在过去几年里,我们一直在做一件事——构建一个面向 AI 时代的企业级向量数据库。这件事情的难点并不在于“做出一个数据库”,而在于“企业级”,也就是让它真正被用起来、好用,而且能够实际解决问题。
就在上周,这件事迎来了一个小小的里程碑:Milvus 在 GitHub 上突破了 35,000 颗 Star。
这个数字不代表什么终点,它只是一个过程中的记录。但它提醒我们一件事:Milvus 不仅是向量数据库领域最受欢迎的开源项目,也是整个 AI 基础设施赛道中最具影响力的基础软件之一,它说明了在数据库这个极少有“明星产品”的领域,有很多人在默默关注我们。
这些 Star 背后,是一个个开发者的信任与支持。感谢每一位 Star、Fork、Issue、PR 的朋友,你们是让 Milvus 一步步成长的推动力。
01
Milvus何以坚持至今?infra没有弯道超车
2017 年Zilliz团队正式成立,那时候,一切的出发点从一个问题开始:AI 世界里,非结构化数据越来越多,模型用向量表达“语义”,但这些向量——如何用一个数据库去做好管理?传统数据库是为表格、标签和字段设计的。我们想做的,是一款为这个全新语义时代而生的数据库。
因此,2018 年,我们开始研发 Milvus。这不是一个“快速上线”的项目,因为那时甚至都没有“向量数据库”这个概念,但我们知道,如果 AI 要走进真实世界,必须要有新的基础设施作为支撑。
到了2019 年,Milvus 初代产品成型后,我们在这一年的11月,选择把 Milvus 开源。这时候还是Milvus还是0.10版本,但基于这一代Milvus,我们已经能够轻松实现十亿图库的以图搜图,响应时间仅为数百毫秒。
在此之后,2020 年,我们加入了 LF AI & Data 基金会。在这个全球开源社区里,我们学习如何长期维护一个项目、如何回应社区的真实需求、如何让软件架构经得起时间的验证。
2021 年,我们发布 Milvus 1.0,同年,我们从基金会“毕业”,成为顶级项目,走出了自己的技术节奏。那一年,我们还参加了 BigANN——一个关于亿级向量搜索的全球挑战赛。我们赢了。这证明了我们在高维检索领域的技术积累,也证明了我们始终坚持做对但难的事情是值得的。
2022 年,我们决定把 Milvus 推进到一个新的阶段:我们更近一步看到了非结构数据的未来,在海量数据的背景下,只有分布式才能真正支撑起企业级别的需求。于是,Milvus2.0诞生了,我们采用存算分离架构,支持动态扩展与云原生部署,成为首个面向生产环境的开源向量数据库。同年,我们完成了 B+ 轮融资。这笔资金并不是为了“跑马圈地”,而是用于打磨产品和支持全球客户。我们知道,这条路需要慢慢走,但每一步都必须走得扎实。
2023 年,RAG 的浪潮袭来。AI 开始真正依赖语义检索,Milvus 被广泛应用于文档问答、Agent 记忆、代码搜索等场景,GitHub 上的 Star 激增。到了下半年,我们正式推出商业化产品Zilliz Cloud,定位为全托管数据库即服务。
接下来的2024 年,我们被 Forrester 报告列入向量数据库领域的“领导者象限”,我们的GitHub star也突破了3W。那一刻我们意识到:这条我们走了七年的路,终于成为了主路。
但我们从未把这些标签当作终点。Milvus 依然是一个开源项目,Zilliz 依然是一家以工程为本的公司。如果说过去七年我们做对了一件事,那大概就是始终坚信infra没有弯道超车,要尊重问题的复杂性,也尊重解决问题所需要的时间。
02
Milvus的本质,不只是开源产品,更是人的集合
而在服务越来越多开发者的过程中,我们发现一个有趣的现象,很多人知道 Milvus,却不知道 Zilliz。
Zilliz 是 Milvus 背后的原厂团队,也是这个项目从零开始的工程团队。
我们并不介意这种“被隐藏”的状态。很多开源项目都是这样:你在用它,却未必知道是谁在维护它。我们更关注的是那些没有被看见的部分:索引的性能如何提升、GPU 是不是值得引入、文档是否对得起新人、社区里的 Issue 是不是有回应。
当然,这些还不够,为了方便更多用户能够以更低门槛享受向量数据库带来的改变,我们也不排斥 AWS、GCP、阿里云、腾讯云等多家厂商对开源Milvus的集成。即使,他们是基于开源Milvus做了付费的产品线。
不过,实践中,我们也看到一个有趣的现象:当企业用户在使用云厂商提供的 Milvus 版本时,一旦遇到技术难题或边缘场景的问题,这种问题包括但不限于:Milvus的最佳实践、性能极致调优、不同场景下的配置思路……最后,还是需要找到原厂团队做最后的兜底,反而增加了系统的复杂度,乃至成本。
很多人以为开源只是一个“工具库”,其实它也是一个“演进过程”,是无数热爱它、相信它的人的集合。只有真正理解架构的人,才能给出bug 修复、性能瓶颈分析,数据系统打通、架构调整种种问题背后的“为什么”。
为此,我们组建了一个24小时全天候相应的社区团队,在中国、美国、欧洲等各个地区服务全球开发者。无论您是在哪一朵云,无论是是选择上云还是自建,都能为你提供及时、专业的服务。
除此之外,我们还有一个超高质量的北极星团队,他们的主要组成是Milvus社区的志愿者。他们会以活动组织者、workshop讲师、创作者等身份,参与社区的活动,帮助解答各种各样的用户问题。
所以我们也建议:如果你正在使用开源的Milvus,或者考虑将向量数据库作为 AI 系统的核心组件,可以与我们直接联系,获取最专业、最及时的支持。
03
向量数据库正在改变世界
之所以选择这个节点出来聊一聊,因为站在当下,我们不只看到了star的突破,更看到了向量数据库正在切实的改变整个行业。
从产业来看,在互联网,eBay、PayPal、腾讯、阿里、Airbnb;在科技产业,英伟达、XAI 、OpenAI、小米、vivo、OPPO;在汽车产业,博世、滴滴、多数自动驾驶头部企业……中国乃至在全球,我们一半以上的客户都是上市公司、潜在的行业隐形冠军、新兴行业独角兽,高增长用户用Milvus或者Zilliz Cloud(我们的商业化产品)已经成为共识。
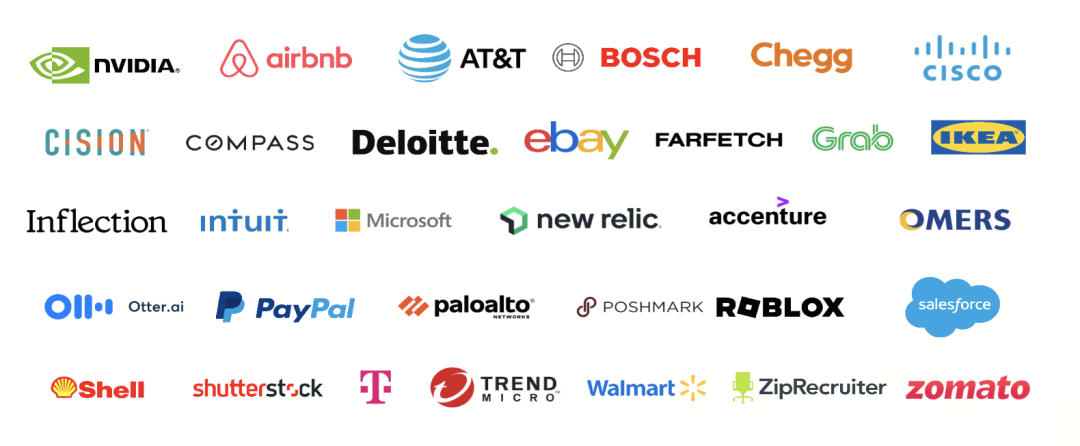
以上为Milvus、Zilliz Cloud的部分国际用户
以上为Milvus、Zilliz Cloud的部分国内用户。
当然,还有很多头部的不具名大厂的logo我们没有放上来。其中一些不乏内部已经有向量数据库产品,但多条业务线,依然在用Milvus与Zilliz Cloud。
而当目光具体到一个个个案,我们则会发现:
博世BOSCH与Milvus合作,在智能驾驶领域实现数据挖掘革新,降低数据采集成本80%,节约千万元数据存储成本,实现毫秒级检索数十亿数据。
博世(BOSCH)× Milvus:智能驾驶领域的数据挖掘革新
某全球性金融巨头合作Milvus,支持了其 25 种货币跨境清算,覆盖 200 多个国家、数千万商家、百亿级交易频次的推荐系统搭建。
金融支付 × 实时推荐:Milvus 如何支撑全球百亿交易的“猜你喜欢”
Shopee 通过引入 Milvus 向量数据库,支持了其在 Shopee 在视频召回、版权匹配和视频去重等多个业务系统中的应用,提升了用户体验和原创内容的识别效率,助力 Shopee 在电商领域开辟新市场。
当然,不止这些,时至今日,可以说凡是有向量检索的场景,就有Milvus、Zilliz Cloud的存在。目前我们已经服务了超过 10000 家企业,成为无数企业构建 AI 向量检索能力的重要基石。
04
为什么我们推出了Zilliz Cloud
开源很美好,但开源也意味着用户侧的巨大投入。从系统架构设计、内核性能优化、社区维护、文档建设,到版本演进与安全漏洞修复,每一个细节背后都需要一支强大的工程团队在支撑。
而对于许多企业用户而言,他们更希望的是一套 无运维、可托管、可观测、企业级 SLA 支持的云服务,在不影响开发效率的前提下快速构建 AI 能力。
与此同时,我们相信,向量数据库不应只是大模型研究人员的专属工具,而应该成为千行百业都能用得起、用得好的核心组件。从金融、制造、医疗,到政务、教育、运营管理,任何场景中非结构化数据的理解和利用,都离不开向量检索的支持。
也是因此,基于Milvus还推出了全托管的商业化产品Zilliz Cloud,通过全球五大云、25大节点,支持企业全球化业务扩张帮助企业在真实的商业场景中,降低人力投入,加速奔跑。
这是一款为大规模 AI 应用而生的全托管向量数据库,具有以下特性:
支持超大规模数据、企业级性能、能够支撑企业的高速发展与灵活变化
在商业化的Zilliz Cloud中,我们提供自研的 AutoIndex 技术,用户不必深入了解索引的底层构建与区别,即可实现查询性能相比开源 Milvus 提升 3-5倍。在此基础上,Zilliz Cloud采用的云原生分布式架构,可稳定支持百亿规模向量数据、万级并发检索。
绝对的安全合规,支撑起企业的数据隐私需求,保证企业全球化扩张的能力。
Zilliz Cloud可以提供企业级安全体系:静态与传输数据加密、细粒度 RBAC 权限管理、全链路审计日志、SAML/OAuth2.0集成、VPC隔 离(BYOC),符合 GDPR、HIPAA 等国际标准。
是企业成本考量的最优解
Zilliz Cloud支持冷热负载优化、弹性扩缩容、按量付费,冷热数据负载优化可以大幅降低企业的资源消耗,总拥有成本(TCO)可下降 50%以上
绝对的云中立
Zilliz Cloud目前已支持全球五大云二十五大节点, AWS、Azure、GCP、阿里云还是腾讯云,都可灵活部署、快速接入,避免平台绑定风险,保障业务的全球一致性与弹性可扩展性。
这些能力看起来并不性感,但足够刚需。而这种刚需,需要时间打磨,与时间做朋友,就像白酒需要酿造而不是勾兑。
我们相信,经过时间的沉淀,无论你是 AI 原生初创公司、财富 500 强企业、政府及科研机构,业务用途是构建搜索引擎、推荐系统,还是多模态大模型的向量检索加速器,Zilliz Cloud 都能为你提供值得信赖的基础设施。
05
最早提出向量数据库,但不只于向量数据库
熟悉我们的朋友都知道,Zilliz/Milvus 团队正是全球最早提出并实现“向量数据库”这一概念的团队。
最早的时候,行业只有 vector search(向量检索)概念。当然,这与时代背景有关,那时候结构化数据的挖掘尚未到达天花板,自然,非结构化数据的潜力也未被重视。
直到2018年前后,人工智能在产业界的落地加速,管理海量非结构化数据,成为摆在所有人面前的一个真问题、急问题。我们不止需要对其进行vector search,还需在此基础上对数据进行容灾备份、增删、量化、查重、混合检索等等更复杂的操作。
恰当其时,我们提出 vector database,我们不止在技术实现上率先完成了这一架构,也在社区、标准、场景推广等多个维度推动了行业的发展。让它从最初无参考可循、无客户认知,到如今被 AI 大模型、RAG 应用、语义搜索广泛采用,我们可以说是走过了无人区,一步步推动行业从认知到实践。
但行业演进不会到此停止,现在,我们正在研发的新一代产品是 Vector Data Lake(向量数据湖)。
原因是,我们观察到了在AI时代,越来越多的企业随着数据规模的不断增加,除了向量数据库之外,还需要一个足够便宜、足够弹性的向量检索产品,这就是我们推出vector data lake的原因。
Vector Data Lake(向量数据湖),用一句话总结即是,针对企业的冷数据,(牺牲一定召回时间的情况下)用存算分离架构,解决海量离线数据处理中的成本问题。
该方案的核心优势在于:
全栈数据整合:在数据层实现了在线与离线数据的无缝对接,确保数据格式统一、高效存储。
融合计算架构:与传统数据湖生态(如 Spark、 Ray 等)天然融合。不仅适用于向量化任务,还能涵盖传统的 ETL、统计分析等业务流程,实现新旧技术的自然融合。
成本可控:该方案设立多级存储,将频繁访问的数据保存在高速存储介质(如 NVMe,SSD),冷数据则归档到对象存储(如 S3),平衡性能与成本。借助先进的数据索引技术与存储策略,可以大幅提升数据读写效率,并支持动态扩展。
我们始终相信,无论是贾维斯定律、还是摩尔定律,时至今日依然有效。他们的底层逻辑——科技产品的市场规模,将随着其单位成本的降低而不断扩张,向量数据库同样如此。
我们希望能够通过自己与社区小伙伴们日复一日、年复一年,对索引、对存储结构、对缓存方式,对产品形态的不断打磨,让更多用户能够以更低成本享受技术进步带来的红利,让非结构化数据加速驶向变革未来的星辰大海。
尾声
能够突破 3.5 万 Star 的项目不多。我们不是第一个,但我们是在一个还没被主流完全定义的领域里,慢慢地被越来越多人选择。
当然,我们不认为 Milvus 是完美的。它还在持续演进,还会有问题、Bug 和不完善的体验。
因此,未来,我们依然将坚持“开源优先”,继续开放路线图、接受社区反馈、在版本中持续优化每一个底层细节,让更多人可以自由地使用、修改、分享这一强大的工具。
如果你是开发者,欢迎为 Milvus 提交 PR、优化文档、参与讨论;
如果你是企业用户,欢迎在社区发起技术交流,也欢迎选择 Zilliz Cloud 获得商用服务支持;
如果你是开源爱好者,请继续为我们打 Star,你的每一次关注都是我们前进的动力!
未来,我们希望与更多人一起,构建全球最强的向量数据库基础设施,加速非结构化数据在人工智能时代的落地。
如果你想了解更多,欢迎访问:https://zilliz.com