主从复制简介
为啥要用主从这样的架构模式
单机QPS是有上限的,而且Redis的特性就是必须支撑读高并发的,那你一台机器又读又写,这谁顶得住啊,不当人啊!但是你让这个master机器去写,数据同步给别的slave机器,他们都拿去读,分发掉大量的请求那是不是好很多,而且扩容的时候还可以轻松实现水平扩容。
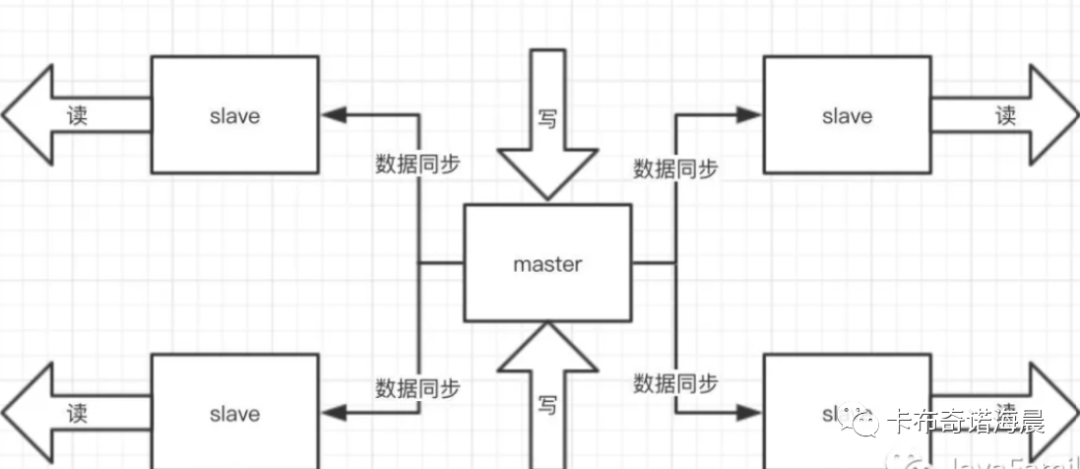
主从复制,是指将一台 Redis 服务器的数据,复制到其他的 Redis 服务器。前者称为 主节点(master),后者称为 从节点(slave)。且数据的复制是 单向 的,只能由主节点到从节点。Redis 主从复制支持 主从同步 和 从从同步 两种,后者是 Redis 后续版本新增的功能,以减轻主节点的同步负担。
主从复制主要的作用
数据冗余: 主从复制实现了数据的热备份,是持久化之外的一种数据冗余方式。
故障恢复: 当主节点出现问题时,可以由从节点提供服务,实现快速的故障恢复 (实际上是一种服务的冗余)。
负载均衡: 在主从复制的基础上,配合读写分离,可以由主节点提供写服务,由从节点提供读服务 (即写 Redis 数据时应用连接主节点,读 Redis 数据时应用连接从节点),分担服务器负载。尤其是在写少读多的场景下,通过多个从节点分担读负载,可以大大提高 Redis 服务器的并发量。
高可用基石: 除了上述作用以外,主从复制还是哨兵和集群能够实施的 基础,因此说主从复制是 Redis 高可用的基础。
Redis数据同步
数据怎么同步的呢?
你启动一台slave 的时候,他会发送一个psync命令给master ,如果是这个slave第一次连接到master,他会触发一个全量复制。master就会启动一个线程,生成RDB快照,还会把新的写请求都缓存在内存中,RDB文件生成后,master会将这个RDB发送给slave的,slave拿到之后做的第一件事情就是写进本地的磁盘,然后加载进内存,然后master会把内存里面缓存的那些新命名都发给slave。
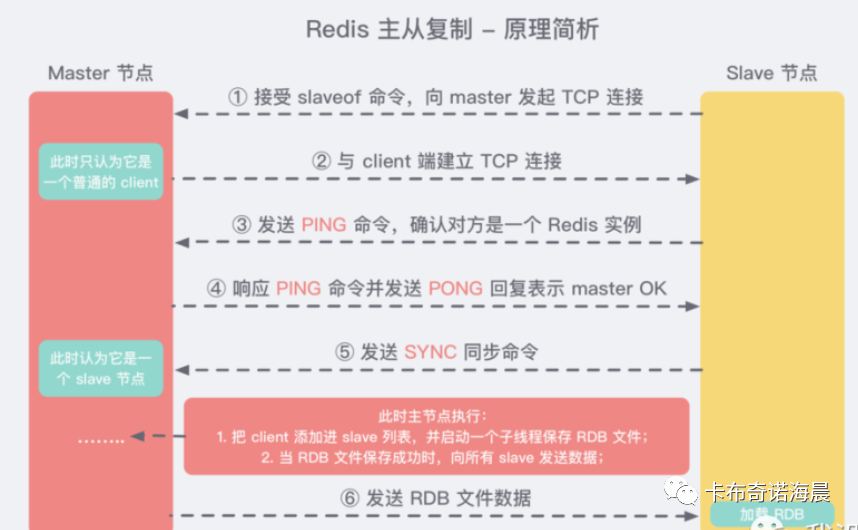
数据传输的时候断网了或者服务器挂了怎么办啊?
传输过程中有什么网络问题啥的,会自动重连的,并且连接之后会把缺少的数据补上的。
大家需要记得的就是,RDB快照的数据生成的时候,缓存区也必须同时开始接受新请求,不然你旧的数据过去了,你在同步期间的增量数据咋办?是吧?
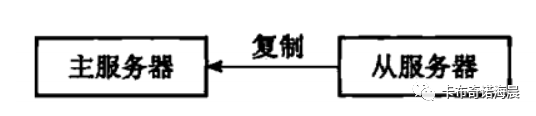
在Redis中,用户可以通过执行SLAVEOF命令或者设置slaveof选项,让一个服务 器去复制(replicate)另一个服务器,我们称呼被复制 的服务器为主服务器(master), 而对主服务器进行复制 的服务器则被称为从服务器(slave), 如图所示。
假设现在有两个Redis服务器,地址分别为
127.0.0.1:6379和127.0.0.1:12345, 如果我们向服务器127.0.0.1:12345发送 以下命令:
127.0.0.1:12345> SLAVEOF 127.0.0.1 6379 OK
那么服务器127.0.0.1:12345将成为127.0.0.1:6379的从服务器,而服务器 127.0.0.1:6379则会成为127.0.0.1:12345的主服务器。
进行复制中的主从服务器双方的数据库将保存相同的数据,概念上将这种现象称作“数 据库状态一致",或者简称“一致”。
比如说,如果我们在主服务器上执行以下命令:
127.0.0.1:6379> SET msg "hello world" OK
那么我们应该既可以在主服务器上获取msg键的值:
127.0.0.1:6379> GET msg "hello world"
又可以在从服务器上获取msg键的值:
127.0.0.1:12345> GET msg "hello world"
另一方面,如果我们在主服务器中删除了键msg:
127,0.0.1:6379> DEL msg(integer) 1
那么不仅主服务器上的msg键会被删除:
127.0.0.1:6379> EXISTS msg(integer) 0
从服务器上的msg键也应该会被删除:
127.0.0.1:12345> EXISTS msg(integer) 0
关于复制的特性和用法还有很多,Redis官方网站上的《复制》文档(http://redis.io/ topics/replication)已经做了很详细的介绍,这里不再赘述。
使用主从复制
为了更直观的理解主从复制,在介绍其内部原理之前,先说明我们需要如何操作才能开启主从复制。
建立复制
需要注意,主从复制的开启,完全是在从节点发起的;不需要我们在主节点做任何事情。
从节点开启主从复制,有3种方式:
(1)配置文件
在从服务器的配置文件中加入:slaveof <masterip> <masterport>
(2)启动命令
redis-server启动命令后加入 --slaveof <masterip> <masterport>
(3)客户端命令
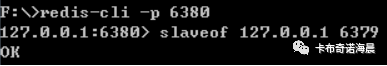
Redis服务器启动后,直接通过客户端执行命令:slaveof <masterip> <masterport>,则该Redis实例成为从节点。
上述3种方式是等效的,下面以客户端命令的方式为例,看一下当执行了slaveof后,Redis主节点和从节点的变化。
实例
准备工作:启动两个节点
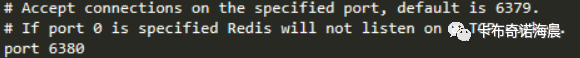
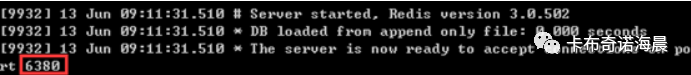
方便起见,实验所使用的主从节点是在一台机器上的不同Redis实例,其中主节点监听6379端口,从节点监听6380端口;从节点监听的端口号可以在配置文件中修改:
启动后可以看到:
建立复制
观察效果
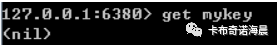
(2)然后在主节点中增加这个key:
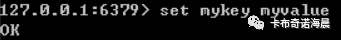
(3)此时在从节点中再次查询这个key,会发现主节点的操作已经同步至从节点:
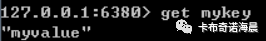
(4)然后在主节点删除这个key:
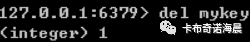
(5)此时在从节点中再次查询这个key,会发现主节点的操作已经同步至从节点:
断开复制
通过slaveof <masterip> <masterport>命令建立主从复制关系以后,可以通过slaveof no one断开。需要注意的是,从节点断开复制后,不会删除已有的数据,只是不再接受主节点新的数据变化。
从节点执行slaveof no one后,打印日志如下所示;可以看出断开复制后,从节点又变回为主节点。
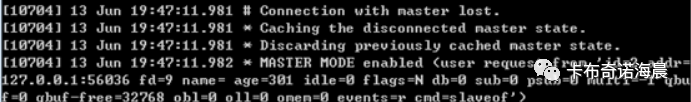
主节点打印日志如下:

主从复制的实现原理
主从复制过程大体可以分为3个阶段:连接建立阶段(即准备阶段)、数据同步阶段、命令传播阶段;下面分别进行介绍。
连接建立阶段
该阶段的主要作用是在主从节点之间建立连接,为数据同步做好准备。
步骤1:保存主节点信息
从节点服务器内部维护了两个字段,即masterhost和masterport字段,用于存储主节点的ip和port信息。
需要注意的是,slaveof是异步命令,从节点完成主节点ip和port的保存后,向发送slaveof命令的客户端直接返回OK,实际的复制操作在这之后才开始进行。

步骤2:建立socket连接
从节点每秒1次调用复制定时函数replicationCron(),如果发现了有主节点可以连接,便会根据主节点的ip和port,创建socket连接。如果连接成功,则:
从节点:为该socket建立一个专门处理复制工作的文件事件处理器,负责后续的复制工作,如接收RDB文件、接收命令传播等。
主节点:接收到从节点的socket连接后(即accept之后),为该socket创建相应的客户端状态,并将从节点看做是连接到主节点的一个客户端,后面的步骤会以从节点向主节点发送命令请求的形式来进行。
这个过程中,从节点打印日志如下:

步骤3:发送ping命令
从节点成为主节点的客户端之后,发送ping命令进行首次请求,目的是:检查socket连接是否可用,以及主节点当前是否能够处理请求。
从节点发送ping命令后,可能出现3种情况:
(1)返回pong:说明socket连接正常,且主节点当前可以处理请求,复制过程继续。
(2)超时:一定时间后从节点仍未收到主节点的回复,说明socket连接不可用,则从节点断开socket连接,并重连。
(3)返回pong以外的结果:如果主节点返回其他结果,如正在处理超时运行的脚本,说明主节点当前无法处理命令,则从节点断开socket连接,并重连。
在主节点返回pong情况下,从节点打印日志如下:
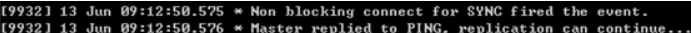
步骤4:身份验证
如果从节点中设置了masterauth选项,则从节点需要向主节点进行身份验证;没有设置该选项,则不需要验证。从节点进行身份验证是通过向主节点发送auth命令进行的,auth命令的参数即为配置文件中的masterauth的值。
如果主节点设置密码的状态,与从节点masterauth的状态一致(一致是指都存在,且密码相同,或者都不存在),则身份验证通过,复制过程继续;如果不一致,则从节点断开socket连接,并重连。
步骤5:发送从节点端口信息
身份验证之后,从节点会向主节点发送其监听的端口号(前述例子中为6380),主节点将该信息保存到该从节点对应的客户端的slave_listening_port字段中;该端口信息除了在主节点中执行info Replication时显示以外,没有其他作用。
数据同步阶段
主从节点之间的连接建立以后,便可以开始进行数据同步,该阶段可以理解为从节点数据的初始化。具体执行的方式是:从节点向主节点发送psync命令(Redis2.8以前是sync命令),开始同步。
数据同步阶段是主从复制最核心的阶段,根据主从节点当前状态的不同,可以分为全量复制和部分复制,下面会有一章专门讲解这两种复制方式以及psync命令的执行过程,这里不再详述。
需要注意的是,在数据同步阶段之前,从节点是主节点的客户端,主节点不是从节点的客户端;而到了这一阶段及以后,主从节点互为客户端。原因在于:在此之前,主节点只需要响应从节点的请求即可,不需要主动发请求,而在数据同步阶段和后面的命令传播阶段,主节点需要主动向从节点发送请求(如推送缓冲区中的写命令),才能完成复制。
命令传播阶段
数据同步阶段完成后,主从节点进入命令传播阶段;在这个阶段主节点将自己执行的写命令发送给从节点,从节点接收命令并执行,从而保证主从节点数据的一致性。
在命令传播阶段,除了发送写命令,主从节点还维持着心跳机制:PING和REPLCONF ACK。由于心跳机制的原理涉及部分复制,因此将在介绍了部分复制的相关内容后单独介绍该心跳机制。
延迟与不一致
需要注意的是,命令传播是异步的过程,即主节点发送写命令后并不会等待从节点的回复;因此实际上主从节点之间很难保持实时的一致性,延迟在所难免。数据不一致的程度,与主从节点之间的网络状况、主节点写命令的执行频率、以及主节点中的repl-disable-tcp-nodelay配置等有关。
repl-disable-tcp-nodelay no:该配置作用于命令传播阶段,控制主节点是否禁止与从节点的TCP_NODELAY;默认no,即不禁止TCP_NODELAY。当设置为yes时,TCP会对包进行合并从而减少带宽,但是发送的频率会降低,从节点数据延迟增加,一致性变差;具体发送频率与Linux内核的配置有关,默认配置为40ms。当设置为no时,TCP会立马将主节点的数据发送给从节点,带宽增加但延迟变小。
一般来说,只有当应用对Redis数据不一致的容忍度较高,且主从节点之间网络状况不好时,才会设置为yes;多数情况使用默认值no。
全量复制
Redis通过psync命令进行全量复制的过程如下:
(1)从节点判断无法进行部分复制,向主节点发送全量复制的请求;或从节点发送部分复制的请求,但主节点判断无法进行部分复制;具体判断过程需要在讲述了部分复制原理后再介绍。
(2)主节点收到全量复制的命令后,执行bgsave,在后台生成RDB文件,并使用一个缓冲区(称为复制缓冲区)记录从现在开始执行的所有写命令
(3)主节点的bgsave执行完成后,将RDB文件发送给从节点;从节点首先清除自己的旧数据,然后载入接收的RDB文件,将数据库状态更新至主节点执行bgsave时的数据库状态
(4)主节点将前述复制缓冲区中的所有写命令发送给从节点,从节点执行这些写命令,将数据库状态更新至主节点的最新状态
(5)如果从节点开启了AOF,则会触发bgrewriteaof的执行,从而保证AOF文件更新至主节点的最新状态
下面是执行全量复制时,主从节点打印的日志;可以看出日志内容与上述步骤是完全对应的。
主节点的打印日志如下:
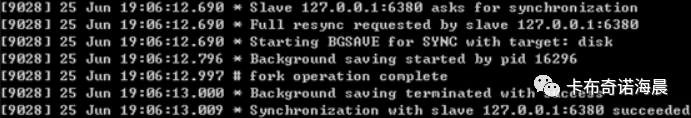
从节点打印日志如下图所示:
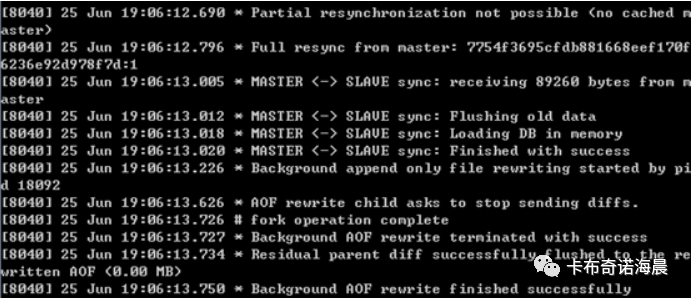
其中,有几点需要注意:从节点接收了来自主节点的89260个字节的数据;从节点在载入主节点的数据之前要先将老数据清除;从节点在同步完数据后,调用了bgrewriteaof。
通过全量复制的过程可以看出,全量复制是非常重型的操作:
(1)主节点通过bgsave命令fork子进程进行RDB持久化,该过程是非常消耗CPU、内存(页表复制)、硬盘IO的;
(2)主节点通过网络将RDB文件发送给从节点,对主从节点的带宽都会带来很大的消耗
(3)从节点清空老数据、载入新RDB文件的过程是阻塞的,无法响应客户端的命令;如果从节点执行bgrewriteaof,也会带来额外的消耗
旧版复制功能的实现
Redis的复制功能分为同步(sync)和命令传播(command propagate)两个操作:
同步操作用于将从服务器的数据库状态更新至主服务器当前所处的数据库状态。
命令传播操作则用于在主服务器的数据库状态被修改,导致主从服务器的数据库状 态出现不一致时,让主从服务器的数据库重新回到一致状态。
同步
当客户端向从服务器发送SLAVEOF命令,要求从服务器复制主服务器时,从服务器首 先需要执行同步操作,也即是,将从服务器的数据库状态更新至主服务器当前所处的数据库 状态。
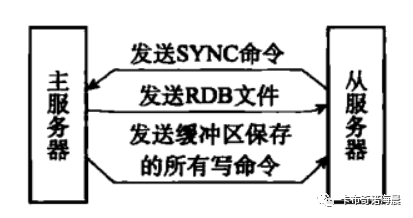
从服务器对主服务器的同步操作需要通过向主服务器发送SYNC命令来完成,以下是 SYNC命令的执行步骤:
1)从服务器向主服务器发送SYNC命令。
2)收到SYNC命令的主服务器执行BGSAVE命令,在后台生成一个RDB文件,并使 用一个缓冲区记录从现在开始执行的所有写命令。
3)当主服务器的BGSAVE命令执行完毕时,主服务器会将BGSAVE命令生成的RDB 文件发送给从服务器,从服务器接收并载人这个RDB文件,将自己的数据库状态更新至主 服务器执行BGSAVE命令时的数据库状态。
4)主服务器将记录在缓冲区里面的所有写命令发送给从服务器,从服务器执行这些写 命令,将自己的数据库状态更新至主服务器数据库当前所处的状态。
图展示了SYNC命令执行期间,主从服务器的通信过程。
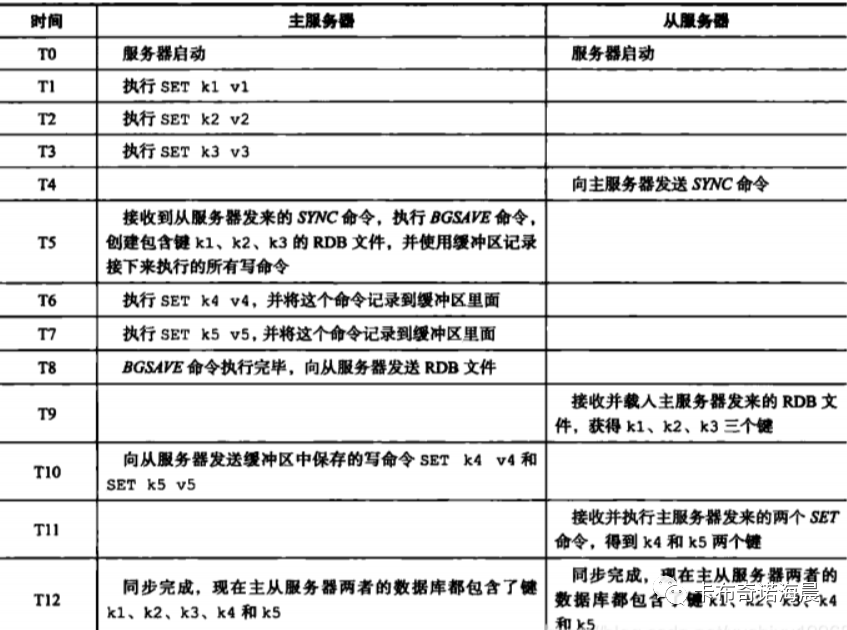
展示了一个主从服务器进行同步的例子。
命令传播
在同步操作执行完毕之后,主从服务器两者的数据库将达到一致状态,但这种一致并不 是一成不变的,每当主服务器执行客户端发送的写命令时,主服务器的数据库就有可能会被 修改,并导致主从服务器状态不再一致。
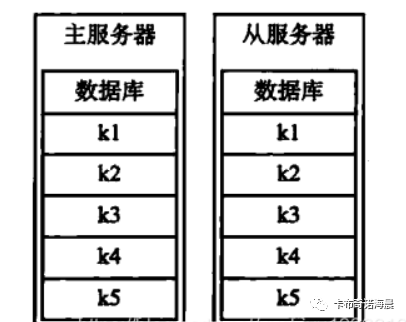
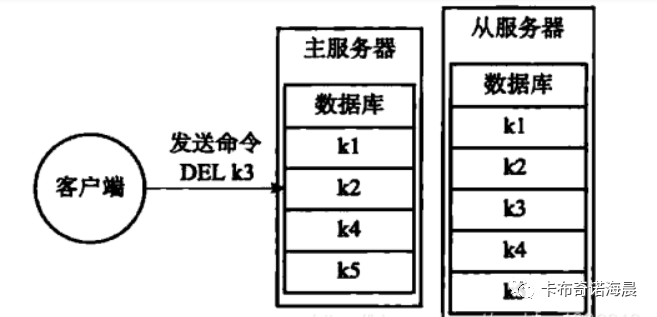
举个例子,假设一个主服务器和一个从服务器刚刚完成同步操作,它们的数据库都保存了相同的五个键k1至k5, 如图所示。
如果这时,客户端向主服务器发送命令DEL k3, 那么主服务器在执行完这个DEL命 令之后,主从服务器的数据库将出现不一致:主服务器的数据库已经不再包含键k3, 但这 个键却仍然包含在从服务器的数据库里面,如图
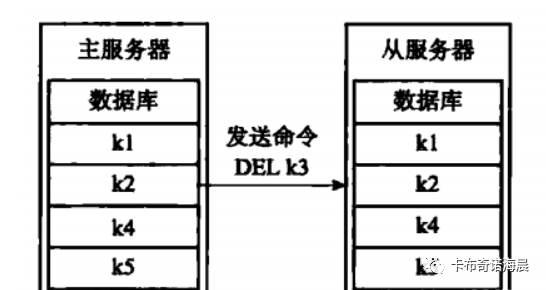
为了让主从服务器再次回到一致状态,主服务器需要对从服务器执行命令传播操作:主 服务器会将自己执行的写命令,也即是造成主从服务器不一致的那条写命令,发送给从服务器执 行,当从服务器执行了相同的写命令之后,主从 服务器将再次回到一致状态。
在上面的例子中,主服务器因为执行了命令 DEL k3而导致主从服务器不一致,所以主服务器 将向从服务器发送相同的命令DEL k3。当从服务 器执行完这个命令之后,主从服务器将再次回到一 致状态,现在主从服务器两者的数据库都不再包含k3了
旧版复制功能的缺陷
在Redis中,从服务器对主服务器的复制可以分为以下两种情况:
初次复制:从服务器以前没有复制过任何主服务器,或者从服务器当前要复制的主 服务器和上一次复制的主服务器不同。
断线后重复制:处于命令传播阶段的主从服务器因为网络原因而中断了复制,但从 服务器通过自动重连接重新连上了主服务器,并继续复制主服务器。
对于初次复制来说,旧版复制功能能够很好地完成任务,但对于断线后重复制来说,旧 版复制功能虽然也能让主从服务器重新回到一致状态,但效率却非常低。
要理解这一情况,请看表展示的断线后重复制例子。
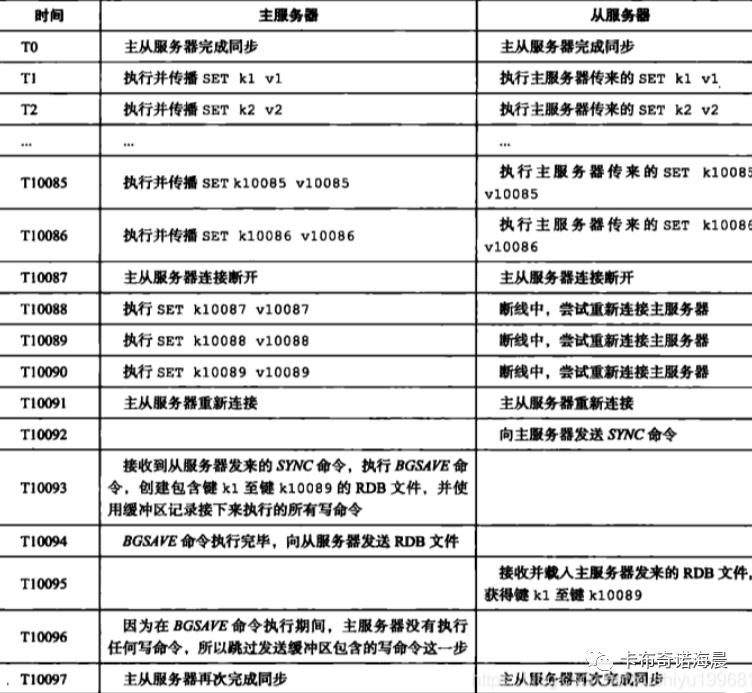
在时间T10091, 从服务器终于重新连接上主服务器,因为这时主从服务器的状态巳经 不再一致,所以从服务器将向主服务器发送SYNC命令,而主服务器会将包含键k1至键 k10089的ROB文件发送给从服务器,从服务器通过接收和载人这个ROB文件来将自己的 数据库更新至主服务器数据库当前所处的状态。
虽然再次发送SYNC命令可以让主从服务器重新回到一致状态,但如果我们仔细研究这 个断线重复制过程,就会发现传送ROB文件这一步实际上并不是非做不可的:
主从服务器在时间T0至时间T10086中一直处于一致状态,这两个服务器保存的数 据大部分都是相同的。
从服务器想要将自己更新至主服务器当前所处的状态,真正需要的是主从服务器连 接中断期间,主服务器新添加的k10087、k10088、k10089三个键的数据。
可惜的是,旧版复制功能并没有利用以上列举的两点条件,而是继续让主服务器生 成并向从服务器发送包含键k1至键k10089的RDB文件,但实际上RDB文件包 含的键k1至键k10086的数据对于从服务器来说都是不必要的。上面给出的例子可能有一点理想化,因为在主从服务器断线期间,主服务器执行的写命 令可能会有成百上千个之多,而不仅仅是两三个写命令。但总的来说,主从服务器断开的时 间越短,主服务器在断线期间执行的写命令就越少,而执行少量写命令所产生的数据量通常 比整个数据库的数据量要少得多,在这种情况下,为了让从服务器补足一小部分缺失的数 据,却要让主从服务器重新执行一次SYNC命令,这种做法无疑是非常低效的。
SYNC命令是一个非常耗费资源的操作 每次执行SYNC命令,主从服务器需要执行以下动作:
1)主服务器需要执行BGSAVE命令来生成RDB文件,这个生成操作会耗费主服务 器大量的CPU、内存和磁盘IO资源。
2)主服务器需要将自己生成的RDB文件发送给从服务器,这个发送操作会耗费主 从服务器大量的网络资源(带宽和流量),并对主服务器响应命令请求的时间产生影响。
3)接收到RDB文件的从服务器需要载入主服务器发来的RDB文件,并且在载入 期间,从服务器会因为阻塞而没办法处理命令请求。
因为SYNC命令是一个如此耗费资源的操作,所以Redis有必要保证在真正有需要 时才执行SYNC命令。
新版复制功能的实现
为了解决旧版复制功能在处理断线重复制情况时的低效问题,Redis从2.8版本开始, 使用PSYNC命令代替SYNC命令来执行复制时的同步操作。
PSYNC命令具有完整重同步和部分重同步两种模式:
其中完整重同步用于处理初次复制情况:完整重同步的执行步骤和SYNC命令的执 行步骤基本一样,它们都是通过让主服务器创建并发送RDB文件,以及向从服务器 发送保存在缓冲区里面的写命令来进行同步。
而部分重同步则用于处理断线后重复制情况:当从服务器在断线后重新连接主服务 器时,如果条件允许,主服务器可以将主从服务器连接断开期间执行的写命令发送 给从服务器,从服务器只要接收并执行这些写命令,就可以将数据库更新至主服务 器当前所处的状态。
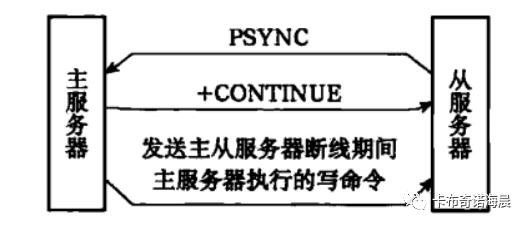
PSYNC命令的部分重同步模式解决了旧版复制功能在处理断线后重复制时出现的低效 情况,表展示了如何使用PSYNC命令高效地处理上一节展示的断线后复制情况。
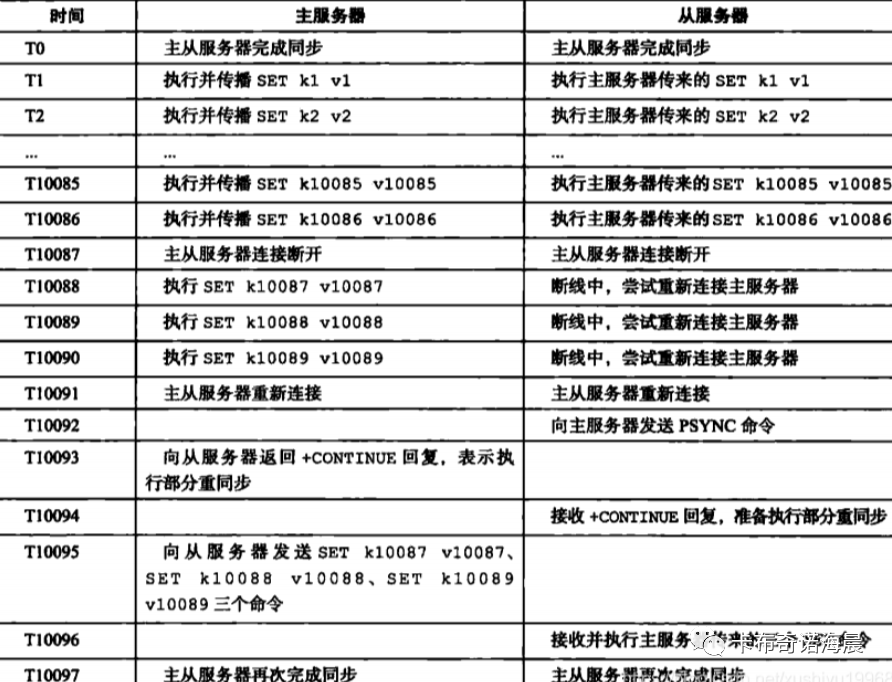
对比一下SYNC命令和PSYNC命令处理断线重复制的方法,不难看出,虽然SYNC命 令和PSYNC命令都可以让断线的主从服务器重新回到一致状态,但执行部分重同步所需的资源比起 执行SYNC命令所需的资源要少得多,完成同步的 速度也快得多。执行SYNC命令需要生成、传送和 载人整个RDB文件,而部分重同步只需要将从服 务器缺少的写命令发送给从服务器执行就可以了。
图展示了主从服务器在执行部分重同步