



官网地址:https://shardingsphere.apache.org/document/current/cn/overview/
shardingsphere-jdbc-core-spring-boot-starter使用背景
#### 1. **系统性能瓶颈**
随着企业业务的不断增长,数据量呈指数级增长,单一数据库架构面临着越来越大的压力。这种情况下,数据库的性能瓶颈逐渐显现,特别是在面对高并发读写和大量数据查询时,数据库的响应速度和系统的整体性能显著下降。为了应对这种情况,系统架构师通常会选择数据库分片(Sharding)和读写分离策略。
#### 2. **数据分片需求**
数据分片是将数据按照某种策略分布到多个数据库实例中,从而减少单个数据库的负载压力,并提高系统的可扩展性和容灾能力。手动实现数据分片不仅复杂且容易出错,还需要大量的维护工作。在这种背景下,ShardingSphere-JDBC 作为一个透明的数据库中间件,可以在不改变现有应用代码的基础上,通过配置文件的方式实现数据分片和多数据源管理,从而大幅度简化分片处理。
#### 3. **读写分离需求**
为了进一步提升系统性能,读写分离是一种常见的策略。通过将写操作(INSERT、UPDATE、DELETE)指向主库,将读操作(SELECT)指向从库,可以有效缓解数据库的读写压力。然而,手动管理主从数据库的切换和一致性维护需要付出较大的开发成本。ShardingSphere-JDBC 通过内置的读写分离功能,能够自动识别和路由读写操作,开发者只需专注于业务逻辑,而无需关心底层的数据库操作细节。
#### 4. **数据加密和影子库需求**
在现代应用中,数据安全变得越来越重要,尤其是对于敏感数据的存储和访问。ShardingSphere-JDBC 提供了数据加密功能,可以在数据入库前进行加密,在查询时自动解密,保障数据的安全性。此外,影子库的功能可以用于在生产环境中进行压测,确保系统在高负载下依然稳定运行,而不会影响实际用户的使用。
#### 5. **简化数据库操作**
在多数据源场景下,应用程序需要连接多个数据库实例。传统方式下,开发者需要手动配置和管理多个数据源的连接以及 SQL 的分发逻辑,增加了系统复杂度。ShardingSphere-JDBC 通过统一的接口和配置管理这些数据库连接,使得应用程序可以透明地访问分布式数据源,极大地简化了开发工作。
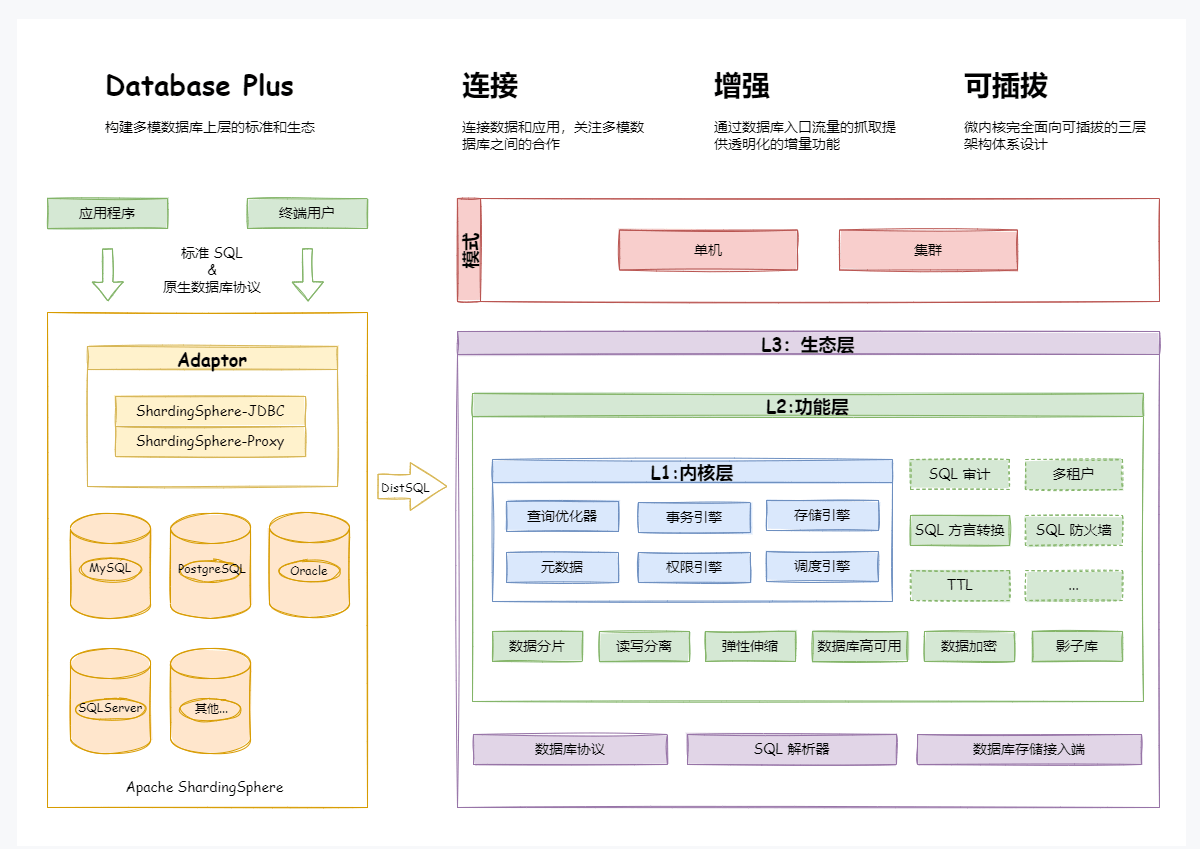
架构图
数据分片
垂直分片
按照业务拆分的方式称为垂直分片,又称为纵向拆分,它的核心理念是专库专用。 在拆分之前,一个数据库由多个数据表构成,每个表对应着不同的业务。而拆分之后,则是按照业务将表进行归类,分布到不同的数据库中,从而将压力分散至不同的数据库。 下图展示了根据业务需要,将用户表和订单表垂直分片到不同的数据库的方案。
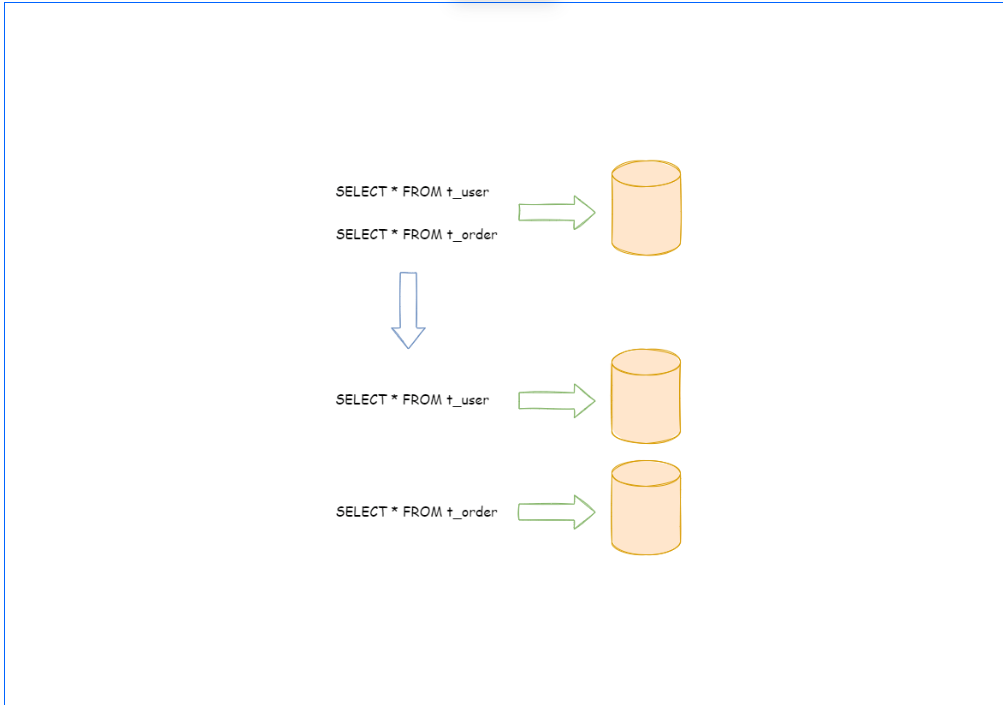
垂直分片往往需要对架构和设计进行调整。通常来讲,是来不及应对互联网业务需求快速变化的;而且,它也并无法真正的解决单点瓶颈。 垂直拆分可以缓解数据量和访问量带来的问题,但无法根治。如果垂直拆分之后,表中的数据量依然超过单节点所能承载的阈值,则需要水平分片来进一步处理。
水平分片
水平分片又称为横向拆分。 相对于垂直分片,它不再将数据根据业务逻辑分类,而是通过某个字段(或某几个字段),根据某种规则将数据分散至多个库或表中,每个分片仅包含数据的一部分。 例如:根据主键分片,偶数主键的记录放入 0 库(或表),奇数主键的记录放入 1 库(或表),如下图所示。
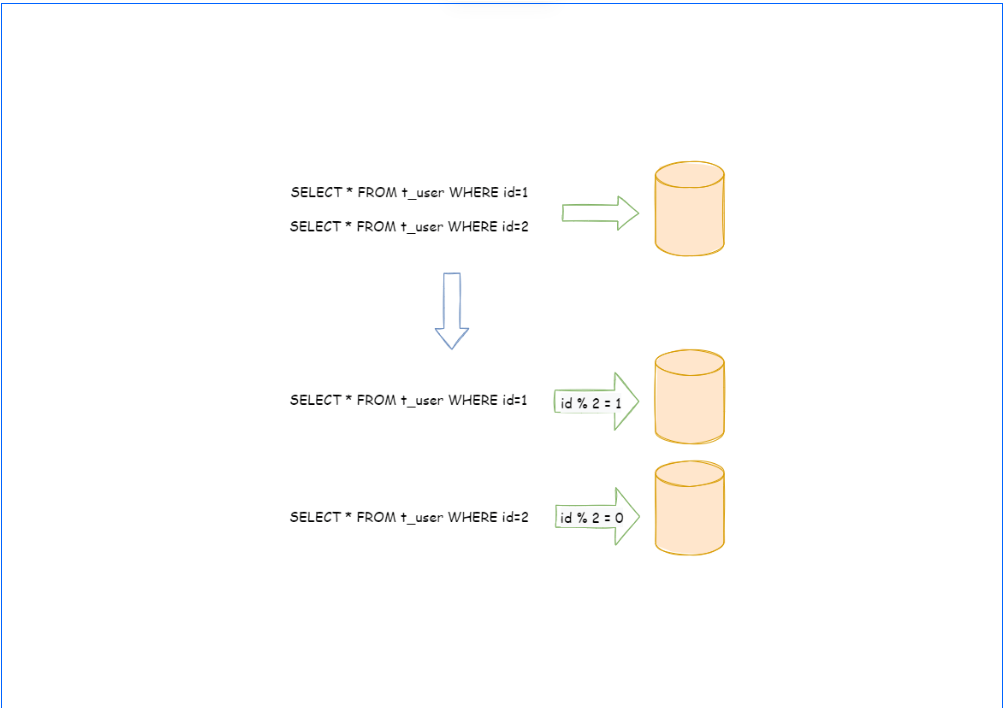
水平分片从理论上突破了单机数据量处理的瓶颈,并且扩展相对自由,是数据分片的标准解决方案。
不支持的语法
CASE WHEN
以下 CASE WHEN 语句不支持:
- CASE WHEN 中包含子查询
- CASE WHEN 中使用逻辑表名(请使用表别名)
分页查询
Oracle 和 SQLServer 由于分页查询较为复杂,目前有部分分页查询不支持,具体如下:
- Oracle
目前不支持 rownum + BETWEEN 的分页方式。
- SQLServer
目前不支持使用 WITH xxx AS (SELECT …) 的方式进行分页。由于 Hibernate 自动生成的 SQLServer 分页语句使用了 WITH 语句,因此目前并不支持基于 Hibernate 的 SQLServer 分页。 目前也不支持使用两个 TOP + 子查询的方式实现分页。
常用inline分片算法表达式
在 ShardingSphere 中,`INLINE` 类型的分片算法使用的是一种内联表达式来进行分片。它通过对分片键的值进行简单的数学运算、字符串操作等方式来决定数据落在哪个表或数据库中。常见的 `INLINE` 类型分片算法表达式主要用于简单场景,例如按取模分片、按范围分片、按日期分片等。
按取模分片
按分片键的取模值来决定落在哪个表或数据库。
示例:- **按表取模分片:**
# 根据 `user_id` 的取模值分片到 2 张表中(`table_0` 和 `table_1`)
algorithm-expression: table_${user_id % 2}
示例:- **按数据库取模分片:**
#  如果有 3 个数据库,数据将根据 `user_id` 的取模分配
algorithm-expression: db_${user_id % 3}
按范围分片
根据分片键的范围来决定分片表。
示例:- **按用户ID范围分表:**
#如果 `user_id` 在 0-100 范围内存储在 `table_0`,101-200 存储在 `table_1`
algorithm-expression: table_${user_id >= 0 && user_id <= 100 ? 0 : 1}
按时间分片
常用于基于日期字段进行分表,按月、按年等规则分表。
示例:- **按月分表:**
#根据 `create_time` 的月份将数据分配到不同表中:
 algorithm-expression: table_${create_time.format('yyyyMM')}
示例:- **按年分表:**
#根据 `create_time` 的年份来分片:
algorithm-expression: table_${create_time.format('yyyy')}
复合取模分片
对于多个字段的组合分片,通常会结合多个字段进行取模运算。
示例:- **`user_id` 和 `order_id` 组合取模分表:**
#将 `user_id` 和 `order_id` 的取模结果组合来分片:
algorithm-expression: table_${user_id % 2}_${order_id % 3}
字符串分片
根据字符串的前缀或后缀进行分片,常用于按某种业务逻辑对字符串类型的字段进行分片。
示例:- **按 `order_id` 的前缀分片:**
#根据 `order_id` 的前两位字符进行分片:
algorithm-expression: table_${order_id.substring(0, 2)}
示例:- **按 `order_id` 的后缀分片:**
#根据 `order_id` 的最后两位字符来分表:
 algorithm-expression: table_${order_id.substring(order_id.length() - 2)}
自定义分片规则
示例:- **按年份和用户ID取模的组合分表:**
#按照 `create_time` 的年份和 `user_id` 的取模结果来分表:
algorithm-expression: table_${create_time.format('yyyy')}_${user_id % 4}
按复合规则进行分片
示例:- **按多个条件分片:**
#比如根据 `age` 和 `region` 组合分片:
algorithm-expression: table_${age >= 18 ? 'adult' : 'child'}_${region}
Groovy脚本算法
如果逻辑复杂,或者需要动态处理分片,可以考虑使用 `Groovy` 脚本算法。(省略···)
shardingsphere-spring-boot-starter使用背景
shardingsphere-jdbc-core-spring-boot-starter使用时,只能先创建表,然后再配置对应的分库分表策略。现阶段实现方式有以下两种:
1.一次性创建出所有的需要分库分表的数据表,再配置对应的分库分表策略;
2.创建定时任务,定时创建分库分表数据表,再配置对应的分库分表策略;
以上两种方式都是预处理的方式来进行建表,在扩展性以及可维护性较差。基于JAVA懒加载思想,实现在使用表的时候再创建表,同时满足按月分表的需求。
使用方法
引入依赖包
<dependency>
      <groupId>com.xtm</groupId>
      <artifactId>shardingsphere-spring-boot-starter</artifactId>
      <version>0.0.1-SNAPSHOT</version>
    </dependency>
application-dev.yml中增加配置
server:
  port: 9001
mybatis-plus:
  mapper-locations: classpath:/mapper/*.xml
spring:
  shardingsphere:
    datasource:
      #配置数据源
      names: sharding_sphere
      sharding_sphere:
        type: com.alibaba.druid.pool.DruidDataSource
        driver-class-name: com.alibaba.druid.pool.DruidDataSource
        # 需要将jdbc-url 换成URL
        url: jdbc:mysql://localhost:3306/sharding_sphere?useUnicode=true&characterEncoding=UTF-8&serverTimezone=Asia/Shanghai&useSSL=false&allowMultiQueries=true
        username: root
        password: 123456
    # 官方配置
    rules:
      sharding:
        tables:
          #逻辑表名
          user:
            # 事实表名
            actual-data-nodes: sharding_sphere.user_male, sharding_sphere.user_female
            #分表策略
            table-strategy:
              standard:
                # 分表字段
                sharding-column: sex
                # 策略名称
                sharding-algorithm-name: user-inline
        sharding-algorithms:
          #策略名称
          user-inline:
            #策略类型
            type: INLINE
            props:
              #表达式
              algorithm-expression: user_$->{sex == 1?'male':'female'}
    mode:
      type: Memory
    props:
      sql-show: true
    enabled: true
    # 小铁马shardingSphere
    xtm:
      tables:
        # 表名
        sharding_test:
          # 字段
          column: create_time
          # 数据源
          dataSource: sharding_sphere
        # 表名
        normal_sharding:
          # 字段
          column: create_time
          # 数据源
          dataSource: sharding_sphere
  main:
    allow-bean-definition-overriding: true
logging:
  level:
    root: info
小铁马shardingSphere配置项详解
spring.shardingsphere.xtm.preCreateNextTable
含义:是否提前创建下次表格,如果是按月分表,那么就是提前创建下个月的表
默认值:true
可选值: true 或false
是否必填:否
spring.shardingsphere.xtm.tables.sharding_test.algorithm
含义:表分片使用的算法
默认值:year-month-split
可选值:year-month-split
是否必填:否
spring.shardingsphere.xtm.tables.sharding_test.column
含义:分片表的字段
默认值:无
是否必填:是
spring.shardingsphere.xtm.tables.sharding_test.dataSource
含义:shardingSphere使用的数据源
是否必填:是
spring.shardingsphere.xtm.tables.sharding_test.preCreateNextTaleCron
含义:提前创建分片表的表达式
默认值:%s 0 0 * * ? 其中%s为随机0-59的数字,默认每天00:00:00至00:01:00执行一次
是否必填:否
