大家好,我是 JiekeXu,江湖人称“强哥”,青学会 MOP 技术社区主席,荣获 Oracle ACE Pro 称号,墨天轮 MVP,墨天轮年度“墨力之星”,拥有 Oracle OCP/OCM 认证,MySQL 5.7/8.0 OCP 认证以及 PCA、PCTA、OBCA、OGCA、KCA、KCP、KCSM 等众多国产数据库认证证书,今天和大家一起看看业务连续性之浅谈集中式数据库高可用!欢迎关注我的微信公众号“JiekeXu DBA之路”,然后点击右上方三个点“设为星标”置顶,更多干货文章才能第一时间推送,谢谢!
目录
	前言
	高可用
	集中式数据库两地三中心架构
		19c 透明应用连续性 TAC
		TAC、AC、TAF 连接串
		TAC 推荐的连接串配置
	金仓数据库KingbaseES高可用架构
		KES 同城双中心灾备架构
		KES 两地三中心架构
		KES 双中心异构双活架构
		KES JDBC 连接串配置
		KES常见故障案例
	参考链接
前 言
6月14日受邀参加金仓社区在山西太原举办的“KING大咖面对面沙龙”活动,沙龙以“数据库平替之高可用保障业务零中断”为主题,我也分享了高可用相关的主题,本文在原PPT上进一步扩充,感兴趣的朋友可查看。
业务连续性(Business Continuity)是指组织在危机发生时维护关键业务功能、最大限度地减少中断并以最少的停机时间恢复正常运营的能力。这些危机可能包括网络攻击、设备或供应链故障、自然灾害、断电停电和其他突发事件。ISO 22301 将业务连续性定义为“指导组织在中断后响应、恢复、重启和复原到预定义的操作级别的已记录过程”。灾难恢复属于业务连续性的一部分,涉及在必要时逐步恢复 IT 服务。业务连续性与灾难恢复的一个主要区别在于,业务连续性考虑所有类型的业务中断,包括已计划的业务中断。
集中式数据库(Centralized Database)是指数据和应用程序都部署在单一的服务器或数据库系统上的结构。这种架构中的所有数据都存储在同一个物理位置,所有的查询和更新操作都通过这个单点的系统进行。
高可用
高可用性(High Availability,HA),是指通过系统设计和架构,确保服务在任何情况下都能持续提供,尽量减少停机时间。其主要目标是保障业务的连续性,使用户在使用过程中感受到服务的正常运行。
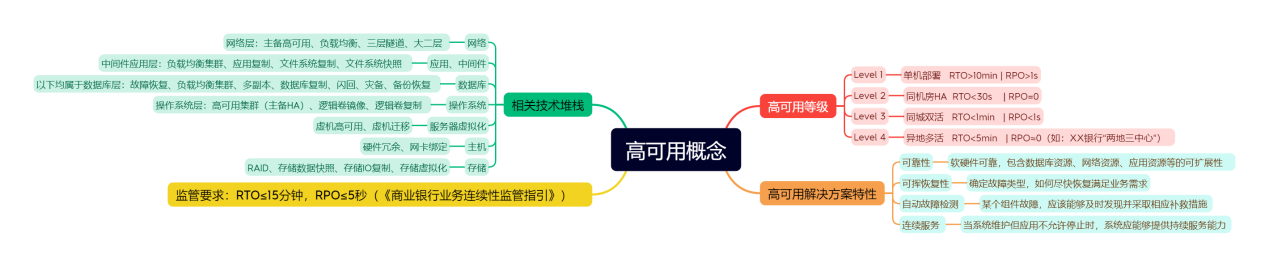
高可用等级分为四级:Level 1 单机部署 RTO>10min | RPO>1s;Level 2 同机房HA RTO<30s | RPO=0; Level 3 同城双活 RTO<1min | RPO<1s; Level 4 异地多活 RTO<5min | RPO≈0。
业务连续性 = 99.99%可用性 + 秒级故障转移 + 数据零丢失
金融行业监管要求:RTO≤15分钟,RPO≤5秒(《商业银行业务连续性监管指引》)
如下图,高可用涉及的相关技术栈有网络层、应用中间件层、数据库层、操作系统层、虚拟化层、主机层、存储层等等技术栈,每一个技术栈都必须要有高可用,全部达到代价也非常昂贵。
高可用解决方案具有可靠性、可恢复性、自动故障检测、能够提供持续服务能力四大特性。
指标 | 含义 | 金融业要求 | |
RTO (Recovery Time Objective) | 故障恢复时间 | ≤15分钟 | RTO是能力:“故障恢复速度 = 运维部门的尊严” |
RPO(Recovery Point Objective) | 数据丢失量 | 0(或秒级) | RPO是底线:“丢失客户交易记录的银行,终将被客户抛弃” |
SLA (Service Level Agreement) | 可用性承诺 | 99.99%(全年52.56分钟24*365*60*0.01%) | SLA是契约:“99.99%不仅是数字,更是对客户资金的敬畏心” |
在金融行业中,RPO 决定生存底线,RTO 体现技术实力,SLA 承载商业信任,三者共同构成业务连续性的铁三角
定义一个系统怎样才算具有高可用性往往需要根据每一个案例的具体情况来具体分析。其度量方式,是根据系统损害、无法使用的时间,以及由无法运作恢复到可运作状况的时间,与系统总运作时间的比较。计算公式为:
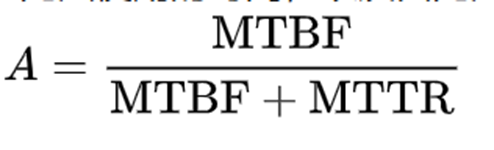
A(可用性),MTBF(平均故障间隔),MTTR(平均修复时间)
可用性越高,年故障时间越短,付出的成本和代价也就越高,下表是可用性与年故障时间转换表,比如四个九年故障时间 99.99% ≈ 365*24*60*(100%-99.99%) = 52.56分钟
可用性 | 年故障时间 |
|---|---|
99% | 87.6小时 |
99.9% | 8.76小时 |
99.99% | 52.6分 |
99.999% | 5.26分 |
99.9999% | 32秒 |
集中式数据库两地三中心架构
如下图所示,集中式数据库不管是单机部署还是类似于 RAC 架构部署,如要满足金融级高可用要求,一般需要“两地三中心”架构,即同城主备加异地灾备,同城主备环境根据业务重要性可以进行同步复制或异步复制,如 主中心部署Oracle RAC,ADG 异步同步到同城备中心,异地灾备环境使用异步复制。PG、MySQL、国产达梦、金仓均可以使用此种架构部署。
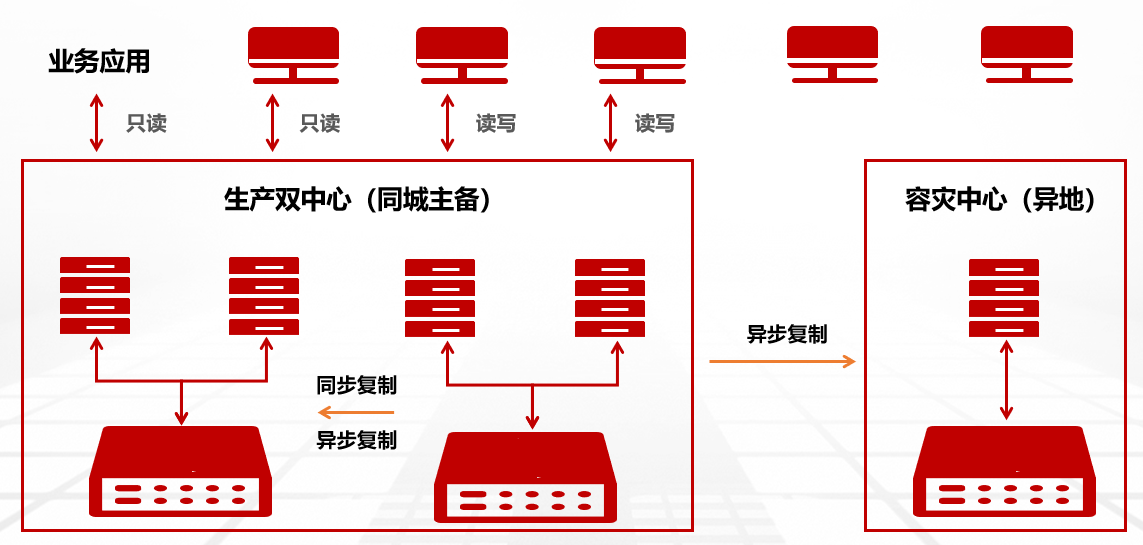
如果是异步复制,那么如果主中心因为断电、洪水、地震等灾难,整个机房不可用的话就会造成数据丢失,试想这要是金融等重要业务,用户能答应吗?如果是 Oracle RAC 使用同步复制,不管是使用存储复制还是 SYNC 同步模式,随着业务量的增长,性能问题会越来越明显,那么就只能使用 ASYNC 模式吗?在 Oracle 11g 你就没得选,只能异步模式同步。在 Oracle 12c 及以后呢,官方推出了 Far Sync 架构,Far Sync可以看作是Oracle ADG 产品中的一个增强特性,在12.1.0.1版本引入,通过在距离主库较近的地方部署ADG Far Sync实例,能够实现包括本地和异地的任意距离的零数据丢失保护,同时对主库性能影响很小。即能够在保证RPO=0的同时,兼顾到主库性能影响最小化。
需要特别注意的是:Far Sync实例并没有用户数据文件,因此无法打开访问,也无法应用redo日志,并且永远不能在主要角色中运行或转换为任何类型的备用数据库。
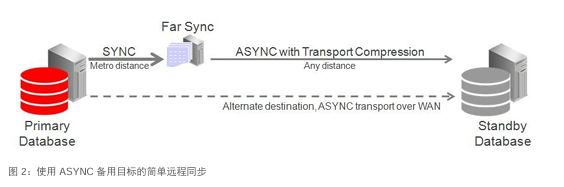
Far Sync实例是 Oracle Active Data Guard Far Sync功能的一部分,需要 Oracle Active Data Guard 许可证。https://docs.oracle.com/database/121/SBYDB/create_fs.htm#SBYDB5416
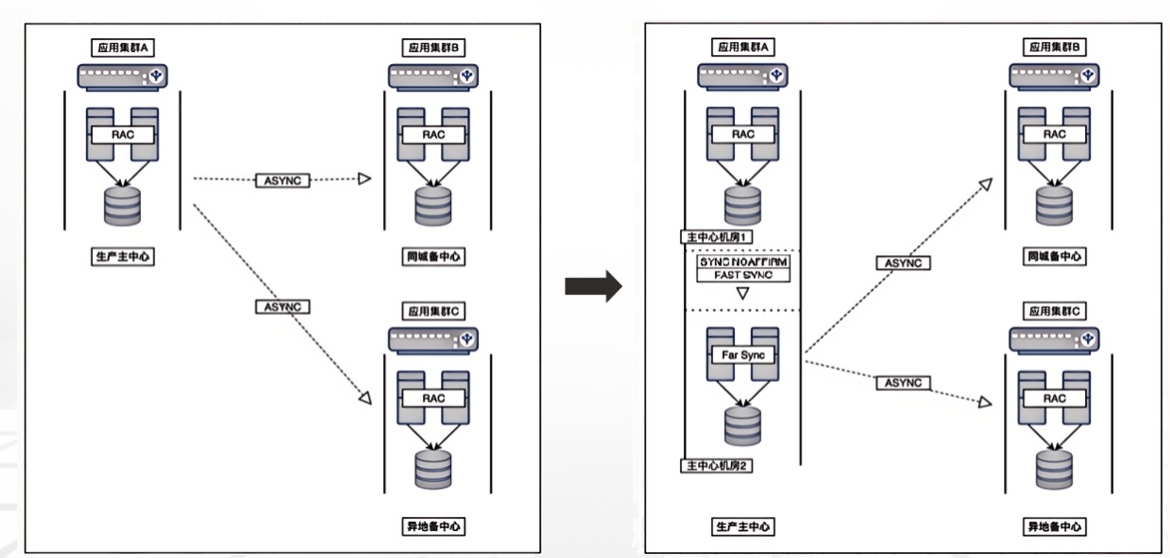
上图是引入 Far Sync 后的架构,这样可以尽大可能避免性能损耗,数据零丢失。当然引入 Far Sync 后还要考虑高可用以及主备切换后,原备库所在机房附近是否还有具备创建 Far Sync 实例,这是比较困难的事情。
创建Far Sync实例与创建物理Standby数据库完全类似,只是Far Sync实例中不存在数据文件
1. 为Far Sync实例创建控制文件
2. 从主数据库使用的服务器参数文件 (SPFILE) 创建参数文件 (PFILE)
3. 从已编辑的参数文件 (PFILE) 创建服务器参数文件 (SPFILE)
4. 使用操作系统复制实用程序将步骤 1 中创建的远程同步实例控制文件和步骤 3 中创建的服务器参数文件
(SPFILE) 从主系统复制到远程同步实例系统上的适当位置
5. 创建备用重做日志(SRLs),方法和在普通standby创建SRLs相同
6. 如果要在 Windows 系统上托管远程同步实例,请使用 ORADIM 实用程序创建 Windows 服务 oradim –NEW –SID ChicagoFS –STARTMODE manual
7. 如果操作系统身份验证用于管理用户并且 SSL 用于重做传输身份验证,则此步骤是可选的。如果不是,则将主数据库的远程登录密码文件复制到远程同步实例上的相应目录。无论何时授予或撤销管理权限( SYSDG、SYSOPER、 SYSDBA等),以及更改任何具有管理权限的用户的密码后,都必须重新复制密码文件(在12.2.0.1之后,密码文件会自动同步更新)
8. 在Far Sync实例上,使用 Oracle Net Manager 为Far Sync实例配置监听
9. 在主数据库上,使用 Oracle Net Manager 为用于redo传输服务的Far Sync实例 (chicagoFS) 创建网络服务名称;在Far Sync实例上,使用Oracle Net Manager为重做传输服务使用的主(chicago)和最终备库(boston)创建网络服务名称
10. 以mount模式启动 Far Sync实例
11. 验证Far Sync实例是否正常运行
12. 将ADG配置的保护模式修改为最大可用。在主数据库上执行命令:
SQL> ALTER DATABASE SET STANDBY TO MAXIMIZE AVAILABILITY;
下图为 Oracle、MySQL、PostgreSQL 以及 Redis 四种数据库的两地三中心高可用架构示意图。

下面介绍 Oracle 为了屏蔽计划内和计划外停机,提升用户零中断的一项技术 透明应用连续性(Transparent Application Continuity)。
19c 透明应用连续性 TAC
什么是 TAC?
着重于用户体验
- 屏蔽计划内维护和意外停机。
- 应用可以透明切换到可用的冗余节点一 RAC 存活节点或者 ADG 备库。
- TAC 通过自动恢复进行中的事务,来为应用程序屏蔽数据库层故障。
- 数据库层的中断对用户来说似乎只是稍微延迟的执行。
- 有效地掩盖了如滚动打补丁、网络故障、数据库实例崩溃以及切换到Active Data Guard 备库等中断事件。
- 配置简单,几乎无代码更改,对应用的透明度高。
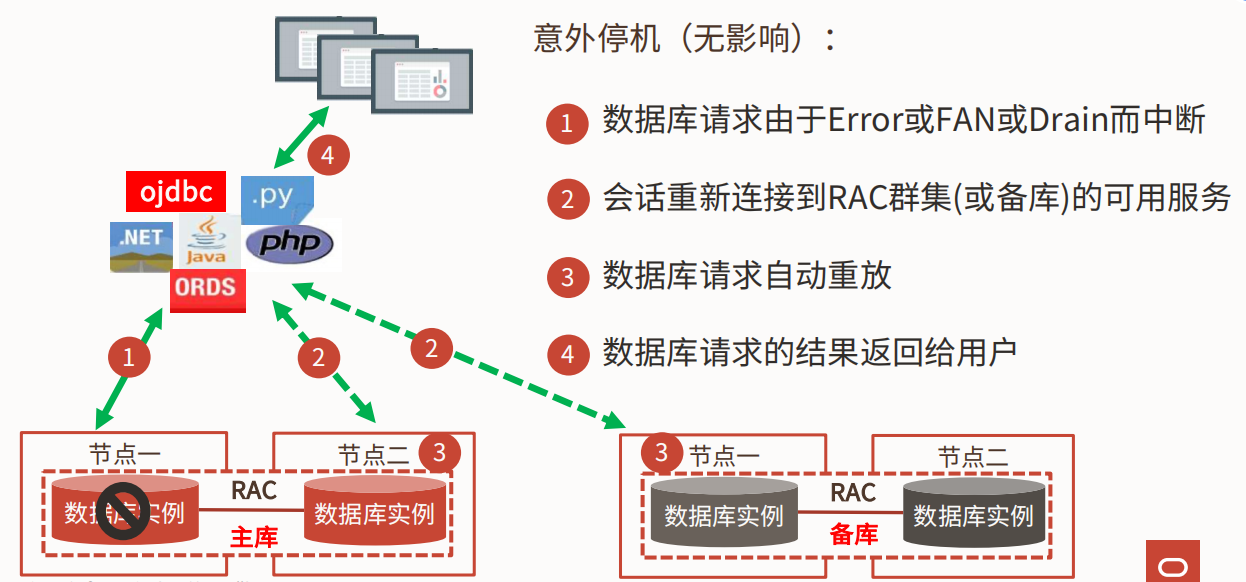
引用自《Oracle 公益课堂》
TAC、AC、TAF 连接串
使用非默认数据库服务(默认服务与数据库或PDB具有相同的名称)。后续单独创建的服务提供了位置透明性和HA功能。
For example 示例:
Transparent Application Continuity
$ srvctl add service -db mydb -service GOLD -preferred inst1,inst2 - failover_restore AUTO -failoverretry 1 -failoverdelay 3 -commit_outcome TRUE -failovertype AUTO -replay_init_time 600 -retention 86400 -notification TRUE -drain_timeout 300 -stopoption IMMEDIATE

Application Continuity
$ srvctl add service -db mydb -service SILVER -preferred inst1 -available inst2 -failover_restore LEVEL1 -failoverretry 1 -failoverdelay 3 -commit_outcome TRUE -failovertype TRANSACTION -replay_init_time 1800 - retention 86400 -notification TRUE -drain_timeout 300 -stopoption IMMEDIATE

Transparent Application Failover
$ srvctl add service -db mydb -service BRONZE -preferred inst1 -available inst2 -failover_restore LEVEL1 -failoverretry 1 -failoverdelay 3 - commit_outcome TRUE -failovertype SELECT -retention 86400 -notification TRUE -drain_timeout 300 -stopoption IMMEDIATE

To add with the Data Guard role, here is the TAC example:
$ srvctl add service -db mydb -service GOLD -preferred inst1 -available inst2 -failover_restore AUTO -failoverretry 1 -failoverdelay 3 -commit_outcome TRUE -failovertype AUTO -replay_init_time 600 -retention 86400 -notification TRUE -drain_timeout 300 -stopoption IMMEDIATE

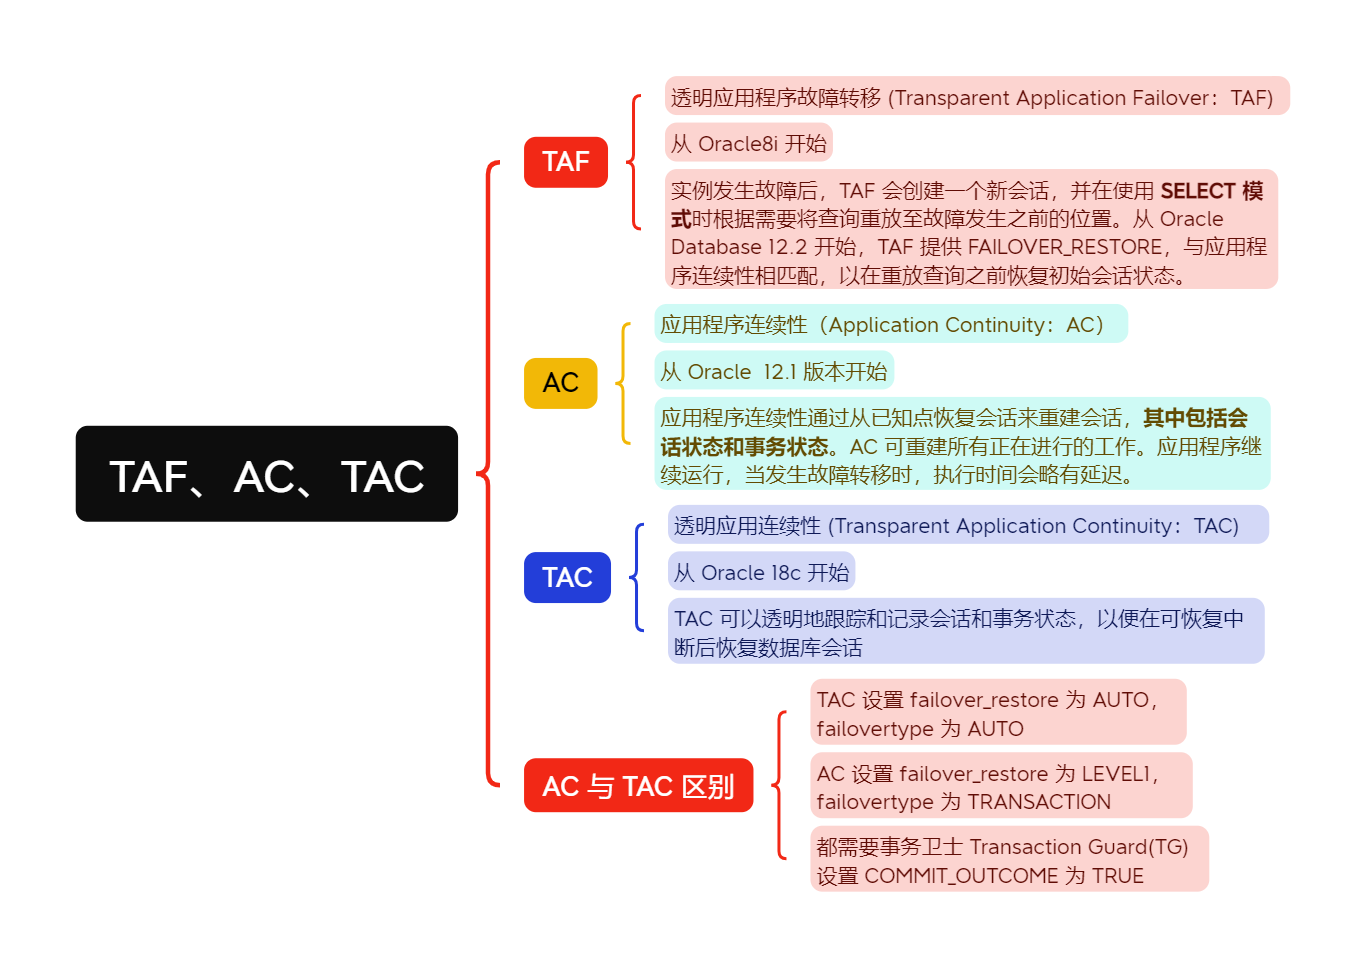
说明:-failover_restore 用于恢复应用程序连续性和 TAF 初始环境的选项;
-commit_outcome (TRUE | FALSE) 提交结果;
-failovertype (NONE | SESSION | SELECT |TRANSACTION | AUTO) 故障转义类型
下图是 TAC、AC、TAF 三者的区别和异同,之前应该也写过一篇 TAF 实战文章,大概讲述了这三者,感兴趣的伙伴可以看看。
《使用 Service 服务配置 Oracle 19c RAC TAF 透明应用程序故障转移》https://mp.weixin.qq.com/s/kWAD_DdBROaeW-rn6mEcfQ
TAC 推荐的连接串配置
TAC 虽好,但对驱动有一定的要求,Driver 版本需要 12.2 或更高。
Use this Connection String for ALL Oracle driver version 12.2 or higher:
RAC 架构
Alias (or URL) =
(DESCRIPTION =
(CONNECT_TIMEOUT= 90)(RETRY_COUNT=50)(RETRY_DELAY=3)(TRANSPORT_CONNECT_TIMEOUT=3)
(ADDRESS_LIST = (LOAD_BALANCE=on)(ADDRESS = (PROTOCOL = TCP)(HOST=primary-scan)(PORT=15210)))
(CONNECT_DATA=(SERVICE_NAME = YOUR SERVICE)))

RAC+ADG架构
Alias (or URL) =
(DESCRIPTION =
(CONNECT_TIMEOUT= 90)(RETRY_COUNT=50)(RETRY_DELAY=3)(TRANSPORT_CONNECT_TIMEOUT=3)
(ADDRESS_LIST = (LOAD_BALANCE=on)(ADDRESS = (PROTOCOL = TCP)(HOST=primary-scan)(PORT=15210)))
(ADDRESS_LIST = (LOAD_BALANCE=on)(ADDRESS = (PROTOCOL = TCP)(HOST=standby-scan)(PORT=15210)))
(CONNECT_DATA=(SERVICE_NAME = YOUR SERVICE)))
金仓数据库KingbaseES高可用架构
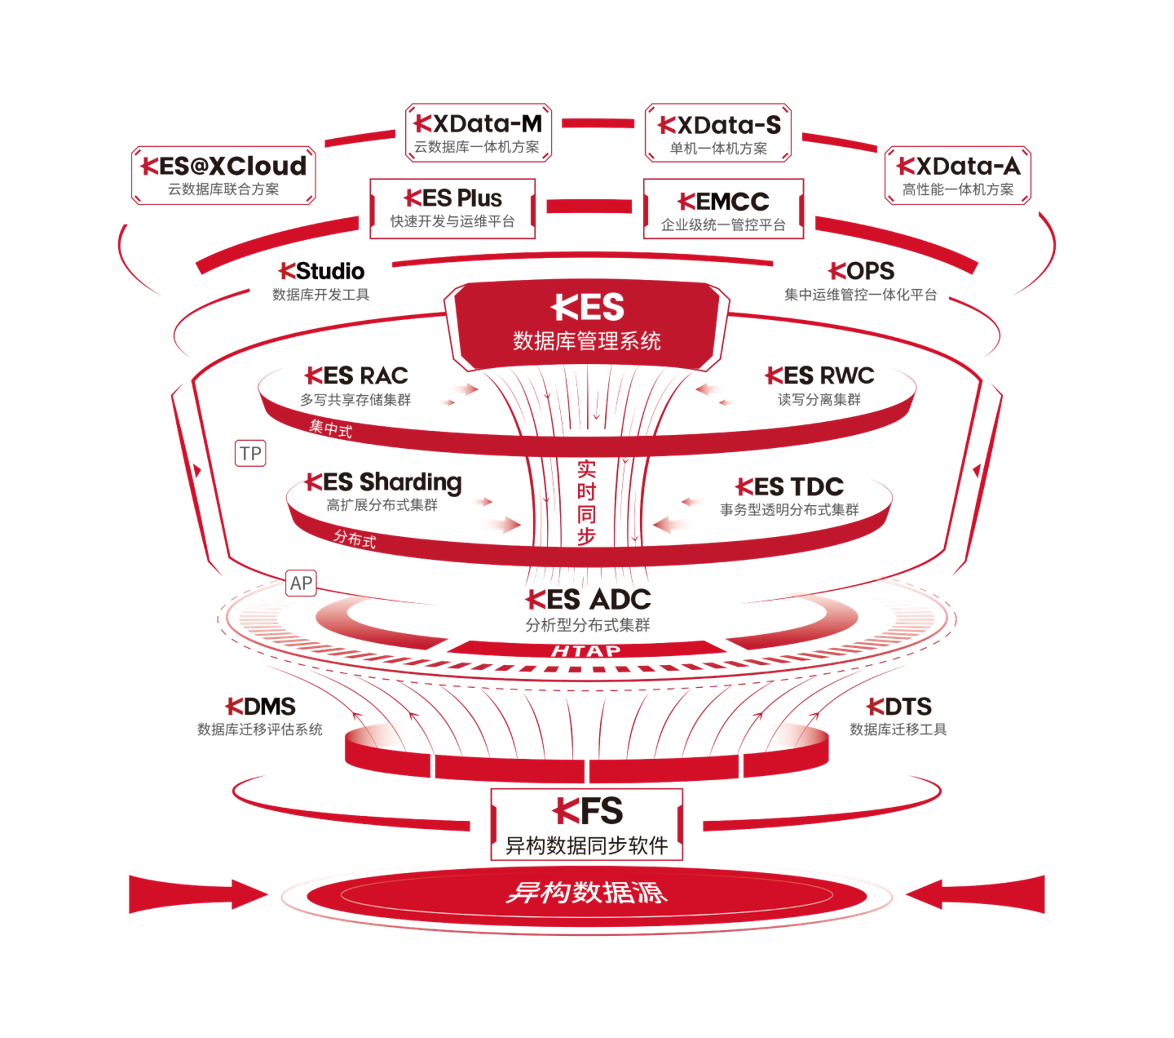
下面是金仓产品架构图,以 KES 为产品核心的一系列产品,有对标 OGG 的异构数据同步软件 KFS,有静态数据迁移工具 KDTS,有数据迁移评估工具 KDMS,还有类似 RAC 的 KES RAC 多写共享存储集群,KES RWC 读写分离集群,还有类似 Oracle APEX 的 KES Plus 快速开发与运维平台,据悉这款产品在国产厂商中属于首家,其他国产数据库厂商没有这个。还有一体机解决方案和云数据库解决方案,感兴趣的朋友可以自行咨询查看。
KES 同城双中心灾备架构
KES 同城双中心架构金仓官方推荐生产中心集群使用流复制 sync 方式同步,灾备中心的第一个节点使用 sync 方式同步,同城其他灾备节点 async 异步方式同步。也可以引入 witness节点,也称为仲裁节点、观察节点,但应用不访问此节点,此节点主要作为集群故障自动切换时的仲裁。这样便可以达到金融级高可用:支持 RPO=0 、RTO<60s 的容灾切换,保障业务的安全性和可靠性。当主集群发生故障时,备集群能够数据无损地快速完成切换,替代主集群继续提供生产服务。
中心内:RPO = 0,RTO < 8s;中心间:RPO = 0,RTO < 60s
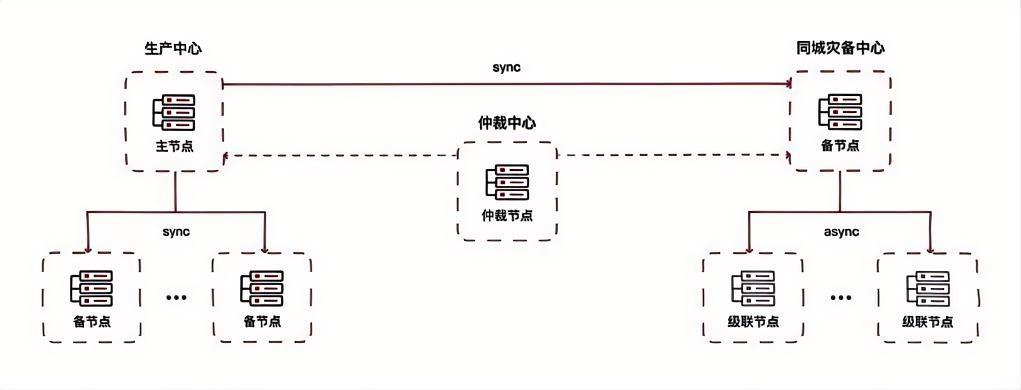
这样同城灾备中心的网络带宽以及距离和磁盘IO性能均有可能是瓶颈,必须大带宽,近距离,第一个 sync 节点磁盘性能强大才不太会出现因备库引发的性能问题。
KES 两地三中心架构
KES 两地三中心架构金仓官方推荐生产中心集群使用 sync 方式同步,同城中心的第一个节点使用 sync 方式同步,同城中心其他节点 async 异步方式同步,异地灾备中心使用 async 异步方式同步,每个中心均引入仲裁节点,灾备中心仲裁节点作为中心仲裁节点。这样便可以达到金融级高可用:中心级&城市级故障容灾保障,保障业务的安全性和可靠性,满足国标金融级容灾标准。当主集群发生故障时,备集群能够数据无损地快速完成切换,替代主集群继续提供生产服务
中心内:RPO = 0,RTO < 8s;中心间:RPO = 0,RTO < 60s;异地中心间:RPO 低至亚秒级,RTO=分钟级
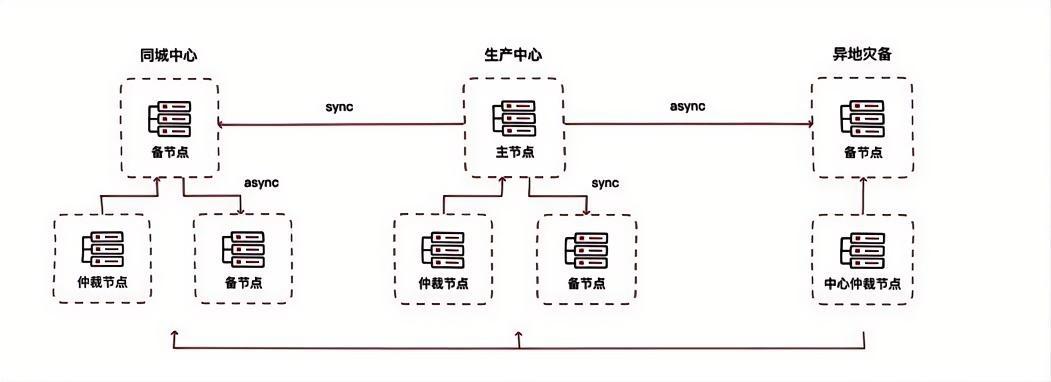
这种架构同城中心的网络带宽以及距离和磁盘IO性能均有可能会是瓶颈,必须大带宽,近距离,第一个 sync 节点磁盘性能强大才不太会出现因备库引发的性能问题。
KES 双中心异构双活架构
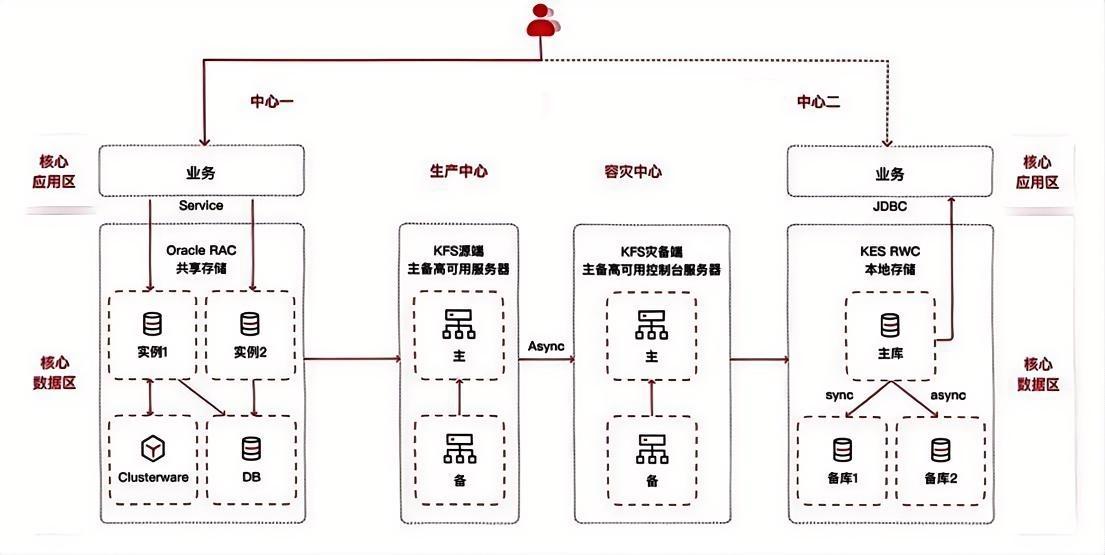
KES双中心异构双活架构常见于国产数据库替换过程中,原系统为 Oracle RAC 还在继续运行业务,通过金仓 KFS 主备高可用同步程序将增量数据同步至灾备中心的金仓 KES RWC 集群来实现双活,灾备端也可以进行部分业务,避免因较长周期的替换场景下,核心数据资产分散而导致丢失、宕机等故障导致业务系统停止。
这样也就可以达到金融级高可用:中心级&城市级故障容灾保障,保障业务的安全性和可靠性,满足国标金融级容灾标准
高兼容:多源异构数据广泛兼容,双中心异构数据库实时双活;
高性能:超远程广域网数据传输加速,跨地域数据同步低延迟;
资源高效利用:双中心异构数据库同时提供对外服务,灾备投资高效利用;
异地中心间:RPO = 秒级,RTO=0
KES JDBC 连接串配置
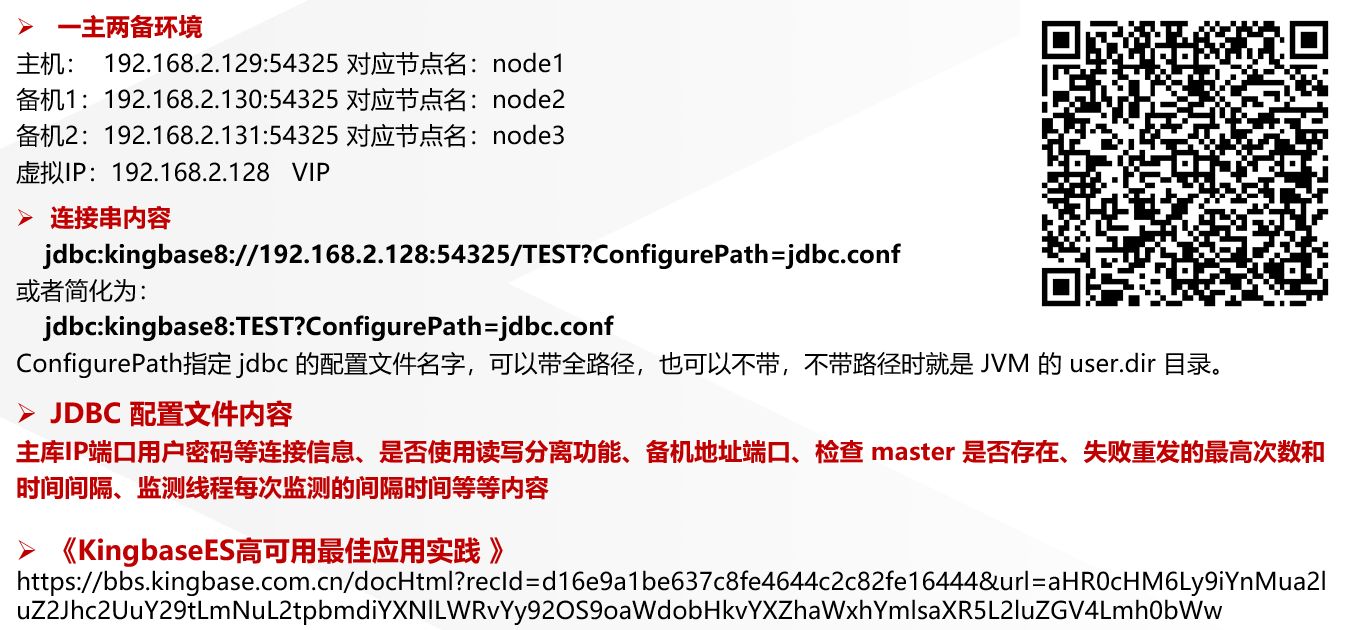
JDBC驱动提供对应用透明的读写分离功能,让应用无成本的快速迁移到数据库读写分离集群,提升整体处理能力。配置支持连接串和配置文件两种形式,读写分离功能参数较多,推荐使用JDBC配置文件。
- 一主两备环境
主机: 192.168.2.129:54325 对应节点名:node1
备机1:192.168.2.130:54325 对应节点名:node2
备机2:192.168.2.131:54325 对应节点名:node3
虚拟IP:192.168.2.128 VIP
- 连接串内容
jdbc:kingbase8://192.168.2.128:54325/TEST?ConfigurePath=jdbc.conf
或者简化为:
jdbc:kingbase8:TEST?ConfigurePath=jdbc.conf
ConfigurePath指定 jdbc 的配置文件名字,可以带全路径,也可以不带,不带路径时就是 JVM 的 user.dir 目录。
- JDBC 配置文件内容
主库IP端口用户密码等连接信息、是否使用读写分离功能、备机地址端口、检查 master 是否存在、失败重发的最高次数和时间间隔、监测线程每次监测的间隔时间等等内容
- 《KingbaseES高可用最佳应用实践 》
jdbc.conf 文件内容
HOST=192.168.2.128
PORT=54325
DBNAME=TEST
user=SYSTEM
password=123456
loggerLevel=OFF
loggerFile=jdbc_test.log

#是否使用读写分离功能
USEDISPATCH=true
#主机读负载率
HOSTLOADRATE=50
#备机地址,使用逗号分割
SLAVE_ADD=192.168.2.129,192.168.2.130
SLAVE_PORT=54325,54325

#nodeList指定各节点的名称,
#各节点的名称为./repmgr cluster show命令查询出的Name字段。
#要求开启读写分离时必须配置此项,
#不允许为空并要与节点的地址配置顺序完全一致。
#各个节点名称之间用逗号分隔,如:nodeList=node1,node2,node3。
nodeList=node1,node2,node3

#在新建连接时检查当前连接DB是不是Master,如果不是回去slave
#检查有没有Master,如果还是找不到Master就会向上报错
MASTER_CHECK=true

#失败重发的最高次数
RETRYTIMES=20
#失败重发每次的间隔时间(单位:秒)
RETRYINTERVAL=5
#监测线程每次监测的间隔时间(单位:秒)
MONITORINTERVAL=5
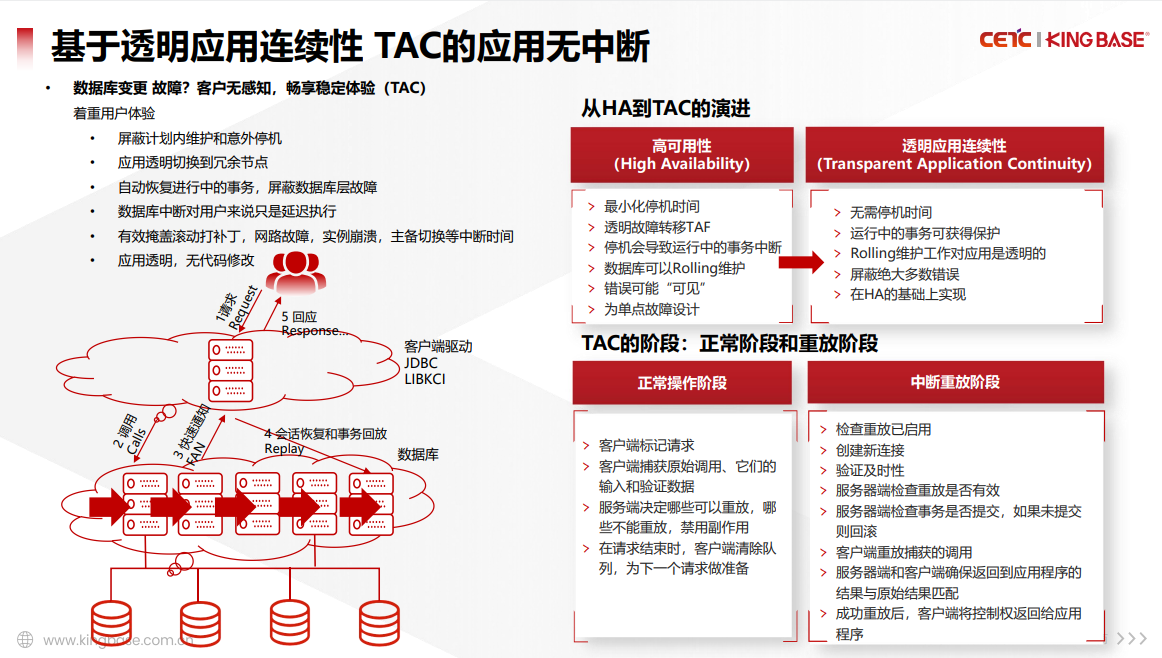
值得一提的事情是上次KING大咖太原站,金仓原厂的架构师讲述了金仓数据库也有类似 Oracle 的 TAC 透明应用连续性,并分享了和我上面说的差不多的内容,具体内容见如下PPT图,但遗憾的事我在官网搜“透明应用连续性”没有找到任何内容,后续有时间的话继续跟进测试一把,如有最新消息可查看我公众号就行。
KES常见故障案例
对于 KES RWC 使用经验也不是很多,作为一个初学者这里也分享三个比较经典的故障案例来为伙伴们避坑,个人能力有限,如有错误还请指正,谢谢!
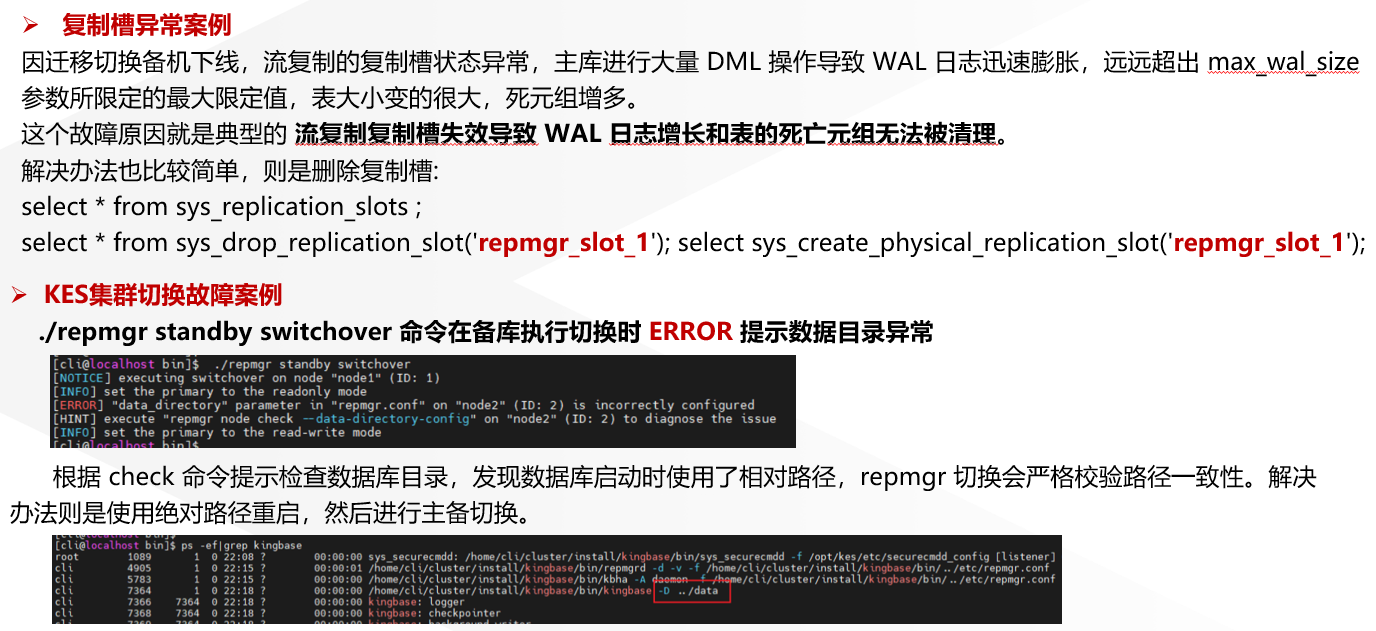
- 复制槽异常案例
因迁移切换备机下线,流复制的复制槽状态异常,主库进行大量 DML 操作导致 WAL 日志迅速膨胀,远远超出 max_wal_size 参数所限定的最大限定值,表大小变的很大,死元组增多。
这个故障原因就是典型的 流复制复制槽失效导致 WAL 日志增长和表的死亡元组无法被清理。
解决办法也比较简单,则是删除复制槽:
select * from sys_replication_slots ;

select * from sys_drop_replication_slot('repmgr_slot_1');

select sys_create_physical_replication_slot('repmgr_slot_1');- KES集群切换故障案例
./repmgr standby switchover 命令在备库执行切换时 ERROR 提示数据目录异常
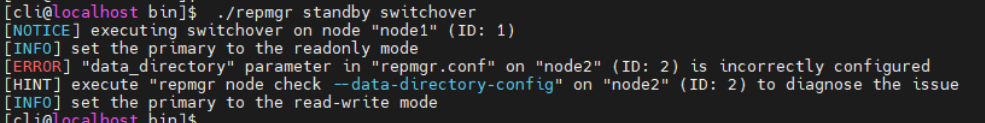
根据 check 命令提示检查数据库目录,发现数据库启动时使用了相对路径,repmgr 切换会严格校验路径一致性。解决办法则是使用绝对路径重启,然后进行主备切换。

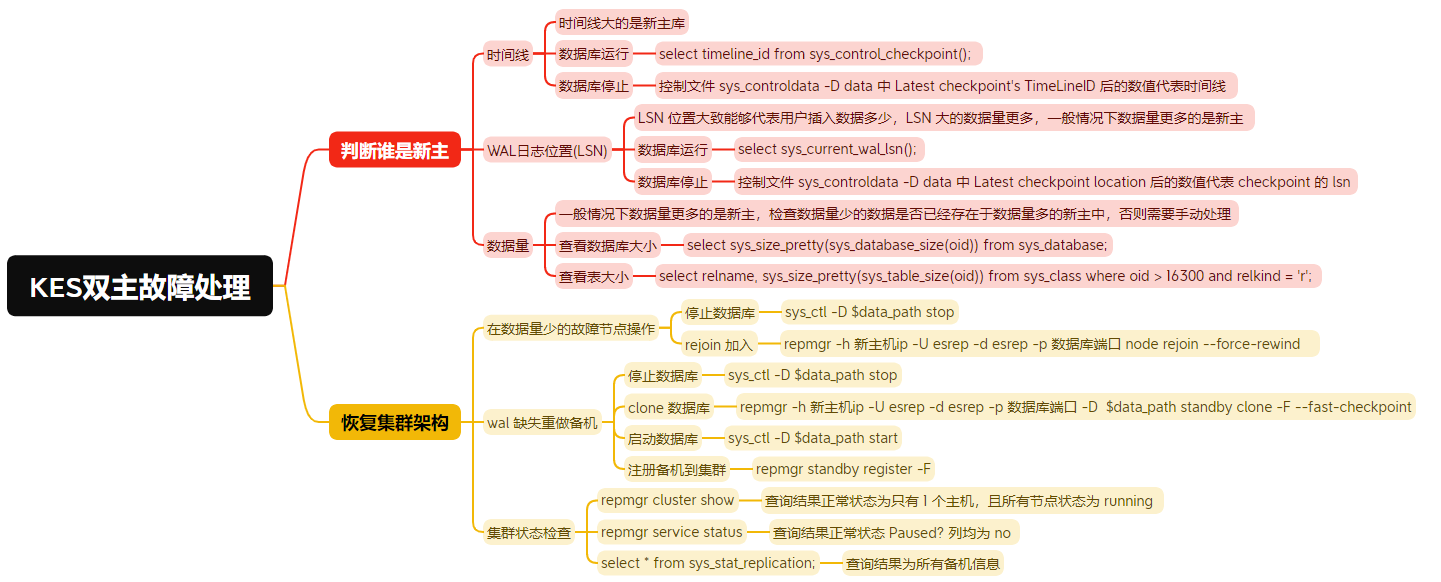
- KES集群双主故障案例
对于因网络故障或主从切换造成的“双主”故障时,我们需要分情况手动处理,大概流程如下所示:
参考链接
https://www.oracle.com/cn/a/tech/docs/technical-resources/farsync.pdf
https://docs.oracle.com/database/121/SBYDB/create_fs.htm#SBYDB5416
https://docs.oracle.com/en/database/oracle/oracle-database/23/sbydb/creating-oracle-data-guard-far-sync-instance.html
https://www.kingbase.com.cn/solution/details_658_30346.html
https://bbs.kingbase.com.cn/docHtml?recId=d16e9a1be637c8fe4644c2c82fe16444&url=aHR0cHM6Ly9iYnMua2luZ2Jhc2UuY29tLmNuL2tpbmdiYXNlLWRvYy92OS9oaWdobHkvYXZhaWxhYmlsaXR5L2luZGV4Lmh0bWw
https://bbs.kingbase.com.cn/docHtml?recId=d16e9a1be637c8fe4644c2c82fe16444&url=aHR0cHM6Ly9iYnMua2luZ2Jhc2UuY29tLmNuL2tpbmdiYXNlLWRvYy92OS9oaWdobHkvYXZhaWxhYmlsaXR5L2NsdXN0ZXItc3dpdGNoL2luZGV4Lmh0bWw
全文完,希望可以帮到正在阅读的你,如果觉得有帮助,可以分享给你身边的朋友,同事,你关心谁就分享给谁,一起学习共同进步~~~
欢迎关注我的公众号【JiekeXu DBA之路】,一起学习新知识!
——————————————————————————
公众号:JiekeXu DBA之路
墨天轮:https://www.modb.pro/u/4347
CSDN :https://blog.csdn.net/JiekeXu
ITPUB:https://blog.itpub.net/69968215
腾讯云:https://cloud.tencent.com/developer/user/5645107
——————————————————————————