



查询优化器的基本承诺是选择“最优”查询计划。但有一个问题——计划的选择依赖于成本估算,该估算是根据选择性估算和基本资源(I/O、CPU 等)的成本计算得出的。所以问题是,我们实际上多久会选择一次“最快”的计划?事实上,我们经常会犯错。
考虑下图,其中显示了一个SELECT带有范围条件的简单查询的持续时间。查询条件会根据表格的不同比例进行调整,如 x 轴所示(包含匹配行的页面比例)。该计划会通过 enable_选项强制使用不同的扫描方法,而暗点标记的意思是,即使不使用参数,扫描方法也会“获胜” enable_。
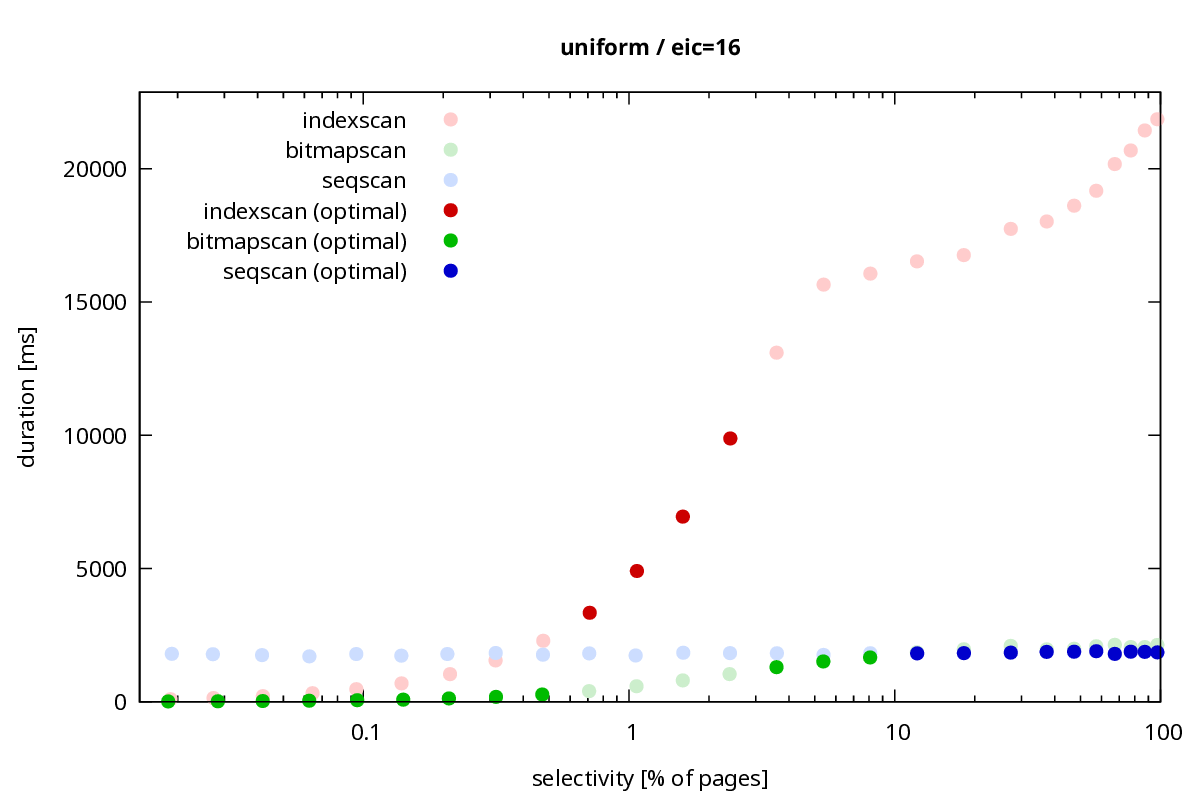
它显示,当选择性约为 1-5% 时(x 轴为对数),规划器会选择索引扫描,但这恰好是一个糟糕的选择。它最多需要 10 秒,而一个简单的“愚蠢”顺序扫描可以在 2 秒内完成查询。
这很好地证明了为什么尝试到处进行索引扫描是毫无意义的,而应用程序开发人员有时却希望这样做。
1% 的选择性相当高,但对于较低的选择性来说,差别不大。图表上看不太清楚,但让我们将 y 轴切换到对数刻度,以便更好地查看低选择性:
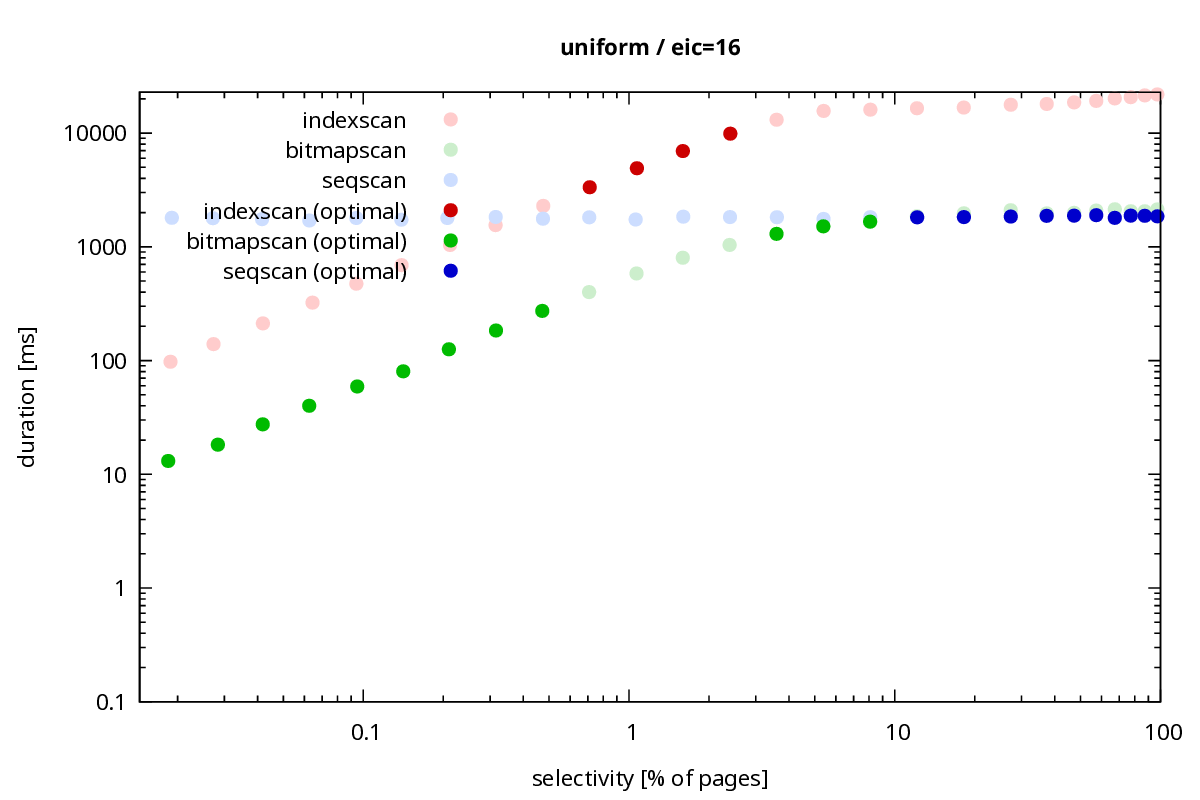
索引扫描在这个查询中根本占不到优势!即使在最严格的条件下,位图扫描也占据了主导地位,大约是后者的 10 倍。规划器确实正确地选择了位图扫描,所以这很好。
注意:原因很简单——位图扫描会执行预取,而索引扫描则不会。禁用预取(或者使用我正在开发的带索引预取功能的补丁)可以消除这种差异。
上面的图表针对的是均匀数据集,这有点极端。一方面,它的估算值计算最简单。我们甚至在某些地方假设了均匀性/独立性。另一方面,它的数据局部性最差。
那么,其他具有不同相关模式的数据分布又如何呢?我用一些数据集运行了此方法,这里给出了几个示例。我将分别展示每个数据集的常规和对数刻度图表。
注意:有关测试的详细信息,请参阅create.sql SQL 脚本(其中创建了所有数据集)和主测试脚本 run-test.sh。
循环模式,随机性强度为1
首先,“循环”加上一点点“模糊”增加了随机性。
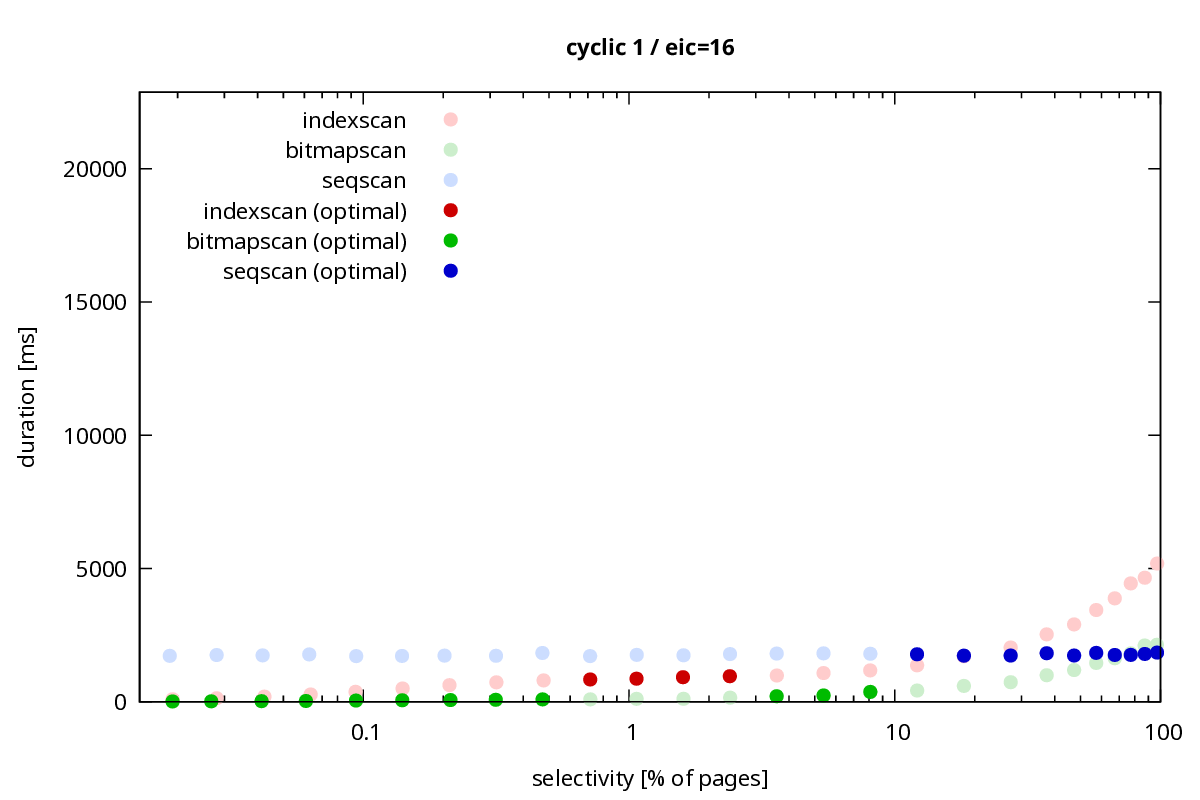
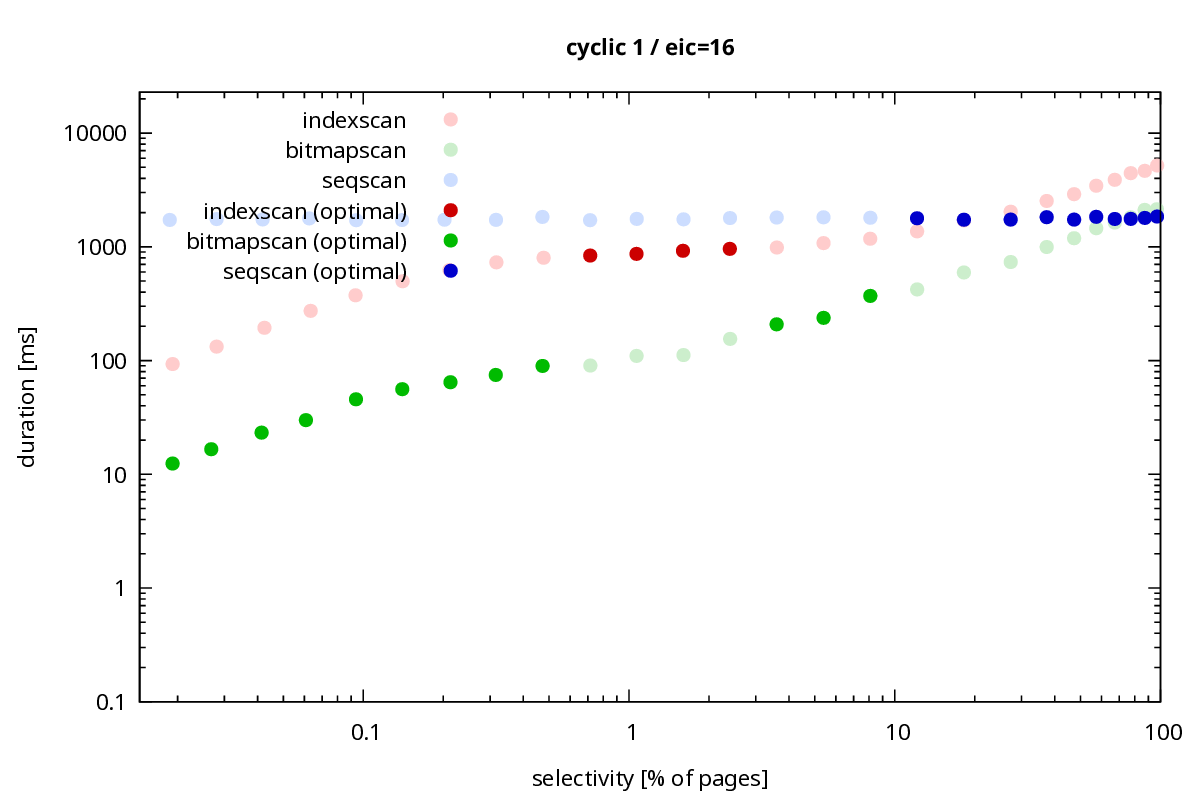
这(可能)比统一数据集好一点,但我们仍然犯了一些错误。我们暂时切换到索引扫描,而不是坚持使用位图扫描。然后我们过早地切换到了顺序扫描。
线性,随机性强度为10
首先是“线性”数据集,其中有 10 倍的“模糊”增加了随机性。
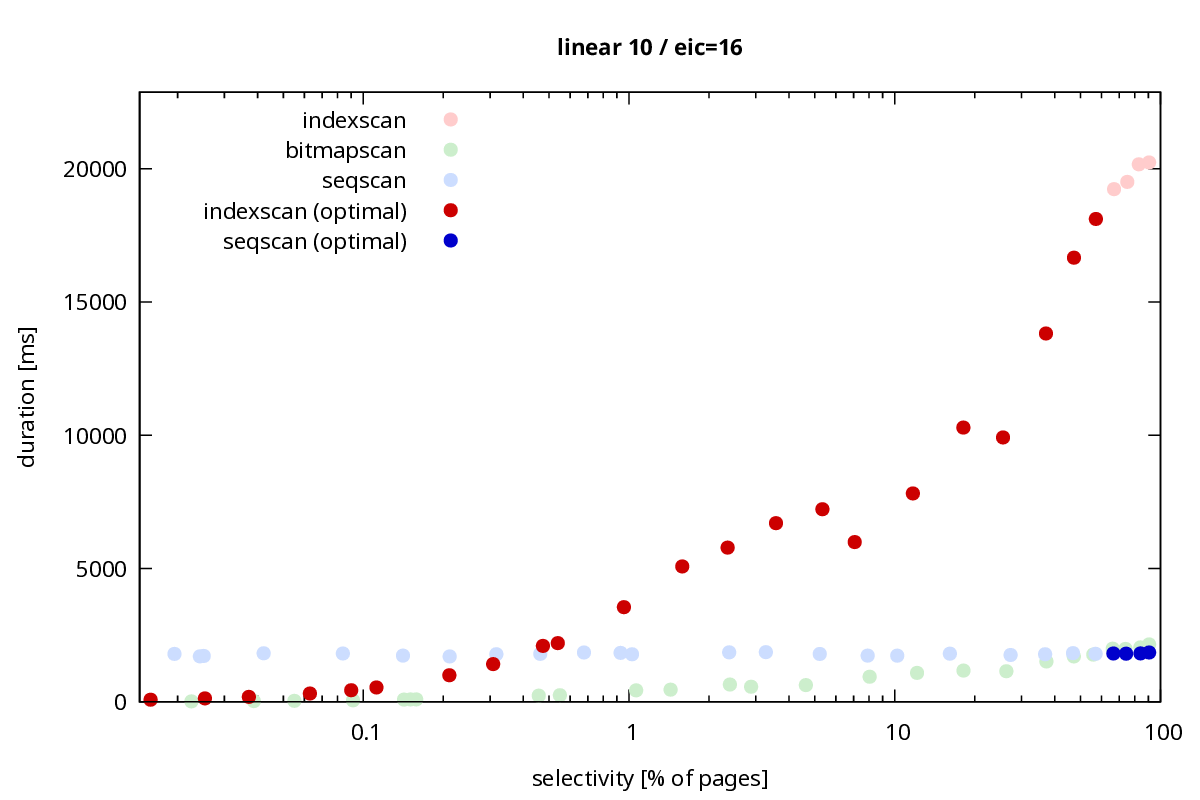
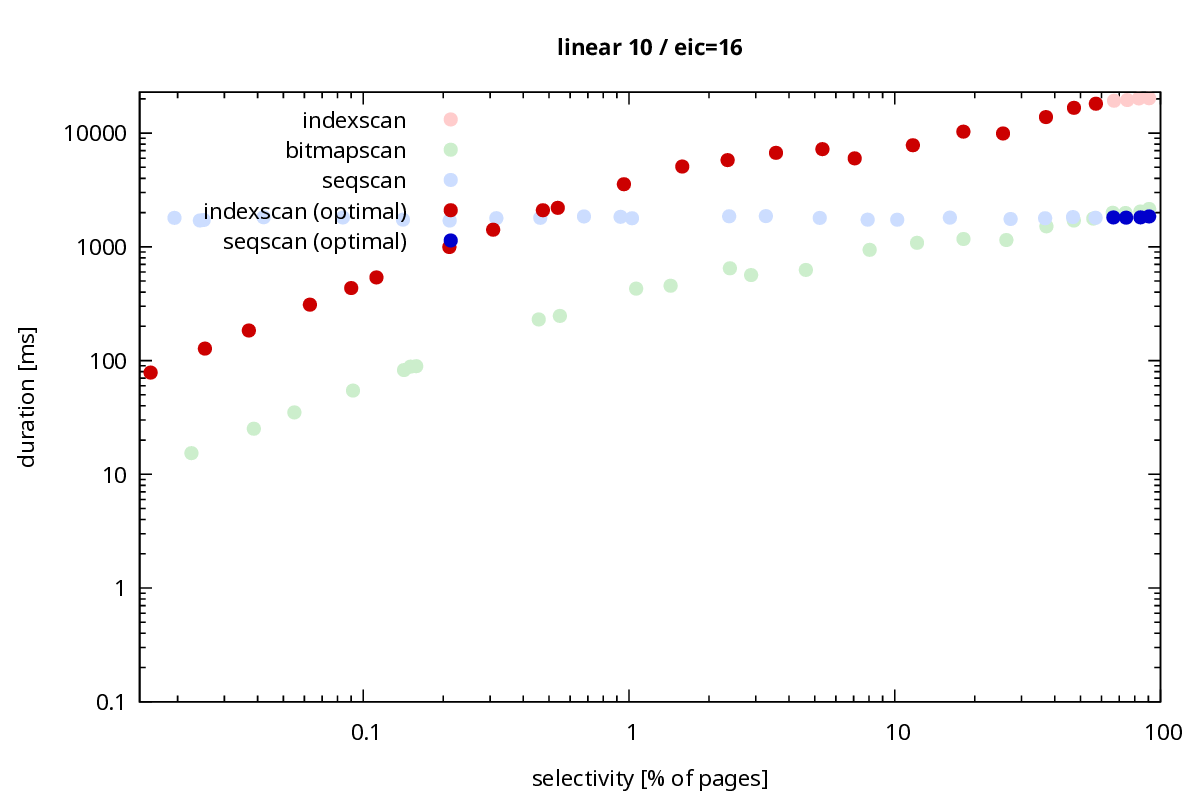
效果不太好,明显比我们在均匀分布图上看到的更差。规划器在选择索引扫描方面更加坚持,即使在低选择性的情况下也是如此(均匀分布图上它会选择位图扫描)。而且这些决策都不是最优的——位图扫描会是更好的选择。只有在最后(选择性约为 90%),计划才会正确地切换到顺序扫描。
线性(无随机性)
最后,一个完全线性的数据集——单调递增的值。这恰好是我们始终选择正确(实际上是最快的)计划的唯一情况。
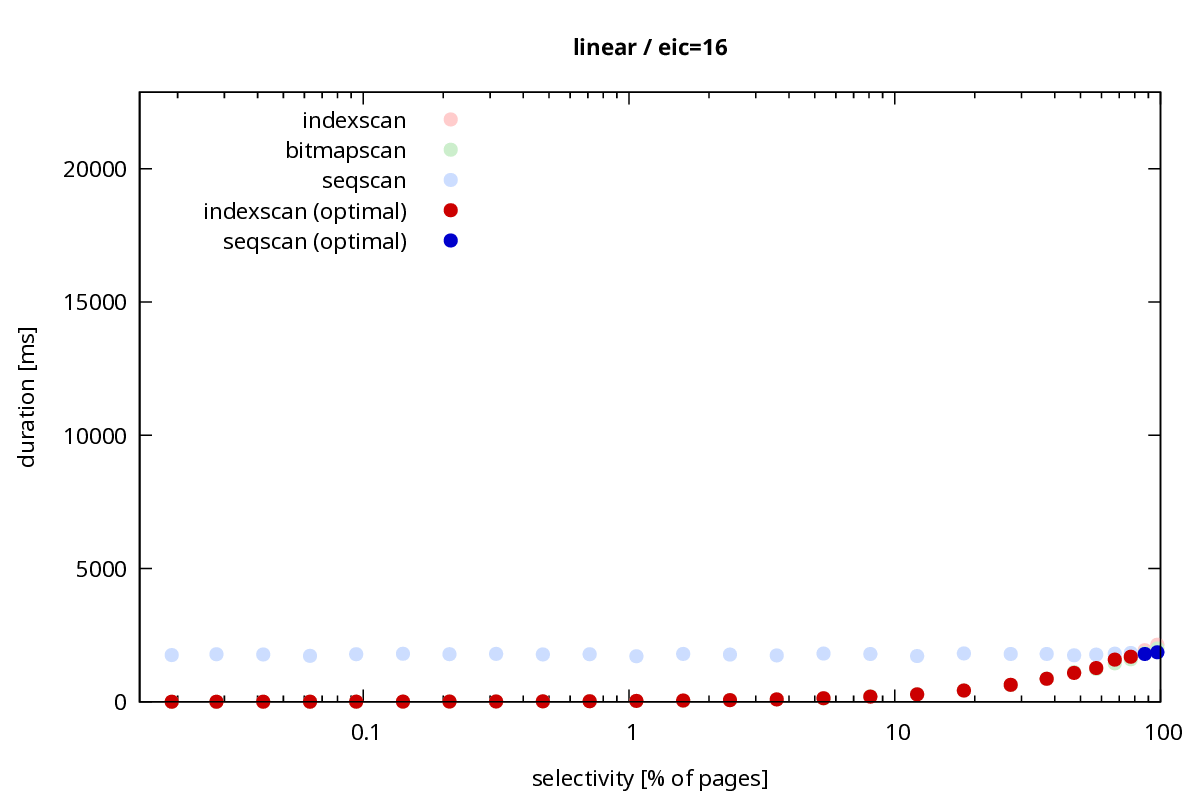
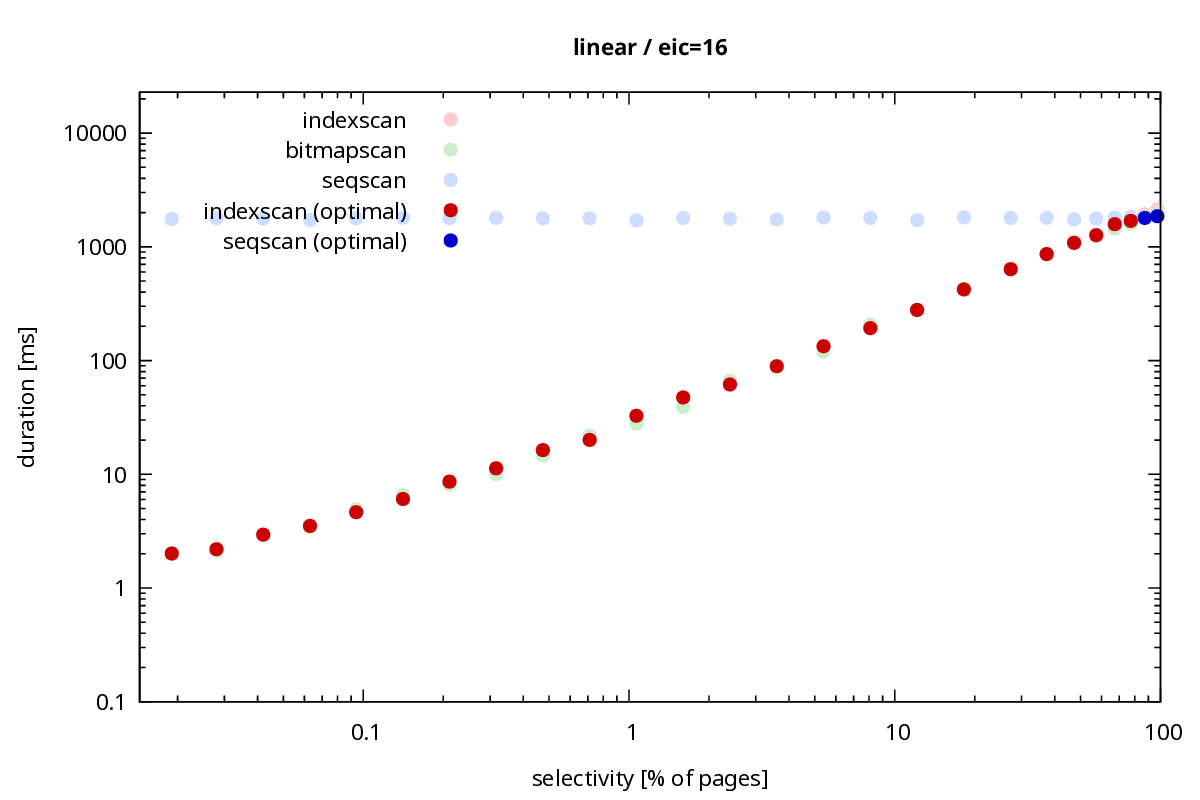
索引扫描和位图扫描之间几乎没有区别。数据集非常适合内核预读,手动预取不会带来任何好处。切换到顺序扫描也恰到好处(即使不切换,索引扫描也能正常工作)。
总结
以上结果来自搭载 Ryzen 9900X 和 NVMe RAID 的机器。我在其他硬件(例如 SATA SSD)上也得到了更多结果,但总体表现完全相同。
本次运行使用的是冷缓存(页缓存和共享缓冲区中没有任何数据)。使用热缓存后,一些差异会消失,或者至少变得不那么明显。例如,索引扫描和位图扫描之间的所有差异都消失了,因为预取操作对缓存中的所有数据几乎没有影响。
我想表达的观点是,规划器会根据统计数据和成本模型,选择它认为最优的方案。如果它真的是最优方案,那就太好了,但它可能并非如此,而且通常并非如此。我们所能期望的最好结果就是不要离最优方案太远。
这可能不会立即显现出来,因为你怎么知道有更好的计划?然后你就得手动强制执行这个计划了。大多数用户只是信任数据库,只有在不同计划之间的阈值处选择性才会注意到这一点。这就是“悬崖”发生的地方,当查询在性能差异巨大的不同计划之间切换时。
或许可以调整一些成本参数,以便更频繁地获得更好的计划。我的经验是,对一个分布的数据集有效的方法可能会损害另一个数据集。完美地配置所有数据集几乎是不可能的。
此外,测试使用的查询非常简单——单表查询,SELECT只有一个范围WHERE条件。对于更复杂的查询(例如,连接具有不同数据分布的表),其行为会更加复杂。
有没有可行的方法来改进这一点?为了提高速度,规划必须依赖于非常紧凑/小的数据表示(优化统计)。而这些统计必然只是数据的简化表示。我们可以改进这一点,添加更多统计信息(例如,关于列之间相关性等),但这始终是一种有损压缩,并且总会遗漏一些有趣的细节。
还有成本模型本身的问题,它只是对硬件行为的一个非常粗略的近似。对于本地系统来说,它已经很粗糙了,而在具有复杂存储系统等的云环境中,它似乎就更不准确了。
这似乎是基于成本的规划面临的一个相当根本的挑战。我相信我们可以改进各个步骤(更好的统计数据、更好的成本模型),但总会有一些细节缺失。
话虽如此,我仍然认为基于成本的计划是目前最好的方法。因为还有什么更好的选择呢?当然不是硬编码的计划,也不是基于规则的计划。但它提醒了我计划稳健性的重要性,甚至如果我们发现查询计划不太合适,也许可以有办法调整它。
原文地址:https://vondra.me/posts/how-often-is-the-query-plan-optimal/
原文作者:Tomas Vondra
