



点击蓝字,关注我们
1
为什么需要DolphinScheduler?
(解决小白认知痛点)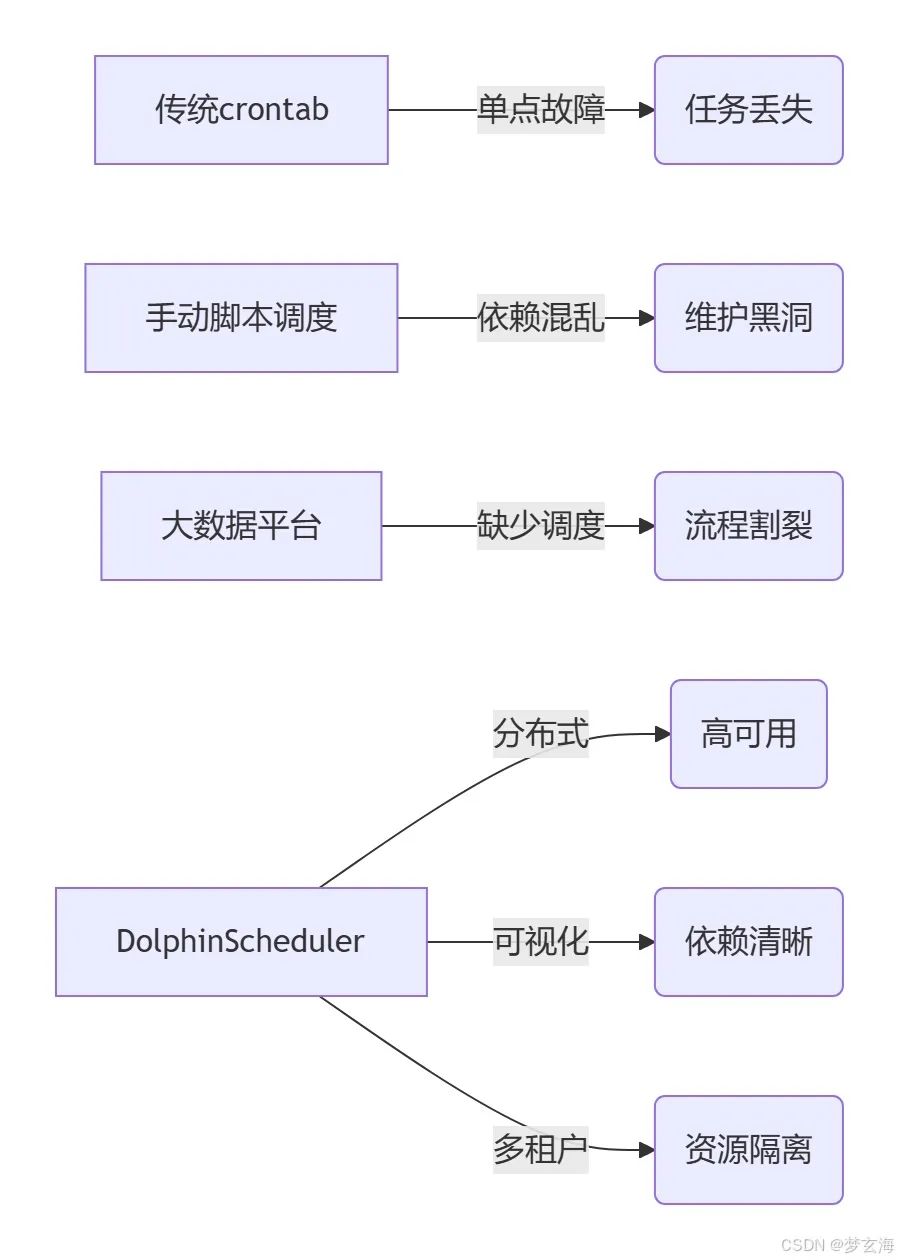
2
3分钟极速部署(小白友好版)
环境准备
最低配置(开发环境)
JDK 8+
MySQL 5.7+
Zookeeper 3.8+
Docker一键启动(避坑推荐)
docker run -d --name dolphinscheduler \
-e DATABASE_TYPE=mysql \
-e SPRING_DATASOURCE_URL="jdbc:mysql://localhost:3306/ds?useUnicode=true&characterEncoding=UTF-8" \
-e SPRING_DATASOURCE_USERNAME=root \
-p 12345:12345 \
apache/dolphinscheduler:3.2.0
3
核心概念可视化解析
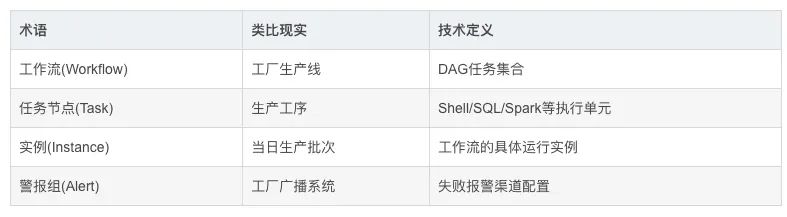
4
手把手创建第一个工作流
(含代码段)
场景:每日用户行为分析
步骤1:登录控制台
http://localhost:12345/dolphinscheduler (默认账号admin/dolphinscheduler123)
步骤2:创建工作流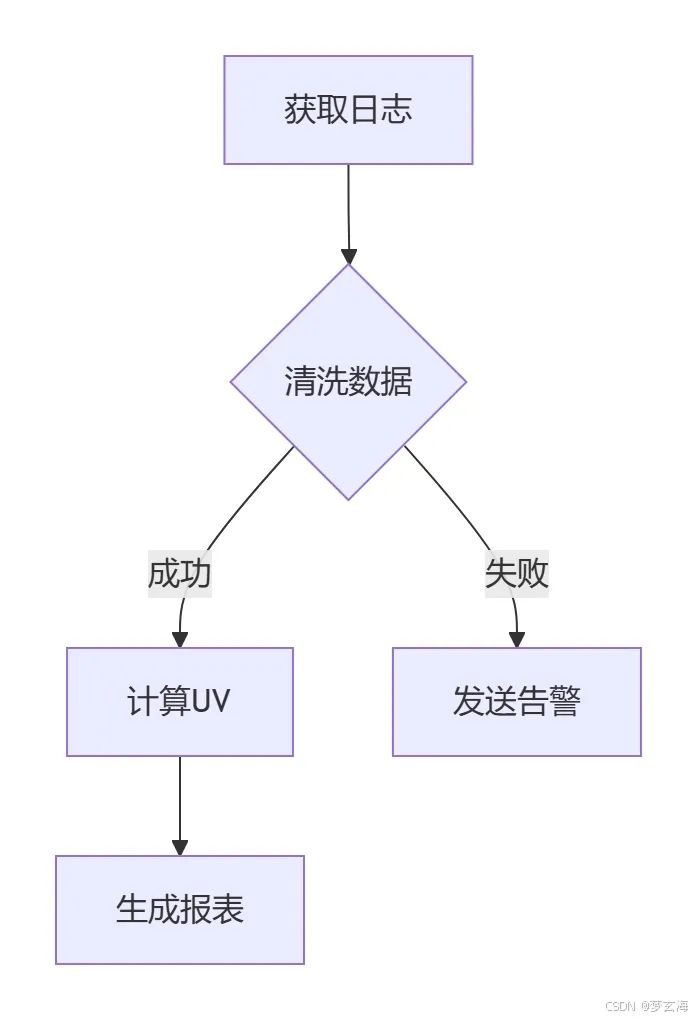
步骤3:配置Shell任务(关键代码)
shell
#!/bin/bash
# 参数自动注入示例
spark-submit \
  --master yarn \
  --name behavior_analysis_${sys_date} \  # 系统动态参数
  opt/jobs/user_analysis.py ${begin_date} ${end_date}
步骤4:设置调度策略
cron
0 2 * * *   # 每天凌晨2点执行(支持Quartz表达式)
5
高级特性解锁(小白也能用)
1. 参数透传(跨任务传值)
python
# 在Python节点中获取上游输出
context.getUpstreamOutParam('uv_count')
yaml
# workflow定义片段
task_retry_interval: 300  # 5分钟重试
retry_times: 3            # 最多重试3次
3. 条件分支(动态路由)
shell
# 根据日期判断是否周末
if [ ${week} -gt 5 ]; then
   echo "skip weekend processing"
   exit 0
fi
6
避坑指南(来自生产实践)
1. 资源错配:Spark任务内存溢出 → 在conf/worker.properties调整:
properties
worker.worker.task.resource.limit=true
worker.worker.task.memory.max=8g  # 根据集群配置调整
2. 时区陷阱:定时任务延迟8小时 → 修改common.properties
:
properties
spring.jackson.time-zone=GMT+8
7
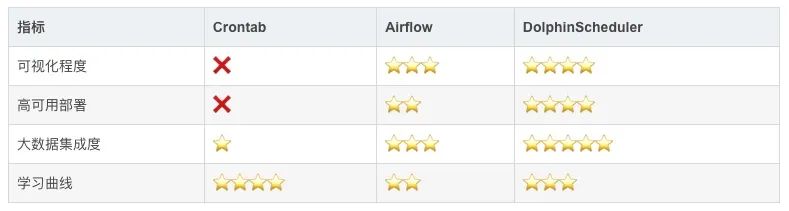
效能对比(说服力数据)
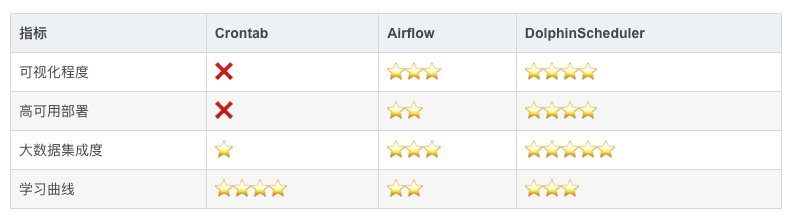
8
写在最后
DolphinScheduler正成为大数据调度领域的事实标准,其云原生架构和操作友好的界面,让开发者从繁琐的流程管控中解放出来。建议初学者从本文示例出发,逐步探索其跨集群任务分发、K8s集成等高级能力。
原文链接:https://blog.csdn.net/2501_91980039/article/details/148811445
用户案例
迁移实战
发版消息
加入社区
关注社区的方式有很多:
GitHub: https://github.com/apache/dolphinscheduler 官网:https://dolphinscheduler.apache.org/en-us 订阅开发者邮件:dev@dolphinscheduler@apache.org X.com:@DolphinSchedule YouTube:https://www.youtube.com/@apachedolphinscheduler Slack:https://join.slack.com/t/asf-dolphinscheduler/shared_invite/zt-1cmrxsio1-nJHxRJa44jfkrNL_Nsy9Qg
同样地,参与Apache DolphinScheduler 有非常多的参与贡献的方式,主要分为代码方式和非代码方式两种。
📂非代码方式包括:
完善文档、翻译文档;翻译技术性、实践性文章;投稿实践性、原理性文章;成为布道师;社区管理、答疑;会议分享;测试反馈;用户反馈等。
👩💻代码方式包括:
查找Bug;编写修复代码;开发新功能;提交代码贡献;参与代码审查等。
你的好友秀秀子拍了拍你
并请你帮她点一下“分享”
