



适用版本:【9.1.0.100(及以上)】
查询过滤器在9.1.0.100
之前就具备提供查询过滤功能的能力,但仅支持自动隔离反复查询被终止的查询,防止烂SQL再次执行。
老版本主要面向异常熔断机制和紧急拦截场景,前者可以与异常规则联动,自动将触发异常规则的语句添加到黑名单中,后者是需要手动找到core或者引发hang的语句进行屏蔽。
9.1.0.100
及9.1.0.200
版本对查询过滤器做了功能的改进,可以通过多维度进行烂SQL识别,功能更丰富,配置更灵活。
在原理介绍之前,先举个简单的例子。
在业务开发过程中,要想禁止对2张以上的表进行关联查询,此时可以使用DDL语句创建过滤规则:
CREATE BLOCK RULE forbid_2_t_sel FOR SELECT FILTER BY SQL('test_block_rule') with(table_num='2');
table_num
指的是一个语句中出现的表的个数,此时所有查询语句不能包含有两张表以上的查询。
--两张表直接关联查询,可以正常执行
postgres=# select * from test_block_rule1 t1 join test_block_rule2 t2 on t1.c1=t2.c2;
 c1 | c2 | c1 | c2
----+----+----+----
(0 rows)

--三张表直接关联查询,被拦截
postgres=# select * from test_block_rule1 t1 join test_block_rule2 t2 on t1.c1=t2.c2 join test_block_rule3 t3 on t2.c1=t3.c1;
ERROR:  hit block rule forbid_2_t_sel(block_type: SELECT, regexp_sql: test_block_rule, table_num: 2(3))
说到这,整体逻辑就非常清楚了。用户可以提前识别烂SQL的特征,然后抽象出来,用DDL语句创建规则,后续会对查询的语句进行过滤,被规则筛选出来的便是烂SQL,执行前会报错,反之则可以正常执行。
查询过滤器框架及功能原理概况:
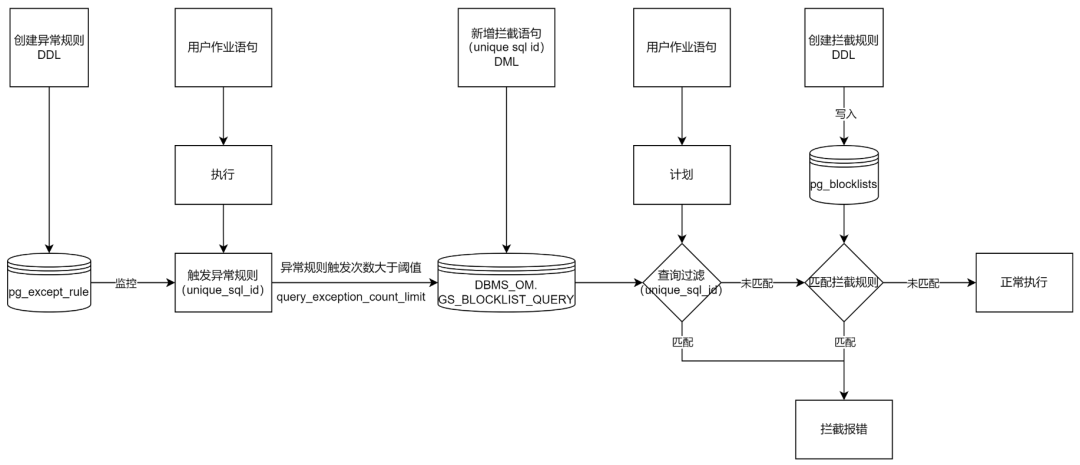
从图中可以看出,之前的查询过滤器的功能依然存在,可以保证与异常规则的联动,新版本的增强更注重规则的灵活性和功能的丰富性。
3.1 查询过滤规则元数据管理
查询过滤规则,可以通过DDL进行新增、删除或者修改,其语法如下:
(1)创建
CREATE BLOCK RULE [ IF NOT EXISTS ] block_name
    [ [ TO user_name@'host' ] | [ TO user_name ] | [ TO 'host' ] ] |
    [ FOR UPDATE | SELECT | INSERT | DELETE | MERGE ] |
    FILTER BY
    { SQL ( 'text' ) | TEMPLATE ( template_parameter = value ) }
    [ WITH ( { with_parameter = value }, [, ... ] ) ];
其中,
block_name: 过滤规则的名称
user_name: 规则应用的对象用户
host: 是规则应用的客户端IP
FOR: 语句类型,支持对UPDATE/SELECT/INSERT/DELETE/MEGE INTO五种类型语句进行限制
FILTER BY: 过滤方法,包含两种形式
SQL: 根据关键词对语句进行正则匹配,例如表名,其长度不能超过1024,建议尽量精简
TEMPLATE:sql_hash:归一化的哈希值(md5),一般不会重复,相较unique_sql_id更推荐使用。unique_sql_id:归一化的64位哈希值,重复概率较sql_hash大一些。
with_parameter: 查询过滤规则选项参数,可以附加多个条件,满足其一便会匹配过滤。
application_name: 客户端名称
query_band: 负载标识
table_num: 包含的基表个数
partition_num: 扫描分区的数量
estimate_row: 基表输出行数
resource_pool: 切换的目标资源池,仅适用于
9.1.0.200
及以上max_active_num: 可并发执行的语句个数,仅适用于
9.1.0.200
及以上is_warning: 改变拦截行为为告警,而非默认的报错,仅适用于
9.1.0.200
及以上
其中,user_name
和FILTER BY
是必选项,其他可以通过业务实际需要进行配置。
(2)修改
ALTER BLOCK RULE block_name RENAME to new_block_name;
通过rename
对查询过滤的规则进行重命名。
ALTER BLOCK RULE block_name
    [ [ TO user_name@'host' ] | [ TO user_name ] | [ TO 'host' ] | [ TO DEFAULT ] ] |
    [ FOR UPDATE | SELECT | INSERT | DELETE | MERGE | DEFAULT ] |
    [ [ FILTER BY ]
    [ { SQL ( 'text' ) | TEMPLATE ( template_parameter = value ) } ] ]
    [ WITH ( { with_parameter = value }, [, ... ] ) ];
所有选项均支持二次修改,如果需要去除部分字段的限制,可以指定default
关键词,例如:
--修改为只能查询1张表
postgres=# ALTER BLOCK RULE forbid_2_t_sel with(table_num='1');
ALTERBLOCK RULE
postgres=# select * from test_block_rule1 t1 join test_block_rule2 t2 on t1.c1=t2.c2;
ERROR:  hit block rule forbid_2_t_sel(block_type: SELECT, regexp_sql: test_block_rule, table_num: 1(2))
postgres=# select * from test_block_rule1 t1;
 c1 | c2
----+----
(0rows)

--去除查询中表个数的限制
postgres=# ALTER BLOCK RULE forbid_2_t_sel with(table_num=default);
ALTERBLOCK RULE
--再次查询报错拦截
postgres=# select * from test_block_rule1 t1;
ERROR:  hit block rule forbid_2_t_sel(block_type: SELECT, regexp_sql: test_block_rule)
(3)删除
DROP BLOCK RULE [ IF EXISTS ] block_name;
3.2 权限问题
对于普通用户来讲是没有创建查询过滤规则权限的,需要管理员或者管理员将权限赋给某一普通用户才可以。
--切换至普通用户
postgres=# set role jack password 'xxx';
SET
--创建查询过滤规则报错提示无权限
postgres=> createblock rule bl2 filter bysql('test');
ERROR:  CREATE/ALTER/DROPBLOCK RULE permission denied forcurrentuser
--重置user
postgres=> resetrole;
RESET
--对普通用户进行授权
postgres=# grant gs_role_block to jack;
GRANTROLE
--切换普通用户
postgres=# set role jack password 'xxx';
SET
--再次创建成功
postgres=> createblock rule bl2 filter bysql('test');
CREATEBLOCK RULE
建议创建查询过滤规则时尽量缩小适用范围,避免误过滤,或者范围过大导致性能劣化。
3.3 备份恢复
对于查询过滤规则的备份或者恢复的权限与操作元数据的权限一致,需要管理员或者管理员讲权限赋值给某一普通用户才可以,用户可以通过gs_dump
导出查询过滤规则定义。
如果想查看或者导入查询过滤规则的定义,可以通过pg_get_blockruledef
进行查询。
postgres=# select * from pg_get_blockruledef('test');
                         pg_get_blockruledef
----------------------------------------------------------------------
 CREATE BLOCK RULE test FILTER BY SQL('test') WITH(estimate_row='3');
(1 row)
所有的查询过滤规则元数据全部保存在pg_blocklists
系统表中,可以通过查看系统表浏览所有的查询过滤规则。
3.4 使用举例
(1)使用关键词进行查询过滤
CREATE BLOCK RULE bl1
To block_user
FOR SELECT
FILTER BY SQL ('tt')
WITH(partition_num='2',
     table_num='1',
     estimate_row='5'
     );

postgres=> select * from tt;
ERROR:  hit block rule bl1(user_name: block_user, block_type: SELECT, regexp_sql: tt, partition_num: 2(3), table_num: 1(1), estimate_row: 5(1))
从上面的查询可以看出,查询语句包含了tt
关键字,并且扫描的分区个数超过了2
,此时执行语句被过滤拦截。
需要注意的是,扫描分区的个数并不总是准确的,仅能识别静态的分区剪枝个数,执行过程中的动态剪枝并不能被识别。
小技巧: 使用关键词过滤时可以先使用正则匹配符~*
进行测试,正则匹配是忽略大小写的。
另外,由于查询过滤器的规则直接作用在用户block_user
上,因此在删除用户block_user
时,会提示有依赖项,此时可以通过在语句最后加上cascade
进行删除,此时作用在此用户上的查询过滤规则也会被一同删除。
受限于篇幅,其他选项就不再一一列举。需要注意的是,过滤规则命中的依据是,with_parameter
命中任意一项,且其他字段的特征也符合即会判定为符合查询过滤规则。
特别注意,不同的计划,可能部分字段无法按照预期进行拦截,例如:
postgres=# create block rule test filter by sql('test')with(estimate_row='3');
CREATEBLOCK RULE
postgres=# select * from test;
 c1 | c2
----+----
1 |  2
1 |  2
1 |  2
1 |  2
1 |  2
(5rows)
此时,语句关键字是可以匹配上的,查询的行数也超过了3行的限制,那为什么无法拦截呢?
postgres=# explain verbose select * from test;
                                          QUERY PLAN
-----------------------------------------------------------------------------------------------
  id |                  operation                   | E-rows | E-distinct | E-width | E-costs
 ----+----------------------------------------------+--------+------------+---------+---------
   1 | ->  Data Node Scan on "__REMOTE_FQS_QUERY__" |      0 |            |       0 | 0.00

      Targetlist Information (identified by plan id)
 --------------------------------------------------------
   1 --Data Node Scan on "__REMOTE_FQS_QUERY__"
         Output: test.c1, test.c2
         Node/s: All datanodes (node_group, bucket:16384)
         Remote query: SELECT c1, c2 FROM public.test
通过计划可以看出,此时是FQS
计划,导致没有估算信息。因此此时无法进行拦截,对于CN轻量化的计划也是一样的,如果我们让语句强制走stream计划
,那么就可以拦截成功:
postgres=# set enable_stream_operator=on;
SET
postgres=# set enable_fast_query_shipping=off;
SET
postgres=# select * from test;
ERROR:  hit block rule test(regexp_sql: test, estimate_row: 3(5))
postgres=#  explain verbose select * from test;
                                       QUERY PLAN
-----------------------------------------------------------------------------------------
id |               operation                | E-rows | E-distinct | E-width | E-costs
----+----------------------------------------+--------+------------+---------+---------
   1 | ->  Row Adapter                        |      5 |            |       8 | 69.00
   2 |    ->  Vector Streaming (type: GATHER) |      5 |            |       8 | 69.00
   3 |       ->  CStore Scanon public.test   |      5 |            |       8 | 59.01

      Targetlist Information (identifiedby plan id)
--------------------------------------------------------
   1--Row Adapter
         Output: c1, c2
   2--Vector Streaming (type: GATHER)
         Output: c1, c2
         Node/s: All datanodes (node_group, bucket:16384)
   3--CStore Scan on public.test
         Output: c1, c2
         DistributeKey: c1
所以,如果估算信息不准确,也会导致误拦截或者漏拦截的情况,因为计划的信息是通过估算得到的,因此这种情况无法避免。
(2)使用语句归一化特征值进行查询过滤
语句归一化的特征值,目前有两个,分别是unique_sql_id
和sql_hash
,两者均是对查询树进行哈希计算之后得出的,区别在于前者是64位哈希值,后者是md5值,因此前者的重复概率会大于后者,在使用时尽量使用sql_hash
进行过滤。
很多小伙伴会问,这两个值如何获取呢?两种方法:
查看explain结果
postgres=> explain verbose select * from tt where a>1;
                                              QUERY PLAN
----------------------------------------------------------------------------------------------------
   id |                     operation                     | E-rows | E-distinct | E-width | E-costs
----+---------------------------------------------------+--------+------------+---------+---------
    1 | ->  Row Adapter                                   |      1 |            |       8 | 16.00
    2 |    ->  Vector Streaming (type: GATHER)            |      1 |            |       8 | 16.00
    3 |       ->  Vector Partition Iterator               |      1 |            |       8 | 6.00
    4 |          ->  Partitioned CStore Scan on public.tt |      1 |            |       8 | 6.00

    Predicate Information (identified by plan id)
-------------------------------------------------
    3 --Vector Partition Iterator
          Iterations: 3
    4 --Partitioned CStore Scan on public.tt
          Filter: (tt.a > 1)
          Pushdown Predicate Filter: (tt.a > 1)
          Partitions Selected by Static Prune: 1..3

  Targetlist Information (identified by plan id)
----------------------------------------------
    1 --Row Adapter
          Output: a, b
    2 --Vector Streaming (type: GATHER)
          Output: a, b
          Node/s: datanode1
    3 --Vector Partition Iterator
          Output: a, b
    4 --Partitioned CStore Scan on public.tt
          Output: a, b

               ====== Query Summary =====
-----------------------------------------------------
  Parser runtime: 0.029 ms
  Planner runtime: 0.286 ms
  Unique SQL Id: 2229243778
  Unique SQL Hash: sql_aae71adfaa3d91bfe75499d92ad969e8
 (34 rows)
查看topsql记录
 queryid                     | 95701492082350773
 query                       | select * from tt where a>10;
 query_plan                  | 1 | Row Adapter  (cost=14.00..14.00 rows=1 width=8)
                             | 2 |  ->Vector Streaming (type: GATHER)  (cost=0.06..14.00 rows=1 width=8)
                             | 3 |   ->Vector Partition Iterator  (cost=0.00..4.00 rows=1 width=8)
                             |   |     Iterations: 2
                             | 4 |    ->Partitioned CStore Scan on public.tt  (cost=0.00..4.00 rows=1 width=8)
                             |   |      Filter: (tt.a > 10)
                             |   |      Pushdown Predicate Filter: (tt.a > 10)
                             |   |      Partitions Selected by Static Prune: 2..3
 node_group                  | installation
 pid                         | 139803379566936
 lane                        | fast
 unique_sql_id               | 2229243778
 session_id                  | 1732413324.139803379566936.coordinator1
 min_read_bytes              | 0
 max_read_bytes              | 0
 average_read_bytes          | 0
 min_write_bytes             | 0
 max_write_bytes             | 0
 average_write_bytes         | 0
 recv_pkg                    | 2
 send_pkg                    | 2
 recv_bytes                  | 3297
 send_bytes                  | 57
 stmt_type                   | SELECT
 except_info                 |
 unique_plan_id              | 0
 sql_hash                    | sql_aae71adfaa3d91bfe75499d92ad969e8
可以看出两种方法都可以轻松获取这两个语句归一化的特征值,explain
可以在事前提前获取,topsql
可以在语句执行后进行获取。
这个时候,可能很多小伙伴又会有疑问,语句中的条件有变化,是否会影响归一化的特征值呢?
答案是不会,因为归一化过程中会去除常量的影响,上述的举例中两个语句条件中的常量值并不相同,但归一化的特征值确实一样的。
(3)查询过滤的性能
由于语句的过滤,特别是关键词的正则匹配通常是比较耗时的,此时如果有过多的过滤规则,可能导致执行时间的劣化,特别是对于短查询可能影响更为明显。
本地实测: 正则匹配关键词长度1024,建立查询过滤规则1000条左右时,对于查询的影响在27.72ms左右,且如果考虑其他匹配项,可能影响会更大,所以,不建议添加太多的查询过滤规则。且业务稳定后可以只对特定开发或者新业务的用户创建查询过滤规则,此时查询过滤规则会优先通过绑定的用户跳过无效的过滤,减少对性能的性能的影响。
(4)过滤时间查看
可以配置GUC参数analysis_options
查看查询过滤规则对正常语句所消耗的时间。
set analysis_options='on(BLOCK_RULE)';

-- explain performance + query

                    User Define Profiling
-----------------------------------------------------------------
Segment Id: 3  Track name: Datanode build connection
      datanode1 (time=0.288 total_calls=1 loops=1)
      datanode2 (time=0.301 total_calls=1 loops=1)
      datanode3 (time=0.321 total_calls=1 loops=1)
      datanode4 (time=0.268 total_calls=1 loops=1)
Segment Id: 3  Track name: Datanode wait connection
      datanode1 (time=0.016 total_calls=1 loops=1)
      datanode2 (time=0.038 total_calls=1 loops=1)
      datanode3 (time=0.021 total_calls=1 loops=1)
      datanode4 (time=0.017 total_calls=1 loops=1)
Segment Id: 1  Track name: block rule checktime
      coordinator1 (time=0.028 total_calls=1 loops=1)
(5)拦截记录【仅适用于9.1.0.200
及以上】
创建查询过滤规则后会拦截很多烂SQL,如何看拦截的语句有哪些呢?可以通过topsql进行查看,abort_info
会记录拦截信息,也就是查询的报错信息。
postgres=# select abort_info,query from GS_WLM_SESSION_INFO where abort_info like '%hit block rule test%';
                        abort_info                         |        query
-----------------------------------------------------------+---------------------
 hit block rule test(regexp_sql: test, estimate_row: 3(5)) | select * from test;
(1 rows)
3.5 异常熔断应用示例
(1) 前提条件
CCN运行正常、功能正常。
用户配置自定义异常规则或触发默认异常规则。
作业异常熔断阈值query_exception_count_limit大于等于0。
(2) 操作示例
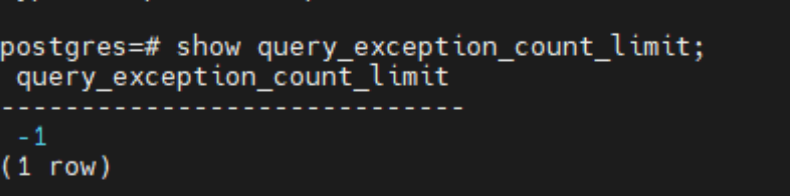
①设置异常熔断阈值。假设设置query_exception_count_limit=1,即只要作业触发异常规则作业就会被加入黑名单。
②配置异常规则。
创建CPU平均使用率异常规则cpu_percent_except,作业运行时间超过2000秒且CPU使用率达到30%时触发异常退出。
CREATE EXCEPT RULE cpu_percent_except WITH(ELAPSEDTIME=2000, CPUAVGPERCENT=30);
异常规则还支持BLOCKTIME、ALLCPUTIME、SPILLSIZE等异常的识别处理,具体可参见异常处理(查询规则)。
③创建资源池respool1关联异常规则cpu_percent_except。
CREATE RESOURCE POOL respool1 WITH(except_rule='cpu_percent_except');
资源池支持最多关联63个异常规则集,每个异常规则集间独立生效,互不影响。
④创建业务用户usr1。
CREATE USER usr1 RESOURCE POOL 'respool1' PASSWORD 'XXXXXX';
⑤用户usr1运行作业触发异常规则后作业被记录到黑名单。
创建的用户usr1运行作业,作业运行时间超过2000秒且CPU使用率达到30%时触发“cpu_percent_except”异常规则,作业触发异常规则后系统对作业进行以下处理:
将作业异常信息保存至系统表GS_BLOCKLIST_QUERY中。
如果作业触发异常熔断,将系统表GS_BLOCKLIST_QUERY中作业黑名单标志置为true。
更新GS_BLOCKLIST_QUERY中作业黑名单信息。
⑥查询作业黑名单和异常信息。
SELECT * FROM dbms_om.gs_blocklist_query;
 unique_sql_id | block_list | except_num |        except_time
---------------+------------+------------+----------------------------
    4066836196 | t          |          1 | 2022-08-08 18:00:00.596269
(1 row)
⑦用户usr1再次运行作业触发异常熔断,GaussDB(DWS)的异常熔断机制禁止该作业执行。
ERROR:  The query is in the blocklist and cannot be run, unique_sql_id(4066836196).
HINT:  If you want to run the query later, confirm the reason why the query is blocklisted and remove the query from the blocklist after resolving the problem.
⑧优化用户usr1所运行的SQL后,将ID为4066836196的SQL从黑名单移除。
确认SQL异常原因,如果异常规则配置不合理,修改异常规则;如果异常规则合理,对SQL进行优化后重新运行。确认问题解决后将SQL移除黑名单。
select gs_remove_blocklist(4066836196);
 gs_remove_blocklist
---------------------
 t
(1 row)
查询过滤器在9.1.0.100
和9.1.0.200
版本丰富了大量的功能,提高了烂SQL拦截的灵活性。
管控面后续版本同样可以直接通过前端页面对查询过滤规则进行管理,大家敬请期待。
我们将不断丰富和完善查询过滤功能,让烂SQL无门可入。
DWS最佳实践 | 轻松上手DWS!SQL编辑器一站式开发指南
最佳实践 | 打破方言壁垒!sql_dialect插件实现SQL自由兼容

 戳阅读原文,了解更多
