



引言
在大数据处理框架中,ORDER BY + LIMIT 是一个常见的“性能杀手”组合。全局排序操作往往意味着数据汇总、单点瓶颈与严重的数据倾斜。为了应对这一典型问题,PawSQL 引入了 GlobalSortingOptimization 重写算法,通过语义感知和查询改写的方式,将全局排序下推为分区排序 + 窗口函数,从根本上优化执行计划。本文将拆解这一优化规则的实现逻辑,揭示它如何在不影响查询语义的前提下,实现执行效率的飞跃。
一、优化动因:全局排序的数据倾斜陷阱
在 Hive 等批量处理系统中,以下 SQL 是造成性能瓶颈的典型代表:
SELECT *FROM sales_tableORDER BY amount DESCLIMIT 10;
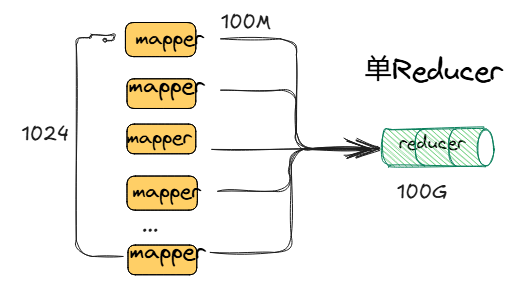
此类语句要求对整个数据集全局排序,并挑出前 N 条记录。在分布式环境下,它将:
强制所有数据经过单个 reducer 聚合; 导致长尾节点拖慢整体任务; 限制并行度,无法横向扩展; 对大表尤其致命,轻则慢,重则失败。
二、优化原理:分区窗口函数排序替代全局排序
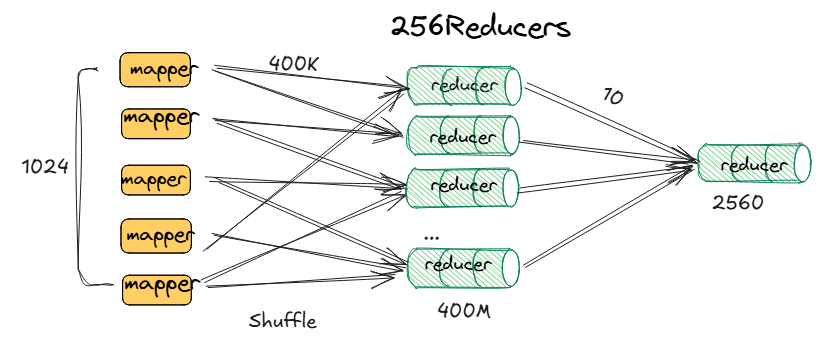
PawSQL 的优化思路基于一个核心转化:
将 “全局排序 + LIMIT” 转换为 “分区排序 + ROW_NUMBER + WHERE 过滤”。
实现如下目标:
- 借助窗口函数,将排序计算下推到每个分区
(全局排序→分区排序) - 分区键智能选择
(分桶键→主键→随机分区) - 双层过滤机制
(分区过滤+全局归并)
分区键智能推断机制
避免数据倾斜的关键在于 合理分区,PawSQL 按以下优先级自动选取分区字段:
- 分桶键:源表分桶键,优先选择,无需Shuffle数据;
- 主键列:唯一性保证,分布均匀;
- 外键列:一般具备较好基数,分布均匀;
- 首列字段:兜底选择;
- 随机函数:最后手段,如
CAST(RAND()*256 AS INT)
,确保均衡。
三、典型案例:优化前 vs. 优化后
最新版本的PawSQL能够自动探测此隐患问题,并基于上下文提供重写优化建议。
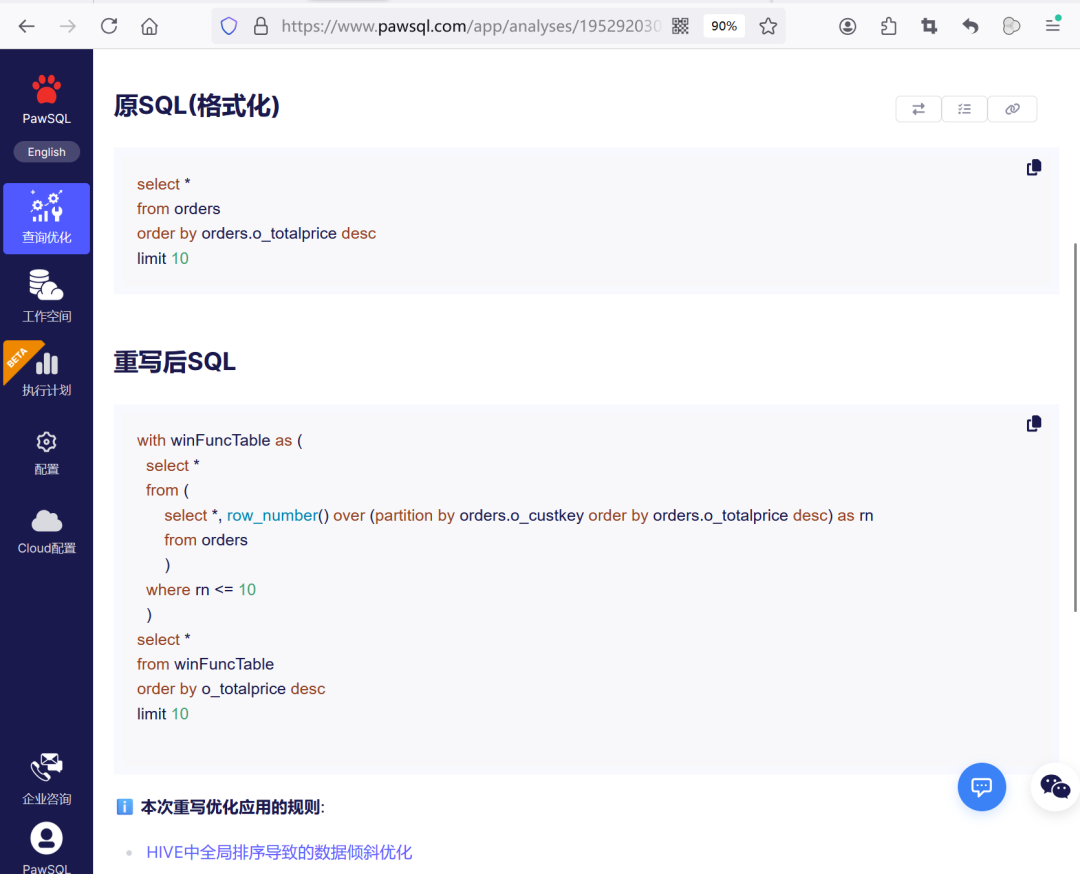
优化前
SELECT *FROM ordersORDER BY o_totalprice DESCLIMIT 10;
优化后
WITH winFuncTable AS (SELECT *FROM (SELECT*,ROW_NUMBER()OVER (PARTITION BY o_custkeyORDER BY o_totalprice DESC) AS rnFROM orders)WHERE rn <= 10)SELECT *FROM winFuncTableORDER BY o_totalprice DESCLIMIT 10;
此案例中o_cuskty为order表的分桶键,重写后的SQL避免了99.99%的数据shuffle.
此案例中o_cuskty为order表的分桶键,重写后的SQL避免了99.99%的数据shuffle.
四、优化效果对比
| 优化维度 | 原执行方式 | 优化后方式 | 案例效果 |
|---|---|---|---|
| 排序位置 | 并行度提升256倍 | ||
| 网络开销 | 数据传输量减少99.99% | ||
| 内存压力 | |||
| 典型场景 | ORDER BY x LIMIT 10 | 执行时间从小时级降至分钟级 |
五、总结
GlobalSortingOptimization
通过自动识别、智能改写与语义保留,将“全局排序”转化为“分区窗口计算 + 过滤”,真正实现了从全局瓶颈到局部并行的执行路径优化。对于大规模数据场景,这一优化算法能够解决此类数据倾斜问题,显著提升查询吞吐,是 PawSQL 在 自动化 SQL 优化领域的又一重磅实践。
🌐关于PawSQL
PawSQL专注于数据库性能优化自动化和智能化,提供的解决方案覆盖SQL开发、测试、运维的整个流程,广泛支持多种主流商用、国产和开源数据库,为开发者和企业提供一站式的创新SQL优化解决方案。
获取更多关于PawSQL的信息,欢迎关注公众号👇👇👇
