



一、什么是RTO和RPO?
| 指标 | 定义 | 核心意义 | 计算公式 |
|---|---|---|---|
| RTO (Recovery Time Objective) |
故障恢复时间目标 系统宕机到恢复服务的时间 |
业务中断容忍极限 时间越短,可用性越高 |
RTO = T2 - T1(T1:故障发生时间点 T2:服务恢复时间点) |
| RPO (Recovery Point Objective) |
数据恢复点目标 故障时允许丢失的数据量 |
数据完整性保障能力 数值越小,数据越安全 |
RPO = T_last - T_recovered(T_last:最后一次成功写入时间 T_recovered:恢复后最新数据时间) |
二、业内对数据库RTO/RPO的要求
不同场景下的典型标准:
| 场景 | RTO要求 | RPO要求 | 代表系统 |
|---|---|---|---|
| 金融核心系统 | ≤ 30秒 | = 0(零丢失) | 支付/清算系统 |
| 电商交易系统 | ≤ 1分钟 | ≤ 1秒 | 订单/库存系统 |
| 企业ERP | ≤ 5分钟 | ≤ 5分钟 | 财务/HR系统 |
| 日志分析 | ≤ 1小时 | ≤ 15分钟 | 大数据平台 |
关键行业标准:
- 金融行业:符合《JR/T 0071-2020》金融业信息系统灾难恢复规范
- 等保三级:RPO≤30分钟,RTO≤2小时
- 云服务SLA:AWS/Azure通常承诺99.95%可用性(对应年停机≤4.38小时)
三、RTO/RPO测试实战方法
测试架构设计:
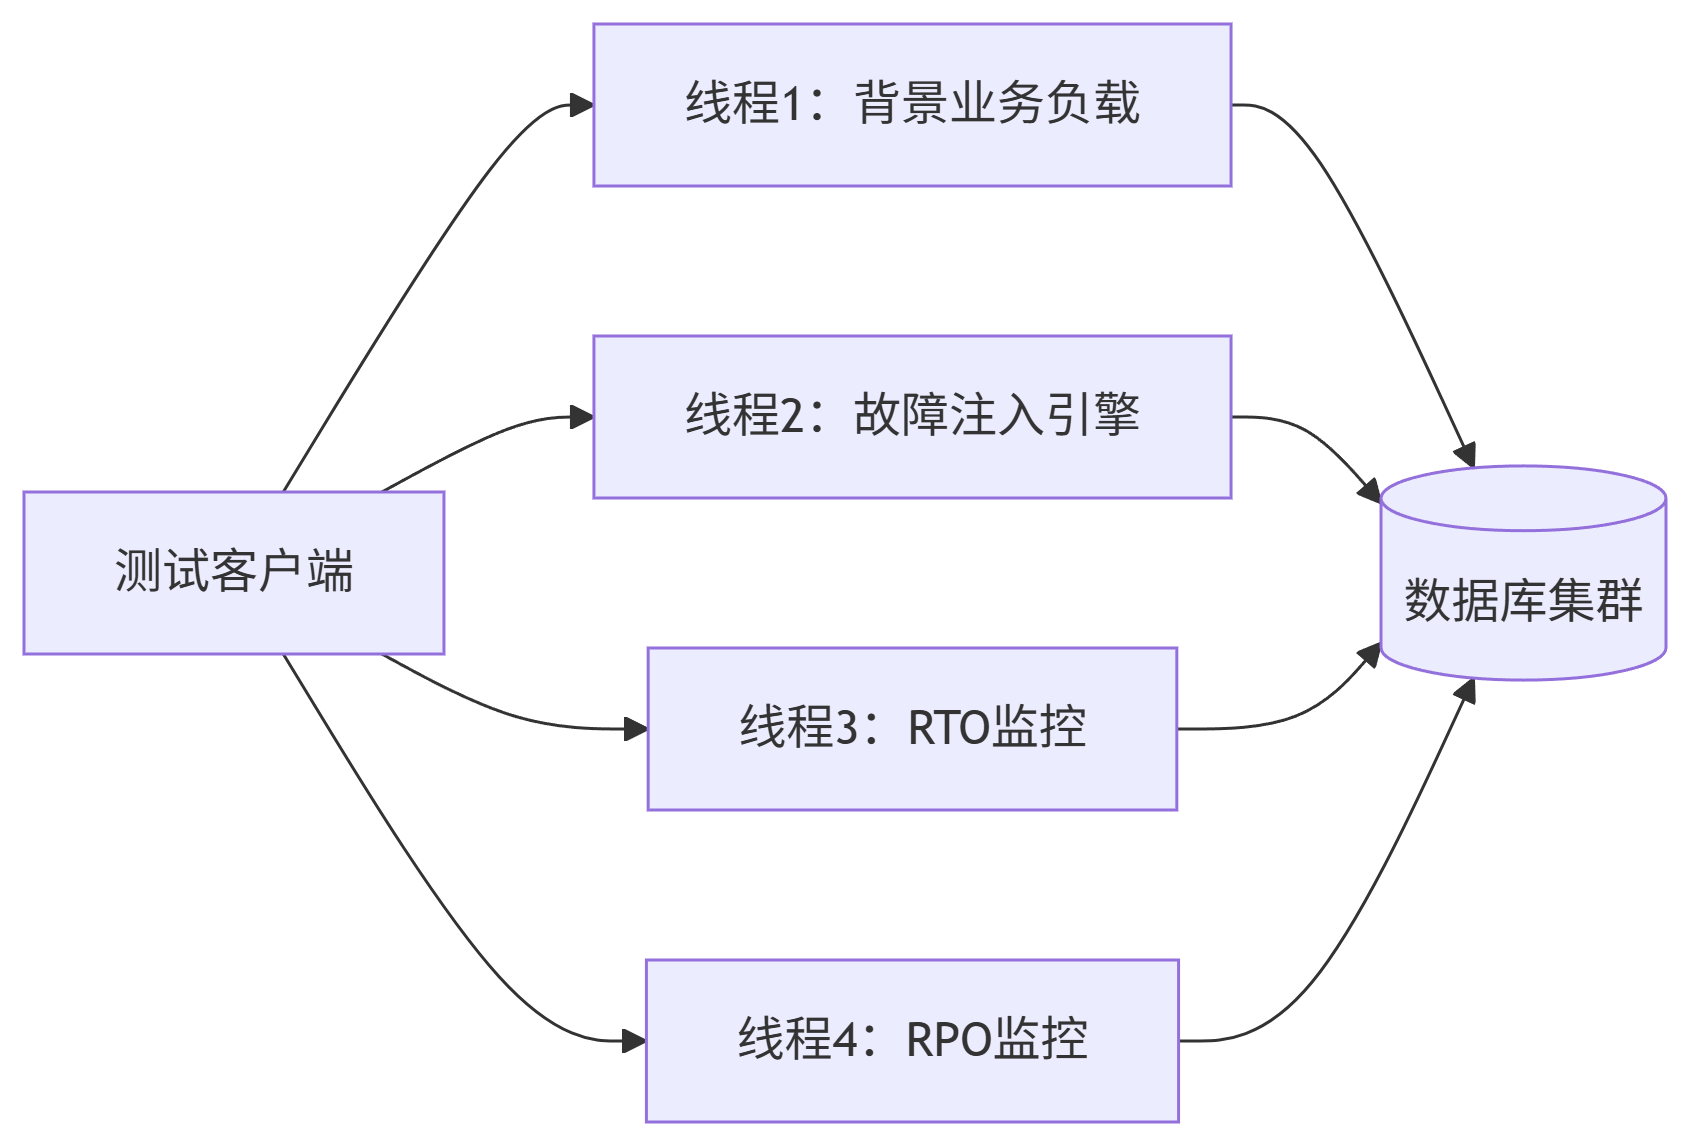
1. RTO测试核心逻辑
import threading
import datetime

# 全局记录时间戳
results = []

def rto_test():
    print("RTO测试开始...")
    # 准备测试表
    leader_node.run('DROP TABLE IF EXISTS test_rto')
    leader_node.run('CREATE TABLE test_rto(id INT PRIMARY KEY, c1 TIMESTAMP)')

    # 建立持久连接(避免连接开销影响结果)
    conn = leader_node.create_persistent_connection()

    # 启动故障注入线程
    fault_thread = threading.Thread(target=inject_fault)
    fault_thread.start()

    # 记录第一次提交失败时间T1
    while True:
        try:
            current_time = datetime.datetime.now()
            conn.execute(f"INSERT INTO test_rto VALUES (1, '{current_time}')")
            conn.commit()
        except DatabaseError as e:  # 捕获数据库异常
            T1 = datetime.datetime.now()
            results.append(T1)
            break

    # 等待故障恢复
    wait_for_recovery()

    # 记录恢复后首次成功时间T2
    while True:
        try:
            conn.execute("INSERT INTO test_rto VALUES (2, NOW())")
            conn.commit()
            T2 = datetime.datetime.now()
            results.append(T2)
            break
        except:
            continue

    # 计算RTO
    rto_seconds = (T2 - T1).total_seconds()
    print(f"✅ 实测RTO = {rto_seconds:.3f} 秒")
关键实现细节:
- 持久连接:使用
create_persistent_connection()避免TCP重连影响计时 - 精准计时:在代码层捕获异常瞬间(非应用层感知)
- 故障注入:通过
inject_fault()模拟真实故障场景:- 主节点进程Kill
- 网络分区(iptables阻断)
- 磁盘IO Hang(使用FUSE模拟)
2. RPO测试核心逻辑
def rpo_test():
    print("RPO测试开始...")
    leader = find_leader_node()

    # 准备测试环境
    leader.run('DROP TABLE IF EXISTS test_rpo')
    leader.run('CREATE TABLE test_rpo(id INT PRIMARY KEY, c1 TIMESTAMP)')

    # 持续更新数据
    conn = leader.create_persistent_connection()
    last_success_time = None

    while True:
        try:
            current_time = datetime.datetime.now()
            conn.execute(f"UPDATE test_rpo SET c1 = '{current_time}' WHERE id=1")
            conn.commit()
            last_success_time = current_time  # 记录最后成功时间
        except DatabaseError:
            break  # 故障发生时跳出

    # 故障恢复后获取数据
    new_leader = wait_for_new_leader()
    recovered_time = new_leader.run("SELECT c1 FROM test_rpo WHERE id=1").first()[0]

    # 计算RPO(毫秒)
    rpo_ms = (last_success_time - recovered_time).total_seconds() * 1000
    print(f"✅ 实测RPO = {rpo_ms:.2f} 毫秒")
精度优化技巧:
- 时间同步:所有节点使用NTP保持时钟同步(误差<1ms)
- 高频写入:每10ms更新一次时间戳(确保检测粒度)
- 数据验证:恢复后校验CRC32确保数据一致性
- 多次采样:循环测试10次取平均值(排除偶发波动)
四、测试注意事项
-
环境要求:
- 生产级硬件配置(避免资源瓶颈干扰)
- 网络延迟根据实际生产环境配置
-
典型干扰源排除:
# 关闭可能影响测试的OS参数 echo 0 > /proc/sys/vm/zone_reclaim_mode sysctl -w net.ipv4.tcp_slow_start_after_idle=0 -
结果验证方法:
指标 验证方式 合格标准 RTO 业务连续性监控 符合SLA约定 RPO 数据比对脚本 与业务容忍度一致
五、实战建议
- 混沌工程集成:将测试封装为K8s Operator实现常态化验证
- 多维度测试:
- 网络抖动(tc netem模拟)
- 节点级故障(VM/容器崩溃)
- 区域级故障(AZ切换)
- 结果可视化:
| RTO区间 | 占比 | 性能评级 | 典型场景 | 改进建议 |
|---|---|---|---|---|
| 0-1秒 | 65% | 💎 黄金 | 金融核心系统 | 保持当前配置 |
| 1-3秒 | 25% | 🥈 白银 | 电商交易系统 | 优化故障检测算法 |
| >3秒 | 10% | ⚠️ 风险 | 日志分析系统 | 检查存储同步机制+网络延迟 |
延伸阅读:
- 零宕机零数据库丢失两地三中心解决方案(共享集群)
- Oracle DG 自动故障转移 —— Fast-Start Fail Over(FSFO)
- 推荐工具:ChaosBlade,tc命令
通过本文的测试方案,您可以精准量化数据库HA能力,为业务连续性提供数据支撑。建议每周执行一次验证,确保灾难恢复能力始终达标。
最后修改时间:2025-08-14 22:13:17
「喜欢这篇文章,您的关注和赞赏是给作者最好的鼓励」
关注作者
【版权声明】本文为墨天轮用户原创内容,转载时必须标注文章的来源(墨天轮),文章链接,文章作者等基本信息,否则作者和墨天轮有权追究责任。如果您发现墨天轮中有涉嫌抄袭或者侵权的内容,欢迎发送邮件至:contact@modb.pro进行举报,并提供相关证据,一经查实,墨天轮将立刻删除相关内容。
