



本文旨在让您全面了解如何使用全新的 VMware Private AI Services (PAIS)。这套 AI 服务现已随 VMware Private AI Foundation with NVIDIA 9.0 一起提供。这套服务为希望在本地部署 Private AI,但又想体验类似云服务的用户提供了一个全面的平台。我们将首先概述大型语言模型部署生命周期的各个阶段,以此开始对 Private AI Services的描述:
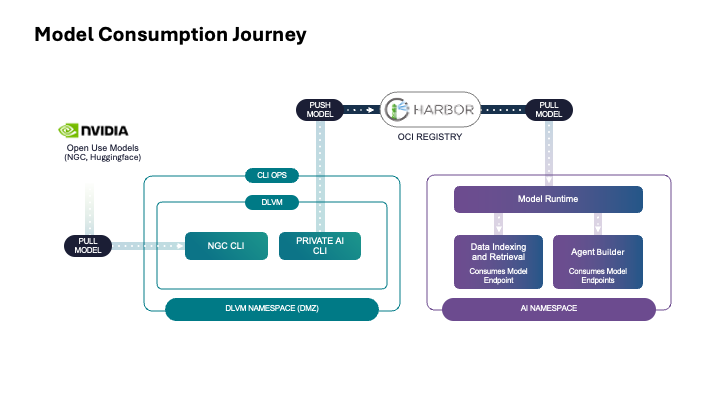
模型选择
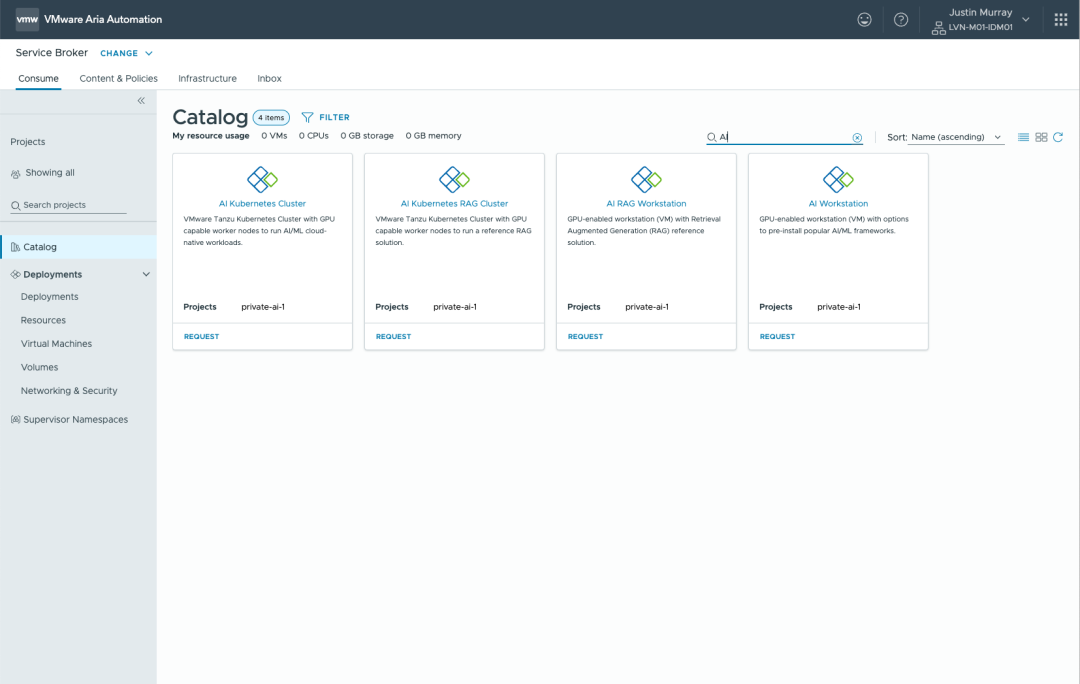
数据科学家或 LLM Ops 工程师可以从不断扩展的公共模型集中选择一个模型(例如,Meta 的 Llama 3 模型集或 NVIDIA GPU Cloud 的优化模型)。选择模型后,需要在安全的环境中使用特定的公司数据测试模型,以评估其答案的准确性、偏差处理、漏洞和性能特征等。无论是 Llama 70B,还是 BAAI BGE-M3模型,都需要进行模型选择和测试。VCF可以自动化的提供测试模型的环境。DevOps 人员或数据科学家在 VCF中选择如下所示的“AI Workstation”菜单,这将创建一个深度学习虚拟机 (DLVM)。深度学习虚拟机中有测试模型所需的工具和环境。这是 VCF 自动化中部署的项目集的一个示例。
模型商店
数据科学家决定保留并存储已测试的模型,以便在其企业中进一步应用。这可以通过在 Harbor 实现模型存储。LLM Ops 人员负责配置此模型存储,并向数据科学家或其他用户提供模型库的访问权限。新测试的模型将使用 VMware Private AI 专用命令行“pais”从 DLVM 推送到基于 Harbor 的模型库。“pais”命令是深度学习虚拟机的一部分。
访问模型
数据科学家、应用程序开发人员或 LLM 测试工程师需要访问一个或多个模型来为其应用程序提供服务。通常,他们的需求是建立一个能够以聊天机器人的方式回答用户问题的模型。为了构建和测试此应用程序,他们需要一个模型Endpoint,以及一种向模型发送输入数据和接收响应的方式。下面您将看到如何部署模型,可以从 Harbor 模型库中选择合适的模型。此引用显示在下方给出的“Model URL”字段中。
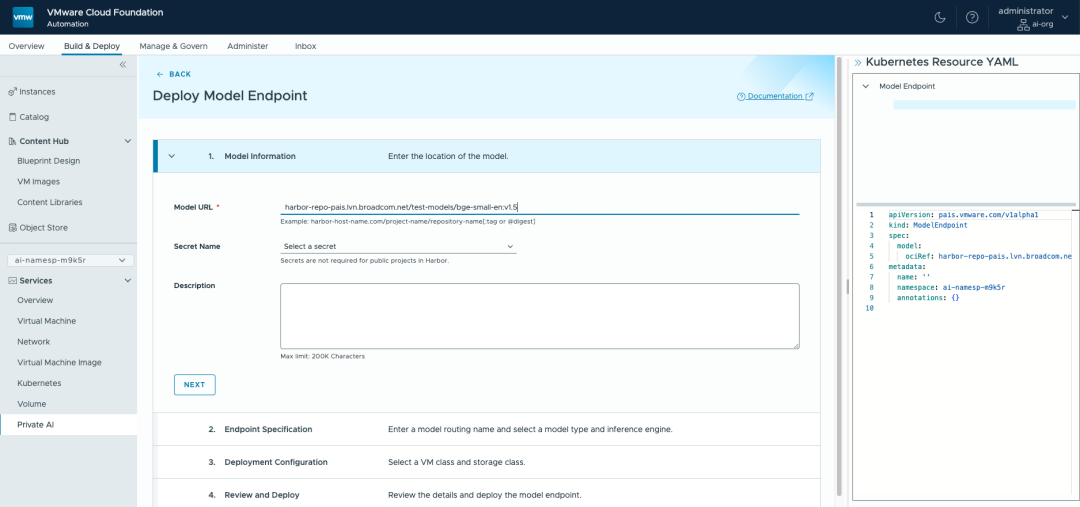
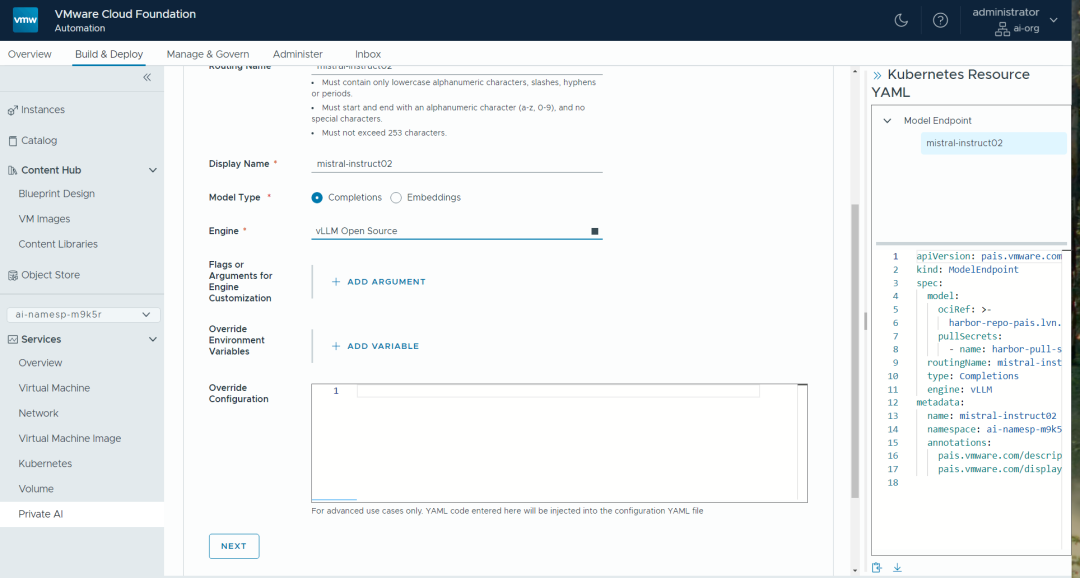
我们为每个要在 AI 应用程序中使用的模型部署一个模型Endpoint。VMware Private AI Model Runtime 同时支持多个模型Endpoint。每个模型都会加载到所选的推理引擎中,以便它为需要它的应用程序提供长期运行的服务。用户从提供的集合中为其模型选择合适的推理引擎。对于completion模型,此推理引擎通常为 vLLM;对于embedding模型,此推理引擎通常为 Infinity。以下是“模型类型”和“引擎”选择的视图。
如果模型需要访问 GPU,部署人员还可以使用如下所示的VMClass来选择合适的 GPU 配置。这些VMClass将由系统管理员预先构建,以允许某些 GPU 用途。模型可以被部署到预构建的 VMware Kubernetes 集群中的带有GPU资源的节点。
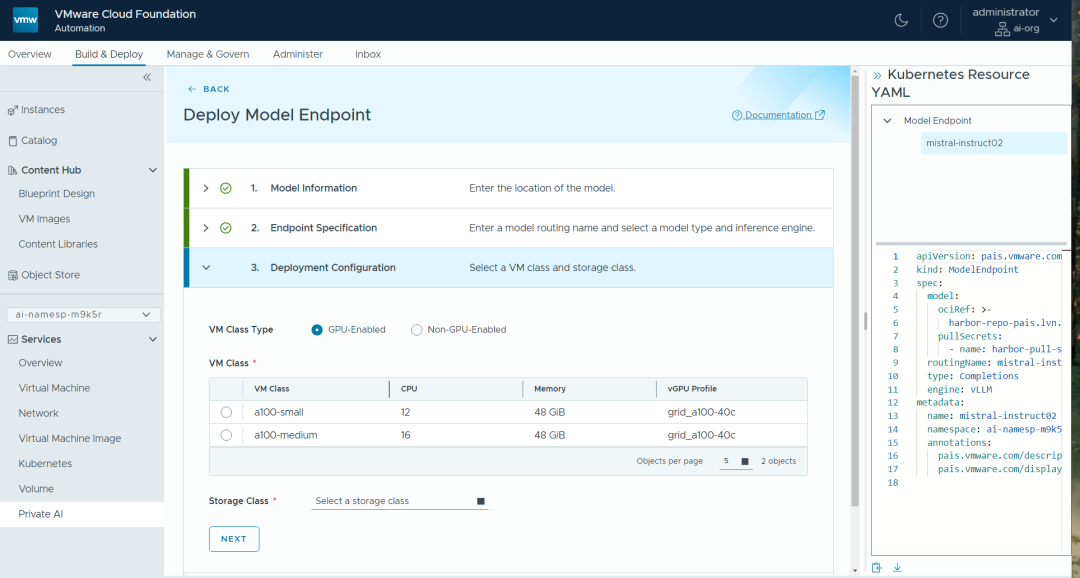
在 Kubernetes 节点中,包含推理引擎(例如 vLLM 或 Infinity)的 Pod 正在运行,并使用适当的 GPU 资源集供模型使用。重要的是,可以通过模型运行时的 API 网关组件访问模型。 API 网关为传入模型的用户请求提供身份验证和授权,并有助于跨模型集平衡请求的负载。
数据索引服务
我们上面部署的模型将使用公司私有数据来增强其在回答最终用户问题时的行为。LLM Ops 工程师或数据科学家提供对 RAG 设计中需要提供给模型的数据源的访问权限。这意味着他们使用 PAIS 中的数据索引和检索服务创建数据源对象,以引用私有数据的各种数据存储库。
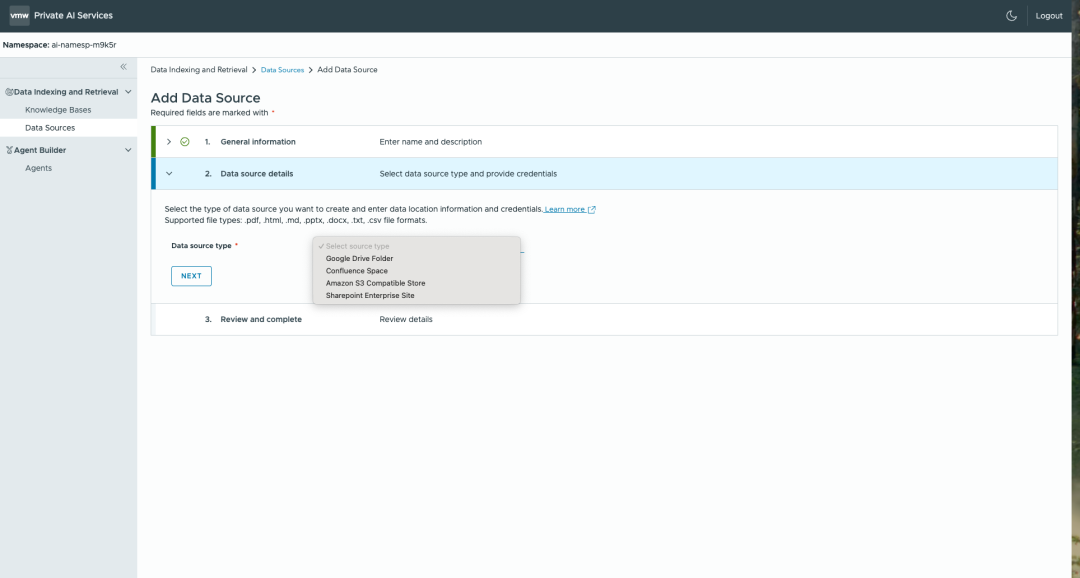
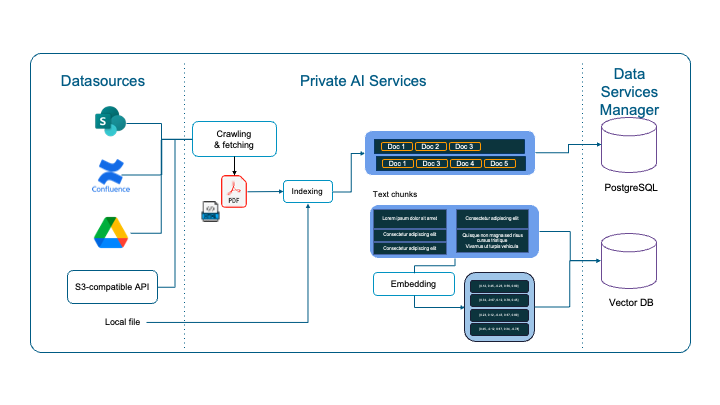
这些数据源可能是对 Google Drive 目录、Confluence 页面、Sharepoint 目录或 S3 源的引用。这些数据源被收集到知识库中,以便进行索引。知识库中的文档在索引过程中被分割成更小的部分。然后,它们被转换为embeddings并进行索引,之后再加载到向量数据库中以供后续检索。用于索引知识库的数据可能来自许多来源,包括本地文件。
数据科学家或LLM运营工程师决定如何创建embeddings以及如何为知识库中的数据源进行索引。以下是选择embeddings模型的一个示例。此模型先前已从模型存储中构建。
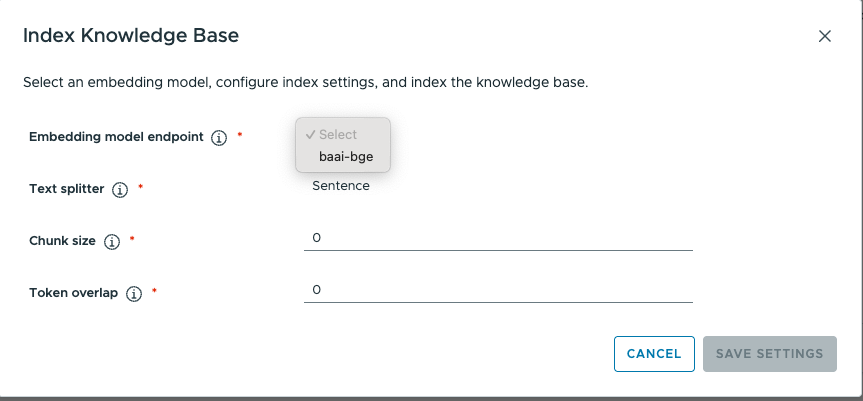
数据索引和检索涉及对输入数据中存在的数据结构和应用程序需求的一些理解,以便使用最合适的块大小和索引。例如,文本语料库可以分块为段落或句子,并对文档中的表格、图表和示意图进行单独的分块和索引。作为知识库索引工作的一部分,知识库及其数据源集合将生成的文本embeddings和索引存储在向量数据库中。当最终用户发出查询时,代理会决定该查询的优先处理位置,我们将在 Agent Builder 的后续步骤中看到这一点。
Agent Builder – 创建 RAG 应用程序的组件
人工智能应用最流行的设计模式之一是检索增强生成 (RAG) 方法。在 RAG 设计中,用户在聊天机器人 UI 中输入的问题首先会转换为embeddings形式。转换后的问题会作为查询发送到向量数据库,以在向量数据库中查找与查询内容匹配的相似条目或语义上有意义的条目。应用程序开发者利用私有 AI Agent Builder 将知识库与模型Endpoint相结合,以设计他们的 (RAG) 应用程序。embeddings模型首先用于将用户的问题转换为embeddings形式。然后,该查询会作为请求发送到向量数据库,以查找与查询匹配的相似条目或语义上有意义的条目。下方展示了 Agent Builder 支持的一个示例交互,这是模型和数据索引功能的测试环境,开发人员现在可以使用此设置来创建客户服务应用程序。
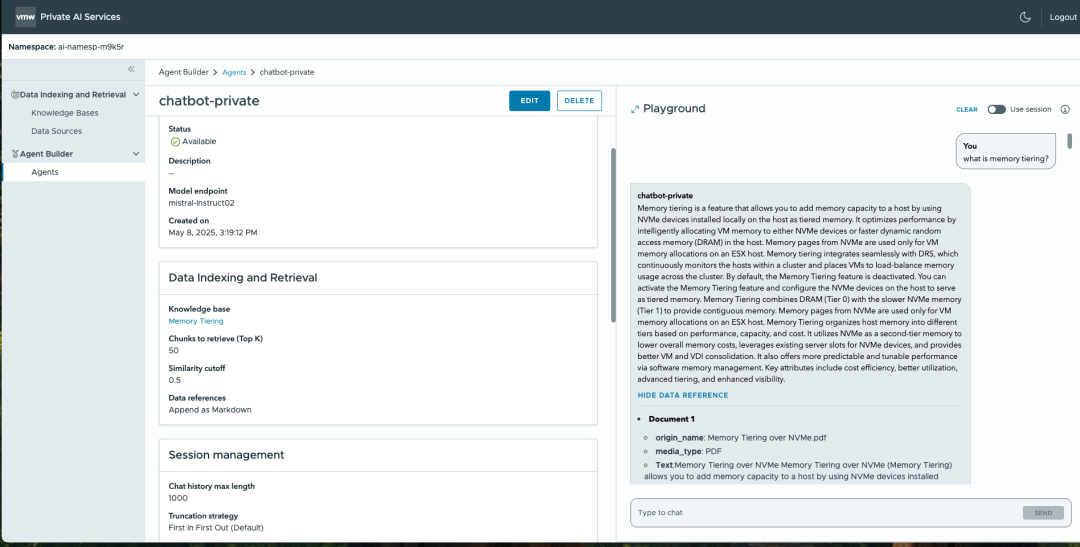
最终用户可以通过向这个新的Agent应用程序提出各种问题来测试它。这让他们能够判断响应的质量、准确性和速度——这些都是数据科学家需要关注的关键因素。此测试过程可以通过CI/CD流程实现自动化,以确保模型和数据的高质量。用户可以通过向Agent发出明确的行为指令来进一步优化其活动。当需要使用新版本升级生产中的模型时,可以分阶段推出新模型,而无需停止使用应用程序的服务。向量数据库中的数据也可以通过知识库重建索引流程定期更新。
VCF 9.0 私有 AI 服务概述
本文概述了 VCF 9.0 中新增的私有 AI 服务功能。这套工具旨在让用户更轻松地使用基于模型和数据源的 AI 应用程序。新的私有 AI 服务包括:
模型存储 - 用于维护对模型及其版本的控制,朝着模型治理的目标迈出了一步;
模型发布 - 基于模型推理服务器的选择,例如 vLLM、Infinity 等。模型Endpoint提供用于从客户端程序访问模型的 URL 和 API;
数据索引和检索 - 使用embeddings模型来组织数据(分块、索引)的流程和工具。在此领域内,我们将知识库定义为一个对象,该对象封装了一组数据存储,这些数据存储可通过查询进行索引访问。
Agent Builder - 利用知识库和模型构建应用程序的工具。
总之,这些服务为希望在本地部署私有 AI 的运营和数据科学人员提供了高效的 AI 应用程序模型和数据组织体验。
