



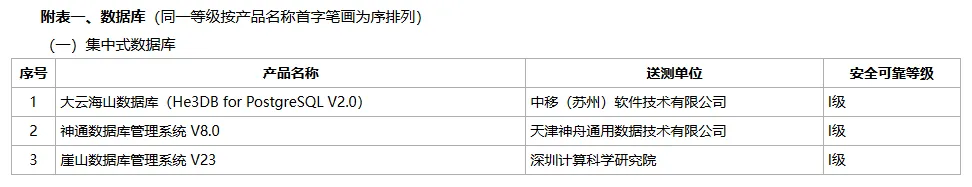
近日工信部公布了最新一期国产数据库安全可控评测结果,共有 3 款集中式数据库,其中大云海山数据库 He3DB 和崖山数据库 YanshanDB 均是首次通过此项测试,神通数据库则从之前的 V7.0 升级到 V8.0 版本。
神通数据库四大传统国产数据库厂商综合对比和崖山数据库国产数据库介绍之崖山DB (YashanDB)以前的文章有介绍,今天我们重点聊聊 He3DB。
产品起源
He3DB 是中移软件数据库团队开源的云原生数据库产品,通过计算/存储分离、数据冷热分层和压缩、智能中间件等技术,来保证高性能和低成本的平衡,在获得高性能的同时,最大化的帮助客户节省数据库的使用成本。
He3DB 产品设计之初参考了 Aurora、PolarDB、Socrate 和 Taurus 等产品相关论文,所以熟悉第一代 PolarDB 的朋友相信看到 He3DB 会有一种似曾相识的感觉,采用主备节点共享存储架构,最多支持一主 15 备,RTO 绝对时间<30 秒。不过 He3DB 基于 PostgreSQL 实现,相比于 PolarDB,He3DB 对于 PG 的兼容性更好。
体系架构
He3DB 架构分为 3 层:代理层、计算层、存储层,分别对应了 He3Proxy、He3PG 和 He3FS 三个开源组件,每个组件可以独立部署,联合起来构成 He3DB 数据库。
中间代理层
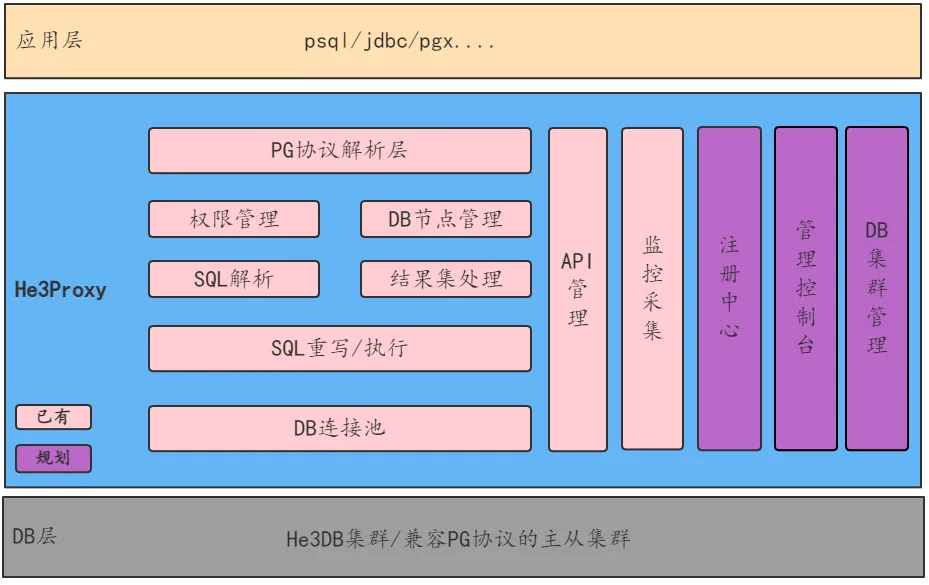
中间代理层是面向应用的接口,承接应用侧的连接请求。最核心的能力就是选择合适的备机节点,保证读写数据的一致性以及备节点的负载均衡。
He3Proxy 采用 Go 语言开发,完全兼容 PG SQL,提供读写分离、负载均衡、连接池管理、读一致性等基础能力,使得一主多备的结构对上层应用完全透明,能够有效提升集群整体吞吐量、提高节点资源利用率。同时还具有集群监控、灰度升级、节点动态扩缩容等功能。
计算引擎
计算引擎提供 ServerLess 服务,按需扩缩容,保证计算资源效能最大化。
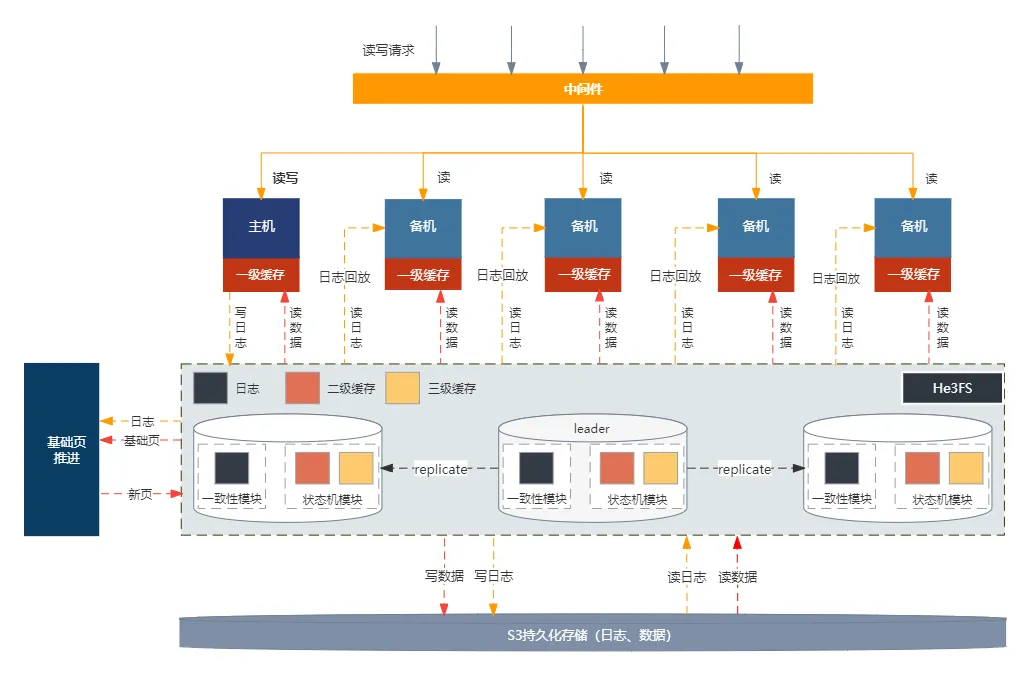
基于 PostgreSQL 源码改造,架构上实现了计算存储分离,主备节点共享数据。实现了 Aurora 论文中提到的 Log is Database 理念,只需要将 WAL 日志写入到存储层,即可完成日志重放,由此来保证所有备节点的数据同步。同时为了确保 RTO 时间绝对可控,实现了 WAL 日志的 Delay replay 能力。
存储引擎
存储引擎分为高性能存储层和冷数据持久层,通过数据分层在保证性能的前提下,最大化降低存储成本。
高性能存储层基于数据库缓存来实现,每个备节点缓存不同的热数据,通过中间层,确保每一个读请求都能选择最佳缓存备节点,而不经常访问的数据则会被持久化到冷数据层。
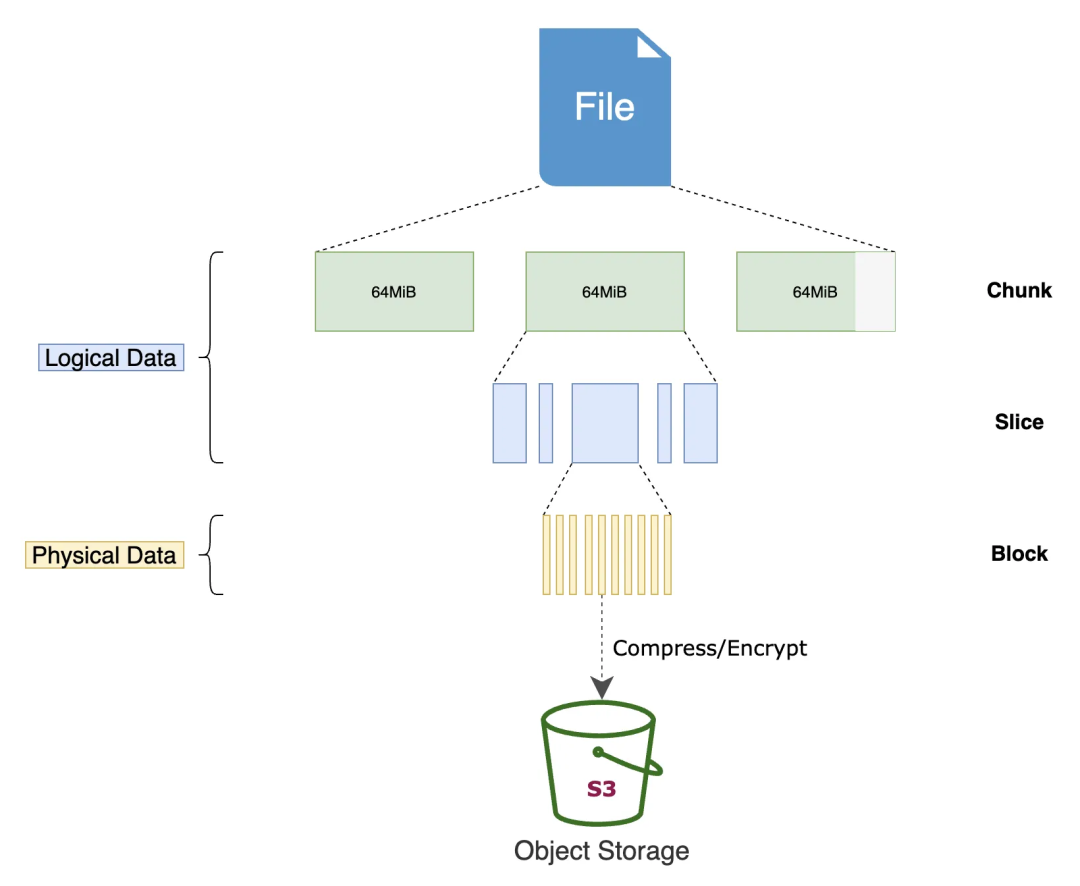
冷数据持久层,基于开源的 JuiceFS 文件系统构建,为所有的集群节点提供共享存储服务。Juice 是一款高性能 POSIX 文件系统,针对云原生环境特别优化设计。其实现上,将数据拆分成固定大小的 Chunk,默认容量上限 64MB,每个 Chunk 由一个或多个没有固定长度的 Slice 组成,Slice 长度不固定。每个 Slice 又会被进一步拆分成默认 4MB 固定大小的 Block。最后,这些 Block 被持久化保存到 S3 等低成本的对象存储中,而数据所对应的元数据根据场景需求持久化保存在 Redis、MySQL、SQLite 等其他数据库引擎。
写在最后
总的来说,He3DB 还是一款有自己特色的产品,除了具备计算层资源弹性扩展能力之外,通过缓存来保证读写性能,而利用对象存储来持久化冷数据,从而降低数据存储的成本。这对于云上比较看着成本的企业来说,还是有一定的吸引力的。
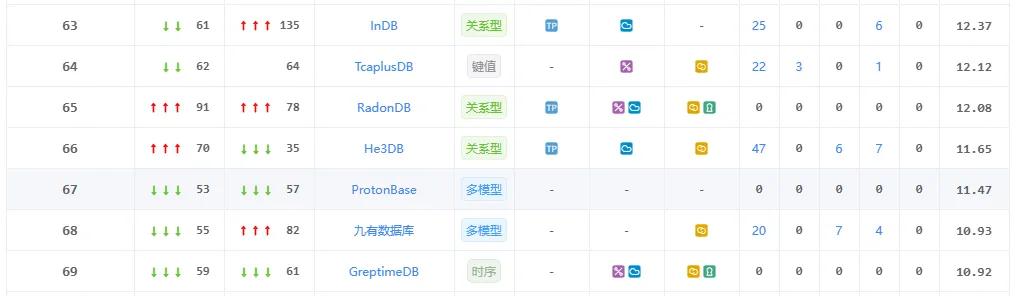
尽管如此,He3DB 也面临着不小的挑战。在移动内部,虽然出身于中移(苏州)软件,背后的中国移动能够为其提供大量的应用场景,对于产品的早期发展是非常有利,但也面临磐维的挑战,毕竟后者才是亲生的,能有多少份额留给 He3DB 也还有待于进一步的观察;在外部来看,当前 He3DB 在墨天轮中的排名 66 位,处在中流的位置,此次通过国测应该有助于其排名的提升,但总体来说影响有限。想要从一众产品中突围,还需要团队付出更大的努力。
