



一、背景介绍
目前,大语言模型(Large Language Model, LLM)在自然语言问答、代码生成、科学发现等多个领域取得了显著的效果。然而,在大规模推广LLM相关应用服务的过程中,我们依旧面临着幻觉、数据陈旧性以及知识更新困难等问题。这些问题的存在使得LLM系统的可靠性和灵活性遭受质疑。
在此背景下,相关研究人员提出了检索增强生成(Retrieval Augmented Generation,RAG)技术以解决上述问题。通过从外部数据库中检索相关信息并将其融入prompt中,RAG能够有效地提高LLM应用服务的可靠性、时效性和上下文的丰富性。通过引入RAG技术,可以实现使用更少参数量的LLM的条件下,实现可以媲美大参数量LLM的生成效果,而后者需要的硬件资源往往远高于前者。目前,诸如Google、Meta、微软等科技巨头均将RAG技术引入了其系统中。
另一方面,尽管RAG具有上述优势,其在性能调优方面仍然面临挑战。第一,RAG系统集成了多种多样的组件,包括检索引擎、生成式LLM以及多种不同的辅助模型(用于编码外部文档、查询重写、检索结果排序等)。这些组件运行在异构的硬件平台上,例如检索模块通常运行在CPU服务器上,而模型相关的模块需要运行在专用的异构加速器上(GPU, TPU等)。因此在性能优化时需要综合考虑不同的指标。第二,系统组件的多样性同时导致参数配置优化的复杂程度大大提高,需要考虑数据库大小、检索频率、模型选择以及硬件平台性能指标等多种因素。
二、代表工作
2.1 RAG系统性能评估概述
本文将介绍发表于ISCA 2025的《RAGO: Systematic Performance Optimization for Retrieval-Augmented Generation Serving》一文,并重点关注其中剖析RAG系统中性能影响因素的相关内容。
文章作者从三个角度切入,构建了量化分析RAG系统性能的评估框架:(1)工作负载抽象:通过对相互之间差异巨大的RAG系统组件承担的工作任务的代价进行抽象。(2)系统设计决策:在RAG系统中存在各种性能取舍的关键因素,需要对这些因素进行一一的梳理以理解RAG性能优化中的决定性设计。(3)系统性优化框架:为了应对多样的模块中复杂的参数配置调优,需要采用有效的系统性优化框架。文章作者基于上述三个角度,提出了名为RAGSchema的RAG系统抽象模型,对RAG系统中的各类组件进行归类,并对不同组件中的关键参数进行描述。
2.2 RAG系统常见任务场景
文章作者列举了四种常见的RAG系统场景以帮助作者在后续文章中说明在不同的设定下RAG系统性能的关键因素会产生变化的情况。
场景一:超大规模语料检索。相关研究表明,当检索模块中的语料足够丰富时,RAG技术能够帮助小规模LLM实现可以媲美超大规模LLM的生成效果(参数规模1:10左右)。RAG中的检索模块在一定程度上可以替代LLM中大量用于编码外部知识的参数。
场景二:超长上下文序列处理。用户会向系统提供一份超长的文档(超过100K token)作为输入。一种可以得到预期结果但计算代价巨大的方法是,将整个文档作为prompt的一部分输入,这将使得需要处理的序列大大增长,计算代价暴增。另一种方法是将用户提供的超长文档融入RAG的检索模块的知识库中,从而利用检索模块的相似搜索能力从用户提供的长文本中抽取出与结果真正有关的信息,从而减短prompt长度,提高处理效率。
场景三:迭代检索。近期的相关研究提出,在生成过程中周期性地进行多轮知识库检索以不断完善检索结果能够有效地提高系统输出的质量。此类通过多次检索迭代优化后的技术在涉及需求解决多跳推理问题的应用中展现出优势。这时,解码器模块自适应地在生成过程中触发多轮检索。在进行检索时,生成过程将暂停以等待检索结果返回,并在结果返回之后通过整合新增的上下文语境指导接下来的序列生成。
场景四:查询重写与重排序。用户提供给系统的查询请求通常是模糊且复杂的查询,这使得直接执行这些查询非常困难。而查询重写模型在预处理阶段将用户查询等价转换为一组简单查询。当一组简单查询返回结果后,重排序模型将对结果根据相关性等指标进行排序,以排除部分相关性弱的检索结果。
2.3 大规模语料下的RAG系统
本短文着重关注RAG系统中检索部分成为性能瓶颈的情形。因此,在本小节本文将解析在大规模语料下RAG系统的性能瓶颈问题。
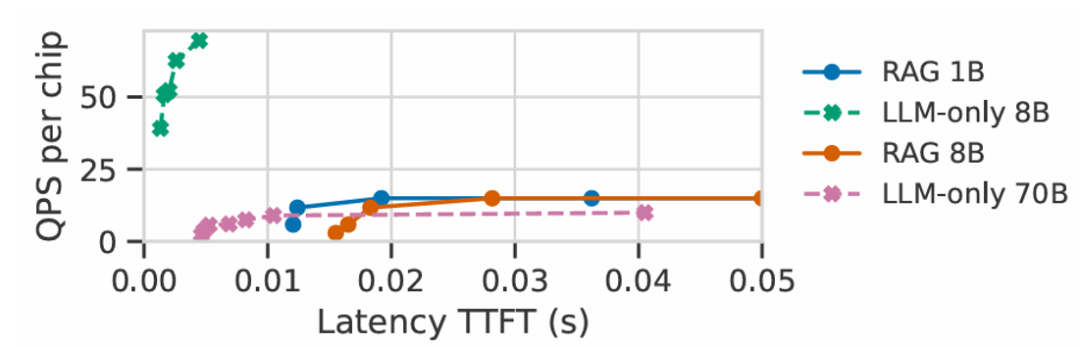
纯LLM与RAG比较 上图显示了同样处理超大规模语料(TB级大小)不同的LLM参数量的RAG系统和纯LLM系统的性能指标比较情况。比较中文章采取了对芯片数归一化后的平均每秒请求响应量和首个token到达时间两个常见的LLM系统性能指标。不难发现,尽管RAG 8B在参数量上相较纯LLM 70B的版本少了一个数量级,但其性能领先优势仅在1.5倍左右。这是因为,采用更少参数的LLM带来的性能优势被检索环节的代价拉平了。这时,我们可以认为,对给定的大规模语料,RAG系统中的模型大小可以在一定限度内增加以换取更好的生成质量,而不会使得系统整体速度减慢。
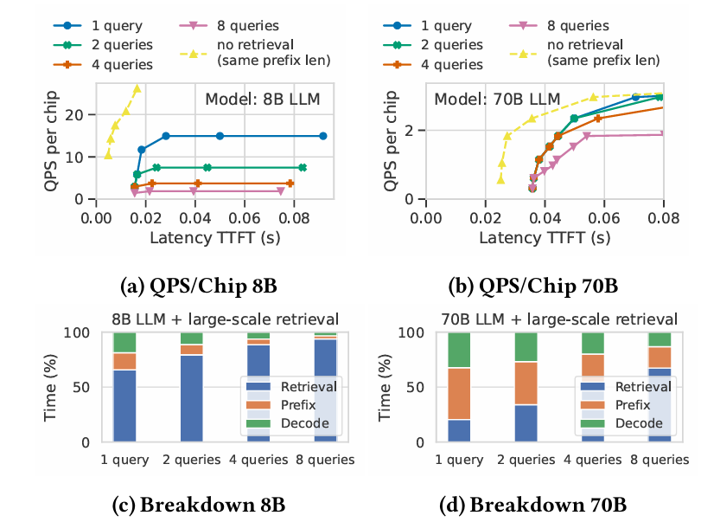
模型大小比较 上图中(a)与(b)比较了在参数量分别为8B与70B时系统性能随着查询数变化的折线图,而(c)与(b)两张图进一步显示了在查询向量数量增加的过程中各个环节的时间占比变化情况。可以看出,对8B模型而言,检索模块从查询向量数为1时开始就已经成为系统的主要性能瓶颈。而对70B模型而言,当每个请求的向量查询数量较大时,检索性能同样会反超成为主要性能瓶颈。
一、背景介绍
目前,大语言模型(Large Language Model, LLM)在自然语言问答、代码生成、科学发现等多个领域取得了显著的效果。然而,在大规模推广LLM相关应用服务的过程中,我们依旧面临着幻觉、数据陈旧性以及知识更新困难等问题。这些问题的存在使得LLM系统的可靠性和灵活性遭受质疑。
在此背景下,相关研究人员提出了检索增强生成(Retrieval Augmented Generation,RAG)技术以解决上述问题。通过从外部数据库中检索相关信息并将其融入prompt中,RAG能够有效地提高LLM应用服务的可靠性、时效性和上下文的丰富性。通过引入RAG技术,可以实现使用更少参数量的LLM的条件下,实现可以媲美大参数量LLM的生成效果,而后者需要的硬件资源往往远高于前者。目前,诸如Google、Meta、微软等科技巨头均将RAG技术引入了其系统中。
另一方面,尽管RAG具有上述优势,其在性能调优方面仍然面临挑战。第一,RAG系统集成了多种多样的组件,包括检索引擎、生成式LLM以及多种不同的辅助模型(用于编码外部文档、查询重写、检索结果排序等)。这些组件运行在异构的硬件平台上,例如检索模块通常运行在CPU服务器上,而模型相关的模块需要运行在专用的异构加速器上(GPU, TPU等)。因此在性能优化时需要综合考虑不同的指标。第二,系统组件的多样性同时导致参数配置优化的复杂程度大大提高,需要考虑数据库大小、检索频率、模型选择以及硬件平台性能指标等多种因素。
二、代表工作
2.1 RAG系统性能评估概述
本文将介绍发表于ISCA 2025的《RAGO: Systematic Performance Optimization for Retrieval-Augmented Generation Serving》一文,并重点关注其中剖析RAG系统中性能影响因素的相关内容。
文章作者从三个角度切入,构建了量化分析RAG系统性能的评估框架:(1)工作负载抽象:通过对相互之间差异巨大的RAG系统组件承担的工作任务的代价进行抽象。(2)系统设计决策:在RAG系统中存在各种性能取舍的关键因素,需要对这些因素进行一一的梳理以理解RAG性能优化中的决定性设计。(3)系统性优化框架:为了应对多样的模块中复杂的参数配置调优,需要采用有效的系统性优化框架。文章作者基于上述三个角度,提出了名为RAGSchema的RAG系统抽象模型,对RAG系统中的各类组件进行归类,并对不同组件中的关键参数进行描述。
2.2 RAG系统常见任务场景
文章作者列举了四种常见的RAG系统场景以帮助作者在后续文章中说明在不同的设定下RAG系统性能的关键因素会产生变化的情况。
场景一:超大规模语料检索。相关研究表明,当检索模块中的语料足够丰富时,RAG技术能够帮助小规模LLM实现可以媲美超大规模LLM的生成效果(参数规模1:10左右)。RAG中的检索模块在一定程度上可以替代LLM中大量用于编码外部知识的参数。
场景二:超长上下文序列处理。用户会向系统提供一份超长的文档(超过100K token)作为输入。一种可以得到预期结果但计算代价巨大的方法是,将整个文档作为prompt的一部分输入,这将使得需要处理的序列大大增长,计算代价暴增。另一种方法是将用户提供的超长文档融入RAG的检索模块的知识库中,从而利用检索模块的相似搜索能力从用户提供的长文本中抽取出与结果真正有关的信息,从而减短prompt长度,提高处理效率。
场景三:迭代检索。近期的相关研究提出,在生成过程中周期性地进行多轮知识库检索以不断完善检索结果能够有效地提高系统输出的质量。此类通过多次检索迭代优化后的技术在涉及需求解决多跳推理问题的应用中展现出优势。这时,解码器模块自适应地在生成过程中触发多轮检索。在进行检索时,生成过程将暂停以等待检索结果返回,并在结果返回之后通过整合新增的上下文语境指导接下来的序列生成。
场景四:查询重写与重排序。用户提供给系统的查询请求通常是模糊且复杂的查询,这使得直接执行这些查询非常困难。而查询重写模型在预处理阶段将用户查询等价转换为一组简单查询。当一组简单查询返回结果后,重排序模型将对结果根据相关性等指标进行排序,以排除部分相关性弱的检索结果。
2.3 大规模语料下的RAG系统
本短文着重关注RAG系统中检索部分成为性能瓶颈的情形。因此,在本小节本文将解析在大规模语料下RAG系统的性能瓶颈问题。
上图显示了同样处理超大规模语料(TB级大小)不同的LLM参数量的RAG系统和纯LLM系统的性能指标比较情况。比较中文章采取了对芯片数归一化后的平均每秒请求响应量和首个token到达时间两个常见的LLM系统性能指标。不难发现,尽管RAG 8B在参数量上相较纯LLM 70B的版本少了一个数量级,但其性能领先优势仅在1.5倍左右。这是因为,采用更少参数的LLM带来的性能优势被检索环节的代价拉平了。这时,我们可以认为,对给定的大规模语料,RAG系统中的模型大小可以在一定限度内增加以换取更好的生成质量,而不会使得系统整体速度减慢。
上图中(a)与(b)比较了在参数量分别为8B与70B时系统性能随着查询数变化的折线图,而(c)与(b)两张图进一步显示了在查询向量数量增加的过程中各个环节的时间占比变化情况。可以看出,对8B模型而言,检索模块从查询向量数为1时开始就已经成为系统的主要性能瓶颈。而对70B模型而言,当每个请求的向量查询数量较大时,检索性能同样会反超成为主要性能瓶颈。
欢迎关注北京大学王选计算机研究所数据管理实验室微信公众号“图谱学苑“
实验室官网:https://mod.wict.pku.edu.cn/
微信社区群:请回复“社区”获取
gStore官网:https://www.gstore.cn/
GitHub:https://github.com/pkumod/gStore
Gitee:https://gitee.com/PKUMOD/gStore

