



💻 深耕数据库内核架构设计与开发十余年,曾主导多款高性能分布式数据库内核研发,攻克高并发、低延迟等核心技术难题。现倾力打造《从零手写数据库》系列教程,首次系统性公开数据库内核源码级实现细节!
🚀 从存储引擎、查询优化到分布式事务,手把手拆解核心模块;从语法解析树构建到执行计划生成,逐行代码还原设计精髓。
🌟 无论你是数据库开发者、系统架构师,还是对底层技术充满好奇的极客,这里都有你想要的“硬核干货”!点击关注,与行业老兵共同探索数据库技术的星辰大海! 公众号:开源无限 
数据库功能非常丰富,在关系型数据库中,数据表是数据库中组织数据的基本单位,类似于学校中的班级,学生以班级为单位进行管理,每个学生一定属于某个班级。有了数据表之后才能对数据进行各种各样的操作,比如插入、查询、更新、删除等。
定义数据表功能的基本流程如下:
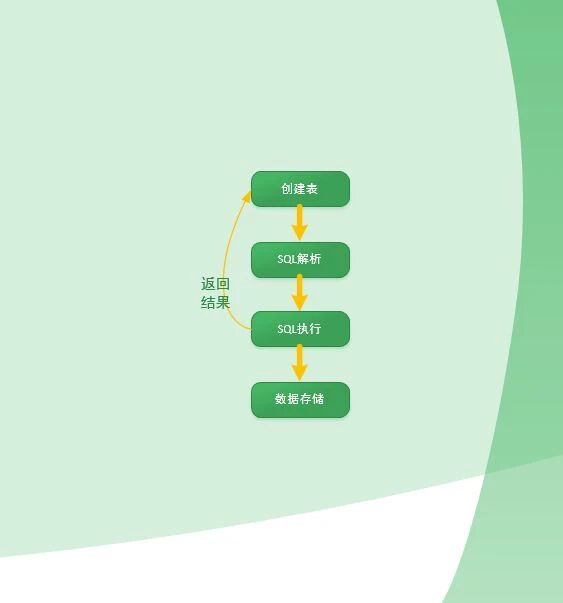
详细实现介绍在本专集的2-23节,创建和删除数据表的实现,大家可以按照以下步骤学习:
SQL解析器 SQL执行器 数据存储引擎
SQL解析器
结构化查询语言(Structured Query Language,SQL)是一种用于管理关系数据库的语言,它用于存取、更新和管理关系数据库中的数据。SQL已经成为操作关系型数据库的标准语言,是数据库领域的标准语言。
数据库内核从外部来看,它就是将用户输入的SQL语句转换成系统可以理解的结构,并按照SQL传递的命令信息调用不同的执行序列,在执行过程中,数据库内核将数据存入数据存储引擎中,或者从数据存储引擎中取出数据,并返回给用户。
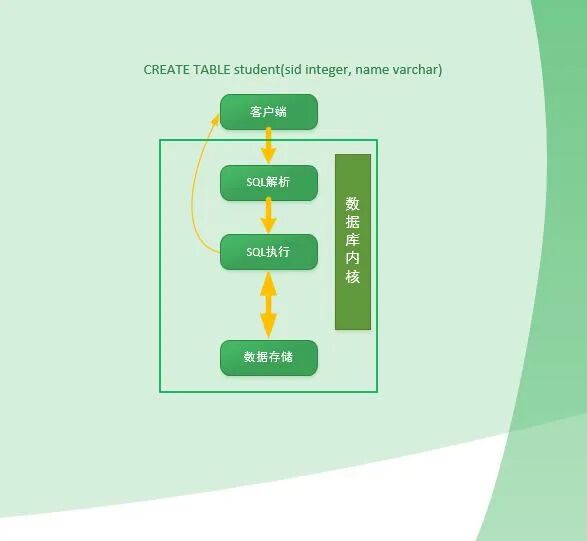
SQL解析器是数据库与外界交互的桥梁,同时也是数据库内核的入口,它负责将用户输入的SQL语句转换成系统可以理解的命令,并将命令传给数据存储引擎执行。因此,本教程的每个功能都会涉及到SQL解析器,由它来翻译用户输入的SQL语句。
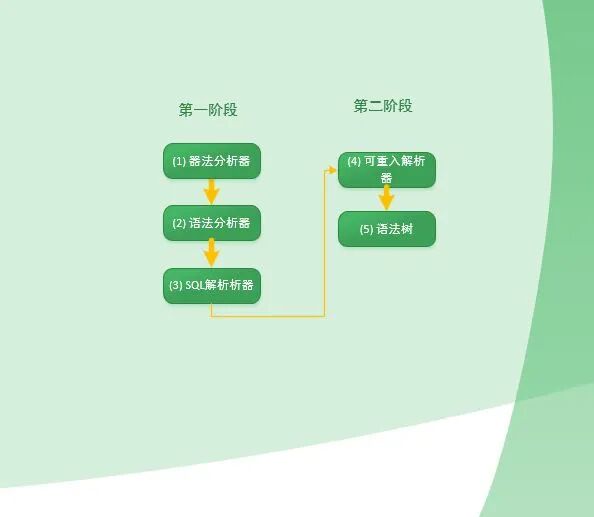
SQL解析器的实现,主要有以下步骤:
很多读者第一次了解SQL解析器时,可能有些疑惑,比如SQL解析器是如何知道用户输入的SQL语句的,它是如何将用户输入的SQL语句转换成系统可以理解的命令的?
在数据表定义功能中,我们将搭建一个SQL解析器的框架,以后的功能只需要增加SQL语法即可。这里尽可能的由浅入深的步骤介绍SQL解析器的实现,希望能帮助大家更好的理解SQL解析器。
SQL解析器的实现,主要分为两个大的阶段,阶段之间是递进的关系。
1 初级SQL解析器
第一阶段首次了解SQL解析器的实现,从简单的demo一步步实现一个SQL解析器。将SQL解析器又拆分为词法解析与语法解析,最后将它们两者联合起来,形成完整的SQL解析器,在上图中用序号表示了它们的先后关系。
语言的解析已经成为计算机领域的一项基础功能,在编程语言产生时,就已经存在解析处理的过程,现在已经有一套完善的语言解析理论,同时也有成熟的工具来帮助我们实现任意语言的解析,比如lex、yacc、ANTLR、BNF、EBNF等,不需要再从字符串解析开始,我们可以将更多注意力放在语法的构造上。
工具的安装
我们选择元老级的解析工具lex和yacc,它们是Unix操作系统中最古老的解析工具,可以轻松实现词法分析和语法分析,它们两个工具联合使用,同时可以使用简单语法来定义SQL语法规则,通过这两个工具将这些规则转换成C语言代码,这样就可以生成一个完整的SQL解析器。
下文介绍了工具在linux系统上的安装方法,windows下安装就比较简单,请自行搜索相关资料。
【手写数据库内核miniToadb】支持SQL的数据库内核,解析工作准备,动起来吧
词法分析demo
从简单的demo体验一下使用lex工具实现词法分析器,通过简单的正则表达式,将语句中的单词和标识符号分割出来,形成一个词法单元的序列。
【手写数据库内核miniToadb】03语言理解的第一步--词法分析,统计单词实现就这样简单
SQL语句的词法单元有以下几种类型:
关键字:SELECT、FROM、WHERE、INSERT、UPDATE、DELETE、CREATE、DROP等等。 标识符:表名、列名、别名、函数名等。 运算符:+、-、*、/、=、!=、>、<、>=、<=、AND、OR、NOT等。 标点符号:,、.、;、(、)、[、]、{、}等。 数字:整数、浮点数、科学计数法等。 字符串:单引号、双引号、反引号等。
关键词在整个SQL语句中起到主干的作用,通过关键字搭建不同的语法句式;
标识符是由用户定义的字符串,比如表的名称就是一个标识符,当然它由组成规则,比如字母、数字、下划线、美元符号等组成,首字符必须是字母或下划线;
数字就比较复杂,不同的数字可以组成不同类型的值,比如整数,只有数字组成,而浮点数可以包含小数点和指数;
这些就需要分别来定义词法规则,才能正确的将SQL语句分割成对应的词法单元,下面两个章节详细介绍了SQL语句的词法规则。
这里的重点是,针对SQL语句,有那些词法单元需要定义,以及它们 的组成规则。当然词法规则中的正则表达式的语法,本教程的代码已经在github上发布,也可以通过AI来生成。
【手写数据库内核miniToadb】04我们要做的SQL解析器设计,SQL语法与类型定义,打造属于你的SQL
【手写数据库内核miniToadb】打卡第5天 创建表SQL的词法分析器,各字段被清晰识别
语法分析demo
SQL语句变化多样,介绍SQL语法就需要专门一本书,因此我们每次语法添加只关注当前要实现的功能,比如本次需要实现创建表的功能,那么就只需要关注CREATE TABLE的语法,这样就简单很多。
SQL语句由关键字来定义框架,其它内容都填充进去,因此语法规则可以由关键字的位置来定义,将整个SQL语句分割成不同的子句,每个子句再定义自己的语法规则。
这样就可以将复杂的问题拆分成几个简单的子问题,每个子问题都可以用简单规则来定义,这样就可以通过递归的方式来解决复杂的问题。
【手写数据库内核miniToadb】第6天 SQL语法分析器框架搭建,一步一步从顶向下编写子规则,工程代码丰富起来了
语法分析,是基于词法单元的基础上,也就是说,语法分析依赖于词法分析的结果。对于一串单词和符号,它们之间有先后顺序关系。根据其中的关键词来选择对应的语法规则,而当前没有匹配的规则或者多于一个规则时,暂时压入栈中,当有匹配规则时,从栈中弹出匹配的规则,直到序列中所有的词法单元都被解析完毕。
比如一个序列 “CREATE” 、“TABLE”、"student"、"("、"id"、"int"、")"、";", 它的处理过程如下:
当接收到“CREATE”时,尚无法确定规则,因此压入栈中;
当接收到“TABLE”时,弹出栈顶的“CREATE”规则,匹配成功;
按创建表的语法规则,规则下一个词法单元为标识符子规则,也就是表名称;开始匹配“student”
继续按规则进行匹配,下面是一个对括号的匹配,括号中是列属性定义子句,接下来分词单元 "("、"id"、"int"都压入栈,直到遇到")",弹出栈匹配成功;
括号中的内容继续压入栈,每两个词法单元匹配一个属性定义子规则,它是一个递归定义的规则;
最后一个词法单元";",匹配到SQL结束符,结束语法分析。
SQL解析器demo
前面介绍了词法分析和语法分析两个组件,如何将它们两者联合起来使用,形成一个完整的SQL解析器,这就是本次的SQL解析器demo。
【手写数据库内核miniToadb】第7天 完整的SQL解析器框架,分词语法解析一气呵成
其实这lex和yacc工具也设计了两者的联合使用的方式,只需要简单的代码改动就可以将前者的输入作为后者的输入,达到串联的效果。
这里需要注意的是,在语法规则中,关键字是用枚举数字来表示,所以在词法分析返回时,不再返回字符串,而是返回关键字对应的枚举值,其它仍是字符串形式返回。
2 可重复使用的SQL解析器
在第二阶段,我们将实现一个可重复使用的SQL解析器,它可以持续接收SQL语句,并解析,直到遇到程序退出指令。
可重入解析器
经过上面的过程之后,可以对当前输入的创建表的SQL语句进行解析,不仅可以得到分解的词法单元,还能够区别表名称,字段名称,数据类型等字段。
但是,它只能解析当前输入的SQL语句,解析完成后程序就退出来,这不符合服务端的需求,我们需要一个可以不断输入SQL语句,并持续解析的解析器。
【手写数据库内核miniToadb】第8天可重入的解析器模块,独立的SQL解析器模块成型啦
在lex和yacc解析的过程中,会在它们内部保存一些过程信息,如解析的位置,栈信息,规则位置等等,简单的再次调用时,就会延用上次的过程信息,产生错误的解析结果。
因此,我们需要将它的影响解析的过程信息,保存在外部的变量当中,每次解析一个SQL语句时,就初始化这个变量,并将这个变量和当前的SQL语句一起传递给解析器,这样就可以重复调用解析器了。
语法树生成
到目前为止,我们已经实现了一个可重复使用的SQL解析器,它可以解析创建表的SQL的语义,但是并没有将SQL传达的信息,如数据表名,字段定义等信息记录下来。
因此,我们需要在解析的过程中,将语义中携带的信息记录下来,为后面执行SQL时提供信息。
【手写数据库内核miniToadb】第9天 语法解析树的结构介绍
【手写数据库内核miniToadb】第10天 语法解析树的生成
【手写数据库内核miniToadb】第11天 打印解析树,SQL解析之后的变化
SQL语法解析规则,是由主干,再细分为第二层的子规则,甚至可以再细分为更小的多个层级的规则,整体来看它其实是一个规则树,最顶层规则可以抽象为就是一个“;"分号,即一个空语句。
每个子规则中都会携带一些信息,比如标识符子规则,在不同的位置时,它表达的语义不同,在表名的位置时,它就是表名称,而在字段定义中时,它可能是字段名称,也可能是类型名称。
因此,我们记录信息,也采用树形,每个规则表示一个树的节点,从最顶层规则表示树根节点,如果有下层规则,则表示树枝在这里分叉了,直到最细分的叶子节点。
这样我们就得到了一棵语法解析树,它记录了SQL语句的语义,并将其转换成树形结构,方便后续的执行。
🌟 点赞收藏,分享给身边的技术伙伴,关注我们,持续获取数据库内核开发的硬核干货!一起从源码级实现到分布式架构,解锁数据库技术的每一个核心细节!🚀
