



还在等什么?赶紧使用协程来处理异步IO,隐藏IO延迟以获得最大的读带宽
1、现代数据库系统在利用NVMe SSD时面临的两个挑战
1) IO并行度不足
现代服务器有很多PCIe通道,可以挂载多个NVMe SSD,从而可以线性扩展存储,减小DRAM和SSD之间的带宽差距。但是为了充分利用多个直连的SSD,需要大量的并发IO请求。也就是说,现代NVMe SSD需要大量的并行IO才能充分发挥性能,当前系统难以生成足够多的并行请求。
2) SSD的读延迟
SSD的读延迟(73us)比DRAM(181ns)高约400倍,同步IO会导致线程长时间阻塞等待,造成CPU资源浪费。
2、该论文的贡献
为解决上面的两个问题,使用异步IO和协程持续产生大量并并行IO请求,并隐藏IO延迟。与同步I/O方案相比,最多少16×个计算资源即可实现最优吞吐量,并且在超出主内存容量时仍能显著保持性能稳定。我们还展示了如何将协程集成到代码生成和分析型数据库管理系统Umbra中,并详细说明了如何从生成的代码调用预编译的C++协程。最后,我们提出了一种新型异步index-nested-loop join算法,该算法可使Umbra在分析查询中的端到端性能提升高达60%。
3、解决问题的方法
使用异步+协程的方式最大化存储的吞吐。利用异步IO调度上百个并行IO请求,并利用协程来隐藏IO延迟。
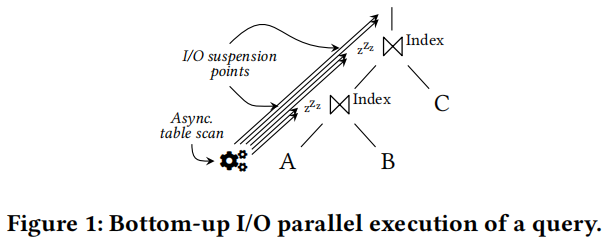
上图是设想的系统,以push-based pipeline的方式执行一个查询,底层的算子取数据,此时有可能产生IO,比如在join的过程中,取到内表值,外表的连接字段建立了索引,那么就可以通过索引对这个值进行探测。如果这一个索引页不在内存就需要IO。在加载数据前将这个IO上的pipeline挂起,异步处理内存中其他索引页的记录。
4、解决方案的有效性原理
1) 异步IO可以解决同步IO的问题,不阻塞线程。一个线程一次可以调度很多IO操作,减少了CPU负载。Linux的新异步IO接口io_uring比aio更据高效且易用。线程通过轮询io_uring获取完成的事件,动态唤醒对应的协程,实现请求-响应的解耦。io_uring覆盖文件、网络、管道等所有I/O类型,支持缓冲I/O(Buffered IO)和直接I/O(Direct IO)
2) C++20提供了协程库(可以将一个函数挂起,后面还可以恢复执行),可以简化将一个同步IO接口转换成异步IO方式的工作。协程零阻塞特性:遇到IO操作时可以将自身挂起,释放CPU去处理其他就绪协程。本文中的Umbra每个线程处理128个数据分片,每隔分片对应一个协程。协程遇到未缓存的数据时挂起,线程转而执行其他就绪协程;IO完成后恢复挂起后的协程。
3) SSD的内部并行:现代NVMe SSD通过PCIe直连可提供高达7GB/s的单盘带宽,但需要深度并行访问(每个SSD需32个并发请求)才能充分利用其内部多闪存芯片的并行性。传统同步I/O因线程阻塞无法满足这种并发需求,而异步I/O通过非阻塞调用允许单线程同时发起数百个请求。
4.1表扫描的顺序IO
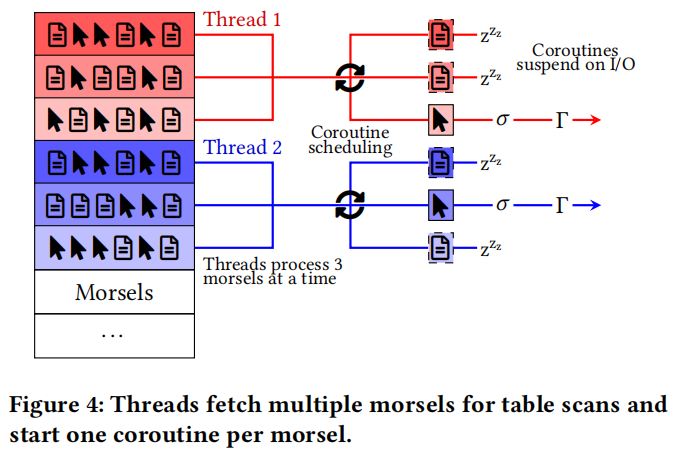
如上图,异步IO使用每个块一个协程的方式,每隔线程的最大IO深度为一个线程一次取的块数。上图例子IO深度是3,即每个线程从work queue取3个块开启3个协程。如果协程需要取的块不在内存,就发起一个异步非阻塞读操作,并挂起自身。对于在内存的块,协程同步处理里面的tuples。只要存在未完成的I/O操作且没有就绪的协程,线程就会轮询线程本地的io_uring,以获取新完成的I/O请求,并恢复发出这些请求的协程。只有当前线程处理完取出一批块,才会从work queue中取下一批块。
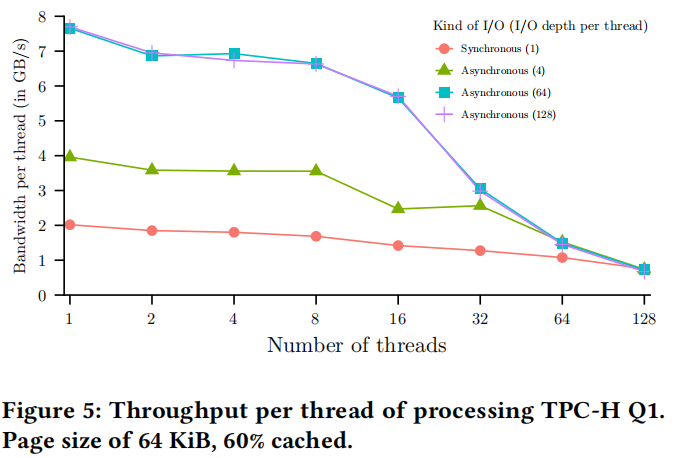
针对TPC-H Q1,协程和异步I/O时每个线程吞吐量。使用同步I/O时,一个线程最多只能有一个未完成的I/O请求。而异步I/O允许一个线程同时发起多个I/O请求。但由于I/O仍消耗大量CPU周期,单个线程不足以饱和I/O带宽。在基准测试开始前,我们配置静态缓冲区管理器使用64KiB固定页大小,并确保lineitem表60%的随机页被缓存。为进行比较,我们调整线程数量和每个线程的I/O深度。同步I/O仅支持每个线程的I/O深度为1。异步I/O仅需1/4计算资源即可实现比同步I/O更高的吞吐量。
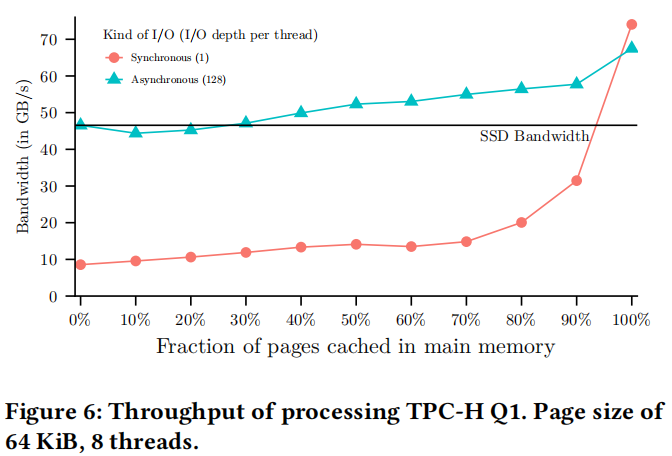
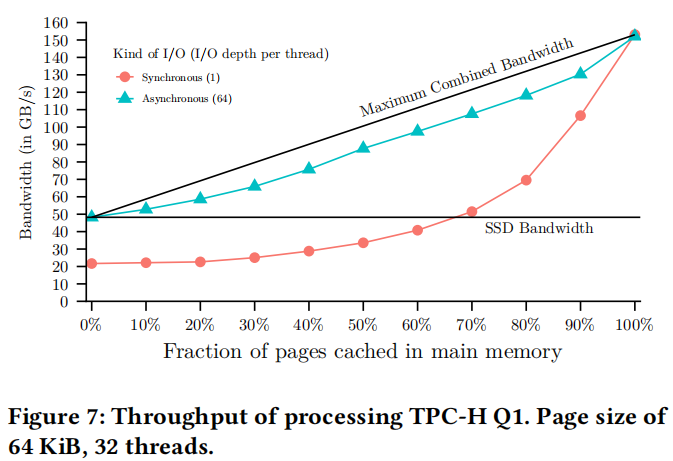
优雅衰减:工作集超出内存容量时的性能影响,并验证异步I/O与协程是否能缓解该问题。图6展示了处理TPC-H Q1查询的吞吐量(x轴)随主存缓存页面比例(y轴)的变化。我们对比了同步I/O与每个线程I/O深度为128的异步I/O(后者性能最佳)。我们再次使用64 KiB的页面大小,但这次将线程数固定为8个。此外,我们添加了一条辅助线,标记空缓存时异步I/O实现的带宽。结果表明,只要使用异步I/O,8个线程就足以实现47 GB/s的完整I/O带宽。同步I/O的I/O深度过低,导致吞吐量差了五倍。随着主内存中缓存页面比例的增加,同步和异步I/O的吞吐量仅略有改善。但即使缓存90%,同步I/O的吞吐量仍比空缓存时异步I/O的吞吐量低15 GB/s
在图7中,我们使用32线程重复实验,并添加了一条额外的辅助线,显示基于SSD和内存带宽的理论最优吞吐量。正如预期,线程数的增加提高了同步I/O的吞吐量。尽管如此,异步I/O仍优于同步I/O,并非常接近理论最优吞吐量。有趣的是,虽然8个线程足以达到SSD的可用带宽,但在64核插槽上我们需要32个线程才能饱和150 GB/s的DRAM带宽。总之,异步I/O极大地减少了超出主内存的影响。特别是对于几乎适合主内存的工作负载(例如80%缓存),同步I/O会损失超过50%的内存内性能。相比之下,异步I/O保留了约75%的性能。
4.2索引扫描的随机IO
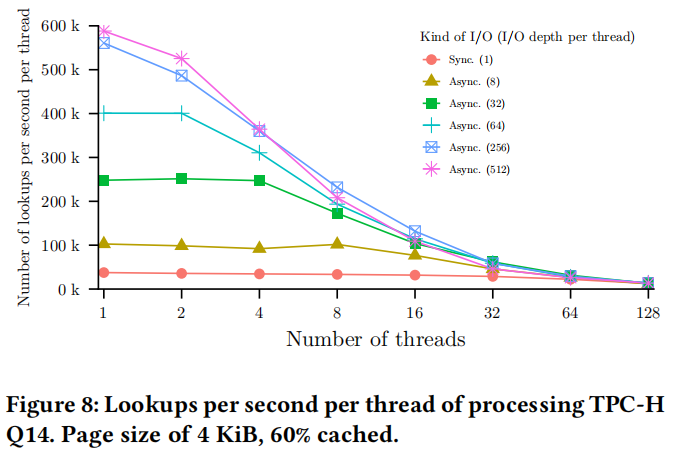
对于SSD,随机和顺序I/O的吞吐量几乎相同。然而,从SSD随机读取时的延迟惩罚很高,限制了执行大量随机I/O的工作负载,例如索引查找。TPCH SQL14对lineitem关系执行非常选择性的过滤,并将剩余元组通过外键列与part关系连接。最后,它使用单个分组对元组进行聚合。为了隔离随机I/O的影响,我们在执行微基准测试前将整个lineitem关系加载到内存中,因为它会被顺序读取。我们再次使用morsel驱动的并行化方法,并采用协程-per-morsel的方法。线程从工作队列中反复抓取一批内存中的lineitem元组morsel,根据谓词进行过滤,并在哈希索引中查找连接伙伴。如果引用的part页面未缓存,线程分别使用同步或异步I/O(带协程)从存储中加载它。对于后者,负责morsel的协程在发出I/O请求后暂停自身,线程切换到同一批中的另一个协程,如前所述。实验中,我们执行SQL14,将页面大小固定为4 KiB,并准备静态缓冲区管理器,使part关系索引中60%的查找来自缓存。大于4 KiB的页面大小显著增加了响应时间,但并未改变同步和异步I/O之间的相对差异。我们在图8中展示了微基准测试的结果。结果表明,对于由随机读取组成的工作负载,异步I/O和协程始终优于同步I/O。在单线程下,异步I/O的每线程I/O深度512的异步I/O吞吐量几乎是同步I/O的15倍。即使使用32个线程,吞吐量仍比同步I/O高出两倍以上。但当我们比较绝对数值时,结果更为惊人:128线程下同步I/O达到峰值1,607,774次/秒的查找量,而异步I/O仅需4个线程即可超越该数值(1,854,512次/秒)。这意味着用16倍更少的线程实现了更好的性能。结论表明,要充分发挥现代NVMe SSD的性能,必须采用异步I/O和协程。此外,异步I/O释放了资源,使我们在相同硬件上完成更多工作,或使用更廉价的硬件完成相同任务。
5、具体实施方式
5.1 C++协程
co_await、co_yield、co_return三个关键字,函数中出现这三个关键字任意一个,就告诉编译器该函数是一个协程函数。co_return:结束协程的执行并返回一个值;co_await是一个挂起点,表示在此处协程可能暂停执行;co_yield将一个值返回给协程的调用者,并挂起当前协程。下如是一个简单的协程例子:
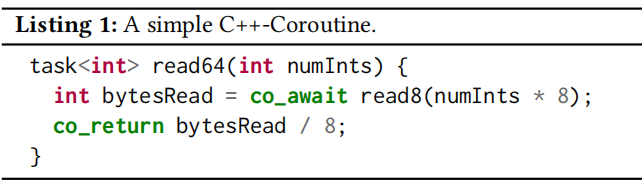
协程返回类型:task<int>表示这个函数是一个协程,task模板通常由协程库提供,用于管理协程的生命周期。当调用read64()时不会立即执行函数体,而实创建一个协程框架,执行到co_await时,如果read8()已经完成,则继续执行后面代码;否则read8()需要等待,协程在此处挂起,让出CPU;当read8()完成后,协程从挂起点恢复执行,最后通过co_return返回结果。
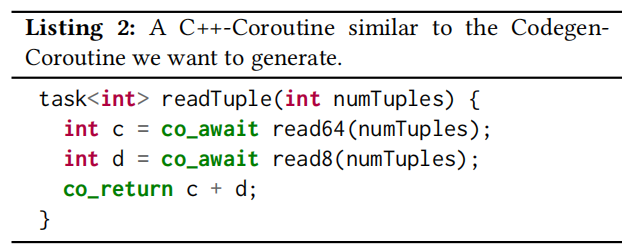
下面List2例子:协程挂起与执行流程:当执行到co_await read64时,若read64尚未完成,当前协程会挂起(保存状态并让出线程控制权),但不会阻塞线程,该线程可以执行其他协程,它不会立即执行co_await read8。协程的挂起是顺序的,必须等待read64完成后才会继续执行下一行代码(即co_await read8)。
恢复执行点:read64完成后,协程从挂起点(co_await read64处)恢复,继续执行下一行co_await read8,若read8也需等待,协程会再次挂起,直到read8完成,最后执行co_return。
与异步I/O的并行性:虽然协程代码是顺序编写的,但底层I/O操作(如read64和read8的磁盘读取)可能由操作系统并行处理,通过异步I/O机制(如io_uring)实现高效调度。
1) 协程挂起:仅暂停当前协程,线程可执行其他任务
2) 同步阻塞:传统同步代码会阻塞线程直到I/O完成,而协程通过挂起避免资源浪费
总结:协程的co_await是顺序执行的,但通过挂起机制实现了非阻塞的异步I/O,底层可能并行处理多个I/O请求。注意:只有线程中有多个协程时,才可以完成异步操作。
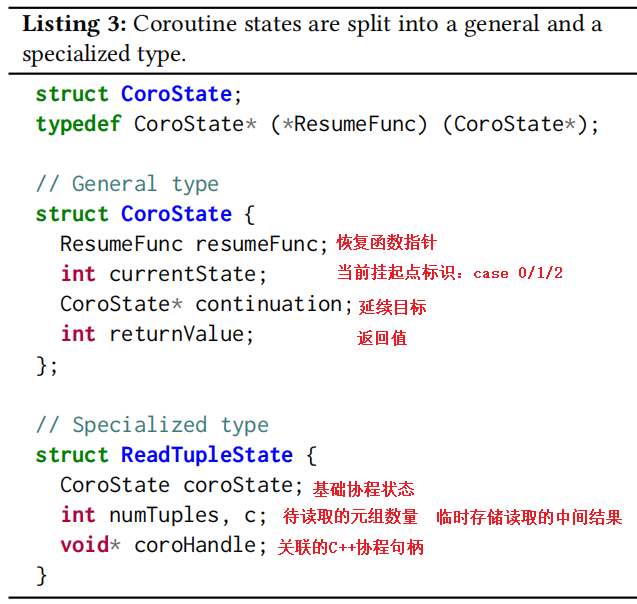
协程的状态就是协程的激活帧,本文将他分为两种类型如下图所示。所有协程都使用CoroState类型(通用类型)的对象来管理协程执行所需的内部变量。ReadTupleState(特殊类型)来提供参数存储和跨挂起点参数值的存储。
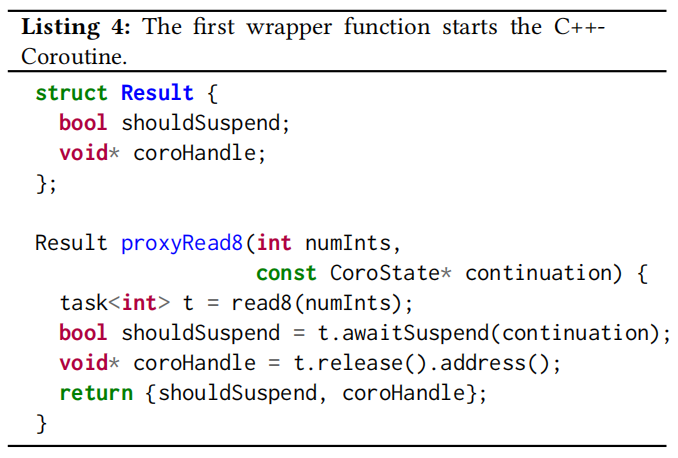
Listing4中的C++协程函数的包装函数:proxyRead8:
1)read8这一步建立一个协程框架t的task
2)调用task对象的awaitSuspend方法开启当前协程的执行,该协程同步完成时,会返回shuldSuspend为false
3)如果协程没有同步完成,awaitSuspend方法设置协程为continuation状态挂起
4)t.release().address()不论协程同步完成还是挂起,都会执行获取协程句柄,将该句柄保存起来以便后续恢复
注意:proxyRead8这个函数的执行在线程中,当调用t.awaitSusspend()时,如果协程暂停了,该方法返回true,此时协程状态会被保存,控制权返回给调用者(proxyRead8函数)。协程暂停,并不意味着线程停止,只是当前协程的执行被挂起了。
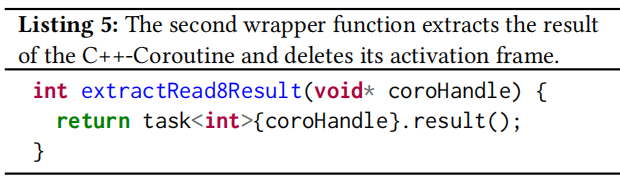
Listing5为第2个包装函数,在协程完成后调用,使用协程句柄提取结果(由co_return返回)。通过组合一个新的task对象(现有协程对象的ownership)做提取结果的事。最后,该task对象的destructor会删除协程对应的激活帧。
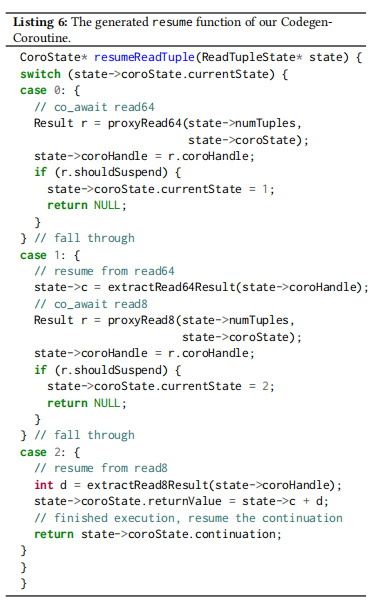
Listing6展示了恢复函数:该封装函数调用上面的2个封装函数函数。根据currentState值决定恢复点。
1)在初始化状态0,调用第一个协程proxyRead64(内部会使用read64的task协程对象执行该协程),如果该协程挂起了,就将该协程句柄保存起来,然后将当前状态currentState置为1,然后返回NULL。由于协程挂起只是该协程将控制权返回给调用resumeReadTuple函数的线程,不影响该线程继续向下执行,所以可以继续向下执行
2)状态0时同步read64执行完,则继续fall through当前的case,进入case 1,从read64协程中提取处结果,然后通过协程read8。协程同样的道理。协程挂起,则保存当前协程句柄,然后返回NULL,否则继续向下执行
3)状态2时,提取处协程结果,将两者值求和,结束执行。
4)Case 1和case 2同样时协程恢复时的处理点,协程恢复后根据currentState值继续执行对应分支。
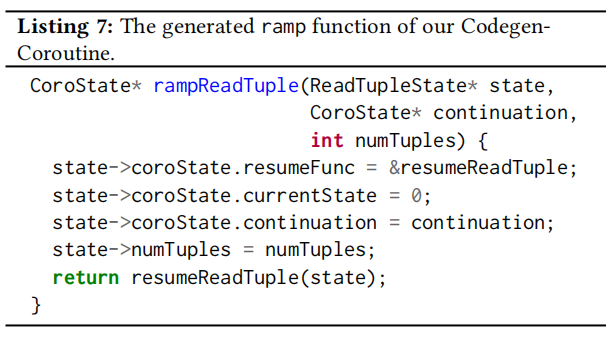
Listing7展示了ramp函数,也就是入口函数。rampReadTuple初始化了协程状态,将控制权转给resume函数。恢复函数会频繁调用以恢复到挂起点,知道协程完成。
5.2 异步IO
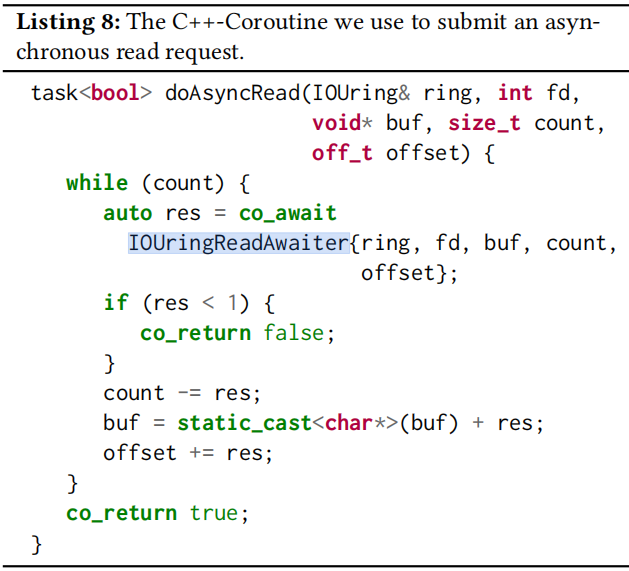
io_uring这样的异步接口提供了两个基本操作:提交请求和轮询请求完成状态。上图展示了我们用于提交异步读取请求的C++协程。IOUringReadAwaiter{}是一种所谓的等待器(awaiter):包含将I/O请求提交给io_uring,存储与请求关联的协程句柄(参见std::coroutine_handle<Promise>::address),然后暂停协程。我们还提供了另一个函数用于轮询(poll)请求完成状态。如果有已完成请求,我们会从中提取协程句柄,并通过调用协程句柄的resume()方法从上次暂停点恢复对应的协程。
5.3 umbra中的协程与异步IO
将一个较小的中间结果和大130倍的lineitem表进行连接,连接键是lineitem表的主键的前缀。Umbra在主键上维护一个B-Tree索引,可以使用index-nested-loop 算法高效连接。不需要读取整个linetime表,仅需要连接相关的页。访问模式本质上是随机的,所以可以使用协程,可以隐藏IO延迟并最大化IO并行。
C++实现B-Tree并使用协程进行page-lookup:
1) 将从存储读数据函数路径上的函数返回类型由T改为task<T>
2) 每次调用此类函数时,我们都必须使用co_await运算符,将调用者编译为C++协程
3) Join的探测端至少128个元组创建一个协程。当协程因IO挂起时,将其状态和恢复信息存储到io_uring的请求中
4) 线程本地的io_uring实例(异步IO接口)达到容量上限时,线程会开始轮询io_uring以获取完成的事件
5) 根据完成的事件,提取关联的协程句柄,从而恢复被挂起的协程继续执行
遇到的问题:当大量并发IO请求时,多个协程会同步加载同一个page,为保证正确性,不可以在内存中由同一个page的多个副本;并且仅调度一次IO更据高效。当一个协程开始加载某个页面时,会将该页面的swip标记为"locked"状态,其他尝试访问同一页面的协程会检测到这个锁定状态。协程遇到锁定的页面时,将该协程放到轮询调度队列中,线程继续处理其他可以执行的协程。被暂停的协程会在后续的调度周期中重新尝试访问目标页面,如果页面已加载完成(解锁),协程可以继续执行;若仍被锁,协程再次放到调度队列等待下次尝试。这种机制虽然增加了少量重试开销,但相比线程阻塞带来的性能损失要小得多。
6、效果
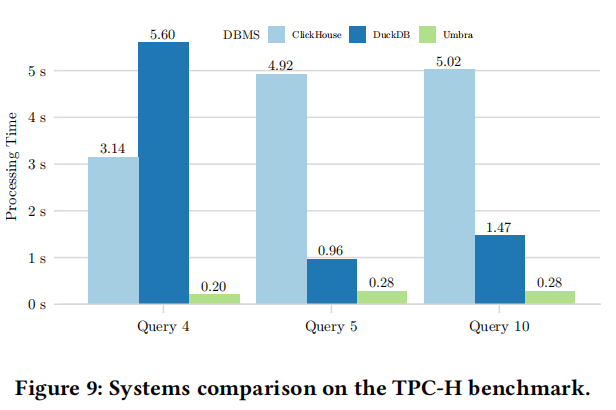
TPCH的SQL4、SQL5和SQL10使用协程改造的index-nestloop join算法和clickhouse、duckdb进行对比,可以看到协程改造的性能高一个量级,简直太棒了!
7、附录
7.1 什么是线程IO深度?
单线程可以同时提交的IO请求数。单线程通过异步机制在某一时刻能并行发起但尚未完成的IO请求数量。
它的并发主要依靠非阻塞IO+事件循环/回调机制,调用异步IO接口比如libaio,提交请求后立即返回,不需要等待IO完成;内核将请求加入到设备队列,由硬件并行处理。线程通过epoll或者回调获取结果。
和多线程并发的区别是,多线程每个线程提交1个请求后阻塞等待结果,线程数就是请求数,可以多个CPU并发执行。
它和内核及硬件的协作:单线程提交的IO请求加入到内核的设备队列,比如NVMe驱动队列,由设备并行处理;NVMe SSD支持64K队列深度,可以同时处理数万个请求。硬件通过中断或者轮询通知内核,内核回调用户线程。
7.2 什么是协程?
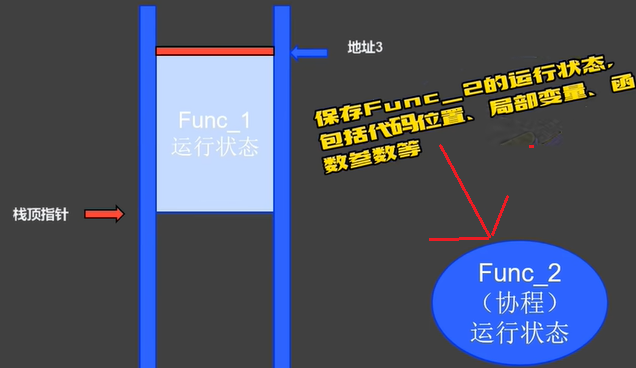
协程是一个可以暂停和恢复执行的函数。与普通函数的区别在于:普通函数是线程相关,而协程不依赖特定的线程。比如某个线程在进行函数调用时,线程上的栈会记录这个函数的状态,比如参数、局部变量等,通过移动栈顶指针完成。当函数执行完后,栈顶指针向上移动,属于Func_1的地址3到地址2的内存被回收。函数状态的维护完全依赖于线程栈,脱离了线程,函数就不存在了。
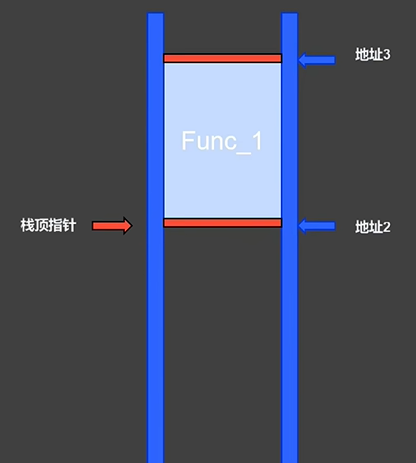
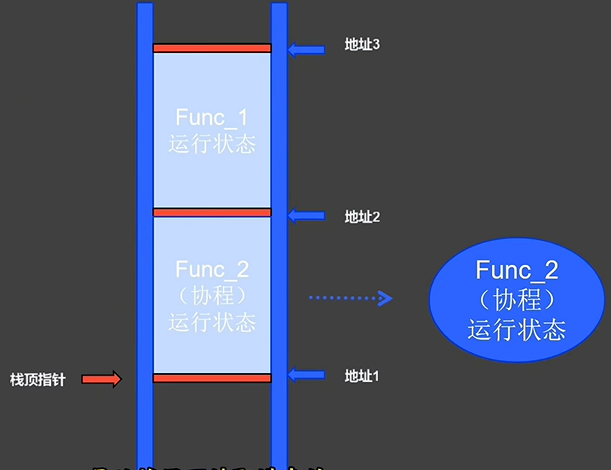
如下图所示,如果Func_2是协程,那么调用Func_2的时候,它的状态所需要的内存会提前在堆上分配,独立于线程栈,此时传递给Func_2的参数都会复制到协程运行状态中。
如下图所示,当调用Func_2时,也会移动栈顶指针,在线程栈分配空间,并将堆上分配的存储的协程状态拷贝到线程栈空间。
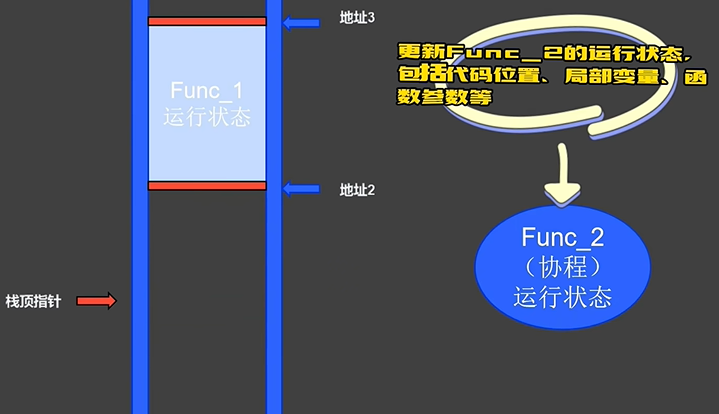
如果Func_2需要暂停,则需要更新运行状态记录到堆的内存中,包括代码位置、局部变量、函数参数等。栈顶指针上移,回收Func_2的栈内存。
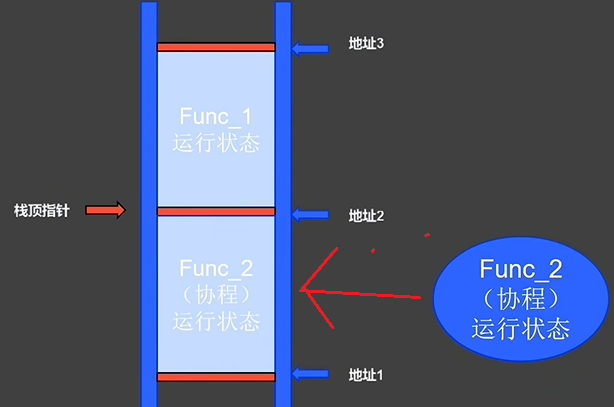
Func_2恢复继续执行的时候,将堆上的状态信息重新拷贝到线程栈分配的地址中,Func_2的执行是从上次暂停的位置继续执行。协程和线程无关,即使这个线程销毁,下个线程继续调用Func_2的时候,也可从这块堆上拷贝协程运行状态到它的线程栈
7.3 什么是协程的activation frame?
协程执行过程中的activation frame(激活帧)类似于传统函数调用的栈帧,是协程执行时上下文存储结构,用于保存协程的状态信息:局部变量(协程内部定义的变量)、参数值(协程调用时传入的参数)、挂起点状态(suspension point,记录协程暂停时的执行位置)、返回值(协程最终返回的结果)、continuation(指向恢复后应跳转的目标,比如父协程或者调用者)。
C++20中,激活帧由编译器隐式生成,对应coroutine_handle管理的上下文,本论文中通过手动实现类似的结构--CoroState。
参考
VLDB2022:https://db.in.tum.de/~fent/papers/coroutines.pdf
https://www.bilibili.com/video/BV1Cz9NYFE8E?spm_id_from=333.788.player.switch&vd_source=10ce859f3f7b1da2094a1283c19fe9b9&p=3
