



🧩 一、架构与设计类问题
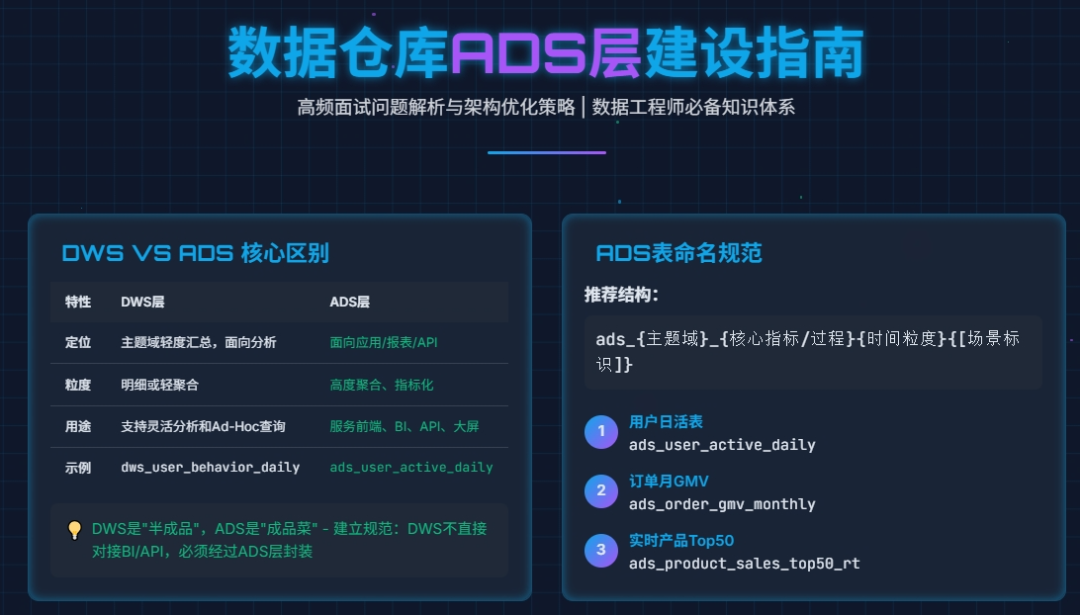
Q1:ADS层和DWS层的区别是什么?容易混淆怎么办?
✅ 区别:
✅ 解决建议:
DWS 是“半成品”,ADS 是“成品菜”
ADS 表名应体现 应用场景 + 指标 + 粒度(如
_daily
,_top100
,_api
)建立规范:DWS 不直接对接 BI/API,必须经过 ADS 层封装
Q2:ADS层应该按“需求”建表,还是按“主题”建表?
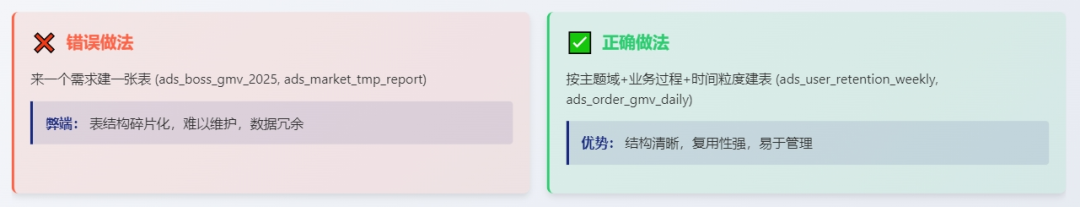
❌ 错误做法:来一个需求建一张表 → ads_boss_gmv_2025
, ads_market_tmp_report
✅ 正确做法:按主题域 + 业务过程 + 时间粒度 建表 → ads_user_retention_weekly
, ads_order_gmv_daily
✅ 解决建议:
制定命名规范(参考前文模板)
建立“ADS表评审机制”:新表需归类到现有主题,避免重复
推行“宽表优先”:一张表服务多个需求,减少碎片化
Q3:ADS层是否应该冗余存储?宽表是否太“宽”?
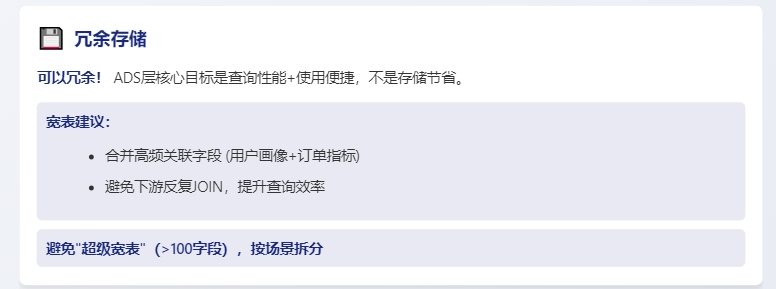
✅ 可以冗余! ADS层核心目标是 查询性能 + 使用便捷,不是存储节省。
✅ 宽表建议:
合并高频关联字段(如用户画像+订单指标)
避免下游反复 JOIN,提升查询效率
但也要避免“超级宽表”(>100字段),按场景拆分(如
ads_user_profile_full
,ads_user_profile_light
)
✅ 解决建议:
对宽表做“热度分析”,高频字段放前面
对超宽表按“使用场景”拆分子表(如 API 用轻量版,BI 用完整版)
使用列式存储(ORC/Parquet)+ 分区 + 压缩,降低存储成本
🛠️ 二、开发与管理类问题
Q4:ADS表命名混乱,怎么统一规范?
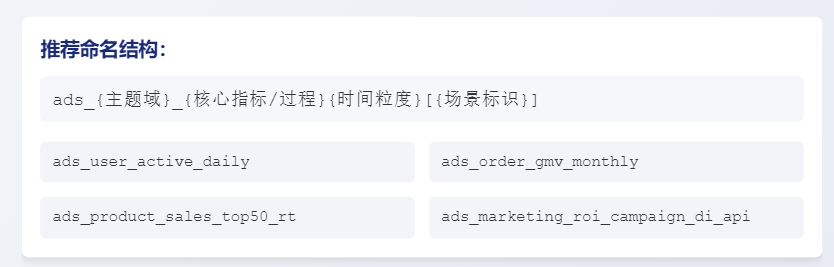
✅ 推荐命名结构:
ads_{主题域}_{核心指标/过程}_{时间粒度}_{[场景标识]}示例:
ads_user_active_dailyads_order_gmv_monthlyads_product_sales_top50_rtads_marketing_roi_campaign_di_api
✅ 解决建议:
制定《ADS命名规范》文档,全员培训
在建表流程中加入“命名审核”环节
使用脚本自动化校验命名(如 Python 正则检查)
Q5:临时表太多,没人敢删,怎么办?
✅ 解决建议:
强制命名规范:临时表必须带
tmp_
+ 日期 →ads_tmp_campaign_20250405设置生命周期:在元数据中标记“保留30天”,调度系统自动清理
建立“临时表登记制度”:谁申请、谁负责、何时清理
定期巡检:每月运行脚本扫描
tmp_
表,邮件提醒负责人
📌 示例:Hive 中可设置
TBLPROPERTIES ('auto.purge'='true')
或使用生命周期管理工具(如阿里云DataWorks)
Q6:ADS表字段口径不一致,业务方投诉“数据不准”?
✅ 根本原因:缺乏统一指标字典 + 字段级口径说明
✅ 解决建议:
强制要求每张表、每个字段必须有 COMMENT(含计算逻辑)
建立《数据字典文档》(参考前文模板),Confluence集中管理
关键指标建立“原子指标库”,如:
活跃用户 = 启动 + 停留>10s
GMV = 支付成功订单金额(不含退款)
口径变更必须走“变更通知流程”,通知所有下游
📈 三、性能与成本类问题
Q7:ADS表查询慢,BI卡顿,怎么办?
✅ 常见原因 + 优化方案:
✅ 建议:
对 ADS 表做“查询性能压测”
建立“慢查询监控告警”
BI 查询走 ADS,禁止直查 DWD/DWS
Q8:ADS层存储成本飙升,怎么优化?
✅ 优化策略:
生命周期管理:
临时表:30天自动删除
历史表:冷数据转低频存储或归档
压缩优化:ORC + Snappy / ZSTD
分区裁剪:避免全表扫描
数据分层存储:
热数据:SSD/高性能集群
温数据:普通HDD
冷数据:OSS/归档存储
定期瘦身:删除无用字段、合并相似表
👥 四、协作与治理类问题
Q9:业务方总说“找不到表”或“不知道用哪张表”?
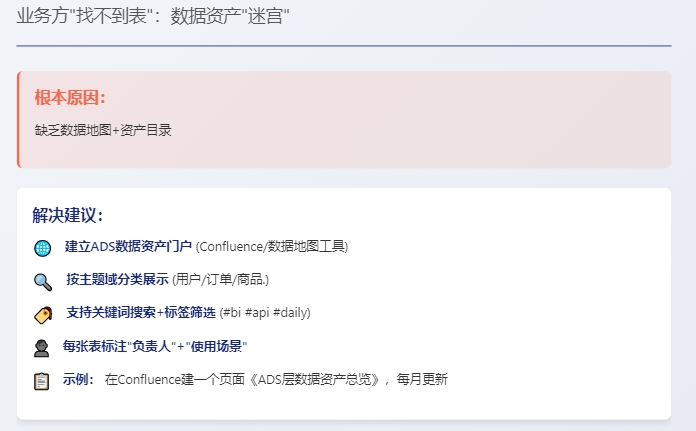
✅ 根本原因:缺乏数据地图 + 资产目录
✅ 解决建议:
建立 ADS数据资产门户(Confluence/数据地图工具)
按主题域分类展示(用户/订单/商品…)
每张表标注“负责人”+“使用场景”
📌 示例:在 Confluence 建一个页面《ADS层数据资产总览》,每月更新
Q10:ADS表没人维护,成了“僵尸表”?
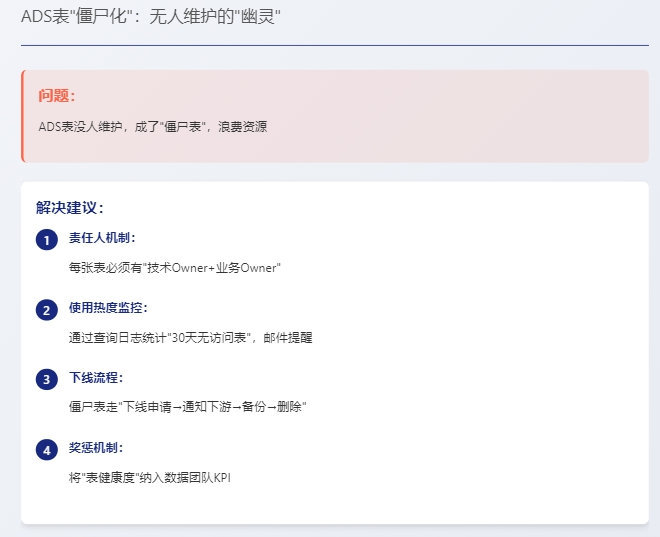
✅ 解决建议:
责任人机制:每张表必须有“技术Owner + 业务Owner”
使用热度监控:通过查询日志统计“30天无访问表”,邮件提醒
下线流程:僵尸表走“下线申请 → 通知下游 → 备份 → 删除”
奖惩机制:将“表健康度”纳入数据团队KPI
🚀 五、高阶扩展类问题
Q11:ADS层如何支持实时场景?
✅ 方案:
实时表单独命名:
ads_xxx_rt
或ads_xxx_realtime技术栈:Flink + Kafka + HBase/Doris/ClickHouse
数据一致性:实时表与离线表分开,口径可略有不同(如“实时GMV” vs “最终GMV”)
降级方案:实时失败时,自动切换到 T+1 数据
Q12:ADS层如何与数据服务(API)结合?
✅ 最佳实践:
建专用表:
ads_xxx_api
,字段精简、命名规范、带版本(v1/v2)API 层做缓存 + 限流 + 权限控制
建立“API-表”映射文档,方便追踪
数据变更通知机制(Webhook/消息队列)
✅ 总结:ADS层建设“避坑清单”
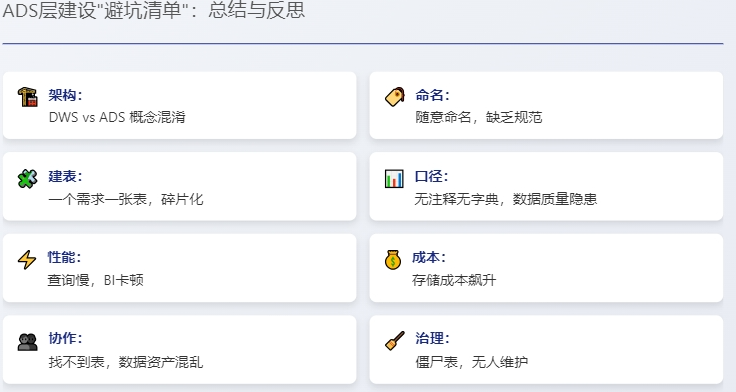
| 类别 | 关键避坑点 | 正确姿势 |
|---|---|---|
| 架构 | 和DWS混淆 | ADS是“成品”,直接服务应用 |
| 命名 | 随意命名 | 按主题+指标+粒度规范命名 |
| 建表 | 一个需求一张表 | 宽表复用,减少碎片 |
| 口径 | 无注释无字典 | 强制COMMENT + 数据字典 |
| 性能 | 全表扫描无分区 | 分区 + 列存 + 压缩 |
| 成本 | 临时表堆积 | tmp_ + 生命周期自动清理 |
| 协作 | 找不到表 | 建立数据地图 + 资产门户 |
| 治理 | 僵尸表无人管 | 责任人 + 热度监控 + 下线流程 |
往期精彩
ADS层表命名规范:拒绝“需求即表名”,构建系统化数据服务体系 | 理论+面试篇
如何设计一个评估618大促活动效果的指标体系? | 阿里巴巴
