一、DWD建模的核心挑战
在探讨AI解决方案之前,有必要明确传统DWD建模面临的主要挑战:
需求理解偏差
业务需求通常以自然语言描述,如“统计每个订单的客户信息、商品详情和支付状态”。数据工程师需从中提取实体、属性、关系,容易因理解偏差导致模型设计错误。数据源复杂性高
原始数据可能来自多个系统(如CRM、ERP、日志系统),格式各异(JSON、CSV、数据库表),字段命名不规范,存在冗余或缺失。建模规范难以统一
不同工程师对星型模型、缓慢变化维度(SCD)、主键设计等理解不一,导致模型风格不一致,影响可维护性。开发效率低下
从需求到DDL(数据定义语言)再到ETL脚本,整个流程可能耗时数天,尤其在需求频繁变更时,重复劳动严重。知识沉淀困难
建模经验多依赖个人积累,难以形成可复用的知识资产。
二、AI大模型如何赋能DWD建模
1. 技术基础:大模型的能力边界
现代大语言模型(如GPT-4、Qwen-Max、Claude 3)具备以下关键能力:
自然语言理解(NLU):能准确解析非结构化文本中的实体、关系和意图。 结构化输出能力:可生成JSON、YAML、SQL、DDL等格式化内容。 上下文推理:结合背景知识进行逻辑推导,如识别“客户”对应“customer_id”。 代码生成:支持生成Python、SQL、Spark等数据处理代码。 多轮对话与反馈修正:支持迭代优化输出结果。
这些能力为自动化建模提供了坚实基础。
2. 核心思路:从自然语言到DWD模型的自动化流水线
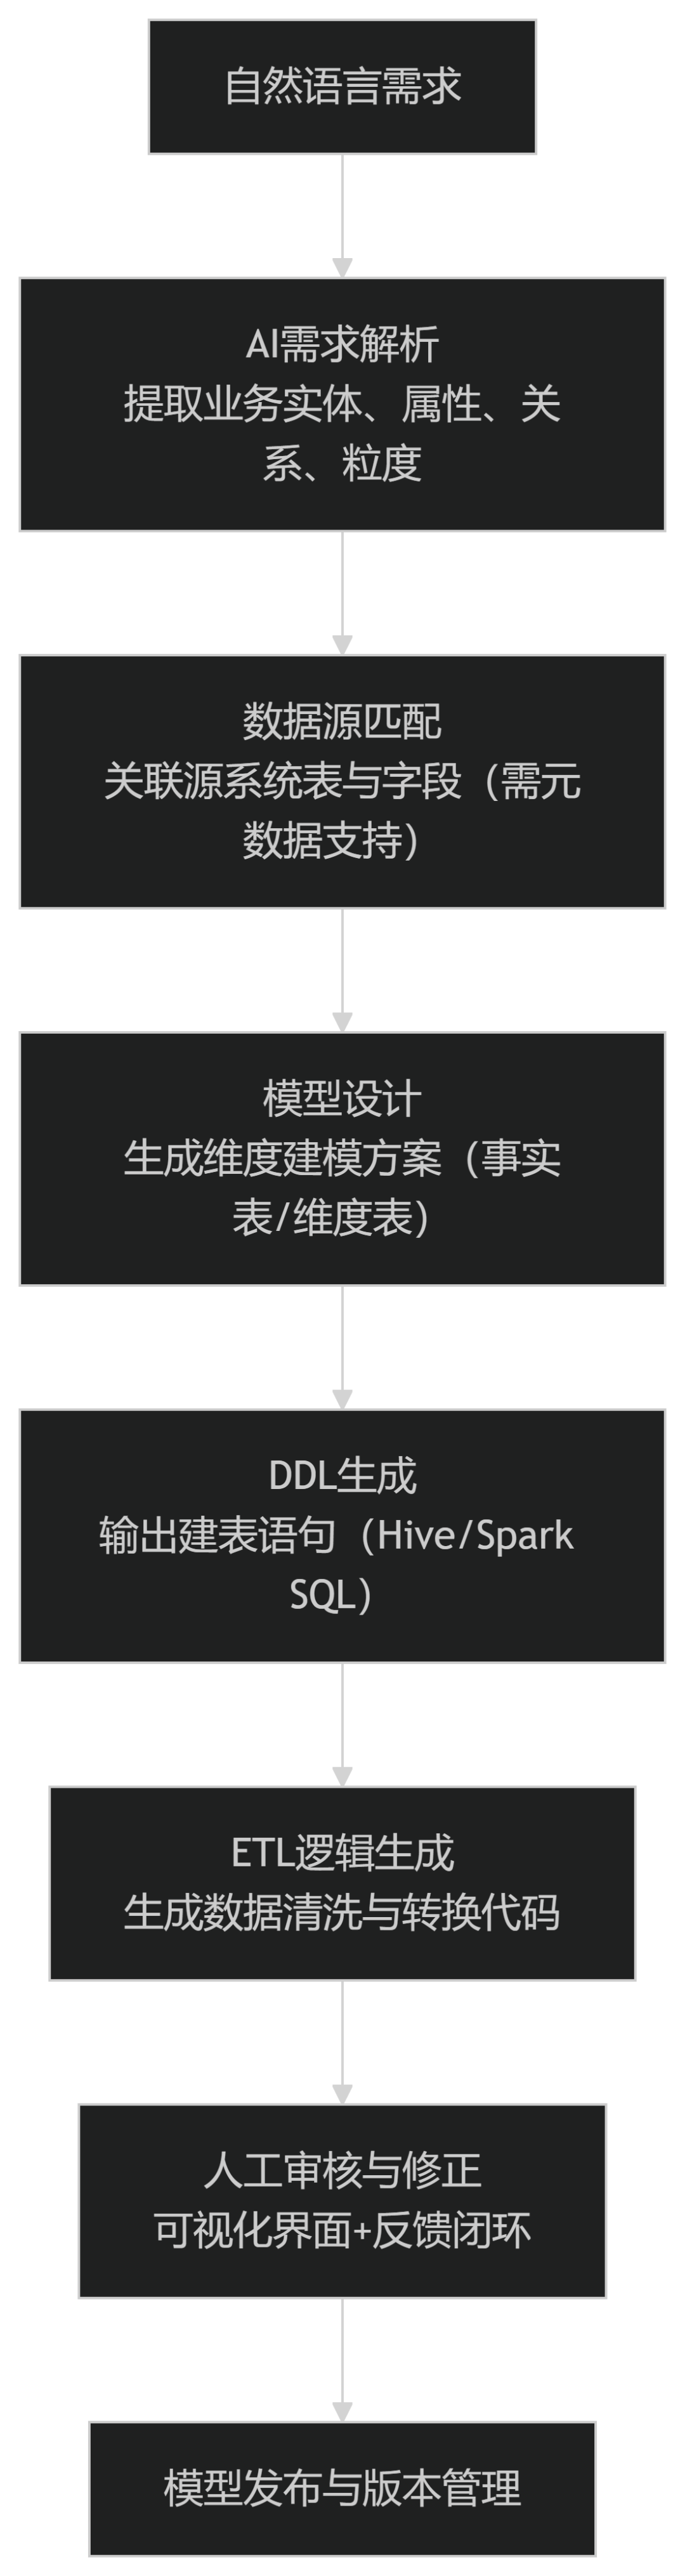
我们提出一个基于AI大模型的DWD建模自动化框架,包含以下关键步骤:
三、关键技术实现细节
1. 需求解析:从自然语言到结构化语义
输入示例:
“请为电商订单业务构建DWD层模型,需包含订单ID、客户姓名、手机号、收货地址、商品名称、单价、数量、订单金额、支付方式、支付状态、下单时间。数据来源包括订单表order_info、客户表customer_info和商品表product_info。”
AI处理流程:
实体识别:识别“订单”为主事实,“客户”、“商品”为维度。 属性提取:列出所有字段,并归类到对应实体。 粒度判断:根据“每个订单”确定粒度为“订单级别”。 主键推断:识别“订单ID”为事实表主键。 维度退化:判断“客户姓名”、“手机号”等是否可退化到事实表。
输出(JSON格式):
{
  "fact_table": {
    "name": "dwd_order_detail",
    "granularity": "per_order",
    "primary_key": "order_id",
    "fields": [
      {"name": "order_id", "type": "string", "source": "order_info.order_id"},
      {"name": "customer_name", "type": "string", "source": "customer_info.name", "degenerated": true},
      {"name": "mobile", "type": "string", "source": "customer_info.mobile", "degenerated": true},
      {"name": "product_name", "type": "string", "source": "product_info.name", "degenerated": true},
      {"name": "price", "type": "decimal(10,2)", "source": "order_info.price"},
      {"name": "quantity", "type": "int", "source": "order_info.quantity"},
      {"name": "total_amount", "type": "decimal(10,2)", "expression": "price * quantity"},
      {"name": "payment_method", "type": "string", "source": "order_info.payment_method"},
      {"name": "payment_status", "type": "string", "source": "order_info.payment_status"},
      {"name": "create_time", "type": "timestamp", "source": "order_info.create_time"}
    ]
  },
"dimension_tables": [
    {
      "name": "dim_customer",
      "fields": ["customer_id", "name", "mobile", "address"]
    },
    {
      "name": "dim_product",
      "fields": ["product_id", "name", "category"]
    }
  ]
}
技术要点:使用Few-shot Prompting,提供多个示例帮助模型理解输出格式;结合RAG(检索增强生成)引入企业建模规范文档。
2. 数据源匹配:依赖元数据仓库
AI模型需访问企业元数据系统(如DataHub、Atlas),以实现:
表名模糊匹配(如“order_info” ≈ “订单信息表”) 字段映射建议(如“customer_name” → “customer_info.name”) 数据类型推断(基于源字段统计信息)
Prompt示例:
你是一个数据建模专家。请根据以下业务需求和元数据信息,生成DWD模型设计。

【业务需求】
{用户输入}

【元数据】
- 表 order_info: 字段 [order_id, cust_id, prod_id, price, qty, pay_method, pay_status, create_time]
- 表 customer_info: 字段 [cust_id, name, mobile, addr]
- 表 product_info: 字段 [prod_id, name, category]

请输出JSON格式的模型设计,包含事实表、维度表、字段映射和表达式。
3. DDL与ETL代码生成
基于结构化语义,大模型可生成:
DDL示例(Hive SQL):
CREATE TABLE dwd_order_detail (
    order_id STRING COMMENT'订单ID',
    customer_name STRING COMMENT'客户姓名',
    mobile STRING COMMENT'手机号',
    product_name STRING COMMENT'商品名称',
    price DECIMAL(10,2) COMMENT'单价',
    quantity INT COMMENT'数量',
    total_amount DECIMAL(10,2) COMMENT'订单金额',
    payment_method STRING COMMENT'支付方式',
    payment_status STRING COMMENT'支付状态',
    create_time TIMESTAMP COMMENT'下单时间'
)
PARTITIONED BY (dt STRING)
STORED AS PARQUET
LOCATION '/data/dwd/dwd_order_detail';
ETL代码示例(PySpark):
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, when

spark = SparkSession.builder.appName("DWD_Order_Detail").getOrCreate()

# 读取源表
order_df = spark.table("ods.order_info")
cust_df = spark.table("ods.customer_info")
prod_df = spark.table("ods.product_info")

# 关联与清洗
result_df = order_df \
    .join(cust_df, order_df.cust_id == cust_df.cust_id, "left") \
    .join(prod_df, order_df.prod_id == prod_df.prod_id, "left") \
    .select(
        col("order_id"),
        col("name").alias("customer_name"),
        col("mobile"),
        col("prod_name").alias("product_name"),
        col("price"),
        col("qty").alias("quantity"),
        (col("price") * col("qty")).alias("total_amount"),
        col("pay_method").alias("payment_method"),
        col("pay_status").alias("payment_status"),
        col("create_time")
    )

# 写入DWD表
result_df.write.mode("overwrite").partitionBy("dt").saveAsTable("dwd.dwd_order_detail")
关键点:通过Prompt约束生成符合企业编码规范的代码(如字段别名、注释、分区策略)。
四、系统架构设计
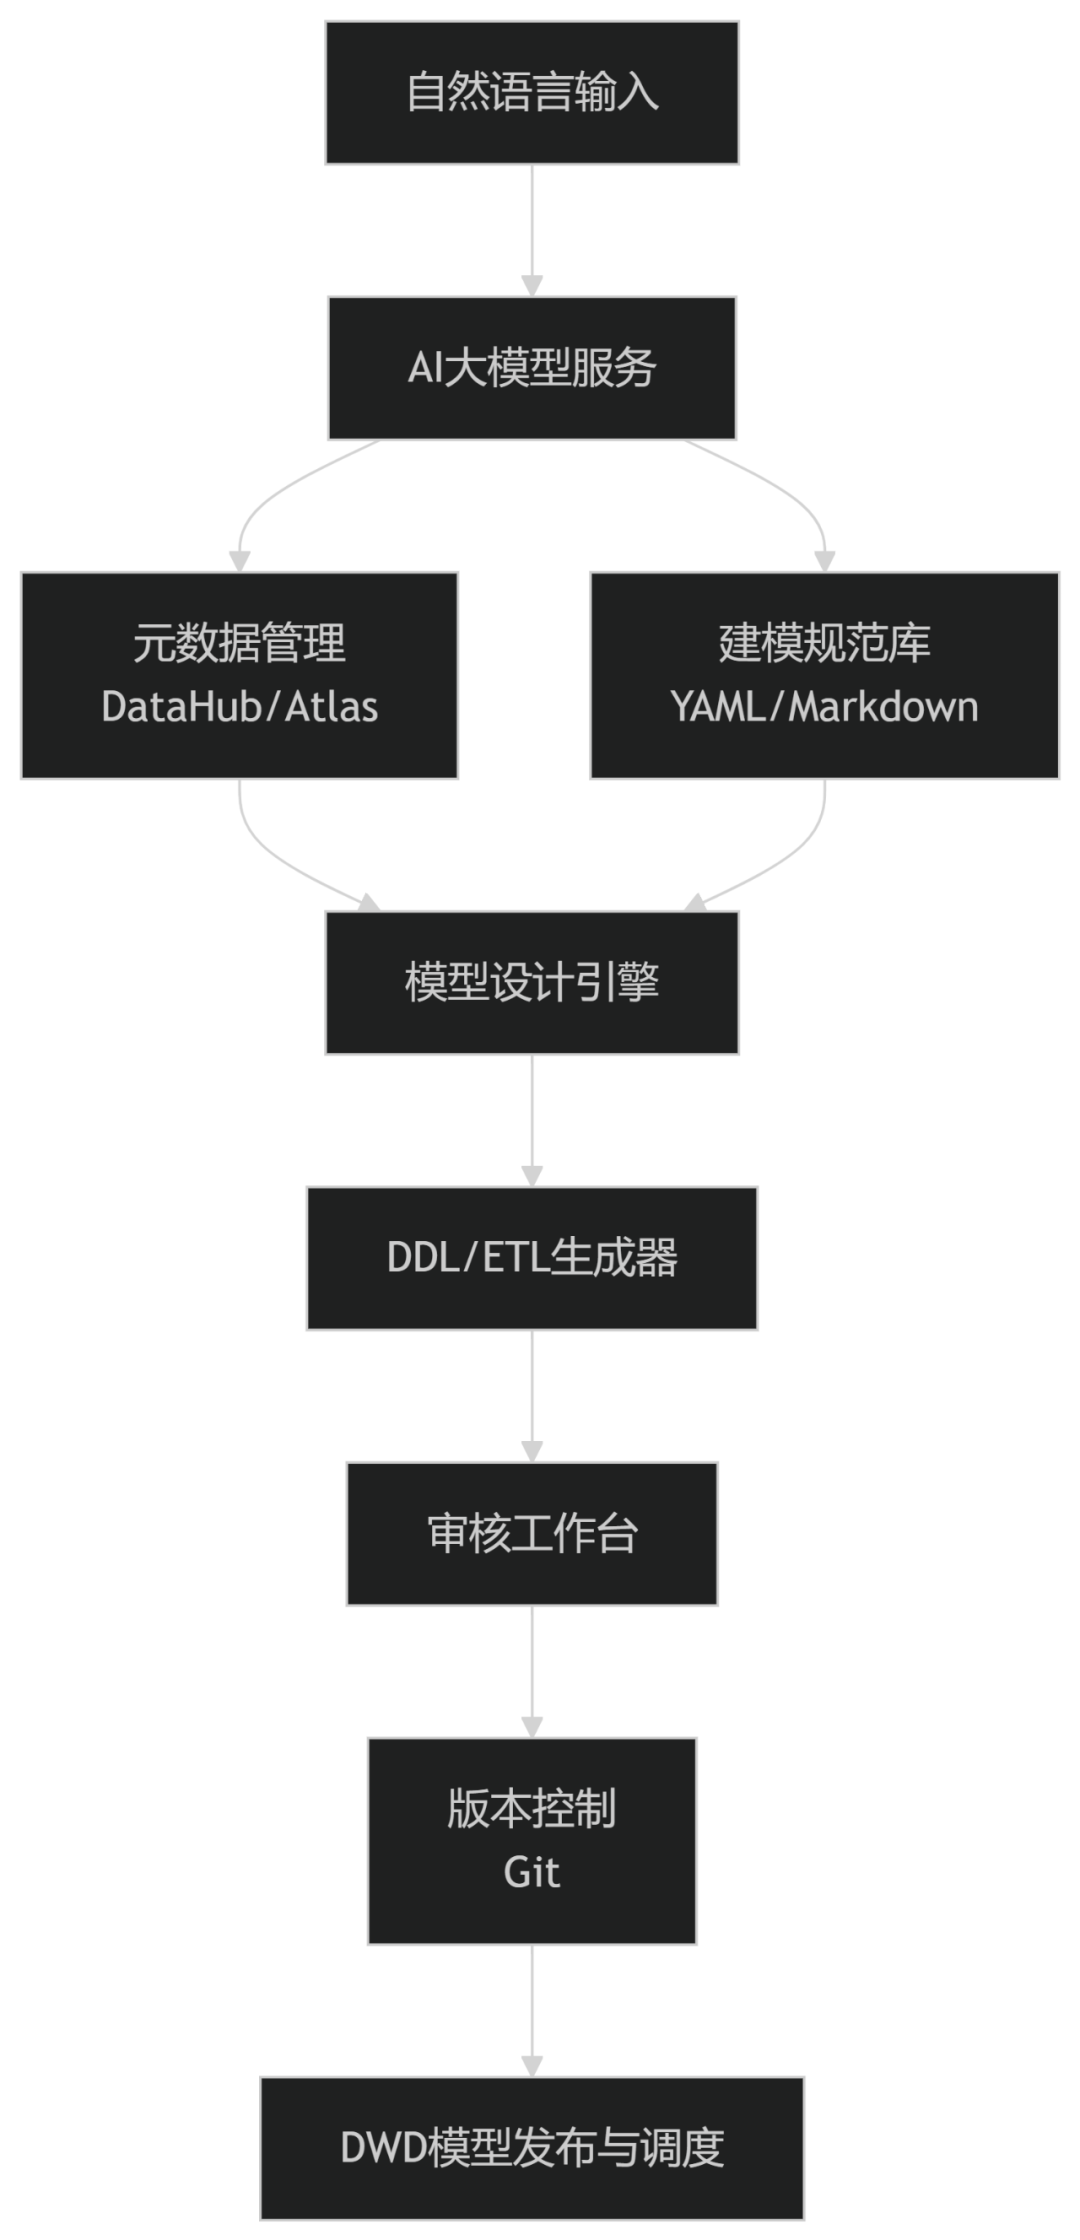
为实现生产级应用,需构建如下系统架构:
核心组件说明:
AI服务层:部署私有化大模型(如通义千问、ChatGLM3)或调用云API,支持流式输出与函数调用。 元数据服务:提供表、字段、血缘、数据质量等信息查询接口。 建模规范库:存储企业级命名规范、数据类型标准、SCD策略等。 审核工作台:可视化界面展示AI生成结果,支持人工修改、评论、审批。 版本与调度:集成Git进行模型版本管理,通过Airflow/DolphinScheduler调度ETL任务。
五、实际应用案例
某大型零售企业数据团队在6个典型DWD建模任务中测试该AI系统:
结论:AI显著缩短建模周期,且生成结果具备较高可用性,主要误差集中在复杂逻辑(如状态机转换)和边缘字段处理。
六、挑战与局限
尽管前景广阔,当前技术仍面临挑战:
元数据质量依赖:若源系统无完整元数据,AI难以准确匹配字段。 复杂逻辑处理:如缓慢变化维度类型2(SCD Type 2)、多源合并等,仍需人工干预。 企业规范适配:不同公司建模风格差异大,需定制化训练或Prompt调优。 安全与权限:大模型可能泄露敏感数据,需部署在私有环境并做脱敏处理。 可解释性不足:AI决策过程“黑盒”,需加强推理链可视化。
七、未来展望
随着AI技术演进,DWD建模自动化将向以下方向发展:
多模态输入:支持上传Excel、流程图、ER图等,AI自动解析。 主动建模建议:基于数据使用模式,AI推荐新增字段或优化模型。 端到端自动化:从需求到上线全流程无人干预,结合DataOps实现CI/CD。 模型自学习:通过反馈闭环,持续优化生成质量。
结语
AI大模型正在深刻改变数据工程的作业方式。基于自然语言自动生成DWD层模型,不仅是技术工具的升级,更是数据生产力的一次解放。它让数据工程师从重复劳动中解脱,聚焦于更高价值的数据治理、架构设计与业务洞察。
“告别手动建模”并非完全取代人类,而是人机协同的新起点。未来,最优秀的数据团队,将是那些善于驾驭AI、将创意与规范转化为数据资产的团队。
技术无须取代人类,而是让人类更接近创造的本质。
预告:下一篇文章将深入探讨——《【系列三】从DWD到DWS,AI大模型如何实现数据聚合的智能推荐?》,敬请期待。
本公众号相关内容推荐
面试内容推荐