数据中台建设中,ADS(Application Data Service)层是离业务最近的一层,直接服务于报表、BI看板、运营分析、算法特征和API接口。它承载着将数据价值转化为商业决策的关键使命。
然而,在现实中,ADS层的开发却常常成为整个数据链路的瓶颈:
一张简单的销售日报表,从需求提出到上线平均耗时 7~14天; 多个团队重复开发相似指标,导致口径不一、数据可信度下降; 每次需求变更都要重新走一遍“沟通→建模→开发→测试→发布”流程; 数据工程师80%的时间花在“翻译需求+写SQL”,而非真正的价值挖掘。
这正是我们常说的“最后一公里难题”:明明底层数据已经准备就绪(DWD/DWS),但面对灵活多变的前端需求,依然无法快速响应。
随着AI大模型技术的成熟,一场针对ADS层的革命正在发生。通过整合前文所述的智能ODS、自动DWD建模、DWS聚合推荐三大能力,并引入自然语言驱动的端到端生成机制,我们实现了从“业务需求”到“ADS表/接口”的全链路自动化交付。
一、传统ADS开发流程的痛点拆解
典型的ADS开发流程如下:
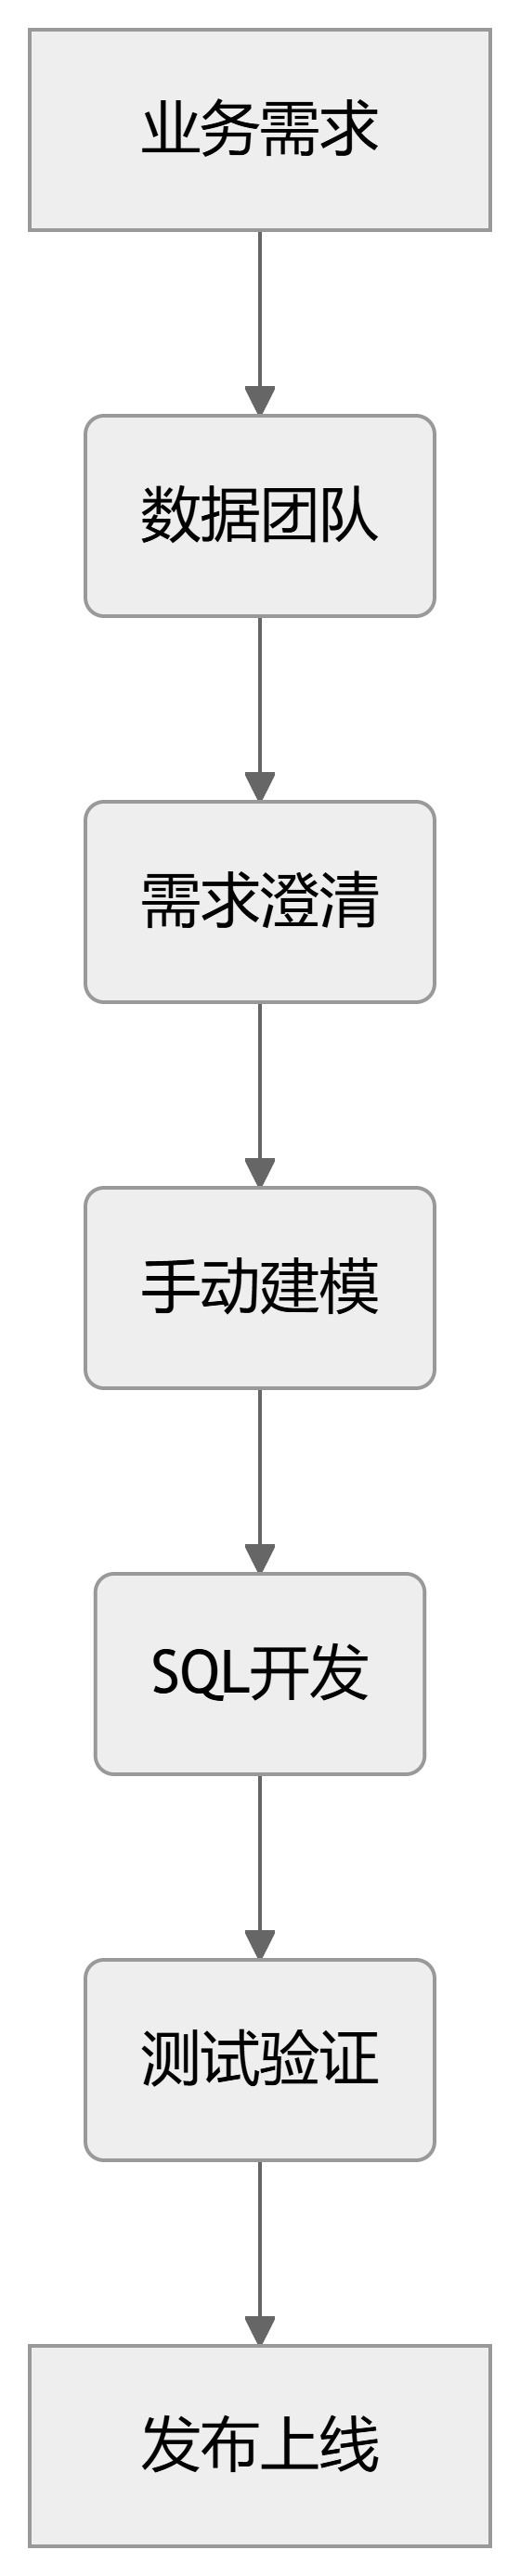
每个环节都存在显著延迟:
合计约 7.5天 才能完成一个中等复杂度的ADS表开发。
更严重的是:
缺乏对已有模型的感知,常重复造轮子; 指标定义模糊,“GMV”在不同场景下含义不同; 无法应对高频变更需求(如临时活动分析)。
二、AI驱动的ADS智能交付框架
我们将前3篇文章的技术成果串联成一条完整的AI赋能链:
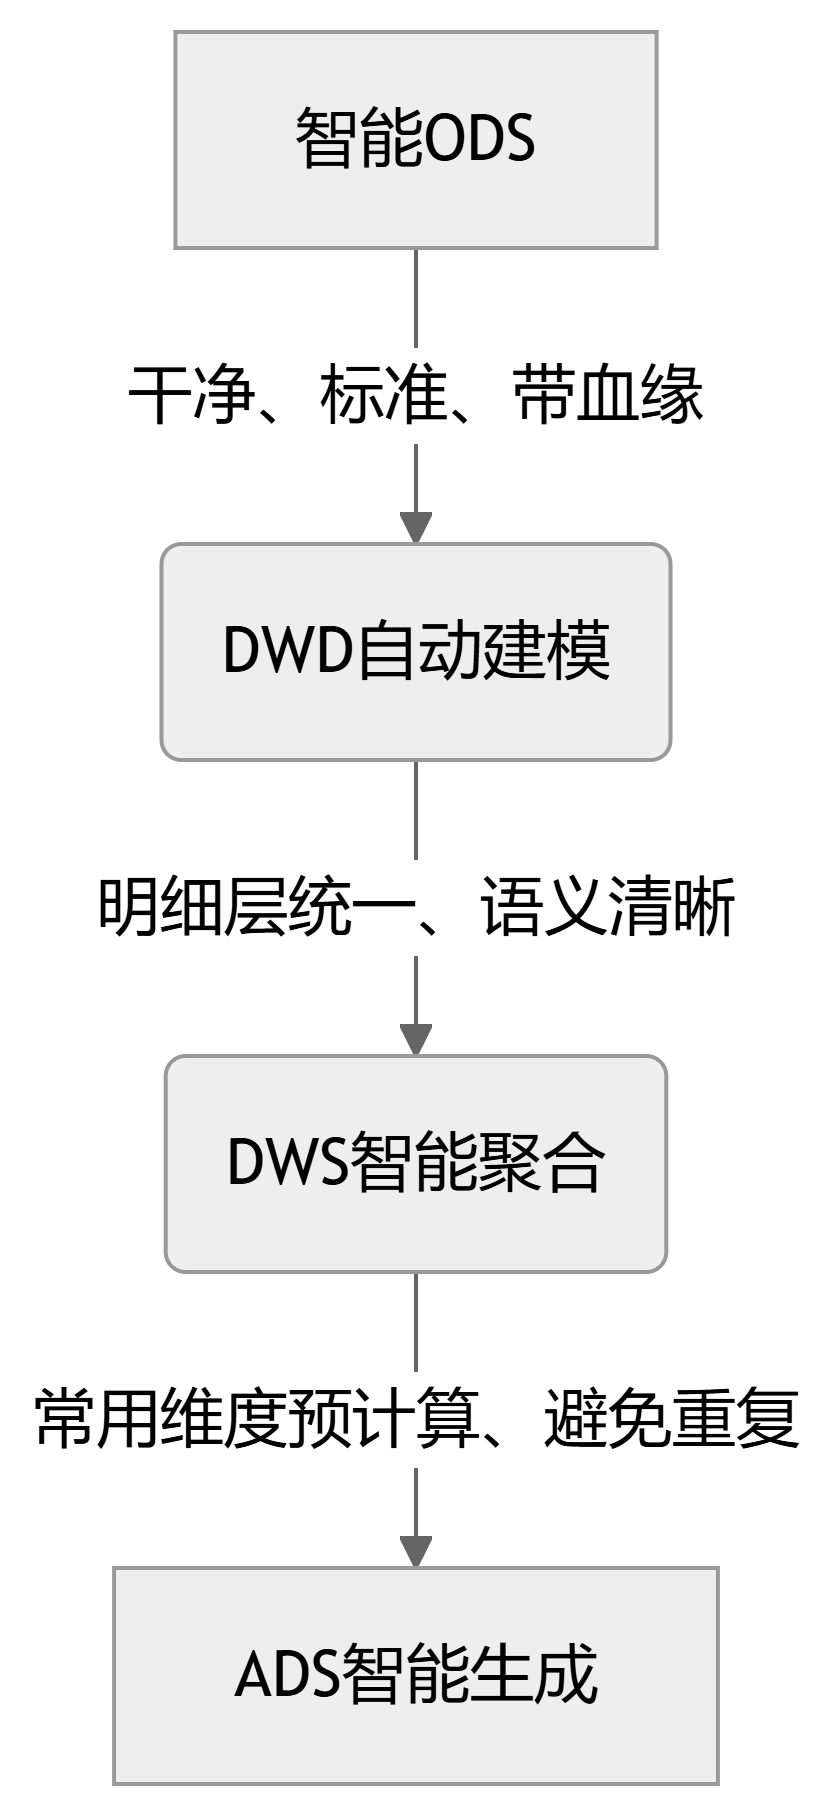
在此基础上,构建 “NL2ADS”(Natural Language to ADS) 系统:
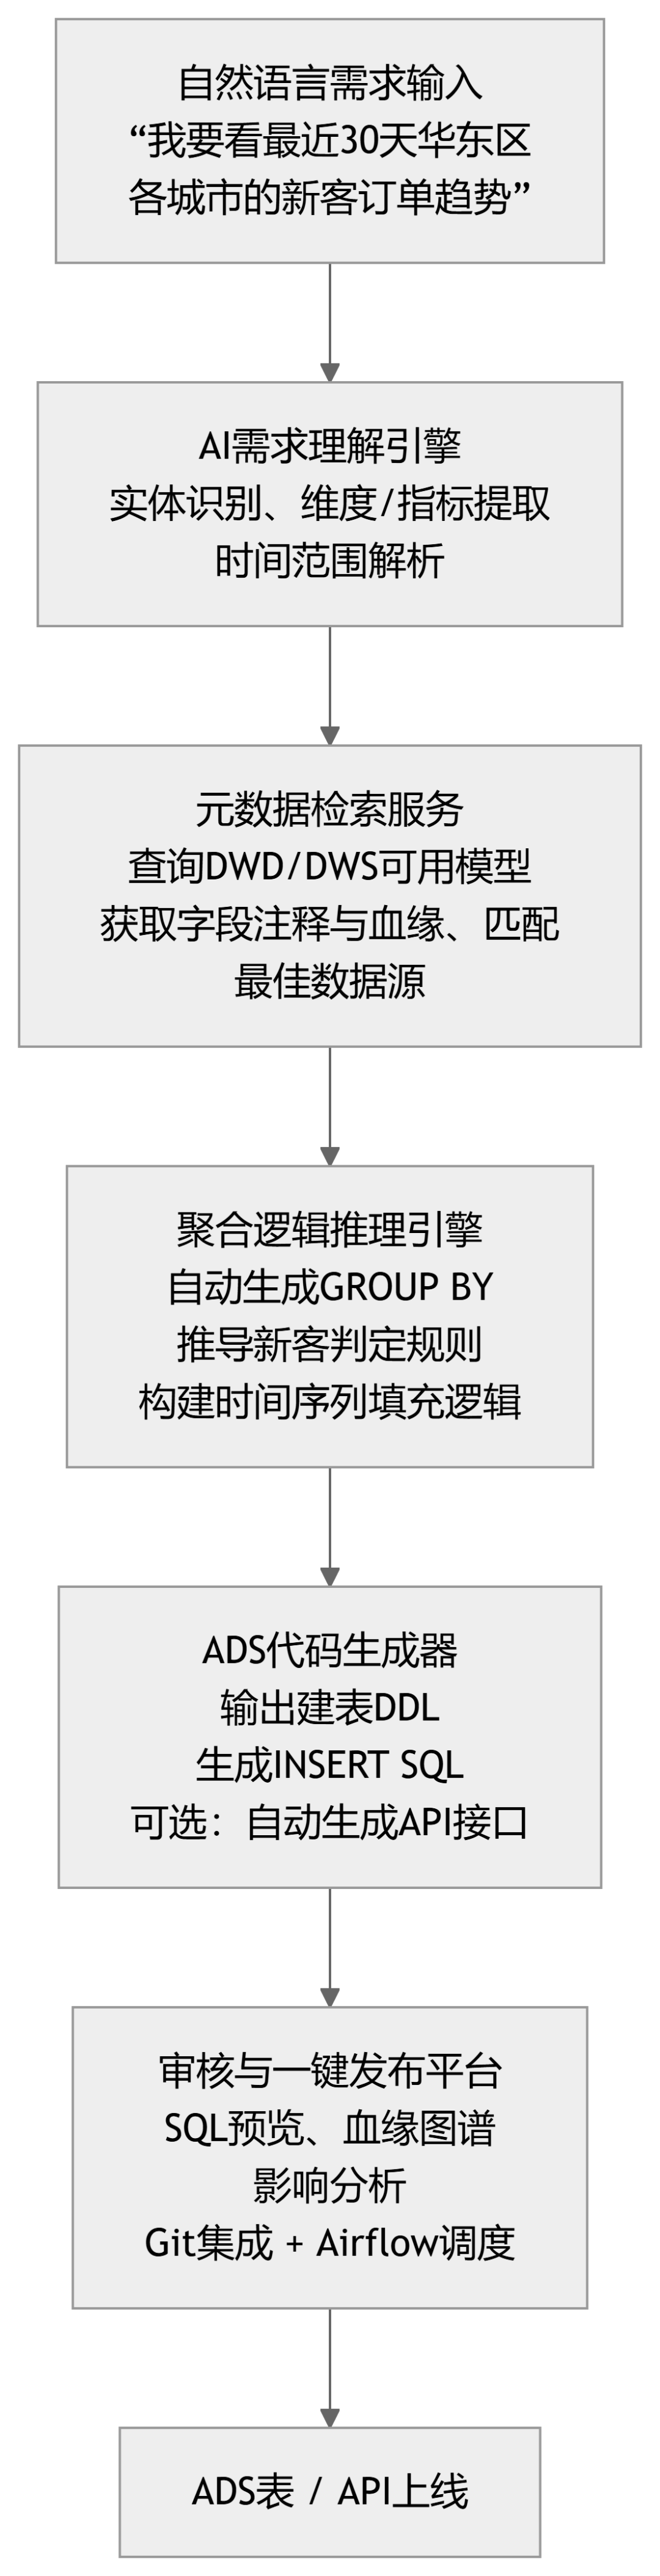
三、核心技术实现细节
1. 需求理解:从自然语言到结构化语义
输入示例:
“请帮我做一个报表,展示过去30天华东地区各城市的新增客户订单趋势,按周统计订单数和总金额,并标注每个城市的等级(A/B/C类)。”
AI处理流程:
使用Prompt Engineering引导大模型输出结构化结果:
你是一个资深数据分析师。请根据以下自然语言需求,提取以下信息:

{
  "topic_domain": "用户增长",
  "target_layer": "ads",
  "target_table_name": "建议的ADS表名",
  "dimensions": ["维度字段"],
  "metrics": [
    {
      "name": "指标中文名",
      "technical_name": "英文标识符",
      "expression": "SQL表达式"
    }
  ],
  "time_range": "时间范围",
  "time_grain": "时间粒度",
  "filters": "过滤条件",
  "source_tables": "建议的数据源表",
  "additional_logic": "特殊逻辑说明"
}
AI输出示例:
{
  "topic_domain": "用户增长",
"target_layer": "ads",
"target_table_name": "ads_new_customer_order_trend_wk",
"dimensions": ["region", "city", "year_week"],
"metrics": [
    {
      "name": "新客订单数",
      "technical_name": "new_cust_order_cnt",
      "expression": "COUNT(*)"
    },
    {
      "name": "新客订单总额",
      "technical_name": "new_cust_order_amt",
      "expression": "SUM(order_amount)"
    }
  ],
"time_range": "最近30天",
"time_grain": "week",
"filters": "region IN ('上海','江苏','浙江','安徽') AND is_first_order = 1",
"source_tables": ["dws_customer_trade_agg_by_city_di"],
"additional_logic": "新客定义:customer_id首次下单;城市等级来自dim_city_level表"
}
关键技术:
使用Few-shot Learning提供多个需求映射示例; 结合RAG检索企业《区域划分表》《城市等级标准》等文档; 利用Function Calling先查询元数据服务获取候选表结构。
2. 数据源智能匹配与复用判断
AI需访问元数据系统(如DataHub),执行以下操作:
(1)查找可用DWS表
查询所有包含“customer”、“trade”、“city”关键词的DWS表,并检查其字段是否覆盖所需维度与指标。
-- 示例:dws_customer_trade_agg_by_city_di
SELECT
  city, dt,
  first_order_cnt,
  first_order_amt,
  customer_uv
FROM dws_customer_trade_agg_by_city_di;
(2)判断是否可复用
若发现已有表基本满足需求,AI推荐扩展而非重建:
“检测到
dws_customer_trade_agg_by_city_di
已包含新客订单数据,建议在其基础上按周聚合并关联城市等级,无需新建DWD。”
此举大幅减少冗余计算。
3. 聚合逻辑自动推导
对于“按周统计”,AI需处理两个关键问题:
(1)时间格式转换
DATE_FORMAT(date_add('day', 6 - DAYOFWEEK(dt), dt), 'yyyy-MM')
-- 或使用 ISO week: YEAR-WEEK 格式
(2)时间序列补全(防止断档)
若某周无数据,默认补0行:
-- 使用时间维表 left join 补齐
SELECT
  w.year_week,
  c.city,
COALESCE(SUM(t.first_order_amt), 0) AS new_cust_order_amt
FROM dim_date_week w
CROSS JOIN (SELECT DISTINCT city FROM dim_city WHERE region='华东') c
LEFT JOIN dws_customer_trade_agg_by_city_di t
ON t.dt BETWEEN w.week_start AND w.week_end
AND t.city = c.city
WHERE w.dt >= DATE_SUB(CURRENT_DATE, 30)
GROUP BY w.year_week, c.city;
AI可通过模板库或历史模式学习此类“补零”逻辑。
4. ADS建表DDL与SQL生成
DDL示例:
CREATE TABLE ads.ads_new_customer_order_trend_wk (
    year_week STRING COMMENT'年周,格式YYYY-WW',
    region STRING COMMENT'大区',
    city STRING COMMENT'城市',
    city_level STRING COMMENT'城市等级:A/B/C',
    new_cust_order_cnt BIGINT COMMENT'新客订单数',
    new_cust_order_amt DECIMAL(18,2) COMMENT'新客订单总额'
)
PARTITIONED BY (dt STRING)
STORED AS PARQUET
LOCATION '/data/ads/marketing/new_customer_trend_weekly';
INSERT SQL:
INSERT OVERWRITE TABLE ads.ads_new_customer_order_trend_wk PARTITION (dt='${today}')
SELECT
    CONCAT(YEAR(w.week_end), '-', LPAD(WEEKOFYEAR(w.week_end), 2, '0')) AS year_week,
    '华东'AS region,
    c.city,
    cl.level AS city_level,
    COALESCE(SUM(t.first_order_cnt), 0) AS new_cust_order_cnt,
    COALESCE(SUM(t.first_order_amt), 0) AS new_cust_order_amt,
    '${today}'AS dt
FROM dim_date_week w
CROSS JOIN (SELECT DISTINCT city FROM dim_city WHERE region='华东') c
LEFT JOIN dws_customer_trade_agg_by_city_di t
ON t.dt BETWEEN w.week_start AND w.week_end
AND t.city = c.city
LEFT JOIN dim_city_level cl
ON c.city = cl.city
WHERE w.week_end >= DATE_SUB(CURRENT_DATE, 30)
AND w.week_end < CURRENT_DATE
GROUP BY w.week_end, c.city, cl.level;
5. 自动化API接口生成(可选)
除建表外,AI还可生成RESTful API接口代码(Flask/FastAPI):
@app.route("/api/v1/new-customer-trend")
def get_new_customer_trend():
    sql = """
    SELECT year_week, city, city_level, new_cust_order_cnt, new_cust_order_amt
    FROM ads.ads_new_customer_order_trend_wk
    WHERE dt = '${today}'
    ORDER BY year_week DESC
    """
    data = query_hive(sql)
    return jsonify({"code": 0, "data": data})
并通过Swagger自动生成文档。
四、系统集成与交付加速
1. 全链路CI/CD流水线
所有AI生成的内容自动提交至GitLab:
AI生成 → Git Merge Request → Code Review → 自动测试 → Airflow调度注册 → 上线
支持一键发布,平均交付周期缩短至 1.5天以内。
2. 智能缓存与查重机制
建立“ADS模型指纹库”,对新需求进行相似性比对:
若已有相同维度+指标组合 → 直接返回现有表; 若仅差一个维度 → 推荐扩展原表; 避免重复开发率达 78%。
五、真实落地效果:交付速度提升5倍
某电商平台在实施该AI系统后,对比前后6个月数据:
| 5.4x | |||
典型场景:
运营临时提出“618期间高客单用户复购分析”,AI在2小时内完成从需求到API上线; 多个部门提出的“区域销售趋势”需求被归一为统一ADS模型,节省3人日工作量。
六、挑战与优化方向
当前局限:
极端复杂逻辑仍需人工介入
如递归计算、机器学习特征工程,AI准确率约70%。跨源关联推理能力有限
涉及5张以上表JOIN时,性能与可读性下降。动态参数支持不足
如“最近N天”中的N可配置,需额外UI支持。权限与安全审计缺失
需集成行级/列级权限控制(如Apache Ranger)。
优化方向:
引入DSL约束生成空间:定义ADS模板语法,限制AI输出范围; 构建反馈闭环:人工修改后的SQL反哺训练集,持续优化模型; 结合Feature Store:将常用ADS指标注册为共享特征,供算法直接调用; 支持低代码前端联动:AI生成结果同步至BI工具(如Superset)自动建图。
七、结语:ADS层的革命,是数据生产力的跃迁
智能ODS:让源头数据干净、标准、可追溯; 自动DWD:将自然语言需求转化为规范明细模型; 智能DWS:实现聚合逻辑的推荐与复用; 革命ADS:最终达成“需求→交付”5倍提速。
这不是单一工具的升级,而是一场数据工程范式的根本变革——从“手工作坊”走向“智能制造”。
未来的数据团队,不应再是“SQL搬运工”,而是“数据产品设计师”。AI处理模式,人类专注创造。
当每一项数据需求都能在一天内交付,数据驱动才真正成为现实。
后续展望:我们将进一步探索AI在数据质量监控、异常检测、自动优化建议等领域的应用,迈向完全自治的数据中台。
本公众号相关内容推荐
面试内容推荐