



导读
之前有写过一些慢SQL导致备份失败(FLUSH /*!40101 LOCAL */ TABLES;)的分析方法, 但时不时就遇到个这种事情也是比较恶心的, 故写个脚本来一劳永逸.
flush table会等待
lock_wait_timeout秒的其它SQL执行. 超时就备份失败.
需求分析
我们的需求是: 备份成功 ==> 1. 如果备份失败, 就要找到失败的SQL. 2.得出哪段时间适合备份.
-
使用什么语言:
shell也可以, 但为了更多的支持和兼容性,我们就选择python3了. -
支持范围:
常见mysql版本是5.7和8.0, 这俩格式都是兼容的. 实际环境中,使用log_slow_extra的并不多, 所以就不考虑了.
我们要解析的慢日志可能会定期轮转,也可能会压缩, 所以要支持解析多个文件和常见的压缩格式(gz和.tar.gz). 有的使用者可能只有python2,所以我们的脚本也得支持Python2.
使用者环境通常没得额外的依赖包, 所以就不能使用pandas之类的了, 好在本次需求并不需要额外的包, 也不需要啥复杂的算法. -
接口:
由于是面向运维人员使用的, 故接口应该尽可能的简单, 参数选项尽可能的少. 而默认选项应该是最常用/最方便的场景. 故使用方法如下:
# 自动识别binlog中备份失败的语句,然后找到对应的罪魁祸首
python analyze_slow_log_for_backup.py mysql-slow.log

# 有时候只是想看下某个时间是否适合做备份
python analyze_slow_log_for_backup.py mysql-slow.log --time '2025-10-14 10:26:58'

# 或者想看下哪段时间适合备份
python analyze_slow_log_for_backup.py mysql-slow.log --analyze
一些细节问题就不讨论了, 比如py2的io没得read1, 慢日志中的时间可能不含时区信息.
实现
然后就可以编写代码了, 这一步可以交给AI来做, 但使用不熟练,还是自己写更快一些. 于是代码如下:
#!/usr/bin/env python
# -*- coding: utf-8 -*-
# writen by ddcw @https://github.com/ddcw
# 分析慢日志,寻找导致备份失败的SQL, 计算哪段时间适合备份.

import os
import sys
import argparse
import glob
import gzip
import tarfile
import io
import datetime

# 时区问题, 默认+8
ADDHOURS = datetime.timedelta(hours=8)

def format_datetime(dt):
	return dt.strftime('%Y-%m-%d %H:%M:%S')

def print_error_and_exit(msg,exit_code=1):
	msg += "\n"
	sys.stdout.write(msg)
	sys.exit(exit_code)

def _argparse():
	parser = argparse.ArgumentParser(add_help=False, description='analyze mysql slow log for backup-data')
	parser.add_argument("--help", "-h", "-H",action="store_true",dest="HELP",default=False,help="show help")
	parser.add_argument("-V","-v","--version",action="store_true",dest="VERSION",default=False,help="show version")
	parser.add_argument("--time",dest="BACKUP_TIME",help="backup start-time ('2025-10-14 10:26:58')")
	parser.add_argument("--lock-wait-timeout",dest="LOCK_WAIT_TIMEOUT",default=60,type=int,help="select @@global.lock_wait_timeout, default:60")
	parser.add_argument("--analyze",action="store_true",dest="ANALYZE",help="analyze slow log, and list suitable backup-times")
	parser.add_argument(dest='FILENAME', help='slow log files', nargs='*')
	if parser.parse_args().VERSION:
		print_error_and_exit('v0.1',0)
	if parser.parse_args().HELP or parser.parse_args().FILENAME == []:
		parser.print_help()
		msg = "\nExample:\n\tpython "+sys.argv[0]+" mysql-slow.log\n\tpython "+sys.argv[0]+" mysql-slow.log --time '2025-10-14 10:26:58'\n\tpython "+sys.argv[0]+" mysql-slow.log --analyze\n"
		print_error_and_exit(msg,0)
	return parser.parse_args()


class OPEN_SLOW_LOG(object):
	def __init__(self,filename):
		self.filename = filename
		if filename.endswith('.tar.gz'):
			self.open = self._open_tar_file
		elif filename.endswith('.gz'):
			self.open = self._open_gzip
		else:
			self.open = self._open
	def open(self):
		pass
	def _open(self):
		return [[self.filename,open(self.filename),False]]
	def _open_tar_file(self):
		fl = []
		tf = tarfile.open(self.filename)
		for tfname in tf.getmembers():
			if tfname.isfile():
				#fl.append([tfname,io.TextIOWrapper(tf.extractfile(tfname),encoding='utf-8')])
				fl.append([tfname,tf.extractfile(tfname),True]) # py2的io没得read1,所以就手动decode咯.
		return fl
	def _open_gzip(self):
		#return [[self.filename,io.TextIOWrapper(gzip.open(self.filename),encoding='utf-8')]]
		return [[self.filename,gzip.open(self.filename),True]]

class READ_SLOW_LOG(object):
	def __init__(self,fd,will_decode=False):
		self.fd = fd
		self.will_decode = will_decode
	def _read_one_line(self):
		data = self.fd.readline()
		if data == b'' or data == '':
			return False,''
		else:
			return (True,data.decode()) if self.will_decode else (True,data)
	def __close__(self):
		self.fd.close()
	def read(self,): # generator
		stop_time = ''
		while True:
			status,stop_time = self._read_one_line()
			if not status:
				break
			if stop_time.startswith('# Time: '):
				break
		while True:
			if stop_time == '':
				break
			end_time = stop_time
			rdata = {}
			status,user_info = self._read_one_line()
			status,query_info = self._read_one_line()
			if not status:
				break
			rdata = {'user_info':user_info}
			sql = ''
			while True: # read for sql
				status,data = self._read_one_line()
				if not status:
					stop_time = ''
					break
				if data.startswith('# Time: '):
					stop_time = data
					break
				sql += data
			if sql == '':
				break
			end_time = datetime.datetime.strptime(end_time.split()[-1], "%Y-%m-%dT%H:%M:%S.%fZ") + ADDHOURS if end_time.endswith('Z\n') else datetime.datetime.strptime(end_time.split()[-1], "%Y-%m-%dT%H:%M:%S.%f+08:00")
			exec_time = float(query_info.split()[2])
			start_time = end_time - datetime.timedelta(seconds=exec_time)
			rdata = {
				'start_time':start_time,
				'end_time':end_time,
				'exec_time':exec_time,
				'sql':sql
			}
			yield rdata
		return

def main():
	parser = _argparse()
	filename_list = []
	for x in parser.FILENAME:
		for filename in glob.glob(x):
			if os.path.isfile(filename):
				filename_list.append(filename)
			elif os.path.isdir(filename):
				for n in os.listdir(filename):
					nfilename = os.path.join(filename,n)
					if os.path.isfile(nfilename):
						filename_list.append(nfilename)
			else:
				print('file'+filename+'not exists. [skip it]')
	if len(filename_list) == 0:
		print_error_and_exit(parser.FILENAME+" not exists")
	if parser.ANALYZE: # 查找持续LOCK_WAIT_TIMEOUT时间的时间段(合并之后)
		time_range = [ x for x in range(24*60*60) ]
		for fname in filename_list:
			for filename,f,will_decode in OPEN_SLOW_LOG(fname).open():
				print('analyze filename:'+filename)
				for data in READ_SLOW_LOG(f,will_decode).read():
					start_time = data['start_time']
					dt = start_time.hour*3600 + start_time.minute*60 + start_time.second
					time_range = [ x for x in time_range  if x not in range(dt,dt+int(data['exec_time'])+1) ]
		start = time_range[0]
		count = 1
		for x in time_range:
			if x == start + count: # 连续的时间段
				count += 1
			else: # 不连续
				if count > parser.LOCK_WAIT_TIMEOUT:
					end = start + count - parser.LOCK_WAIT_TIMEOUT
					print(str(start//3600)+':'+str((start%3600)//60)+':'+str(start%60)+' --> '+str(end//3600)+':'+str((end%3600)//60)+':'+str(end%60))
				start = x
				count = 1
	elif parser.BACKUP_TIME is not None: # 查看这个时间点影响备份语句的SQL
		start_time = datetime.datetime.strptime(parser.BACKUP_TIME, "%Y-%m-%d %H:%M:%S")
		end_time = start_time + datetime.timedelta(seconds=parser.LOCK_WAIT_TIMEOUT)
		backup_time = [start_time,end_time]
		for fname in filename_list:
			for filename,f,will_decode in OPEN_SLOW_LOG(fname).open():
				print('read filename:'+filename+'for backtime:'+parser.BACKUP_TIME)
				for data in READ_SLOW_LOG(f,will_decode).read():
					if data['start_time'] < backup_time[0] and data['end_time'] > backup_time[1]:
						print('\nBACKUP_TIME:\t'+format_datetime(backup_time[0])+'-->'+format_datetime(backup_time[1])+'\nSLOW_SQL_TIME:\t'+format_datetime(data['start_time'])+'-->'+format_datetime(data['end_time'])+'\nSLOW_SQL:'+data['sql']+'\n')

	else: # 啥也不加, 就自动识别(先找到\nFLUSH /*!40101 LOCAL */ TABLES;\n)
		backup_time = None
		for fname in filename_list:
			for filename,f,will_decode in OPEN_SLOW_LOG(fname).open():
				print('read filename:',filename)
				for data in READ_SLOW_LOG(f,will_decode).read():
					if data['sql'].endswith('\nFLUSH /*!40101 LOCAL */ TABLES;\n'):
						backup_time = [data['start_time'],data['end_time']]
						continue
					if backup_time is  not None:
						if data['start_time'] < backup_time[0] and data['end_time'] > backup_time[1]:
							print('\nBACKUP_TIME:\t'+format_datetime(backup_time[0])+'-->'+format_datetime(backup_time[1])+'\nSLOW_SQL_TIME:\t'+format_datetime(data['start_time'])+'-->'+format_datetime(data['end_time'])+'\nSLOW_SQL:'+data['sql']+'\n')


if __name__ == '__main__':
	main()
演示
是时候演示了, 我们先随便整个慢sql,然后发起备份, 然后分析慢日志:
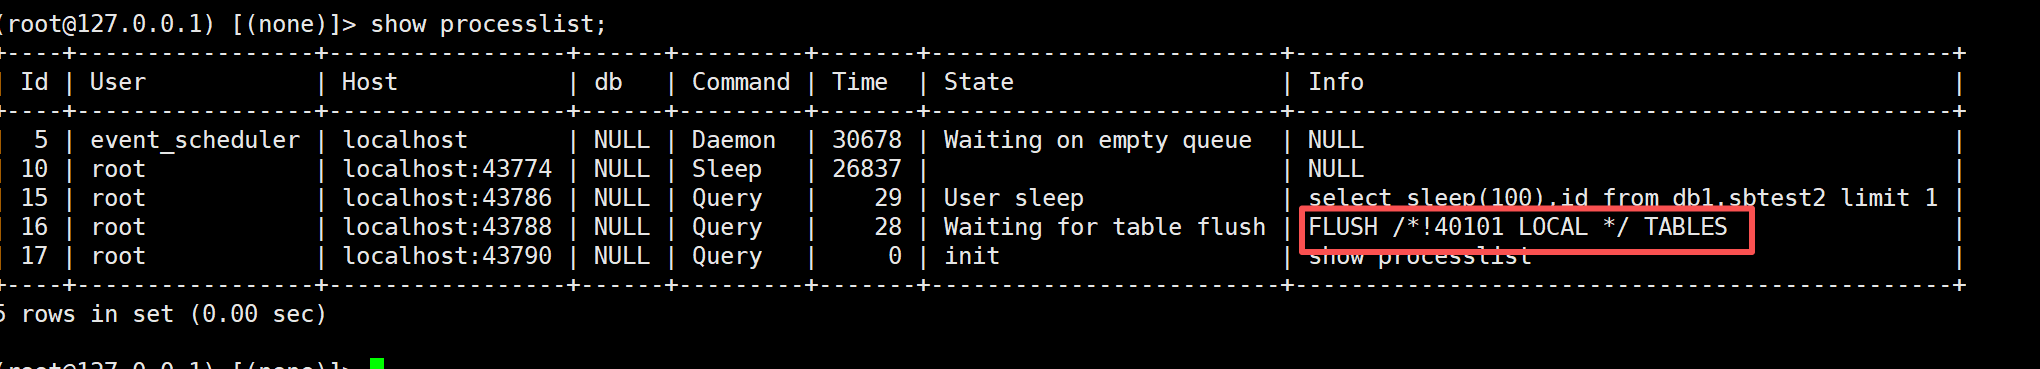
我们啥也不跟, 就是自动分析:
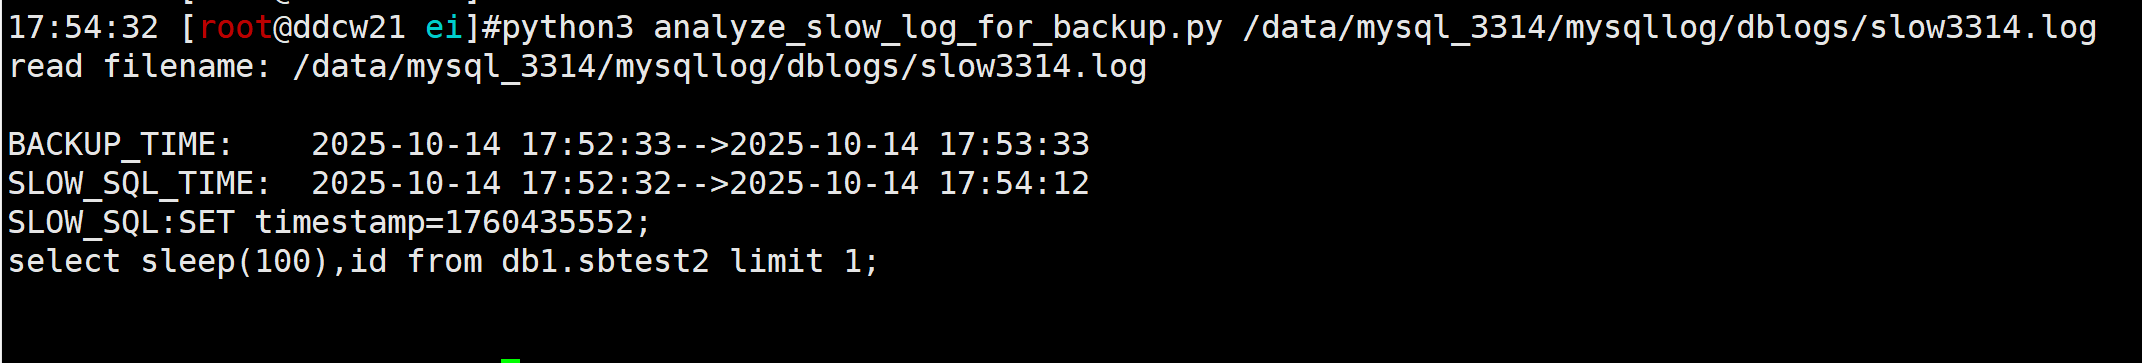
当然我也可以看下’02:00’ 是否适合备份(没有输出,表示那段时间没有相关的慢SQL)

或者让脚本列出所有时间段, 让我们来选:(输出内容表示适合备份的时间段)
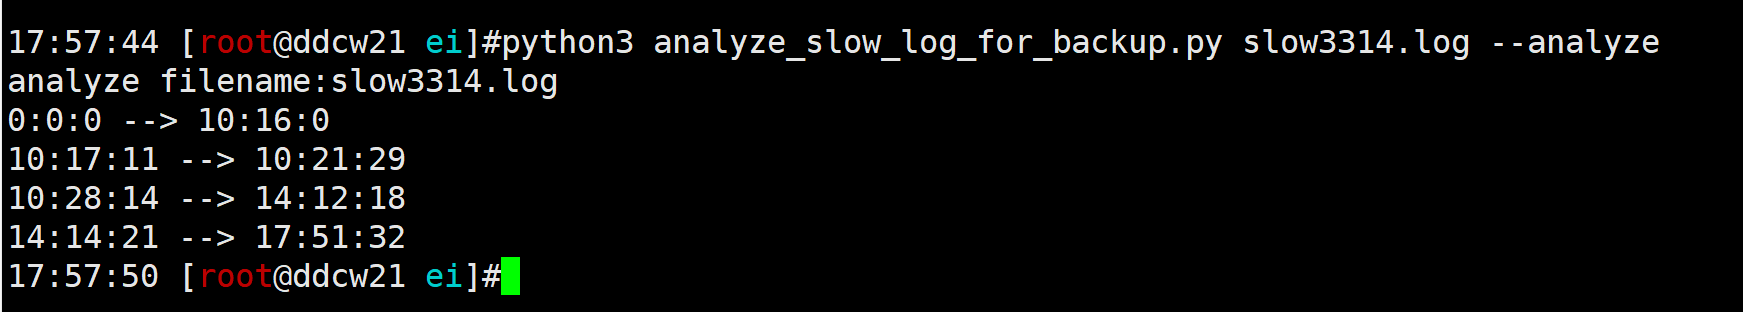
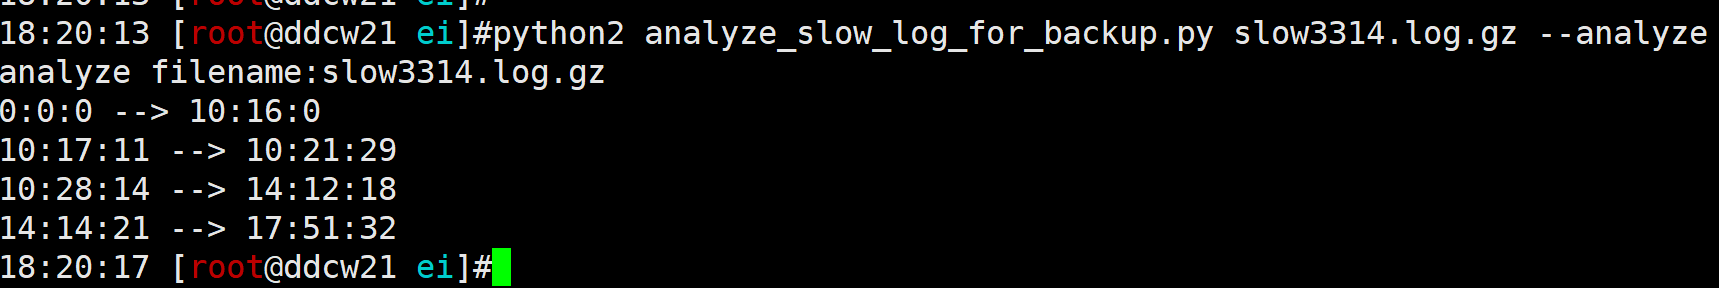
当然python2和压缩文件也是支持的
总结
当然我们还可以将分析的slow log单独存储到某些库中, 方便以后分析.
有些慢sql可能由于Bug不会记录到慢日志中, 此时我们可以编写脚本来监控备份期间的show processlist情况.
脚本下载地址: https://github.com/ddcw/ddcw/blob/master/python/analyze_slow_log_for_backup.py
