PolarDB-X SQL 解析与优化详解
本文将介绍 PolarDB-X 中 SQL 解析和优化的流水线,重点介绍 SQL 语句从原始字符串到可执行计划的处理过程,涵盖解析流程、参数化、优化策略以及计划生成。
SQL处理流水线回顾
PolarDB-X 遵循多阶段流水线来处理 SQL 语句,将原始 SQL 文本转换为优化的执行计划。该流水线主要由Planner
类及其相关组件管理。
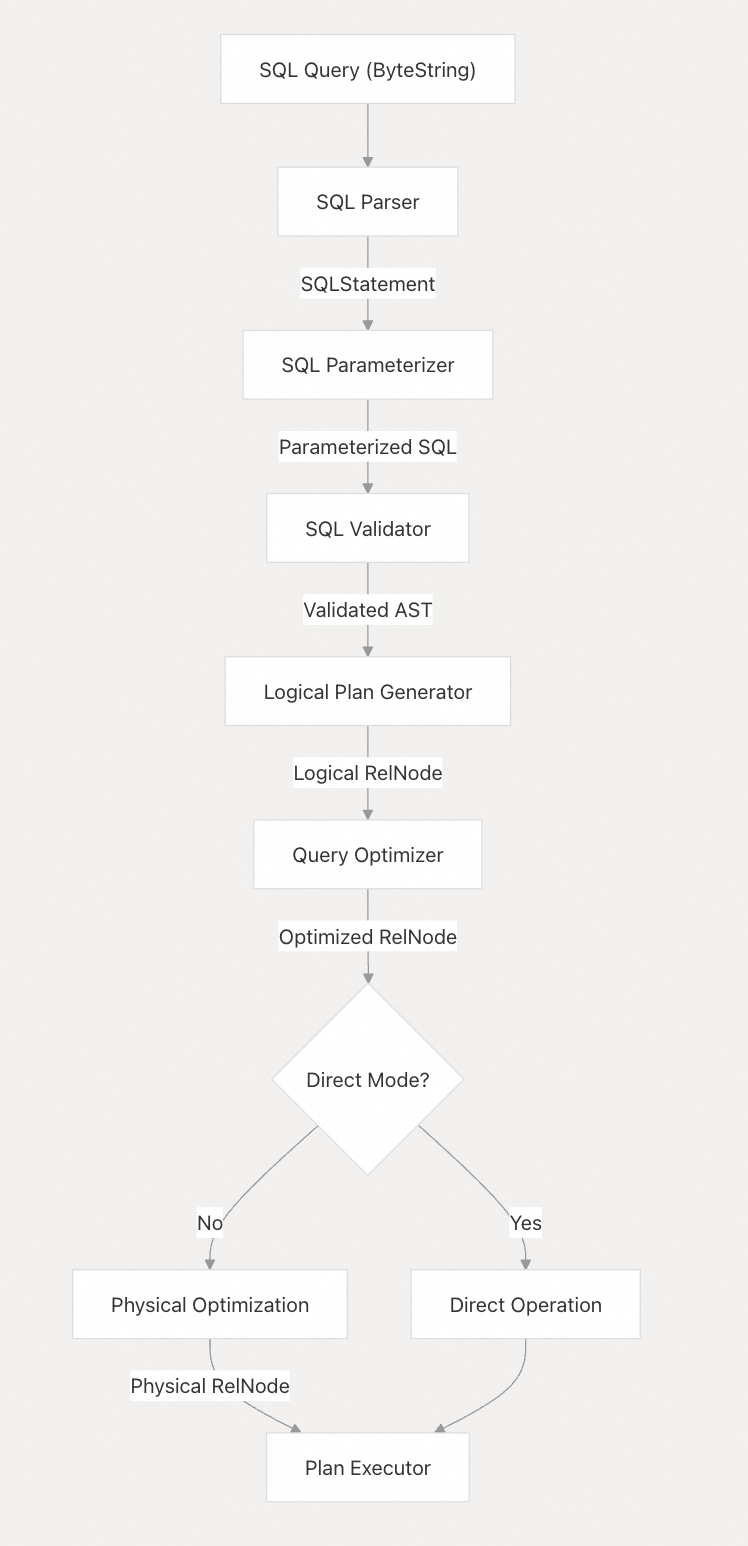
流水线从 SQL 解析开始,到执行计划的生成结束。每个阶段都会转换输入并将其传递到下一个阶段。
SQL解析
SQL 解析是处理管道(流水线)的第一阶段,将原始 SQL 字符串转换为系统可以操作的结构化表示。
解析器架构
PolarDB-X 使用改进版的 Druid SQL 解析器,该解析器专门针对 MySQL 语法进行了定制。将文本转换为抽象语法树 (AST)。

解析器执行以下操作:
标记化:将 SQL 文本分解为词汇标记 语法分析:验证 SQL 语法并构建 AST 语义标记:将语义信息attach到节点
scheam 存储库
Schema Repository 提供元数据访问,以便在解析过程中进行验证。它有助于:
表结构验证 列存在性验证 数据类型检查 约束验证
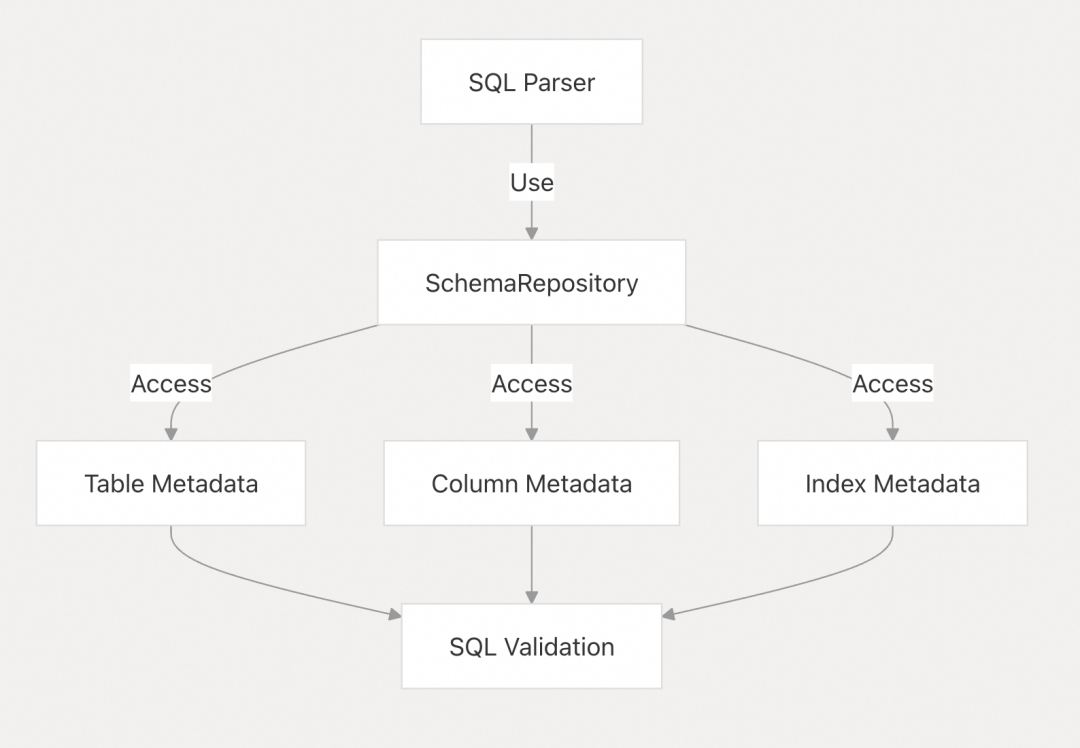
此验证可确保 SQL 语句引用有效的schema对象。
SQL参数化
SQL 语句解析后会进行参数化,即将字面值替换为参数。此过程可以提高计划重用性,并有助于防止 SQL 注入。
参数化过程
参数化由SqlParameterizeUtils
和DrdsParameterizeSqlVisitor
处理,它们遍历 AST 并用参数占位符替换文字。
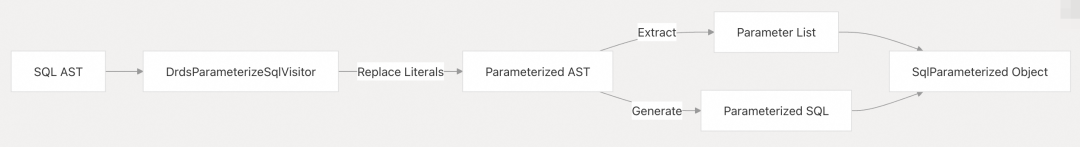
参数化过程:
识别文字值(字符串、数字、日期) 用参数占位符(?)替换它们 收集参数列表中的原始值 生成带占位符的参数化 SQL
参数类型
PolarDB-X 处理几种类型的参数:
'123'456 | ||
@var_name | ||
@@time_zone | ||
? | ||
NOW() |
根据参数的类型,其处理方式也不同,对用户和系统变量有特殊处理。
查询计划和优化
一旦解析和参数化,SQL 语句就会经过规划和优化阶段,从而创建高效的执行计划。
逻辑计划生成
优化的第一步是将 SQL AST 转换为由RelNode
对象表示的逻辑计划:
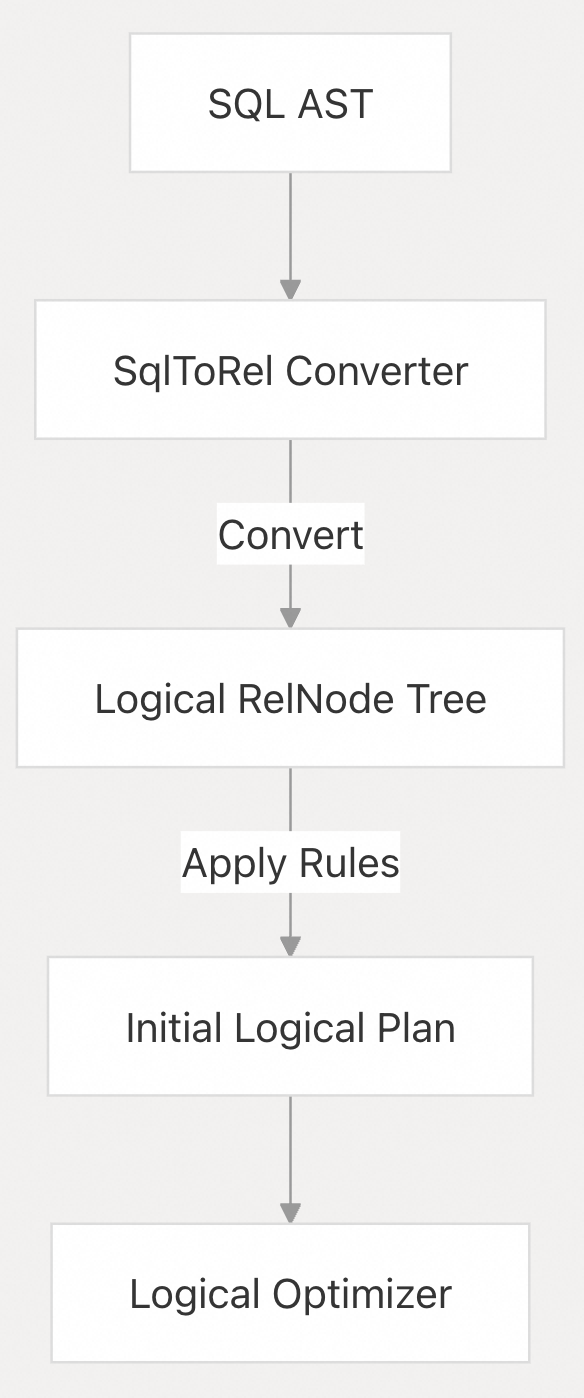
逻辑计划表示执行查询所需的操作,但不指定它们将如何物理实现。
优化阶段
PolarDB-X 采用多阶段优化策略:

基于规则的优化(RBO):应用转换规则来改进计划 基于成本的优化(CBO):使用成本模型评估不同的计划 物理计划转换:将逻辑运算符转换为物理实现
优化规则
PolarDB-X 应用了许多优化规则来转换查询计划:
LogicalJoinToHashJoinRuleJoinConditionPruningRule | ||
PushFilterRuleFilterReorderRule | ||
LogicalAggToHashAggRulePhyTwoPhaseAggRule | ||
SubQueryToSemiJoinRule | ||
PushProjectRuleProjectMergeRule | ||
CBOPushJoinRule |
这些规则在特定阶段应用,规则应用由 HEP(启发式执行计划器)或 Volcano 优化器协调。
特殊优化特性
PolarDB-X 实现了几个特殊的优化特性:
直接模式:适用于可直接在单个数据节点上执行的简单查询 表查找优化:使用索引进行高效的点查找 分布式连接策略:哈希连接、嵌套循环连接、sort merge join 运行时过滤器优化:用于改进查询执行期间的过滤
物理计划生成
优化的最后阶段是生成执行引擎可以运行的物理执行计划。
物理操作符的选择
物理运算符的选择基于:
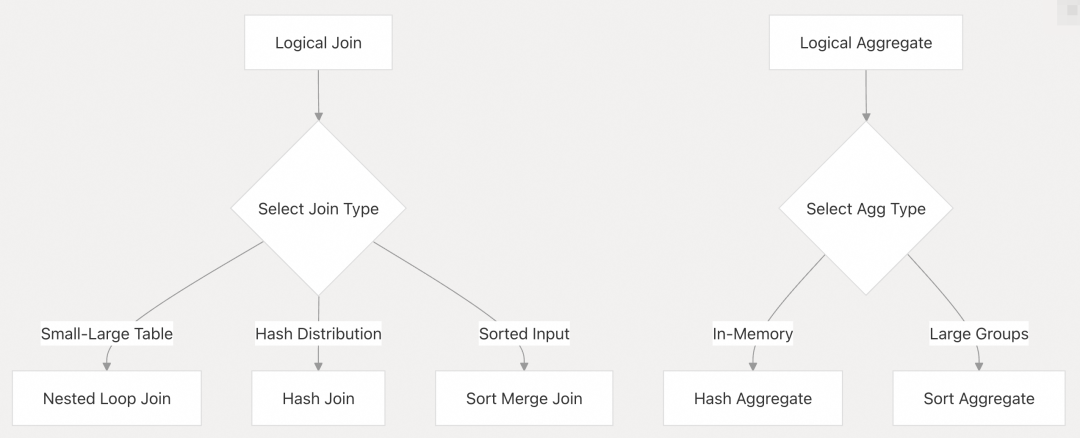
成本估算 可用索引 数据分布 内存限制 JOIN 类型 可用的访问路径
分布式执行的计划转换
对于分布式执行,规划器需要将逻辑运算符转换为其分布式对应项:
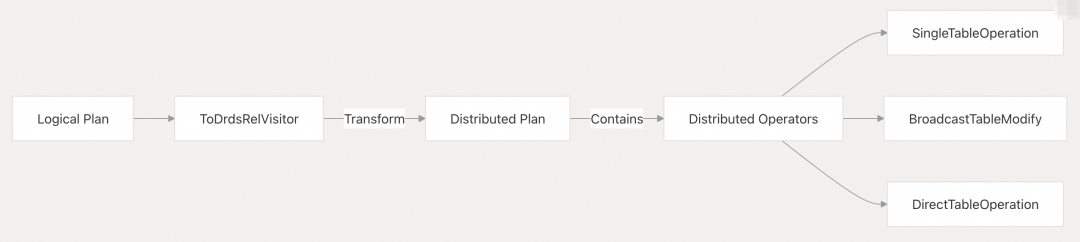
这种转换使得该计划适合跨多个数据节点执行。
执行上下文
解析和优化的所有阶段都在ExecutionContext
提供的以下内容环境中运行:
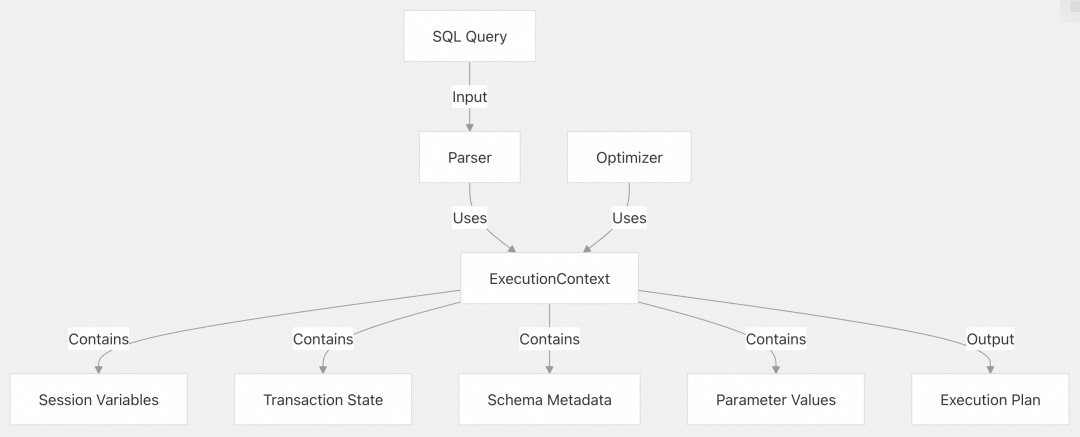
连接串信息 schema 元数据 会话变量 事务状态 特权信息 参数值 HINT
当连接执行 SQL 语句时创建 ExecutionContext
,并在整个SQL处理管道中传递。
计划缓存和重用
PolarDB-X 实现了计划缓存,以便重复使用类似查询的执行计划:
prepared 语句缓存:缓存准备好的语句的计划 参数化计划缓存:根据参数化 SQL 缓存计划 SQL 基线管理:允许修复关键查询的特定计划
计划重用显著提高了具有不同参数值的重复查询的性能。
总结
PolarDB-X 的解析和优化管道通过几个明确定义的阶段将 SQL 文本转换为可执行计划。该过程包括:
SQL 解析为 AST 用于计划重用的 SQL 参数化过程逻辑计划生成 基于规则和基于成本的优化 物理计划生成 执行计划最终确定
这种复杂的管道使 PolarDB-X 能够高效处理复杂的分布式 SQL 查询,同时保持 MySQL 兼容性。
欢迎关注PolarDB公众号.
如需“商务咨询“或”开源交流“, 速加小编微信.