



欢迎关注PolarDB, 期待更多有趣文章. 商务/开源技术咨询可加小编微信沟通.
GraphRAG 在 PostgreSQL 上的实践
直播回放-哔哩哔哩: https://player.bilibili.com/player.html?autoplay=false&bvid=BV1cBG7zeEvf
随着人工智能和数据库技术的发展,如何更高效地利用结构化与非结构化数据进行精准问答成为了一个重要课题。本文基于 PolarDB 研发工程师傅宇(Eric Fu)在IvorySQL 2025生态大会上的分享《GraphRAG 在 PostgreSQL 上的实践》,探讨了GraphRAG 的概念、实现方法及其在PostgreSQL中的应用。
Why Graph RAG?
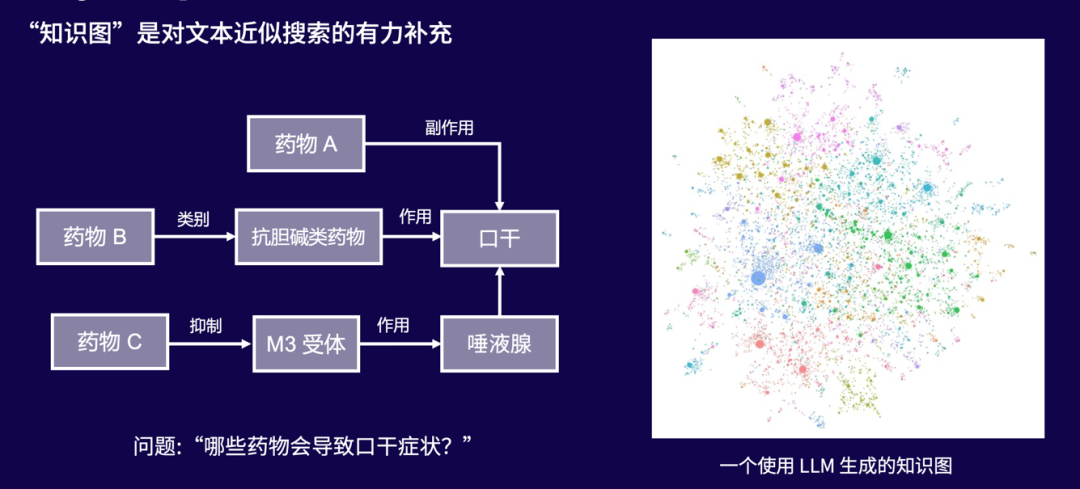
GraphRAG是传统检索增强生成(RAG)模型的一个进化版本,旨在通过结合图数据库的优势来提升特定领域的问答能力。传统的RAG依赖于文本相似度搜索,但这种方法对于需要推理的问题解决能力有限。例如,在回答“哪些药物会导致口干症状?”这样的问题时,简单的文本匹配无法捕捉到药物之间的复杂关系。而GraphRAG通过整合图数据库,能够更好地理解和处理这些关系,从而提供更加准确的答案。
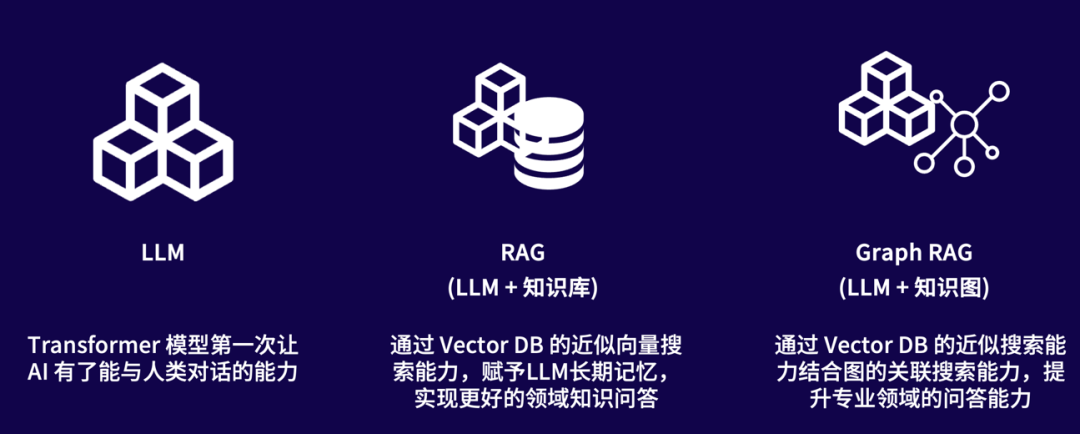
此外,GraphRAG还能弥补RAG中知识表示缺乏结构性描述的不足。例如,对于中药“黄芪”,虽然有许多文献描述其功效和使用场景,但要从中总结出黄芪的主要功效及适用病症,则需要对信息进行结构化处理和总结。GraphRAG可以将这些分散的信息转化为一个结构化的知识图谱,使得查询更为直观有效。
构建知识图
构建知识图的过程主要包括4个步骤:文本分块、图构建以及社群总结。
文本分块
首先,原始文档需要被分割成适合分析的小段落,例如数百 tokens。每个 chunk 应当语义聚焦。如果chunk 太大,则会导致多个实体混在一起,进而导致后续的图谱构建混乱。反过来,如果chunk 太小,描述同一概念的语义不完整、散落在多个 Chunk 中,也会影响图构建的效果。
图构建
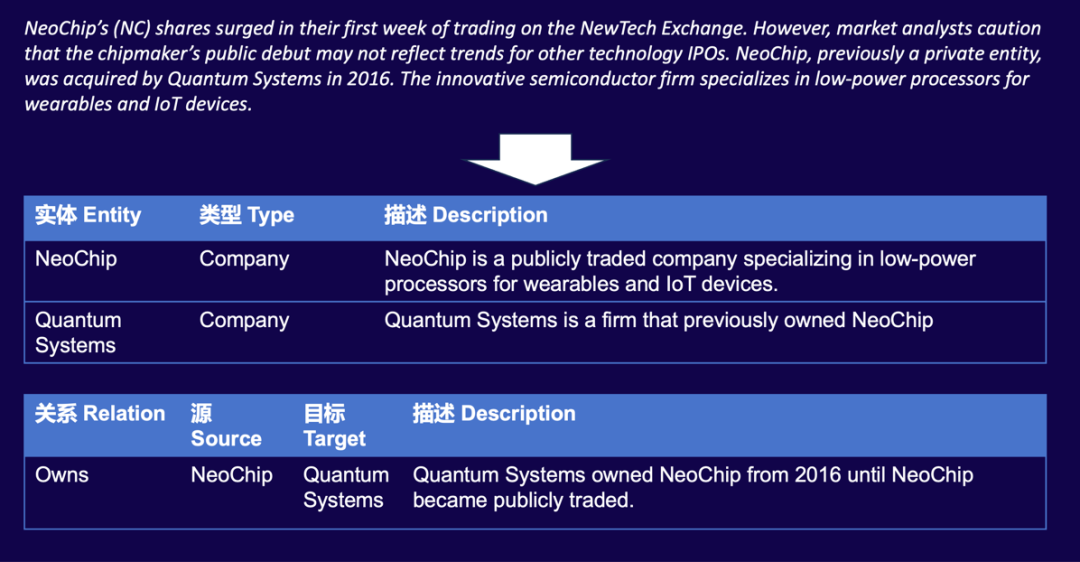
接下来,从这些文本片段中抽取实体和它们之间的关系,并将其组织成图结构。以NeoChip为例,我们可以识别出如NeoChip、Quantum Systems等实体,并建立他们之间的关系,比如Quantum Systems拥有NeoChip。这个过程可以通过大语言模型(LLM)或者自然语言处理算法自动完成。
社群总结
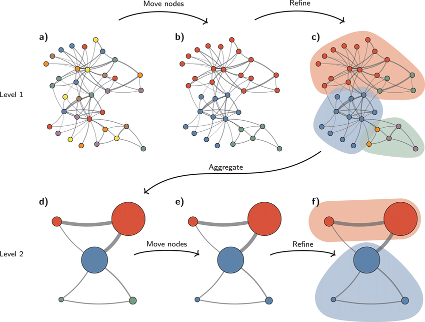
最后,运行社群发现算法识别紧密连接的节点群组,并使用LLM对这些社群进行总结。社群(Community)是图论中的一个概念,是指图上彼此积聚的一批节点,并且满足:同一社群内节点间的联系较多、不同社群间节点间的联系较少。
社群构建的过程是递归进行的:
运行社群发现算法(例如 Leiden)
使用 LLM 总结各个社群,并替换原节点
递归上述步骤直到剩余节点数小于阈值
构建向量索引
最后,将原始文本、图、社群进行 embedding 抽取,写入向量数据库的 3 张表中。这一步的目的是为了让查询时能根据语义找到存在关联的文本信息。
文本块写入 text_embedding 表
Graph 的节点和边,根据之前总结的文字描述信息,写入 description_embedding 表
社群的节点和边,根据之前总结的文字描述信息,写入 description_embedding 表
查询知识图
查询知识图分为局部搜索(Local Search)、全局搜索(Global Search)及动态推理与遍历搜索(Drift Search)三种方式。
局部搜索
局部搜索适用于有明确查询目标的情况,比如询问“PostgreSQL是什么?”或“黄芪有哪些副作用?”。这类问题可以直接定位到相关的实体及其周边信息,快速获得答案。
步骤如下:
找到最近相关节点(基于 embedding 相似度或文本)
然后在其邻近节点子图中进行搜索
全局搜索
全局搜索则针对需要跨社区综合理解的问题,例如“近年来有哪些开源的大规模预训练模型比较活跃?”、“有哪些药物具备抗炎作用?”。此时,系统需要整合来自不同社群的数据,形成全面的回答。
它的步骤比较复杂:
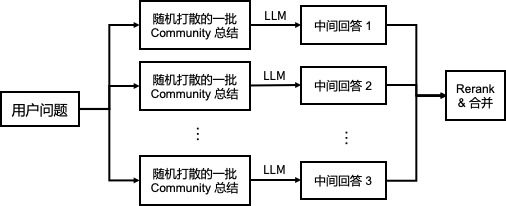
将社群总结随机打散、分成多个预设大小的 Chunk
将这些 Chunk + 用户问题并行输入 LLM 生成中间回答
Rerank 并剔除无用的中间回答
将有用的中间回答输入 LLM 生成最终结果
Drift Search
Drift 全称是 Dynamic Reasoning and Inference with Flexible Traversal,通过动态生成追问问题的方式,逐步深化探索直至获得满意答案。
基于 Top K 接近的社群,调用 LLM 生成初步回答和追问问题
根据重要性排序,使用 Local Search 回答追问问题
用所有中间答案作为上下文,生成最终答案
整个搜索过程就像在社群和图节点构成的树上基于优先级进行遍历。
在 PostgreSQL 上实践
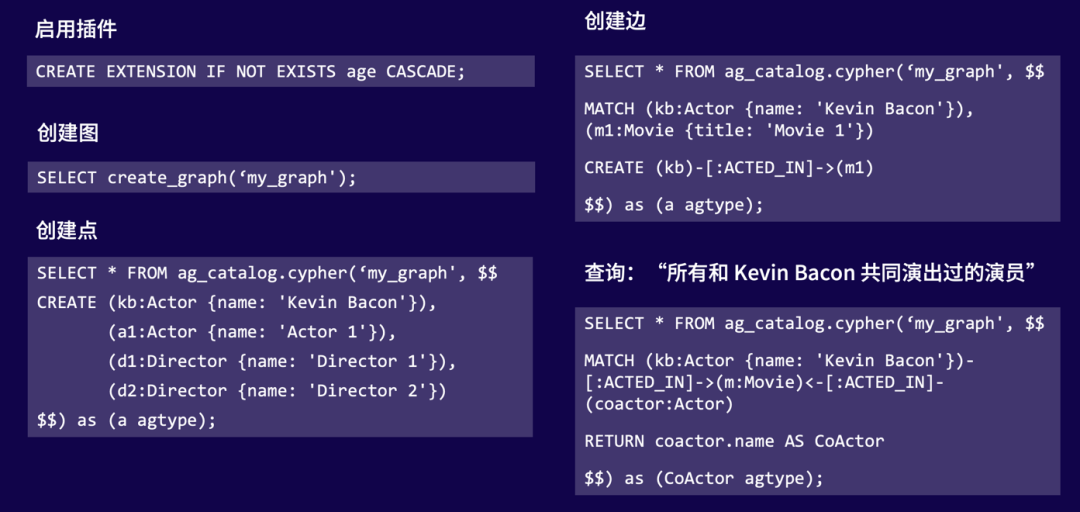
Apache AGE作为PostgreSQL的一个扩展插件,提供了强大的图数据库功能支持。借助AGE,我们可以轻松创建图模型并执行复杂的图查询操作。
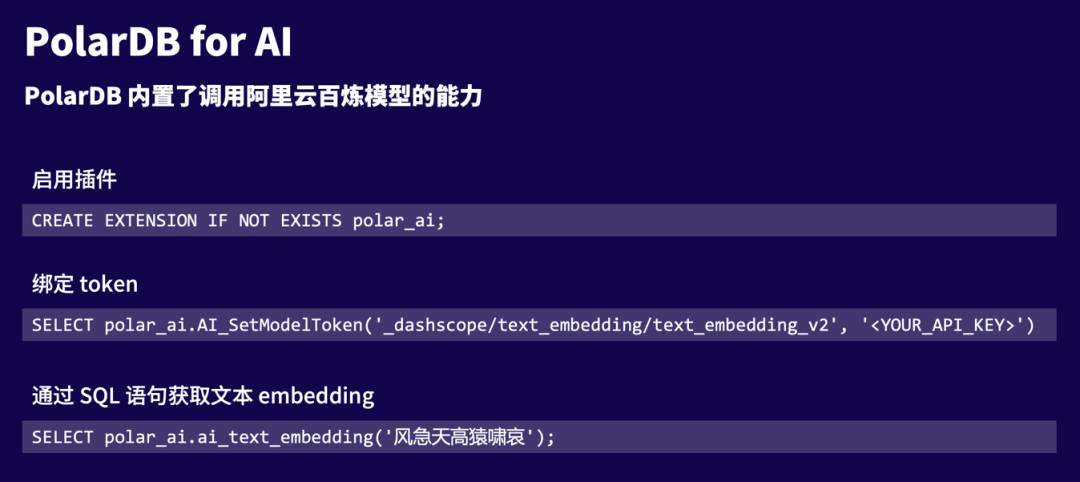
同时,阿里云 PolarDB for AI还允许我们用SQL调用阿里云百炼平台的模型能力,实现诸如文本 embedding、重排序等功能,极大地丰富了PostgreSQL在AI领域的应用场景。
总结
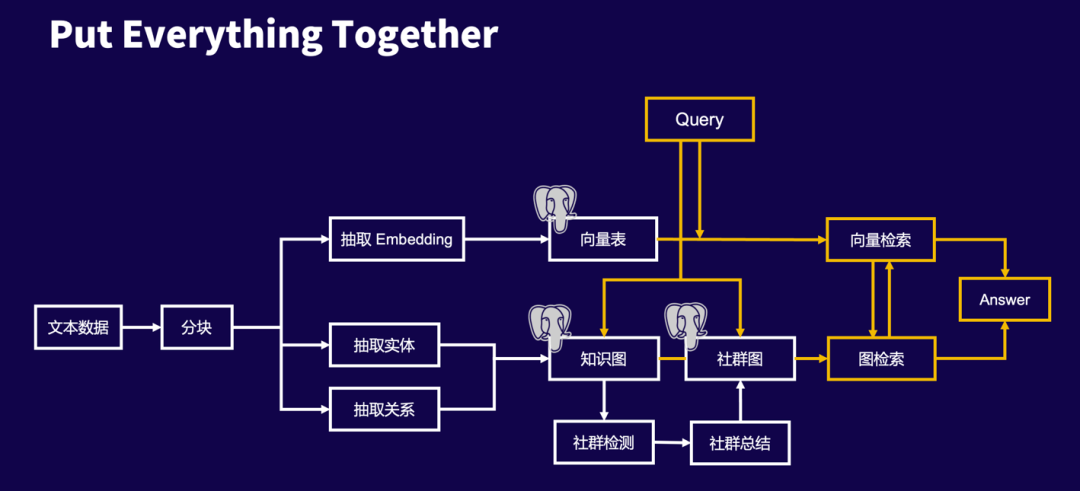
其中,黄色部分是 GraphRAG 相比普通 RAG 新增的部分。
参考资料
RAG vs. GraphRAG: A Systematic Evaluation and Key Insights: https://arxiv.org/abs/2502.11371
From Local to Global: A GraphRAG Approach to Query-Focused Summarization: https://arxiv.org/abs/2404.16130
微软 Graph RAG 项目: https://microsoft.github.io/graphrag/
PolarDB for PostgreSQL 文档 - PolarDB for AI : https://help.aliyun.com/zh/polardb/polardb-for-postgresql/ai-capability/
百炼大模型 API 参考: https://help.aliyun.com/zh/model-studio/model-api-reference/
Apache AGE: https://age.apache.org/
