

暂无图片
暂无图片
暂无图片
暂无图片
暂无图片

从 0 到 1 实现:AI 版你画我猜小游戏

vivo互联网技术 2025-11-06
299

作者: vivo 互联网前端团队- Wei Xing


目录

01. 引  言

02. 你画我猜AI版-玩法简介

03. 训练模型

04. 集成至页面

05. 优化措施

06. 总  结

07. 参  考

全民AI时代,前端er该如何蹭上这波热度?本文将一步步带大家了解前端应该如何结合端侧AI模型,实现一个AI版你画我猜小游戏。


1分钟看图掌握核心观点👇
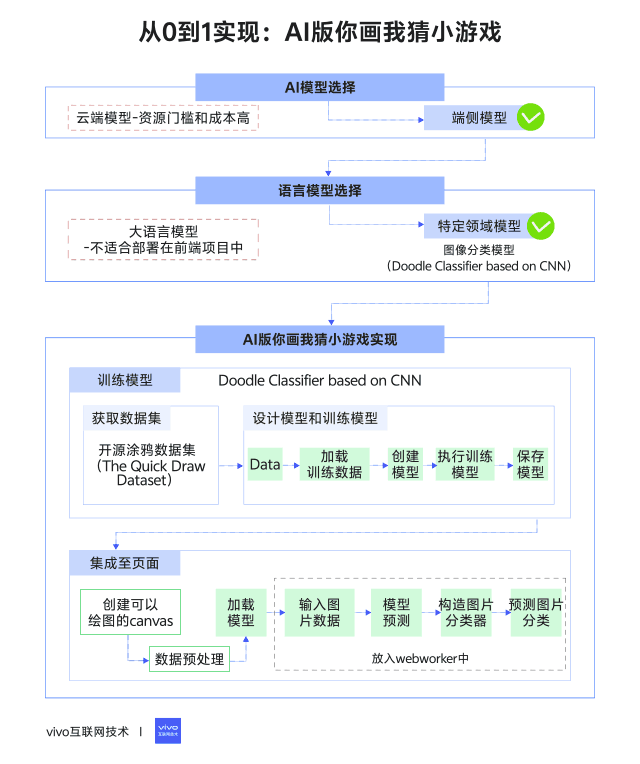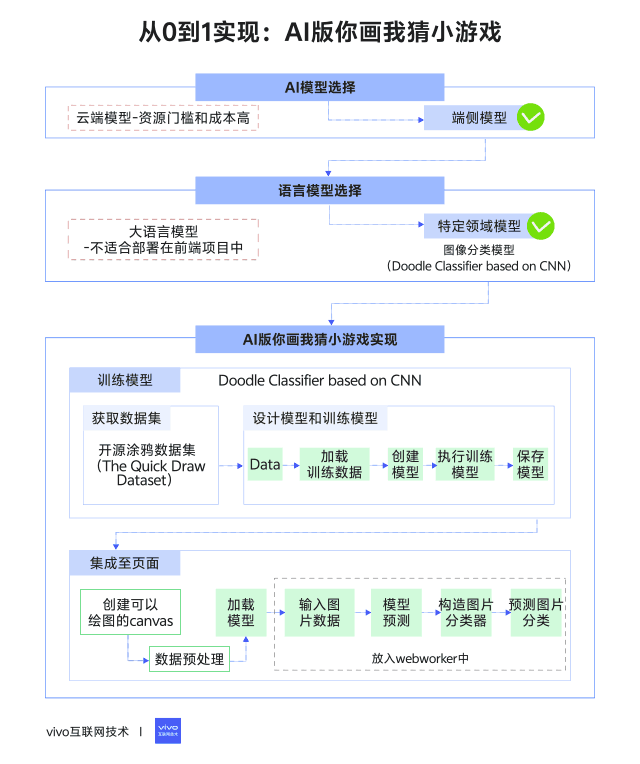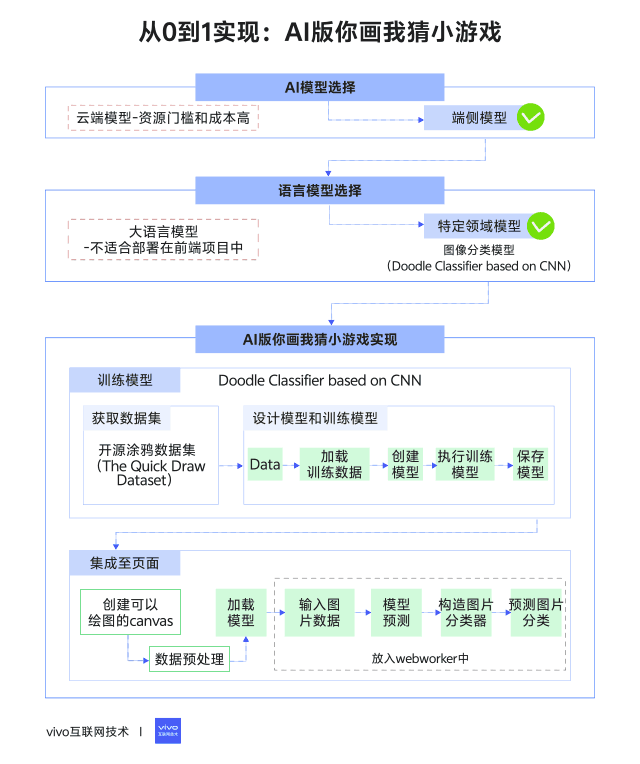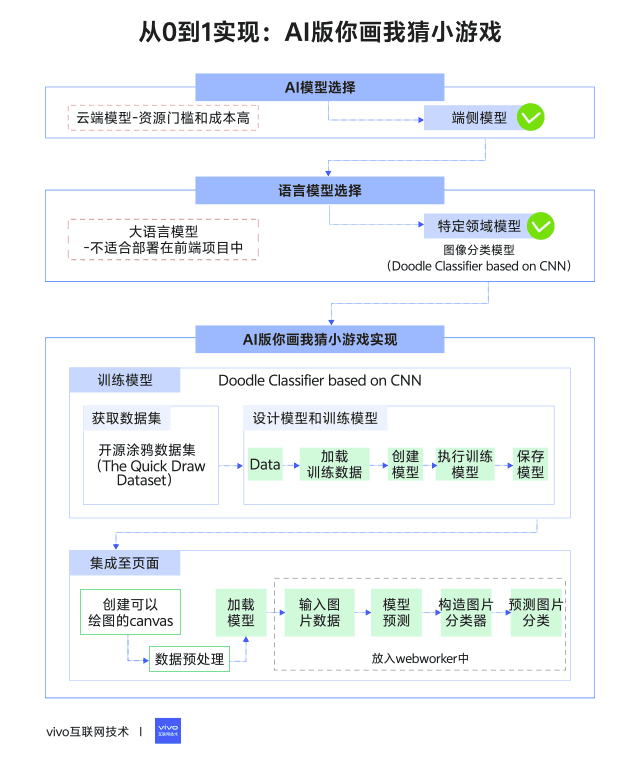

本文提供配套演示代码,可下载体验:

Github | vivo-ai-quickdraw


01

引  言


近几年AI的进化速度堪比科幻片——昨天还在调教ChatGPT写诗,今天Sora已经能生成电影级画面了。技术圈仿佛被AI“腌入味”了,说不定连这篇文章都是DeepSeek帮忙写的(狗头)。


前端er的野望:当其他行业忙着用AI造火箭时,我们这群和浏览器“斗智斗勇”的手艺人,该怎么蹭上这波热度?


在深入思考如何蹭上热度之前,首先,我们需要先简单了解下AI模型的分类。


1.1

云端模型和端侧模型


从模型的部署方式上来看,AI模型可以简单分为云端模型(Cloud Model)和端侧模型(On-Device Model)两种。


  • 云端模型:将模型部署在服务集群上,提供一些API能力供端侧来调用,端侧无需处理计算部分,只需调用API获取计算结果即可。比如OpenAI的官方API就是如此。


  • 端侧模型:直接将模型部署在终端设备上,模型的计算、推理完全依赖终端设备,具有更高的实时性、私密性、安全性,但同时对终端设备等硬件要求也较高。


对于前端来说,由于其非常依赖浏览器和终端设备性能,所以原本最适合前端的方式其实是直接调用云端模型API,把计算的负担转嫁给服务集群,页面只需负责展示结果即可。但通常情况下,搭建集群、训练模型、定制API有很高的资源门槛和成本,现实条件往往不允许我们这样做。


因此,我们可以转而考虑利用端侧模型来赋能。


1.2

大语言模型和特定领域模型


端侧模型从概念上来区分,又可以简单分为大语言模型和特定领域模型。


大语言模型

其中大语言模型(Large Language Model,LLM)就是我们熟知的ChatGPT、DeepSeek、Grok这类模型,它们功能强大,但对设备的性能要求很高,以DeepSeek为例,即使是最小的1.5B版本模型,也至少需要RTX 3060+级别的显卡才能带得动,并且模型本身的大小已经达到1.1GB,并不适合部署在前端项目中。

模型版本

参数量

模型大小

显存

GPU

R1 1.5B

15亿

1.1 GB

4–5 GB

RTX 3060 12GB


特定领域模型

所以,最终留给我们的选项就是利用一些特定领域模型来赋能前端,它们可以用来处理某些特定领域的问题。例如,利用视觉(CNN、MobileNet)模型实现图像分类、人脸检测,或者利用自然语言模型(NLP)实现问答机器人、文本恶意检测等。


这些模型等特征是尺寸较小,并且对设备性能要求不高,非常适合直接部署在前端并实现一些AI交互。


所以,接下来我们就来看看,如何从0到1训练一个图像分类模型(Doodle Classifier based on CNN),并将模型集成至前端页面,实现一个经典你画我猜小游戏-端侧AI版。


02

你画我猜AI版-玩法简介


动手实践之前,先来简单介绍下你画我猜AI版的玩法,它和普通版本你画我猜的区别在于:玩家根据提示词进行涂鸦,由AI来预测玩家画的词是什么,如果AI顺利猜对玩家画的词,则玩家得分。
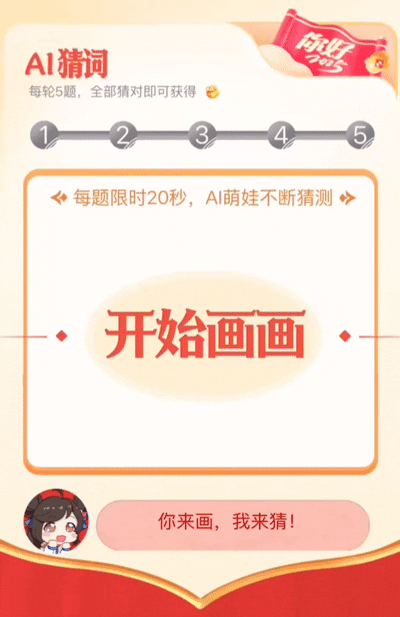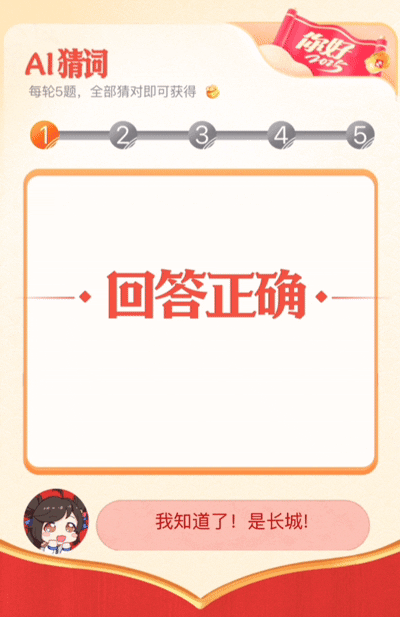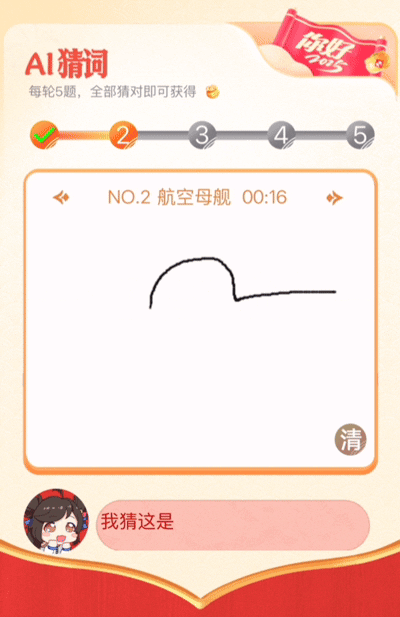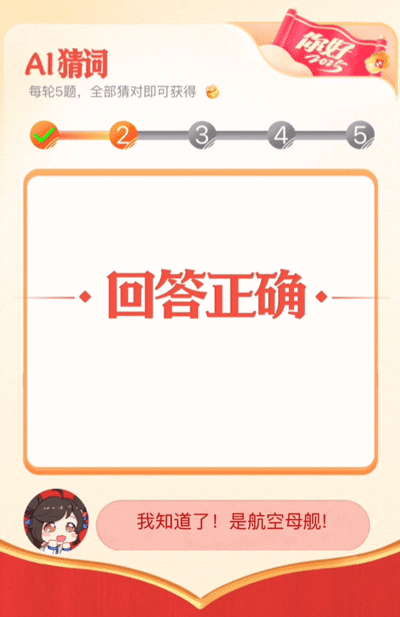


例如,提示词是“长城”,则玩家需要通过画板手绘一个长城,尽量画的像一些,让AI猜出正确答案就能得分。


了解了基础玩法之后,接下来正片开始,详细介绍如何从零到一开始实现它。


我们提供了简化版的 live demo,你可以访问链接试试看。同时我们也提供了相关的 demo代码,你可以随时访问github仓库,下载和尝试运行它。


03

训练模型


首先,第一步是训练模型。


根据上面的玩法简介,我们知道它本质上是一个基于视觉的图片分类AI模型,而这个模型的功能是:输入图片数据后,模型可以计算出图片的分类置信结果。例如,输入一张小猫的图片,模型的分类计算结果可能为:[猫 90%,狗8%,猪2%],表示模型认为这张图有90%的概率是只猫,8%的概率是条狗,2%概率是只猪。


这样一来,我们通过将用户手绘的canvas中的图片数据丢给模型,并把模型输出的置信概率最大的分类当作AI的猜测结果,就可以模拟出AI猜词的互动了。


而实现这个模型也很简单,但我们需要了解一些深度学习神经网络的知识以及tensorflow.js的基础用法。如果对这两者不太熟悉,可能需要先自行google一下,做点知识储备。


那么假设大家已经有了一些基础的神经网络、TensorFlow.js基础知识,就可以利用TensorFlow.js轻松搭建一个基于CNN的图片分类模型。


3.1

获取数据集


在进入模型训练之前,我们需要先获取数据集。


数据集是训练模型的基础,我们可以自己创建数据集(这很困难、费时),或者寻找一些开源数据集。刚好Google Lab提供了一套完整的开源涂鸦数据集(The Quick Draw Dataset),数据集中包含了345个不同类别的涂鸦数据集合,总共有5000万份涂鸦数据,足够我们挑选使用。
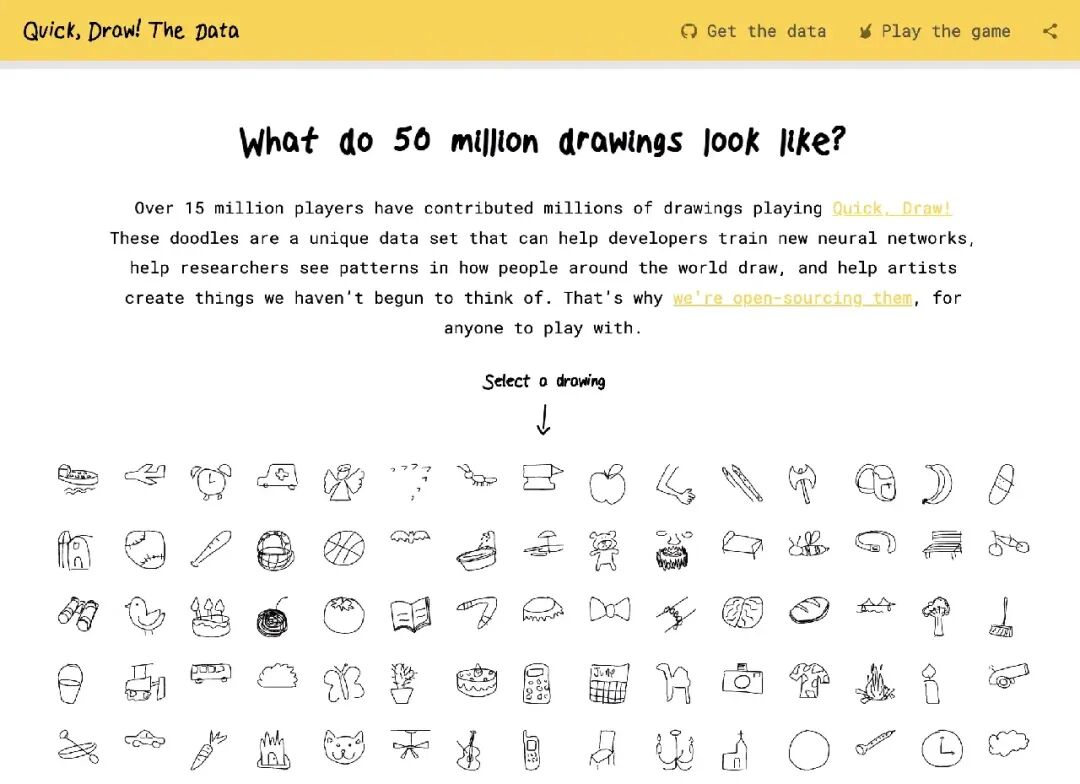


我们可以直接访问开源涂鸦数据集(The Quick Draw Dataset)下载所需的数据。点击页面右上角的Get the Data 跳转github仓库,可以看到文档中列出了多种数据类型:
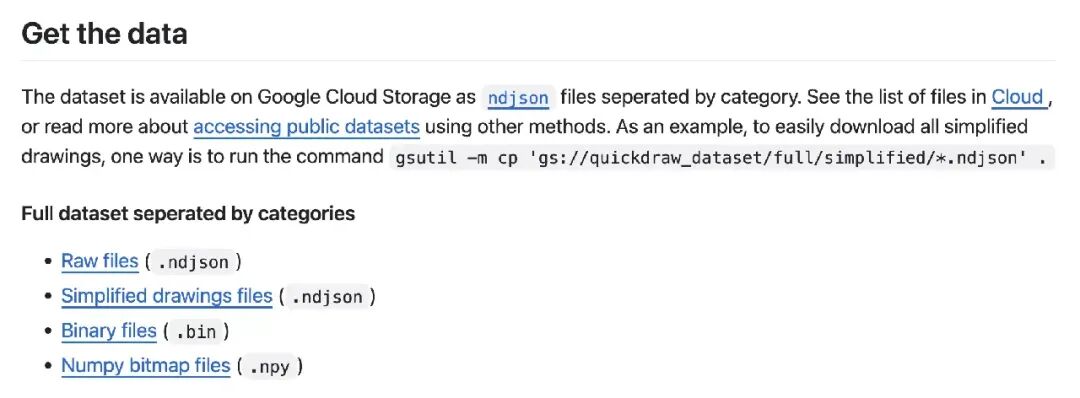


这里我们直接选择下载Numpy bitmap files。
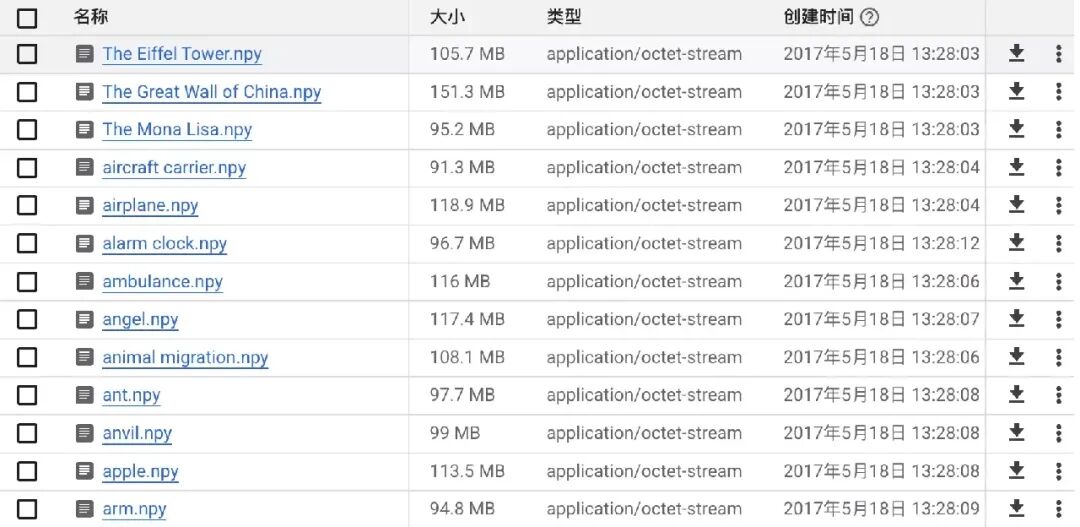


注意:这里的数据集有345种类别,如果全部进行训练的话,训练时间会很长并且最终的模型大小较大,因此,我们可以视情况挑选其中的部分词汇,例如选择80个词汇进行训练,对于一款小游戏来说,词汇量也足够了。


3.2

搭建模型和训练模型


下载完训练数据之后,接下来我们需要搭建模型结构并进行模型训练。


如果我们下载了demo代码,可以看到项目结构如下,主要内容为3个部分:

    项目目录/
    ├── 📁 src/                    
    │   ├── 📄 index.ts            # 程序入口文件
    │   ├── 📁 data/               # 数据集
    │   │   ├── 📄 Apple.npy
    │   │   ├── 📄 The Great Wall.npy  
    │   │   └── 📄 ...       
    │   └── 📁 model/              # 训练模型相关
    │       ├── 📄 doodle-data.model.ts  # 数据加载
    │       └── 📄 classifier.model.ts   # 模型结构
    ├── 📄 package.json


    -data目录:存放训练数据集

    -model目录:

    • doodle-data.model.ts:数据加载预处理

    • classifier.model.ts:定义模型结构

    -index.ts:训练程序入口


    先来看项目的index.ts入口文件,功能非常简单,主要逻辑就是四步:

    • 加载训练数据

    • 创建模型

    • 训练模型

    • 保存模型参数


      import { Classifier } from './model/classifier.model';
      import { DoodleData } from './model/doodle-data.model';


      async function main(){
        const data = new DoodleData({
          directoryData: 'src/data',
          maxImageClass: 20000
        });


        // 1. 加载训练数据
        data.loadData();
        // 2. 创建模型
        const model = new Classifier(data);
        // 3. 训练模型
        await model.train();
        // 4. 保存模型参数
        await model.save();
      }


      main();


      了解了核心流程之后,再来详细看下model目录下的两个核心文件:doodle-data.model.ts和classifier.model.ts。


      首先是doodle-data.model.ts ,它的核心代码如下,主要是加载data目录下的数据,并将数据预处理为tensor张量,后续可于训练模型。

        // 加载data目录下的数据
        loadData() {
          this.classes = fs.readdirSync(this.directoryData)
            .filter((x) => x.endsWith('.npy'))
            .map((x) => x.replace('.npy', ''));
        }


        // 数据生成器,预处理数据为tensor张量
        *dataGenerator() {
          // ...
          for (let j = 0; j < bytes.length; j = j + this.IMAGE_SIZE) {
            const singleImage = bytes.slice(j, j + this.IMAGE_SIZE);
            const image = tf
              .tensor(singleImage)
              .reshape([this.IMAGE_WIDTH, this.IMAGE_HEIGHT, 1])
              .toFloat();
            const xs = image.div(offset);
            const ys = tf.tensor(this.classes.map((x) => (x === label ? 1 : 0)));
            yield { xs, ys };
          }
        }


        其次是,classifier.model.ts。它的核心代码如下,代码的主要功能是:


        构建了一个基于CNN的图像分类模型。通过tf.layers.conv3d()构造了卷积神经网络结构。


        提供了train()方法,用于训练模型。这里定义了模型训练的迭代次数(epochs)、训练的批次大小(batchSize),这些参数会影响模型训练的最终结果,就是通常我们所说的“模型调参”,当你觉得模型训练效果不佳时,可以调整这些参数重新训练,直到达成不错的准确率。


        提供了save()方法,用于保存模型参数。

        (点击查看代码👇)

          import * as tf from "@tensorflow/tfjs-node";
          import { DoodleData } from "./doodle-data.model";


          exportclassClassifier {
            // ...
            // 定义模型结构
            constructor(data: DoodleData) {
              this.data = data;
              this.model = tf.sequential();
              this.model.add(
                tf.layers.conv2d({
                  inputShape: [data.IMAGE_WIDTH, data.IMAGE_HEIGHT, 1],
                  kernelSize: 3,
                  filters: 16,
                  strides: 1,
                  activation: "relu",
                  kernelInitializer: "varianceScaling",
                })
              );
              this.model.add(
                tf.layers.maxPooling2d({
                  poolSize: [2, 2],
                  strides: [2, 2],
                })
              );
              this.model.add(
                tf.layers.conv2d({
                  kernelSize: 3,
                  filters: 32,
                  strides: 1,
                  activation: "relu",
                  kernelInitializer: "varianceScaling",
                })
              );
              this.model.add(
                tf.layers.maxPooling2d({
                  poolSize: [2, 2],
                  strides: [2, 2],
                })
              );
              this.model.add(tf.layers.flatten());
              this.model.add(
                tf.layers.dense({
                  units: this.data.totalClasses,
                  kernelInitializer: "varianceScaling",
                  activation: "softmax",
                })
              );


              const optimizer = tf.train.adam();
              this.model.compile({
                optimizer,
                loss: "categoricalCrossentropy",
                metrics: ["accuracy"],
              });
            }


            // 模型训练
            async train(){
              const trainingData = tf.data
                .generator(() => this.data.dataGenerator("train"))
                .shuffle(this.data.maxImageClass * this.data.totalClasses)
                .batch(64);


              const testData = tf.data
                .generator(() => this.data.dataGenerator("test"))
                .shuffle(this.data.maxImageClass * this.data.totalClasses)
                .batch(64);


              await this.model.fitDataset(trainingData, {
                epochs: 5,
                validationData: testData,
                callbacks: {
                  onEpochEnd: async (epoch, logs) => {
                    this.logger.debug(
                      `Epoch: ${epoch} - acc: ${logs?.acc.toFixed(
                        3
                      )} - loss: ${logs?.loss.toFixed(3)}`
                    );
                  },
                  onBatchBegin: async (epoch, logs) => {
                    console.log("onBatchBegin" + epoch + JSON.stringify(logs));
                  },
                },
              });
            }


            // 保存模型
            async save(){
              fs.mkdirSync("doodle-model", { recursive: true });
              fs.writeFileSync(
                "doodle-model/classes.json",
                JSON.stringify({ classes: this.data.classes })
              );
              await this.model.save("file://./doodle-model");
            }
          }


          如果我们从github仓库下载了demo代码,在根目录下执行:

            npm run start


            开启模型训练过程,会有一些输出如下,表示当前的训练轮次、识别准确率、损失等。

              onBatchBegin0{"batch":0,"size":512}
              onBatchBegin1{"batch":1,"size":512}
              onBatchBegin2{"batch":2,"size":512}
              onBatchBegin3{"batch":3,"size":512}
              onBatchBegin4{"batch":4,"size":192}
              ...
              [Classifier] Epoch: 0 - acc: 0.078 - loss: 2.632
              ...


              耐心等待日志打完,模型训练完成之后,我们的项目目录下就会产出一个额外的目录,存放模型的训练结果。

              • classes.json:图片的所有分类,根据data目录中的数据文件名称生成

              • model.json:模型的描述文件

              • weights.bin:模型的参数文件


                项目目录/
                ├── 📁 doodle-model/           # 训练结果(最终模型)
                │   │   ├── 📄 classes.json    # 图片分类     
                │   │   ├── 📄 model.json      # 模型描述文件
                │   │   └── 📄 weights.bin     # 模型参数


                这样,我们的模型就训练完成了。


                接下来看看如何在页面中集成模型,实现从绘制canvas图片到模型分类预测的效果。


                04

                集成至页面


                在页面中的集成模型也非常简单,我们只需要创建一个可以绘图的canvas,每隔一段时间就将当前canvas的图像数据传输给模型,触发一次模型预测即可。


                先来看下项目的核心目录结构:

                  项目目录/
                  ├── 📁 public/assets/doodle-modle/   # 将训练生成的模型放置在public目录下
                  │   │   ├── 📄 classes.json    # 图片分类     
                  │   │   ├── 📄 model.json      # 模型描述文件
                  │   │   └── 📄 weights.bin     # 模型参数
                  ├── 📁 src   
                  │   ├── 📁 models/               
                  │   │   └── 📄 DoodleClassifier.js  # 图片分类器
                  │   ├── 📁 views/               
                  │   │   └── 📄 DoodleView.vue   # 页面视图(canvas画布)


                  其中,DoodleClassifier.js的核心代码如下:

                  • loadModel:加载模型,包括model.json、classes.json,在model.json中会自动加载weights.bin

                  • predictTopN:输入图片数据,调用model.predict() 预测最有可能的TopN个分类结果,并按照置信度排序


                  (点击查看代码👇)

                    import * as tf from "@tensorflow/tfjs";
                    import apiClient from "@/services/http";


                    // 加载模型
                    async loadModel(){
                      this.model = await tf.loadLayersModel("assets/doodle-model/model.json");
                      const response = await apiClient.get("assets/doodle-model/classes.json");
                      this.classes = response.data.classes; 
                    }


                    // 预测最有可能的TopN个分类,并按照置信度排序
                    async predictTopN(data, n){
                      const predictions = Array.from(await this.model.predict(data).data());


                      const indexedPredictions = predictions.map((probability, index) => ({
                        probability,
                        index,
                      }));


                      indexedPredictions.sort((a, b) => b.probability - a.probability);


                      const topNPredictions = indexedPredictions.slice(0, n);


                      return topNPredictions.map((p) => ({
                        label: this.classes[p.index],
                        accuracy: p.probability,
                      }));
                    }


                    // 预测分类结果
                    async predict(data){
                      const argMax = await this.model.predict(data).argMax(-1).data();
                      returnthis.classes[argMax[0]];
                    }


                    DoodleView.vue的核心代码如下:

                    • 调用new DoodleClassifier()构造图片分类器

                    • 调用loadModel()加载模型

                    • 预处理canvas的图片数据

                    • 将预处理的数据传输给model.predictTopN(),预测图片分类


                    (点击查看代码👇)

                      // 构造图片分类器
                      this.model = new DoodleClassifier()


                      // 加载模型
                      this.model.loadModel()


                      // 预处理canvas图片数据
                      const tensor = tf.browser.fromPixels(imgData, 1);
                      const resized = tf.image
                        .resizeBilinear(tensor, [28, 28])
                        .reshape([1, 28, 28, 1]) // Reshape to [1, 28, 28, 1] for batch and single channel
                        .toFloat();
                      const normalized = tf.scalar(1.0).sub(resized.div(tf.scalar(255.0)));


                      // 预测图片分类
                      this.model.predictTopN(normalized, 5).then((predictions) => {
                        if (predictions) {
                          this.predictions = predictions;
                        }
                      });


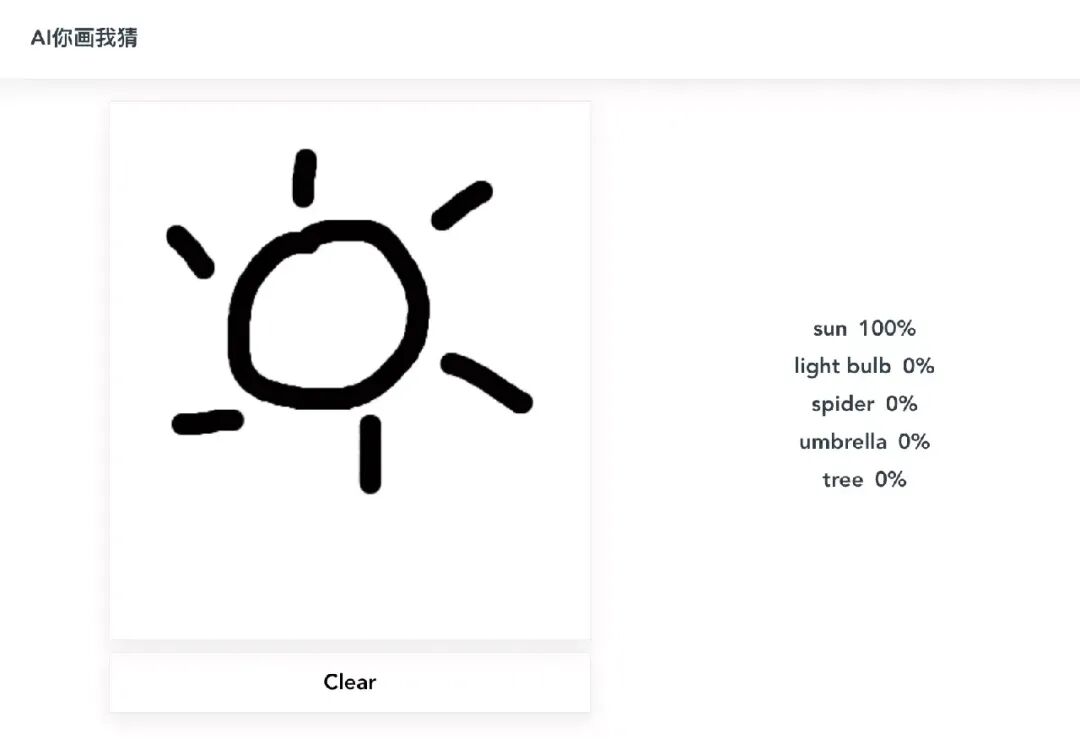
                      到这为止,你画我猜-AI版就已经基本搭建完成了。实现起来并不复杂。


                      如果一切顺利,并且你按照我们提供的demo构建页面,就可以直接在项目中运行:

                        npm run serve


                        一个简易版本的你画我猜AI版就运行成功了,试试看吧。


                        05

                        优化措施


                        通过上面的步骤,我们完成了模型训练和canvas图片分类预测的全流程,成功实现了你画我猜AI版。但实际上可能会遇到两个比较关键的问题。


                        5.1

                        数据标准化


                        当我们去调整canvas画布大小、画笔粗细后,可能会出现预测结果不准确的情况,此时从canvas获取的图像数据和我们喂给模型的训练数据产生了差异。


                        这时候我们需要在获取到canvas数据后,额外做一些数据预处理,将数据标准化,例如:

                        • 将画布的内容区域裁剪为正方形,并居中显示

                        • 将画布的线条适当变粗,使模型更容易识别


                        5.2

                        利用 webworker 优化性能


                        模型的计算过程是十分耗时的,将计算过程放在主线程会导致页面卡顿,因此我们可以将整个模型的预测部分放入webworker中,以此来提升计算性能,不影响页面渲染。


                        06

                        总   结


                        你画我猜-端侧AI版是前端结合AI的一个简单案例,为我们提供了前端利用AI赋能的大致思路和基本实现逻辑。条件允许的情况下,我们可以利云端模型来拓展前端业务。但如果缺乏资源,我们则转而考虑使用端侧的特定领域模型来产出一些新玩法、新交互。相比之下,端侧AI具有更强的灵活性、安全性和更低的集成成本。大家可以试着在各自的业务中探索和使用端侧AI,或许无法产出太大的效益,但也是在全民AI时代下,一些积极的尝试和沉淀。


                        07

                        参   考


                        部分代码参考自:


                        END


                        猜你喜欢


                        文章转载自vivo互联网技术,如果涉嫌侵权,请发送邮件至:contact@modb.pro进行举报,并提供相关证据,一经查实,墨天轮将立刻删除相关内容。

                        评论
