引言:为什么逻辑模型是数据仓库的基石
我们常常看到这样的场景:数据仓库或数据平台建成了,但业务人员抱怨找不到需要的数据,分析师抱怨数据难以理解且口径混乱,开发团队则疲于应对永无止境的“烟囱式”数据开发。问题的根源,往往在于缺失了一个坚实、清晰、面向业务的逻辑模型。
逻辑模型,是连接业务操作与数据技术的桥梁。它不关心数据存储在HDFS还是云上对象存储,也不关心计算引擎是Spark还是Flink。它只关心一件事:如何将纷繁复杂的业务过程,抽象为一套标准、一致、易于理解的数据蓝图。
一、逻辑模型设计全流程概览
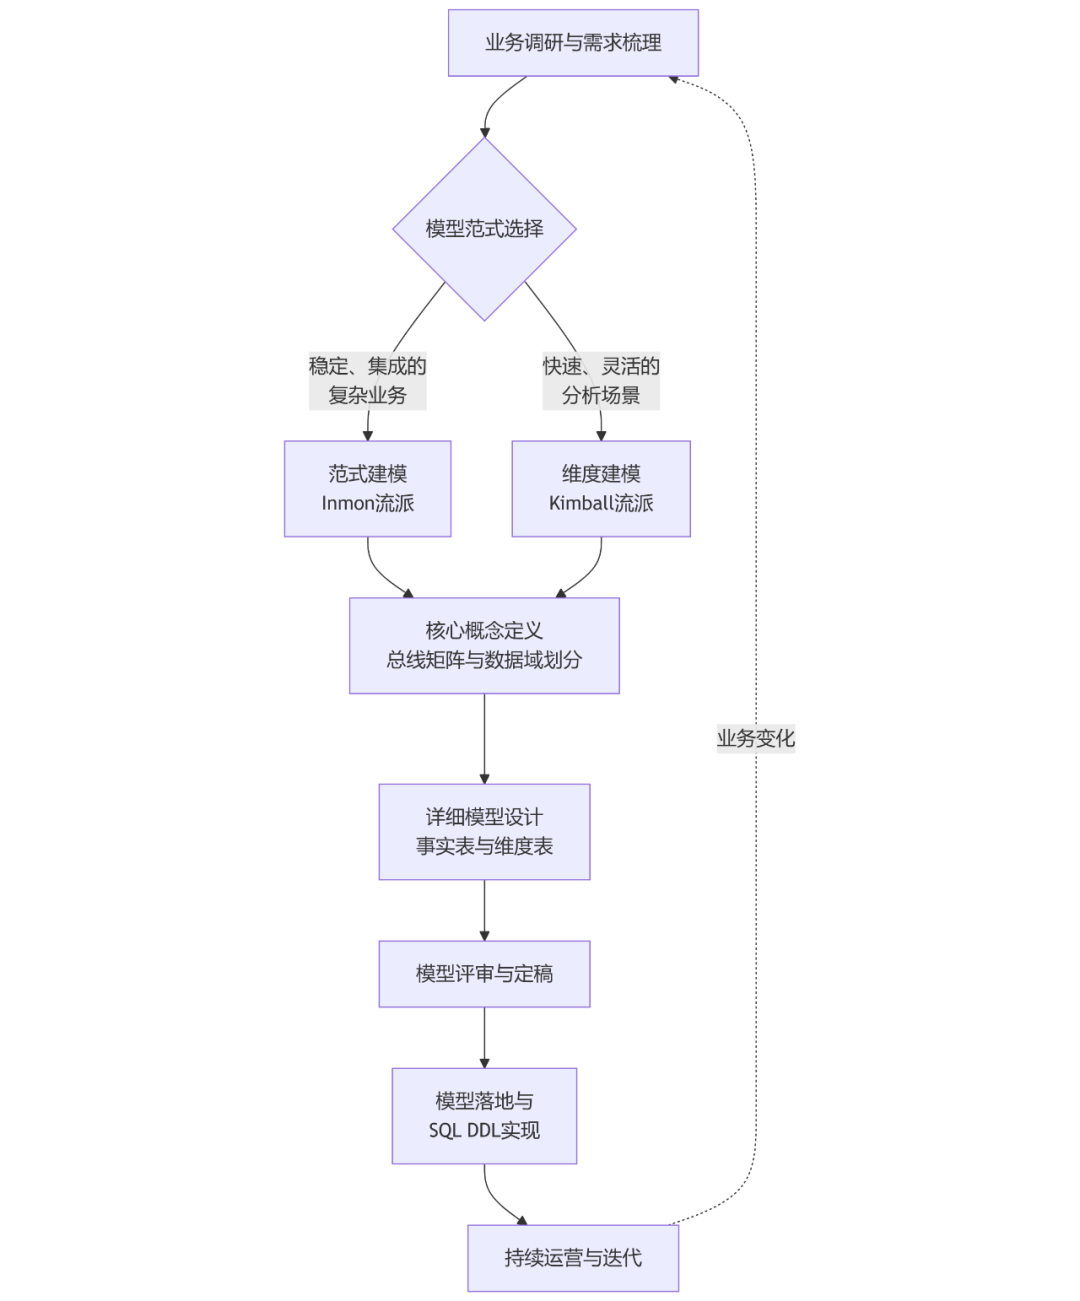
逻辑模型的设计是一个环环相扣、迭代演进的过程。其核心流程如下图所示:
二、第一阶段:深入业务,明确边界
真实体验:小组曾接手一个重构项目,之前的模型因为设计者完全依赖二手业务文档,导致一个关键的“订单状态”字段包含了超过10个无法解释的值。最终我们不得不与业务方进行了长达数周的核对,才理清其真实含义。
1. 业务调研:不只是访谈
与谁聊? 不仅要找业务负责人(明确目标和价值),更要找一线业务操作人员(了解真实流程和例外情况),还要找数据分析师(理解现有的分析需求和痛点)。 聊什么? 业务过程:客户从浏览商品到支付完成,经历了哪些核心环节?(例如:加购、提交订单、支付、发货、确认收货)。 关键指标:业务最关心哪些数字?(例如:每日成交金额GMV、新老客占比、渠道转化率)。 业务规则:什么是“有效订单”?“首单客户”如何定义?这些规则是数据一致性的生命线。 数据源:了解操作型系统(如MySQL中的订单表、日志系统中的点击流数据)的数据结构、更新频率和数据质量。
2. 案例:电商业务梳理
假设我们为一个电商平台设计模型,通过调研,我们识别出以下核心业务过程:
用户注册 商品浏览/搜索 加入购物车 提交订单 支付订单 发货 确认收货 申请售后
具体建议:使用“用户故事”或“用例图”来记录和确认业务过程,确保技术团队和业务团队对流程的理解是一致的。
三、第二阶段:选择建模范式——Inmon还是Kimball?
这是一个经典的抉择。虽然现代数据仓库多有融合,但确立主导思想至关重要。
| 核心思想 | ||
| 模型结构 | ||
| 优点 | ||
| 缺点 | ||
| 适用场景 |
反思与选择:在互联网行业,业务快速迭代,对分析效率要求极高,Kimball的维度建模成为了事实上的标准。因为它对业务人员更友好,SQL查询简单,能快速满足80%的分析需求。下文我们将重点展开维度建模。
四、第三阶段:定义核心概念与架构
1. 构建总线矩阵
总线矩阵是Kimball方法中的核心工具,它明确了业务过程与维度之间的关系。
| 提交订单 | ||||||
| 支付订单 | ||||||
| 发货 | ||||||
| 用户注册 |
真实体验:制作总线矩阵的过程,是暴露业务盲点的绝佳机会。我们曾发现,不同部门对“渠道”的定义完全不同,有的指引流渠道,有的指成交平台。在矩阵设计阶段统一这些一致性维度的定义,是避免未来数据孤岛的关键。
2. 划分数据域
为了管理方便,将业务过程按照功能模块归类。
会员域:用户注册、资料修改等。 交易域:下单、支付、退款等。 商品域:商品上架、信息变更、类目调整等。 日志域:浏览、点击、搜索等行为数据。
五、第四阶段:详细模型设计——事实表与维度表
1. 维度表设计
维度是观察数据的角度。设计目标是:稳定、清晰、内容丰富。
主维表:存储当前最新的、完整的维度信息。例如 dim_user
(用户维度表)。缓慢变化维解决方案:这是维度表设计的核心挑战。 TYPE 1:覆盖。直接更新为最新值,不保留历史。适用于纠正错误数据。 TYPE 2:增加新行。最常用、最重要的方案。当维度属性变化时,插入一条新记录,并分配新的代理键和版本标识。完美记录所有历史状态。 TYPE 3:增加新列。仅保留少量历史版本,例如“当前值”和“上一个值”。
案例:用户U001
改变了所在城市。 TYPE 2处理后的dim_user
表:
具体建议:为所有维度表分配无意义的代理键,而非使用业务系统主键。这能有效隔离源系统变化,并高效处理TYPE 2变化。
顺丰科技二面:什么是代理键,为什么在维度表中它比自然键更受推荐?
2. 事实表设计
事实是业务过程的度量,通常是可加的数字。
事务事实表:最核心、最常用。记录特定业务事件发生时的瞬间状态,数据一旦产生就不再变化。例如 fct_order
(订单事实表)。周期快照事实表:按固定周期(如每天)汇总数据,用于评估定期绩效。例如 fct_daily_sales
(日销售汇总表)。累积快照事实表:用于描述具有明确工作流和生命周期的过程,在流程关键节点更新记录。例如 fct_order_flow
(订单流转事实表),记录从下单到收货的各个时间点。
案例:fct_order
(事务事实表)
案例:fct_order_flow
(累积快照事实表)
具体建议:
事实表的粒度必须明确声明,且是原子级的。 尽量将所有维度外键包含在内,确保分析的灵活性。 可加性事实(如金额、数量)是最佳选择;半可加事实(如余额)需谨慎处理;不可加事实(如比率)应尽量避免,转而存储其分子分母。
六、第五阶段:评审、落地与迭代
1. 模型评审会
召集业务方、分析师、开发工程师进行评审。重点审查:
业务契合度:模型是否能支持已知的分析需求? 易用性:表结构和字段命名对分析师是否友好? 可扩展性:未来业务变化是否容易扩展? 技术可行性:ETL开发复杂度是否在可接受范围?
2. 生成DDL与数据标准
使用SQL DDL将逻辑模型转化为物理模型。
-- 以dim_user为例
CREATE TABLE dim_user (
  user_sk BIGINT COMMENT'用户代理键',
  user_id STRING COMMENT'用户业务ID',
  user_name STRING COMMENT'用户姓名',
  city STRING COMMENT'所在城市',
  start_date STRING COMMENT'记录生效日期',
  end_date STRING COMMENT'记录失效日期',
  is_current INT COMMENT'是否为当前记录 1是 0否',
  dw_create_time TIMESTAMP COMMENT'数据创建时间'
) COMMENT'用户维度表'
PARTITIONED BY (dt STRING COMMENT'日期分区')
STORED AS PARQUET;
具体建议:
建立统一的数仓命名规范,例如表名 dim_/fct_
前缀,字段名小写蛇形。为每个字段和表添加清晰的注释,这是数据资产可管理性的基础。 考虑数据生命周期,在物理设计时引入分区和分桶策略。
3. 持续运营
逻辑模型不是一成不变的。必须建立一套变更管理流程。
小变更:增加一个维度属性,通过评审后直接补充。 大变更:业务过程重构(如新增一个订单状态),可能需要新建事实表或对现有模型进行重大调整。
反思:我们曾因未建立严格的变更流程,导致不同开发人员对同一个业务概念建立了多个不同的事实表,造成了严重的数据重复和口径不一致。后来我们引入了“数据模型Owner”机制,任何对核心模型的修改都必须由Owner组织评审。
结论
数据仓库逻辑模型设计,本质上是一个将业务知识“翻译”为数据语言的过程。它要求设计者既深刻理解业务,又熟练掌握数据建模技术。
一个优秀的逻辑模型,能够:
打通数据孤岛,提供统一的数据视图。 提升数据质量,确保口径一致、准确可信。 降低开发成本,避免重复建设和混乱的烟囱式开发。 加速数据价值兑现,让分析师和业务人员能够自助、高效地获取洞察。
扫码即可加入星球👇全部获取