



一、时代的拐点:当“数据库”成为国家基础设施
在过去的十年里,中国信息技术体系经历了从“应用自建”到“底层自研”的转变。数据库——作为一切数字系统的“地基”——也从一个技术选型问题,变成了国家级战略问题。
当我们在谈“信创(信息技术应用创新)”时,背后的核心诉求其实只有三个字:可控、安全、可持续。而这三点,正是长期依赖国外数据库产品所无法保证的。
在国产化推进过程中,数据库的改造尤为复杂:既要满足业务连续性,又要兼容原有SQL体系;既要运行在国产CPU、操作系统环境中,又要维持高性能、高可靠性。
在这样的背景下,磐维数据库(OLAP)型的研发被正式启动——它的诞生,不是为了追赶谁,而是为了回答一个更根本的问题:
“未来十年的中国数据库,应该长成什么样子?”
二、问题所在:旧有“分析型数据库”框架已无法应对新局面
无论是Greenplum、ClickHouse还是Exadata,这些广为使用的分析型数据库都诞生于十多年前。它们的设计理念集中在“大规模离线分析”上,而当时的数据主要是结构化、批量导入、单一来源。但今天的企业数据早已发生了质变:
- 实时流数据与批量数据并存;
- 非结构化与半结构化数据快速增长;
- 云环境下的弹性伸缩、任务调度成为刚需;
- 数据分析不再是“报表输出”,而是直接驱动决策。
也就是说,传统“分析型数据库”是为过去的世界设计的。它们在架构上追求吞吐量,却忽视了智能性与动态性。而国产化的信创环境,又进一步放大了这种差距——硬件架构不同、系统接口不同、生态配套不同。如果继续沿用原有逻辑,只会在“兼容”中陷入性能和维护的双重困境。
磐维数据库(OLAP)型就是在这种背景下诞生的:
- 它不是简单的“国产替代”,而是一次面向新生态的底层重构尝试。
三、设计初衷:让数据库重新理解“分析”这件事
我们希望数据库能更像一个“系统的思考者”——它不只是执行SQL语句,而是能主动理解任务的目标、数据的特征、资源的状态,从而自动选择最优的执行路径。
磐维数据库(OLAP)型的三个设计原则由此确立:
| 原则 | 含义 | 对应能力 |
|---|---|---|
| 自主决策 | 系统能够根据负载与数据分布动态优化执行 | 智能优化器 |
| 自适应扩展 | 资源变化时能自动均衡节点任务 | 分布式执行架构 MPP++ |
| 自我调优 | 通过历史执行数据不断优化自身行为 | 自调优引擎 |
换句话说,我们希望磐维不仅能“运行查询”,还要“理解查询、学习查询、优化查询”。
四、架构演进:从“分析”到“决策”的转变
传统分析型数据库架构:

这种架构的问题是“固定”——执行路径在查询前已经确定,即使后续资源或数据变化,也无法动态调整。
磐维数据库(OLAP)型采用新的“决策型架构(Decision-Oriented Architecture)”:
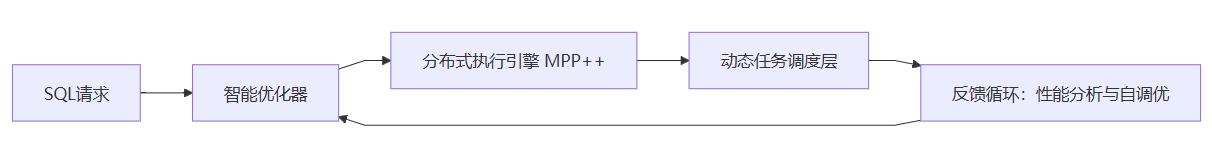
这种设计让系统具备持续学习与自适应能力。每次执行结果都会反馈给优化器,用于更新代价模型;同时,热冷分层机制自动平衡性能与资源成本。数据库不再是“被动响应系统”,而是一个会思考的计算网络。
五、国产化背景下的核心目标:从“能用”到“好用”
磐维数据库(OLAP)型的技术目标可以概括为三个关键词:
- 适配国产生态
- 兼容统信 UOS、麒麟OS
- 运行在飞腾、鲲鹏、兆芯等 CPU 架构上
- 完成信创中间件、云平台接口适配
(均基于公开的信创兼容测试规范)
- 稳定可靠的架构底座
- 支持多副本与分布式高可用
- 提供集群健康检测与自修复机制
- 保证在软硬件替换场景下的平滑迁移
- 可持续优化能力
- 通过PanweiTune持续分析执行日志与性能指标
- 自动推荐索引与统计信息更新策略
- 在长期运行中性能不衰减,反而持续提升
这些设计,使得磐维不仅“能替代”,更能“长期运行、持续优化”。这也是国产化数据库真正的难点所在:不仅要在实验室跑通,更要在生产环境中活下来。
六、磐维的价值:让数据库重新回归理性与可控
在数据库技术几十年的演进中,我们习惯了复杂度不断上升。企业往往需要一整支DBA团队来维护系统的稳定运行。而磐维数据库(OLAP)型想做的,是让数据库“自己会管理自己”。
这种理念的转变,正好契合了当前信创体系的三大目标:
| 信创方向 | 传统数据库挑战 | 磐维的应对思路 |
|---|---|---|
| 安全可信 | 核心代码不可控 | 自研内核、国密加密、全链路审计 |
| 自主可控 | 依赖外部生态 | 国产软硬件全适配、开放API接口 |
| 高效可用 | 运维复杂、学习门槛高 | 智能优化、可视化控制台、自动诊断 |
这些不是概念层口号,而是实实在在的系统能力。在多次信创产品联合测试中,磐维数据库(OLAP)型已完成国产CPU、操作系统、中间件环境的验证,并具备了在政务、金融、能源等领域部署的可行性基础。
七、未来:为智能化时代构建“数据库操作系统”
数据库的演进,正在从“管理数据”转向“理解数据”。AI、流计算、知识检索等新场景,正在要求数据库具备新的能力。
磐维的下一步,将向“AI-native Database”方向演进:
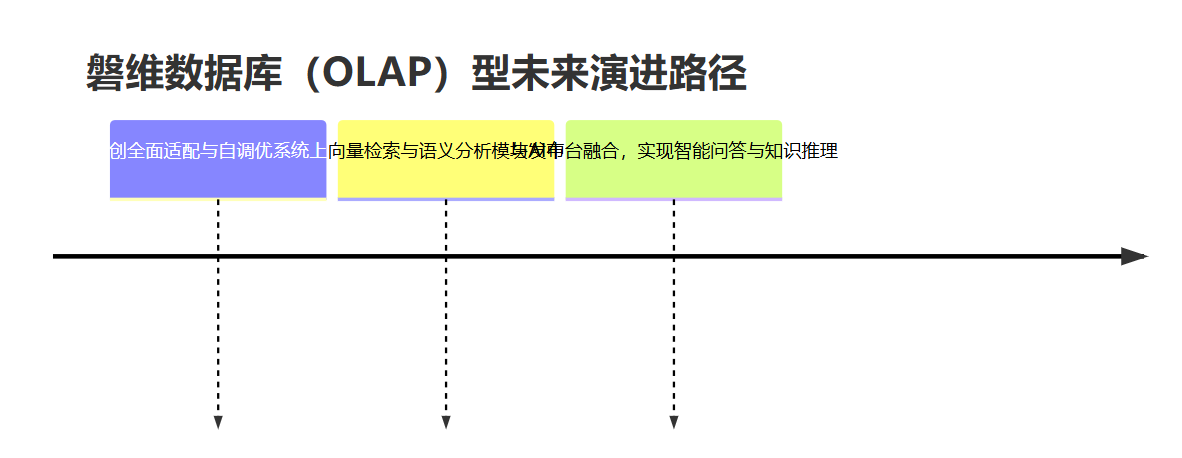
未来的磐维数据库(OLAP)型,将不仅能存储事实数据,还能够理解语义、支持智能决策。那时,数据库不再只是“执行器”,而是一套“数据操作系统”。
八、结语:技术的自立,是长期的耐心工程
磐维数据库(OLAP)型的诞生,不是一场资本驱动的创业故事,而是一场工程师式的长期主义实验。
我们相信,真正的“国产数据库”不应只是兼容、替代,而应该在中国的软硬件生态中、在信创体系中,拥有自己的定义、节奏和逻辑。
让数据库更懂业务!
让系统更懂数据!
让每一次分析都成为一次决策!
这,就是磐维数据库(OLAP)型的起点。也是我们重新定义“分析型数据库”的理由。
