关于非结构化数据的一切
在过去多年里,我们只专注一件事——为AI时代构建真正能用、好用的企业级向量数据库。
这件事的核心难点,从来不是做出一个工具,而是让技术穿透复杂的业务场景,成为企业可信赖的基础设施。
就在近日,这份坚持迎来了重要印记:Milvus在GitHub上正式突破40,000颗Star。与此同时,也是我们立项研发Milvus项目的七周年之际。
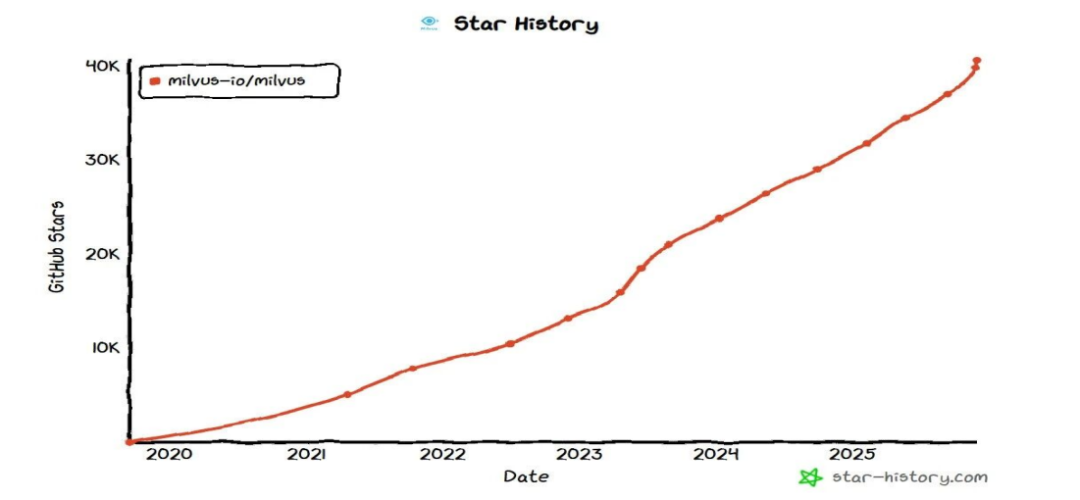
过去,我们形容一段感情或者经历,总是容易谈到一个词——七年之痒。但是站在Milvus立项七周年之际,我们反而相比过去,有了更多的信心,更多的热忱,以及更多的热爱。
因为,无论七年还是4Wstar,这个数字都不是终点,而是行业对向量数据库价值的集体认可的新起点。它印证了Milvus不只是向量数据库领域的开源标杆,更是AI infra赛道中不可或缺的核心组件。
每一颗Star的背后,都是一次代码审阅、一次Issue反馈、一次PR提交的积累。感谢每一位参与Milvus社区建设的开发者,你们的每一份投入,都让这个开源项目更加强大。
01
从0到4万星:Zilliz与Milvus的7年深耕路
很多人知道Milvus,却未必清楚:Zilliz就是Milvus背后的组织,也是这个项目从0到1、从1到4万星的全程操盘手。
2017年Zilliz成立时,那时候,行业还没有向量数据库的概念,我们率先提出了那个关键问题:向量逐渐成为AI时代非结构化数据的通用语义,那么我们究竟要如何高效的管理它?
那时候,放眼四周:传统数据库困于结构化的表格结构,以100%准确性为目标的结构化数据库无法承载语义检索的灵活需求。而在新兴市场,ANN类基础检索算法虽然已经出现,但是距离一个高效、成熟、产业化的产品还有相当距离。
带着这个疑问,Zilliz团队在2018年正式启动开源Milvus研发,走上了这条虽难但对的路。
2019年11月,Milvus0.10版本开源,即便只是初版,也已能实现十亿级图库的毫秒级检索,让行业第一次看到向量数据库的潜力;2020年加入LF AI & Data基金会,我们在全球开源生态中学会了如何构建可持续的技术共同体;2021年Milvus1.0发布并成为基金会顶级项目,同年在BigANN全球亿级向量搜索挑战赛中夺冠,用实力证明了技术路线的正确性。
2022年是关键转折年,Zilliz团队敏锐洞察到企业级需求的核心——分布式架构。Milvus2.0应运而生,以存算分离架构实现动态扩展,成为首个可用于生产环境的开源向量数据库。2023年起,RAG浪潮爆发,Milvus成为语义检索的核心组件,Star数量激增,Zilliz顺势推出全托管云服务Zilliz Cloud,让技术落地门槛大幅降低。
2024年,Milvus入选Forrester向量数据库"领导者象限",Star突破4万星的时刻,我们更加确信:AI基础设施没有弯道超车,Zilliz八年磨一剑的坚守,正是Milvus持续领跑的核心密码。
02
Why Zilliz Cloud?原厂服务不可替代
作为Milvus的原厂,Zilliz始终秉持"开源优先"理念。因为我们清楚,作为一个全新的技术设施产品,它的初始阶段,距离产业级的最高标准,一定是有一定的技术磨合与认知深化的路要走的。
与此同时,我们的服务对象——大模型、电商、搜索、企业知识库等等场景,也都在以一日千里的速度不断狂奔进化。在这个过程中,我们要如何跟上他们的脚步,甚至做到比用户的需求先一步,同样是一个不断动态进化的过程。
开源能够在这样一个基础设施infra同步进化的过程中,最大限度地降低用户的选择成本以及对新兴产品的不信任感。
但与此同时,八年进化,我们也必须承认开源Milvus为行业提供了技术基石,但是它动态的系统架构设计、内核性能优化、能力建设、文档建设,也导致了开发者们必须不断随之迭代认知、技术以及部署升级,这背后每一个细节都需要用户组建一支强大的工程团队去支撑。
那么有什么办法,能够让用户可以0门槛用好我们的向量数据库产品呢?
部分云服务巨头,选择推出各种云服务版本的Milvus,诚然,这解决了部分不愿自建机房,希望弹性使用IDC资源用户的核心诉求。
但是我们也发现:开源产品的本质是人的集合。当企业用户在使用云厂商提供的 Milvus版本时,一旦遇到技术难题或边缘场景的问题,这种问题包括但不限于:Milvus的最佳实践、性能极致调优、不同场景下的配置思路……最后,还是需要找到原厂团队做最后的兜底,反而增加了系统的复杂度,乃至成本。
也是基于这一背景,我们推出了Zilliz Cloud。建立在milvus的基础上,它是一个 无运维、可托管、可观测、企业级 SLA 支持的完整解决方案。您依然可以在各大云服务上,以SaaS的形式使用它,节约您的IDC成本。但是我们能够为您提供原厂级的运维服务以及更专业,更极致的性能。
与此同时,为了更符合商业化用户的深度需求,Zilliz Cloud与开源版本milvus也有一定的能力建设侧重点不同。相较milvus,Zilliz Cloud还具备以下优势:
极致性能与规模:自研AutoIndex技术让查询性能较开源版提升3-5倍,云原生分布式架构可稳定支撑百亿级向量存储和万级并发,远超部分云厂商的优化版本;
企业级安全合规:提供静态与传输加密、细粒度RBAC权限、VPC隔离等全链路安全体系,符合GDPR、HIPAA等国际标准,满足金融、医疗等敏感行业需求;对于必须将数据完全保留在企业自有环境、无法外流的场景(如涉及高度敏感的模型训练数据或关键业务数据),Zilliz 还提供更严苛的 BYOC(Bring Your Own Cloud) 部署模式。在 BYOC 架构下,所有数据、索引与计算资源均运行在客户自有的云账户或私有环境中;Zilliz 仅在客户授权的前提下提供托管式运维与技术支持,在确保业务独立性的同时,提供与云服务一致的可用性与专业性。
成本最优解:冷热数据分层存储、弹性扩缩容结合按量付费模式,使总拥有成本(TCO)降低50%以上,点石科技的实践已充分验证这一优势;
全球云中立部署:覆盖全球五大云25个节点,企业可灵活选择部署环境,避免云厂商绑定风险,支撑全球化业务扩张。
总而言之,我们希望借助Zilliz Cloud,向量数据库可以成为千行百业都能用得起、用得好的核心组件。从金融、制造、医疗,到政务、教育、运营管理,任何场景中非结构化数据的理解和利用,都能借助Zilliz Cloud的能力,立刻挖掘释放。
03
4万星背后的信任:全球万余家企业的共同选择
Milvus能突破4万星,更重要的支撑是商业场景的深度验证。
如今,Zilliz的服务版图已覆盖互联网、科技、汽车、金融等关键领域:博世在智能驾驶领域用Milvus实现数十亿数据毫秒级检索,降低80%数据采集成本;某全球金融巨头依托Milvus搭建覆盖25种货币、百亿级交易的推荐系统;Shopee通过Milvus实现视频召回与版权匹配,提升原创内容识别效率;minimax在内的大模型企业借助Zilliz Cloud实现高效的训练数据管理以及文件去重清洗。
这些头部客户的选择,本质是对Zilliz技术实力的认可。
截至目前,Zilliz已服务超过10000家企业,其中一半以上是上市公司或行业独角兽。更值得关注的是,不少拥有自研向量数据库能力的大厂,仍选择Milvus或Zilliz Cloud作为核心业务支撑,这正是对我们技术价值的最高肯定。
04
不止于向量数据库:Zilliz 的下一站是语义驱动的多模态数据湖
作为向量数据库理念的提出者,Zilliz 一直在思考一个重要趋势:当企业的数据体量突破 TB、PB,甚至迈向万亿级规模,类型从结构化数表扩展到文本、图像、音频、视频、时序、多传感器流等非结构化、多模态数据时,向量数据库是否依然是最合适、性价比最好的选择?
答案是,向量数据库当然可以支撑海量多模态数据场景,但在许多情况下,这样做成本并不经济,也不是架构上最优的选择。
在诸如大模型训练数据、自动驾驶全量感知数据、机器人训练语料等场景中,绝大部分数据是“冷数据”,它们对检索延迟的要求并不严格,也不需要实时高并发访问。如果仍以向量数据库的热路径来承载全部数据,不仅成本高昂,数据治理和上下文管理也会变得复杂低效。
基于这一洞察,我们即将推出 Milvus Lake——一个以语义检索为中心的新型多模态数据湖。它能够从多模态源数据(向量、标签、元信息、LLM 描述、结构化字段)中统一抽取语义内容,并以业务实体为主线构建语义宽表(Semantic Wide Table)。这让企业首次能够以统一方式管理、检索和治理散落在对象存储、湖仓系统与模型输出管道中的海量原始数据,使其成为可查询、可理解、可复用的语义成品数据。
在系统层面,Milvus Lake 基于 manifest + data + index 的三段式设计,让索引成为多模态数据湖的一等公民,实现 “先检索、后处理” 的数据路径。这种方式特别适合万亿级冷数据:其延迟更可控,成本更低,可用性更高。
依托多级存储策略(NVMe/SSD 承载热数据,对象存储归档冷数据)、高效压缩编码与 lazy-load 索引机制,Milvus Lake 在保留语义相关性的同时,使海量数据的管理成本显著下降。
此外,它还能与 Paimon、Iceberg、Hudi、Spark、Ray 等大数据体系无缝协作,让企业在一个平台上完成批处理、近实时处理、检索、特征工程与训练数据构建等任务。
无论是大模型训练集构建、自动驾驶仿真库、机器人学习语料,还是面向生产业务的语义检索和分析,Milvus Lake 都能提供一套兼具扩展性与经济性的语义级湖仓一体基础设施,加速企业迈向全栈 AI 化。
尾声
在AI基础设施领域,能突破4万星的项目寥寥无几。Milvus的成长,离不开社区每一位开发者的贡献,也离不开企业用户的信任与反馈。但我们深知,Milvus仍有优化空间,开源之路没有终点。
未来,Zilliz将继续坚持开源优先,开放路线图、接纳社区反馈,让Milvus的底层技术持续迭代;同时,通过Zilliz Cloud为企业用户提供更可靠的商用服务,让技术价值高效落地。
我们相信,技术的使命不是让系统变得更复杂,而是让企业更容易、更低成本地处理海量数据。正如摩尔定律推动算力普及,Zilliz 也将对索引、存储、编码和语义建模持续打磨,从而让企业无论是万级还是万亿级数据规模,都能轻松管理多模态数据,并让这些数据真正为 AI 应用所复用、共享和放大。
如果你是开发者,欢迎为Milvus提交PR、完善文档、参与技术讨论,让这个开源项目更加强大;如果你是企业用户,建议选择Zilliz Cloud——直接对接原厂技术团队,获得最精准的解决方案,避免第三方版本的隐性成本。
4万星是新起点,Zilliz期待与更多伙伴一起,构建全球最强的向量数据库基础设施,让非结构化数据在AI时代绽放更大价值。
了解更多Zilliz与Milvus的故事,欢迎访问:https://Zilliz.com