



加v:cqhg_bigdata,送你一份基于数据湖的数据中台设计思路.ppt
引言
在数据基础设施的发展历程中,我们见证了从传统关系型数据仓库(例如 Teradata、Oracle Exadata),到以 Hadoop 为基础的数据湖,再到如今备受关注的“湖仓一体”(Lakehouse)架构的变迁。每一次演进,不仅是技术栈的升级换代,也深刻影响着业务价值的重塑与释放。
一、传统架构的困境:数据孤岛与冗余管道
在湖仓一体架构诞生之前,企业中的数据体系往往呈现两种格局:
一边是数据仓库,它承载着企业关键业务的结构化数据分析任务,例如商业智能(BI)分析与固定报表生成。这类系统特别注重事务一致性(ACID)、严格的数据结构(Schema)与查询性能,典型代表如 Snowflake 和 Amazon Redshift。 另一边则是数据湖,它更多地用于处理非结构化或半结构化的数据场景,比如机器学习模型训练、日志文件分析等。数据湖的优势在于能够以较低成本存储海量原始数据,并支持灵活的数据格式与处理方式,常见技术组合如 Amazon S3 配合 Apache Spark 进行分析处理。
这种分离带来了三大核心痛点:
数据冗余:同一份原始数据需分别 ETL 到仓库和湖中,造成存储与计算资源浪费。 一致性缺失:仓库中的聚合表与湖中的原始数据版本不一致,导致分析结果冲突。 运维复杂:两套系统意味着两套元数据管理、权限控制、监控告警体系。
以某大型电商平台为例,其用户行为日志先入 Kafka,再经 Flink 写入 S3 构成数据湖;同时,另一条管道通过 Airflow 调度 Spark 作业清洗后写入 Redshift 供 BI 使用。业务方发现,“昨日UV”在BI系统和算法团队的Jupyter Notebook里竟然差了12%。为了找出原因,前前后后花了三天时间,最后才发现,原来是两条数据管道用了不同版本的去重逻辑。
二、湖仓一体的核心:统一存储 + 统一事务 + 统一元数据
湖仓一体并非简单地“把仓库建在湖上”,而是通过底层存储格式与元数据层的革新,实现 一份数据、多类负载、强一致性 的能力。其技术基石主要由以下三部分构成:
1. 开放表格式(Open Table Formats)
Delta Lake(Databricks)、Apache Iceberg(Netflix 起源)、Apache Hudi(Uber 起源于)是当前三大主流开放表格式。它们在对象存储(如 S3、OSS)之上构建了事务性、时间旅行(Time Travel)、Schema 演化等能力。
以 Iceberg 为例,其核心设计如下:
S3 Bucket
├── data/
│   ├── part1.parquet
│   └── part2.parquet
└── metadata/
    ├── v1.metadata.json
    ├── v2.metadata.json
    └── snapshot-xxx.avro
每次写入生成新的元数据快照,读取时通过快照 ID 定位数据文件,天然支持 ACID 与时间点查询。
2. 统一计算引擎生态
湖仓一体的价值在于“谁都能读”。Spark、Flink、Presto、Trino、Hive 甚至 Snowflake(通过 External Table)均可对接 Iceberg 表。这意味着:
数据工程师用 Spark 做批处理; 实时团队用 Flink 写流; 分析师用 Trino 直接查原始明细; 算法工程师用 PySpark 训练模型。
所有角色操作的是同一张逻辑表,物理数据仅存一份。
3. 元数据解耦与服务化
传统 Hive Metastore 成为性能瓶颈。Iceberg 将元数据完全解耦,支持直接读取 S3 上的元数据文件,或通过 REST Catalog(如 Nessie、AWS Glue Data Catalog)提供高并发访问。这使得元数据操作(如分区变更、Schema 更新)不再依赖中心化数据库。
三、真实落地体验:从 POC 到生产
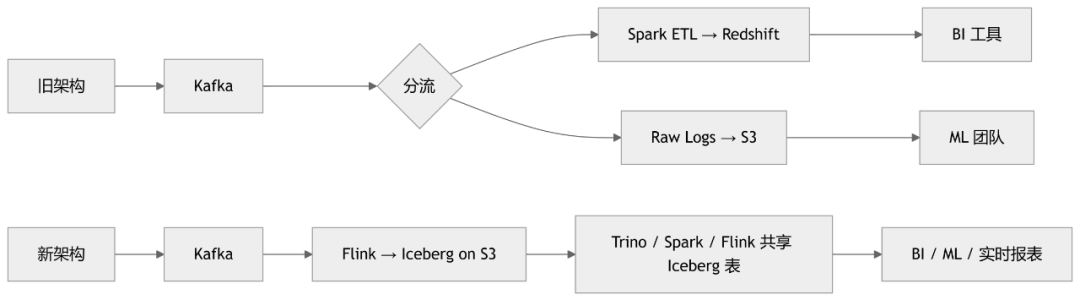
我们在 2024 年为一家金融科技公司实施湖仓一体架构,替换原有“Kafka → Spark → Redshift + S3”的双轨系统。以下是关键节点与反思。
架构演进对比
关键收益
存储成本下降40%:消除 Redshift 中的冗余副本,全部数据存于 S3。 ETL 开发效率提升:不再维护两套清洗逻辑,统一使用 Spark Structured Streaming 写 Iceberg。 数据一致性保障:通过 Iceberg 的 snapshot-id
,分析师可复现任意历史时刻的数据状态。
遇到的挑战
小文件问题:Flink 流式写入产生大量小 Parquet 文件,影响查询性能。
对策:启用 Iceberg 的rewrite_data_files
动作,配合定时压缩任务。Trino 对 Iceberg 的兼容性:早期版本不支持
MERGE INTO
,无法实现 SCD Type 2。
对策:升级至 Trino 406+,或改用 Spark 执行维表更新。权限粒度不足:S3 的 IAM Policy 无法按 Iceberg 表/列授权。
对策:引入 Apache Ranger 或 AWS Lake Formation 实现细粒度访问控制。
四、湖仓一体 ≠ 万能药:适用边界与选型建议
尽管湖仓一体优势显著,但并非所有场景都适合立即迁移:
OLTP 场景:仍需传统数据库(如 PostgreSQL)支撑高并发点查。 超低延迟需求:<100ms 的实时查询更适合 ClickHouse 或 Druid。 强事务型应用:银行核心账务系统仍依赖 Oracle 的完整 ACID。
选型建议
| Apache Iceberg + Trino + Spark | |
| Delta Lake | |
| Apache Hudi |
★注:Iceberg 在 2024 年已支持行级删除(通过 Position Delete),Hudi 的 COW 表也逐步优化查询性能,三者差距正在缩小。
五、未来展望:湖仓一体只是起点
湖仓一体的真正革命性,在于它打破了“仓库=结构化、湖=原始数据”的思维定式,推动数据平台向 统一、开放、弹性 演进。下一步,我们看到三个趋势:
向量湖仓:Iceberg 已开始探索嵌入向量索引(如 FAISS),支持 AI 原生查询。 Serverless 查询加速:Snowflake Arctic、BigQuery Omni 等产品将计算与存储进一步解耦。 Data Mesh 与湖仓融合:以域为中心的数据产品,底层仍依赖湖仓一体提供一致性保障。
#湖仓一体 #开放表格式 #ACID #多引擎兼容 #架构简化 #成本优化
扫码即可加入星球👇全部可下载
广告人士勿入,切勿轻信私聊,防止被骗
点下方的“❤”支持我们,非常感谢!
