



1.背景了解
备集群发生重启,cm对备集群重启处理是:
1.所有节点全部以级联备方式-M Cascade standby重启
2.设置节点为security_connect连接状态
3.设置节点为polling_connect状态
4.然后进行选主进行failover升首备

polling_connect: select * from pg_catalog.disable_conn(\’polling_connection\’, \’\’, 0);
轮询连接状态,主要用于长轮询场景,通过周期性查询数据库状态实现动态连接管理,限制性连接,只允许特定IP如白名单;
使用场景:数据库维护期间、数据迁移期间
security_connect: ProcessCmsMsg LOG: instId(6001) process_lock_chosen_primary_command succeed! command: select * from pg_catalog.disable_conn(‘specify_connection’, ‘192.168.0.64’, 1617);
通常指通过配置文件或代码直接指定数据库连接参数,如主机地址、端口、用户名等
使用场景:数据库正常运行的默认状态
2.问题1定位
备集群重启后,首备一直无法连接到主集群主节点,并报错

并且pg_log日志中后续会一直打印 “Invalid channel id: %d.”, replindex)
@根因分析1@:查看首备pg_log日志发现首备节点成功连接到主集群节点后,才报错Refuse WAL streaming, connection mode is 1, connertion IP is [首备节点ip]。
该报错信息可知:(a)首备节点是可以连接到主集群主节点的 (b)连接模式是:SPECIFY_CONNECTION =1 (3)连接ip是[首备节点ip]
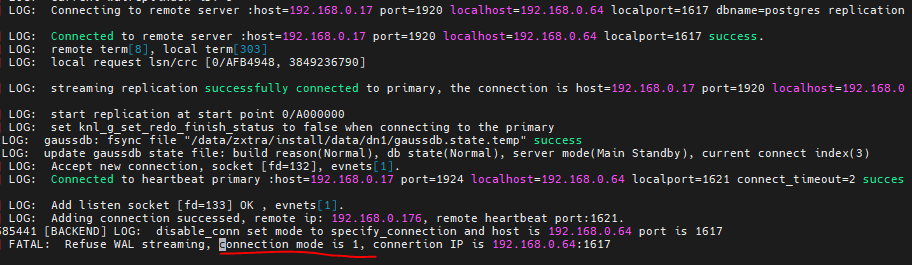
由于该fatal原因导致walreceiver线程挂了,流复制会重新进行建立。
@根因分析2@:查看第二处一直打印的日志对应代码
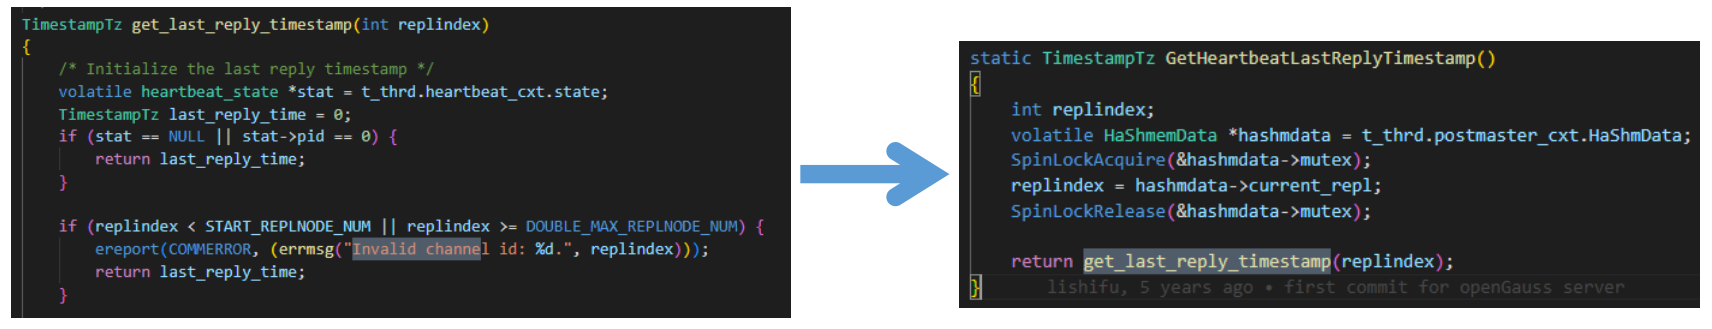
从代码中可以发现replindex是从t_thrd.postmaster_cxt.HaShmData->current_repl当前获取得到。
结合分析1+分析2可知:
首备正常启动,并与主集群主节点建立连接后 -> 由于cm的security_connect处理 -> 在walreicever线程正常连接接收数据的过程中 -> 运行到WalRcvrProcessData -> RefuseConnect函数报错FATAL: Refuse WAL streaming, connection mode is 1, connertion IP is 192.168.0.64:1617 -> 导致walreceiver线程挂了 -> 重新建立连接 -> 报错“Invalid channel id: 0.”
@根因分析3@:
由于无效的replindex是从t_thrd.postmaster_cxt.HaShmData->current_repl当前获取得到,因此需要分析t_thrd.postmaster_cxt.HaShmData->current_repl的赋值情况。
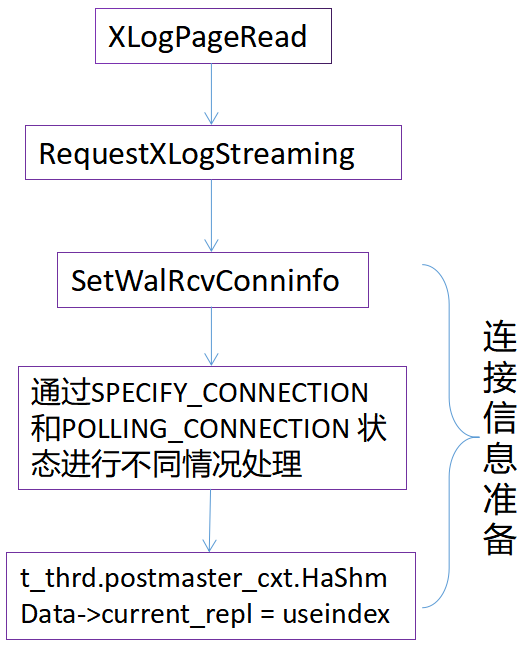
SetWalRcvConninfo函数处理逻辑:
(1) 如果当前是SPECIFY_CONNECTION:表示跳过其它节点连接,只连接special指定节点。
前提是必须满足g_instance.comm_cxt.localinfo_cxt.disable_conn_node.disable_conn_node_data.disable_conn_node_port == conninfo->remoteport),表示含义是disable_conn_node_port节点ip与与当前conninfo->remoteport节点相同
(2) 如果当前是POLLING_CONNECTION :t_thrd.walreceiverfuncs_cxt.WalReplIndex会递增,直到找到可以成功连接的节点
分析代码可知,首备由于SetWalRcvConninfo函数中遇到SPECIFY_CONNECTION,导致disable_conn_node_por是首备自己,conninfo->remoteport不是自己,这个条件导致无法成立,因此无法进入条件1,又由于当前是SPECIFY_CONNECTION状态,也无法进入条件2。最后导致useindex = 0;
随后walreceiver线程拉起时,t_thrd.postmaster_cxt.HaShmData->current_repl = 0,replconninfo = NULL
notice: replconninfo信息的索引是从1开始
代码文件:server_master\src\gausskernel\storage\replication\walreceiverfuncs.cpp
@根因分析4@:
根据cm对备集群重启处理,可知,SPECIFY_CONNECTION状态将首备节点信息全部发送给所有节点,包括自己。select * from pg_catalog.disable_conn(‘specify_connection’, ‘192.168.0.64’, 1617); 导致首备节点与主集群主节点连接好后walreceiver又挂了,重新建连的时候又由于该状态导致replconn信息为空,所以会一致打印invalid channel。
扩展思考:
通过上述分析可知,cm + server内核代码分析可知,该处理逻辑是针对单集群/主集群,也就是在单集群failover过程中,需要上锁并解锁的一个过程,通过SPECIFY_CONNECTION的处理,来指定在failover过程中其余备节点只能接受来自 升主备节点的 连接,对此我的理解是为了防止双主情况的一种,防止升主阶段,原主启动去连接其它备节点。
总结:
该设计时针对场景是单集群failover,控制其它非升主备节点在failover阶段只能连接升主节点。作用对象是:非升主备节点
这种设计延用到备集群,由于首备节点不是单纯的单角色节点,它既要作为server端来接收 级联备节点的连接,又要作为client端去连接主集群主节点。实际上不属于该设计的作用对象。
3.问题2分析
问题描述: 备集群发生重启后,级联备节点无法连接到首备心跳端口,一直报错Failed to connect to heartbeat primay
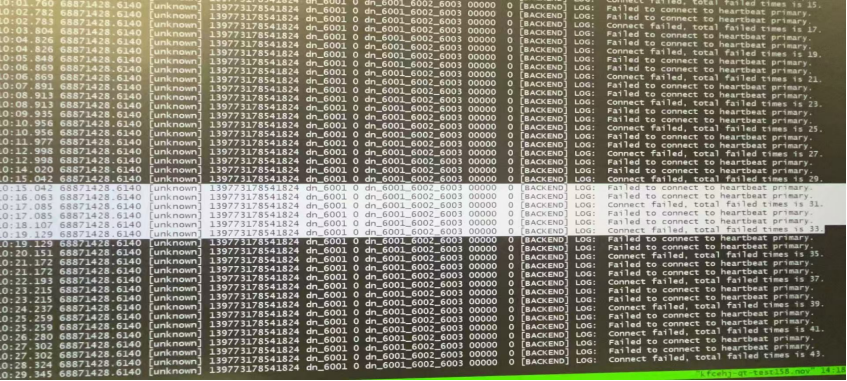
@定位分析1@:
1.在代码中搜索Failed to connect to heartbeat primay报错,找到函数HeartbeatClient::Connect
2.分析函数HeartbeatClient::Connect,该函数获取到replconninfo信息后,调用PQconnect函数进行连接
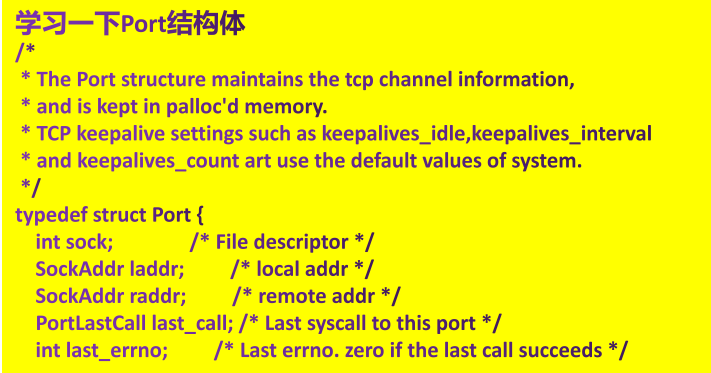
3.返回结果Port结构体,如果Port不为空,则打印日志Connected to heartbeat primary :[首备ip] success. 如果为空,则打印Failed to connect to heartbeat primay
4. 成功后会打印Add listen socket [fd=129] OK , evnets[1]。
从目前函数可知,备集群级联备连接首备节点心跳端口失败问题,猜测原因可能是:(1)replicon信息错误 (2)首备节点不允许级联备连接
@定位分析2@:
先检查replicon 配置 在配置文件中,如果无法确定,则加日志打印replcoin信息,先确定是否信息有问题,加日志如下:
ereport(LOG, (errmsg(“Connected to heartbeat primary :%s success.”, connstr)));
测试过后发现replconm信息在函数中正确,级联备中显示首备的信息正确。排除原因1。
从报错代码开始倒推:
报错 -> HeartbeatClient::Connect() -> server_loop -> heartbeat_main
从代码分析级联备走过的代码流程,加上定位分析1 的信息正确,发现所有情况都是正常的,从级联备角度无法分析下去。
换角度从首备分析,查看首备是否有接收到 级联备的连接请求。
@定位分析3@:
查看首备是否有接收到 级联备的连接请求。
首先在级联备节点执行“telnet 首备IP 心跳端口”,会返回connect refuse,查找操作系统相关资料,检查防火墙后排除是防火墙阻止端口连接,猜测原因可能是 首备IP没有被正确配置为接受连接状态。
当前通过前面几个步骤的排查,仍然存在一个知识盲区,由于对传统主备双集群连接细节不清楚,无法继续定位,只能暂时猜测上述原因,想不到更好的排查方法。
@定位分析4@:
重新找观测点,发现主备在第一次搭建的时候级联备是可以正常连接到首备。因此通过对比第一次搭建和重启后,首备日志发现一个不同点是级联备正常连接首备时,首备会打印如下日志:
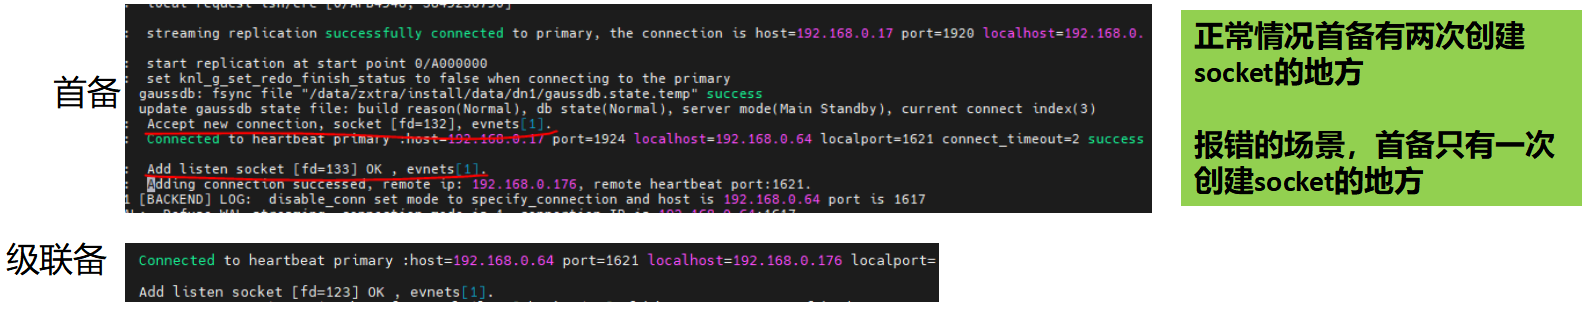
代码流程如下:
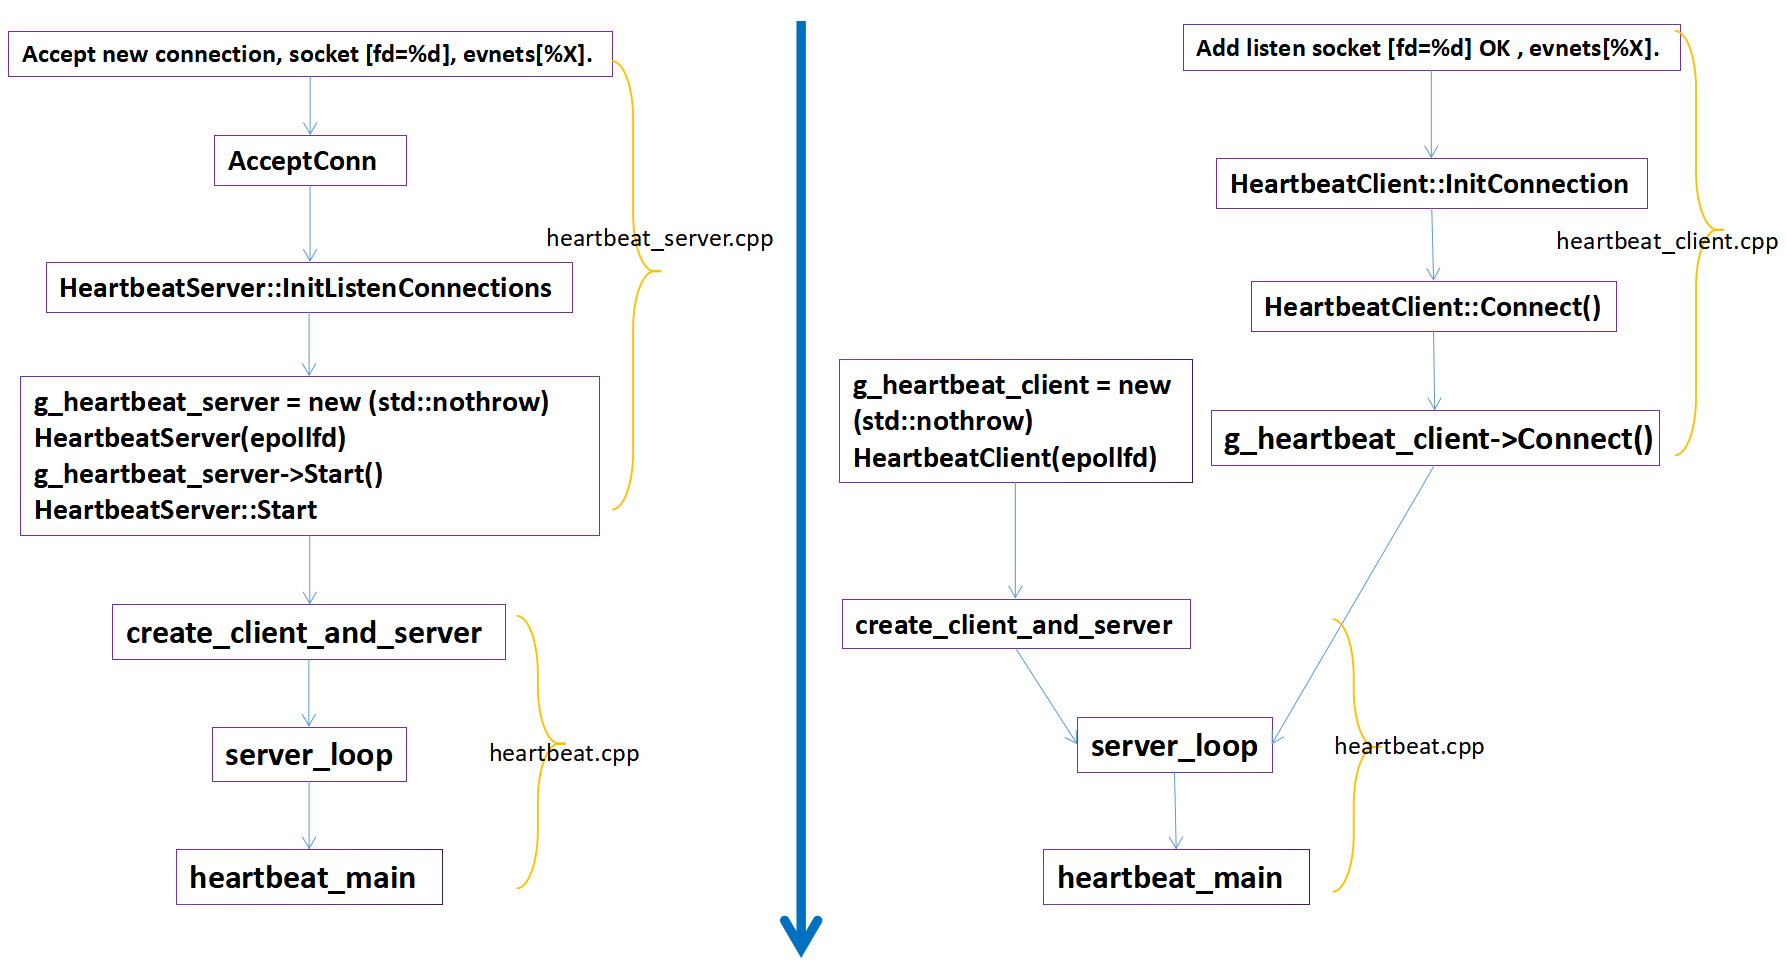
在首备pg_log搜索"heartbeat thread started"日志,发现线程拉起存在,但是不知道是此时是否创建g_heartbeat_server和g_heartbeat_client对象,在函数create_client_and_server添加日志,发现并没有创建g_heartbeat_server对象。
分析首备pg_log日志,发现首备启动是以级联备启动,因此is_cascade_standby=true,在heartbeat线程拉起来的时候,还没有进入failover,因此导致heartbeat线程只创建了g_heartbeat_client对象。
分析流程可知,failover过程中,应该会有退线程逻辑,理论上,heartbeat应该会重新拉起。在首备pg_log日志中全局搜索"heartbeat thread started"日志,发现只有1次,也就说明heartbeat没有被重新拉起,大概率是因为没有退出,找到heartbeat线程退出的代码如下:
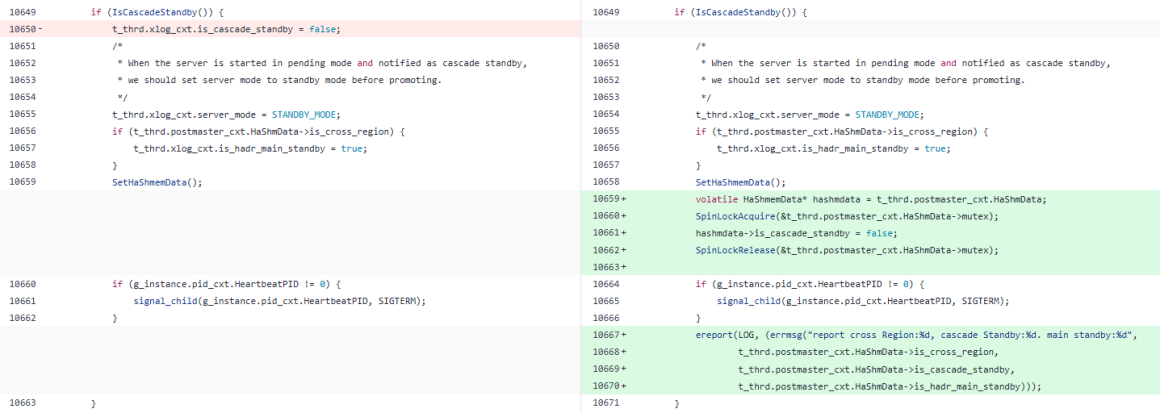
代码流程如下:
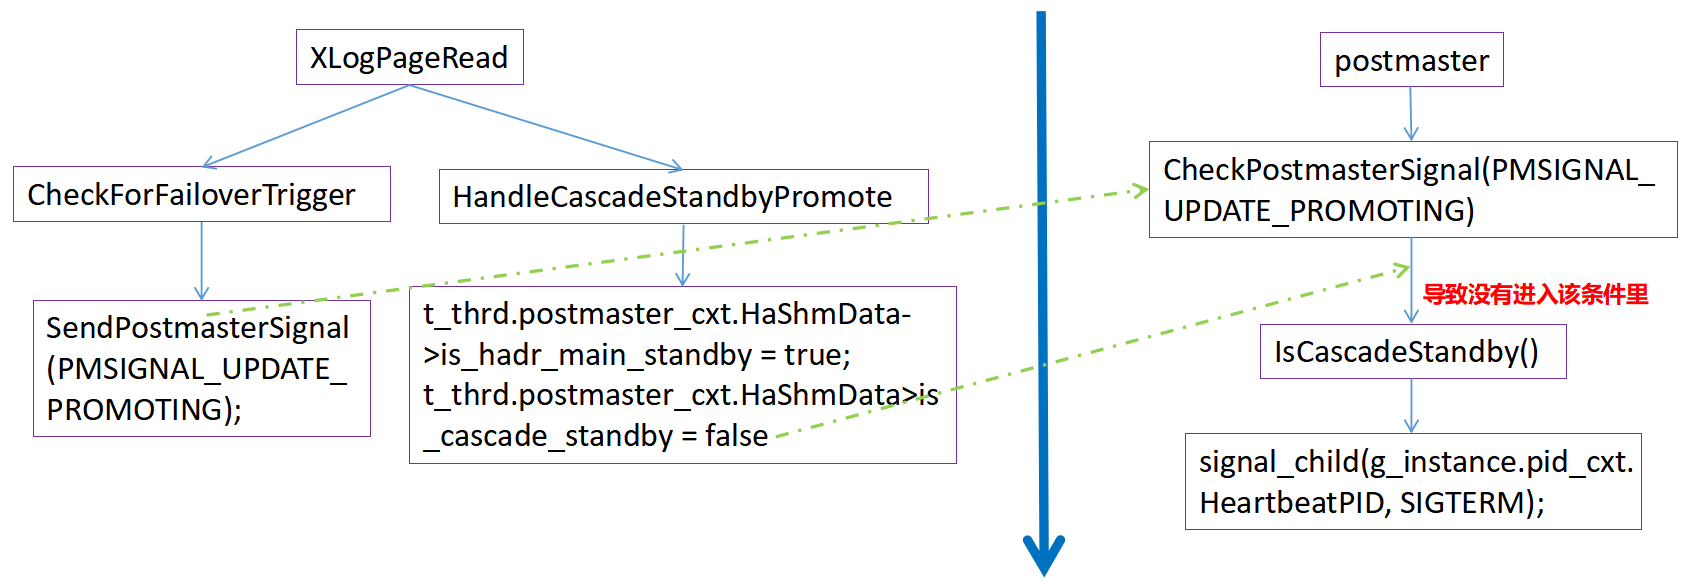
根因: 由于startup线程和pm线程并发,导致t_thrd.postmaster_cxt.HaShmData>is_cascade_standby先被设置成false,pm才收到PMSIGNAL_UPDATE_PROMOTING信号,此时无法进入IsCascadeStandby()函数中,导致heartbeat没有退出,因此g_heartbeat_server没有被创建,也没有创建接受连接的socket的,即监听端口没有创建,当级联备发送连接请求时没有对应的监听ip和端口,因此会一直报错
