随着数字化转型的深入,企业数据架构经历了一场从传统的企业数据仓库(EDW)到数据湖(Data Lake),再到如今Lakehouse(湖仓一体)架构的范式转移。Lakehouse架构巧妙地结合了数据湖的低成本、开放性与灵活性,以及数据仓库的高性能、ACID事务保障与质量管理能力,使得企业能够在一个统一的平台上处理从商业智能(BI)报表到机器学习(ML)模型训练的全谱系工作负载。
然而,在存储与计算层融合取得巨大进展的同时,作为一个关键的中间层——数据目录(Catalog),其发展却相对滞后。在传统的数据库管理系统(DBMS)中,目录是紧密耦合在引擎内部的元数据存储库,负责管理表结构、约束及权限。但在存算分离的Lakehouse架构中,目录的角色发生了改变:它不再仅仅是查询优化的辅助工具,而是连接底层异构云存储(如AWS S3、Azure Data Lake Storage、Google Cloud Storage)与上层多样化计算引擎(Spark、Trino、Presto、AI Frameworks)的纽带。
当前的Lakehouse生态系统主要依赖于像Hive Metastore(HMS)这样的组件作为操作目录。虽然HMS在大数据时代功不可没,但面对现代企业对安全性、合规性及AI资产管理的严苛要求,其架构局限性日益凸显。首先是治理的不一致性,用户既可以通过目录访问表,也可以绕过目录直接通过云API访问底层文件,导致权限管控出现“后门”。其次是互操作性的缺失,许多云原生目录(如AWS Glue)与特定计算平台强绑定,形成了新的数据孤岛。再者是资产类型的单一,传统目录仅能管理结构化表格,对于激增的非结构化数据(如文档、图像)及AI模型资产束手无策。
针对上述痛点,Databricks推出了Unity Catalog。其核心愿景是构建一个开放(Open)且通用(Universal)的治理层。所谓“开放”,意味着基于标准API和开放数据格式(如Delta Lake, Iceberg),不绑定特定计算引擎;所谓“通用”,意味着在单一命名空间下统一管理表、文件、模型等全类型资产,并实现跨云、跨工作空间的策略一致性。本文将深入剖析UC是如何通过一系列架构创新来实现这些目标的,并基于Databricks全球数千家客户的生产数据,验证其设计的有效性与先进性。
在设计下一代数据目录时,研发团队识别出了阻碍Lakehouse架构落地和扩展的四大核心挑战。这些挑战不仅存在于技术层面,更深刻影响着企业的数据安全态势与业务敏捷性。
2.1 统一访问控制的困境:逻辑与物理的割裂
在云原生Lakehouse环境中,数据访问天然存在“双重路径”现象。用户可以通过SQL查询引用逻辑层面的目录对象(例如 catalog.schema.table),也可以通过云存储SDK直接访问物理层面的存储路径(例如 s3://bucket/path/to/data)。
现有的目录系统(如HMS)通常仅在逻辑层面上实施访问控制列表(ACL)。然而,为了让计算引擎能够读取数据,企业往往不得不赋予计算集群宽泛的底层存储读取权限(如IAM Role)。这就造成了一个严重的安全漏洞:如果用户知晓数据的物理存储路径,并且具备调用云API的能力,他们就可以完全绕过目录层的ACL策略,直接读取原始数据。
这种“旁路访问”使得企业难以实施严格的数据安全策略。特别是在涉及行级过滤(Row-level Filtering)或列级脱敏(Column Masking)的精细化访问控制(FGAC)场景下,物理路径访问会直接暴露未经脱敏的原始数据,导致隐私泄露。如何在保留云存储灵活性的同时,切断这一“后门”,确保无论用户通过何种方式访问,都必须经过统一的权限校验,是UC面临的首要挑战。
2.2 多样化资产类型的管理鸿沟
随着人工智能技术的普及,现代数据平台不再仅仅是结构化数据的仓库。数据科学家需要管理成千上万个机器学习模型版本;合规团队需要扫描存储桶中的PDF合同以查找敏感信息;数据工程师需要维护复杂的ETL管道。
传统的数据湖目录是为“表(Table)”这一单一概念设计的。它们的数据模型(Database -> Table -> Column)过于僵化,无法自然地映射“模型注册表(Model Registry)”或“非结构化文件卷(Volume)”等概念。这导致企业通常需要维护多套割裂的元数据系统:一套用于SQL分析(HMS),一套用于ML工作流(MLflow),一套用于文件管理(对象存储浏览器)。这种碎片化不仅增加了运维成本,更导致了权限管理的混乱——管理员需要在三个系统中分别为同一个用户配置权限,且很难保证策略的一致性。例如,当一个员工离职时,必须在所有系统中同步撤销权限,稍有遗漏便会留下安全隐患。
2.3 外部访问与互操作性的壁垒
Lakehouse的一个核心优势是数据的开放性。然而,实际情况往往是数据被锁定在特定的引擎或格式中。当企业使用Databricks进行核心数据处理时,往往还需要使用其他工具(如PowerBI直接查询、外部Spark集群、或者基于Iceberg的查询引擎)来访问同一份数据。
如果目录是封闭的,外部工具就无法获取元数据,也就无法读取数据。此外,将数据从一种格式(如Delta Lake)转换为另一种格式(如Iceberg)以适配不同工具,会产生昂贵的数据复制和同步成本。如何在不进行数据搬迁的前提下,让外部系统能够安全、高效地访问受管数据,是实现数据使用平等化的关键。
2.4 发现能力与实时性的权衡
在数据治理领域,数据发现(Data Discovery)通常被视为后续阶段的需求,由专门的第三方工具(如Alation, Collibra)通过定期扫描元数据来实现。然而,将运营目录(Operational Catalog)与发现目录(Discovery Catalog)分离会带来一系列问题。
首先是延迟(Staleness)问题,搜索结果往往滞后于元数据的实际变更,导致用户基于过时的信息做出决策。其次是关系断裂,第三方工具通过解析SQL日志构建关系,这种方式容易出错且不完整,难以获取计算引擎内部的精确执行逻辑。最后是权限复用困难,发现工具通常无法复用运营目录的复杂权限逻辑,导致用户在搜索时可能看到他们无权访问的资产摘要,或者在点击详情时才被拒绝,用户体验极差。UC的设计目标是将发现能力内置于核心目录架构中,在保证核心服务低延迟的同时,提供实时的搜索与建立关系的能力。
Unity Catalog的设计不仅仅是一个元数据存储库,它是一个位于控制平面(Control Plane)的独立服务,旨在协调数据平面(Data Plane)中各个组件的行为。其架构设计遵循分层解耦的原则,以支持大规模多租户环境下的灵活治理。
3.1 统一的三层命名空间
UC引入了一个标准化的三层命名空间结构,彻底取代了传统的两层结构(Database.Table),为企业级治理提供了必要的层级隔离。
该模型的核心层级如下:
·Metastore(元存储):这是命名空间的顶层容器,通常映射到一个云区域(Region)。它包含了所有底层的元数据,并负责存储云资源的抽象定义(如存储凭证、外部位置)。一个企业通常在每个云区域部署一个Metastore,但可以通过数据共享协议实现跨Metastore的访问。
·Catalog(目录):命名空间的第一层(如 prod_catalog)。Catalog是数据隔离的主要边界,通常映射到业务单元、开发环境(Dev/Test/Prod)或组织边界。它是权限分配和资源配额管理的最高层级单元。
·Schema(模式/数据库):命名空间的第二层(如 finance_db),相当于传统数据库中的Database。它用于组织具体的资产,是日常权限管理和逻辑分组的常用粒度。
·Assets(资产):位于最底层,UC不仅支持传统的表,还扩展支持了多种新型资产:
oTables:结构化数据表,分为托管表(Managed Table)和外部表(External Table)。
oViews:视图,包括标准视图和物化视图,支持跨表逻辑封装。
oVolumes:卷,用于管理非结构化数据。Volumes将云对象存储中的一个目录映射为UC中的一个对象,使得用户可以使用类似文件系统的路径访问非结构化数据,同时享受UC的权限管控。
oModels:机器学习模型,深度集成了MLflow模型注册表功能,使得模型版本管理与数据管理同构。
oFunctions:用户自定义函数(UDFs),作为与内置功能同权的一等对象受管,确保计算逻辑的安全性与可复用性。
3.2 基于SQL标准的继承式权限模型
为了降低学习成本并适应大规模治理需求,UC采用了基于ANSI SQL标准的权限模型(GRANT/REVOKE)。其设计精髓在于层级继承(Hierarchical Inheritance)机制。
在UC中,任何资产的所有权(Ownership)赋予拥有者全部权限。而对于普通用户,权限是自上而下继承的。例如,如果管理员授予某个用户组对 prod_catalog 的 SELECT 权限,该用户组将自动获得该Catalog下所有Schema及所有Table的查询权限。这种设计极大地简化了权限管理工作——管理员无需为新增的每一张表单独授权,只需在Catalog或Schema层级配置策略,即可实现自动化的权限传播。同时,UC支持否定权限(Deny)和特权分离,确保高敏感数据(如PII)即便在宽泛的继承策略下也能被单独保护。
3.3 SQL查询的生命周期透视
为了深入理解UC如何介入数据访问流程,我们需要剖析一个典型的SQL查询在Lakehouse平台中的周期。
1.查询解析:用户提交SQL查询(如 SELECT * FROM prod.sales.orders)。计算引擎(如Databricks Runtime)首先解析SQL语句,提取引用的对象标识符。
2.元数据解析与鉴权:引擎向UC服务发起REST API请求。UC验证请求者的身份(Authentication)和权限(Authorization)。如果表定义了行过滤或列掩码,UC会将这些策略规则作为元数据的一部分返回给“受信任”的引擎。
3.查询规划:引擎利用UC返回的统计信息(Statistics)和模式信息生成物理执行计划。
4.凭证获取(Credential Vending):这是UC安全模型的核心。引擎在准备读取底层云存储(如S3)时,不会使用预置的静态AK/SK。相反,引擎向UC请求“临时凭证”。UC验证该操作合法后,向云厂商的STS(Security Token Service)请求一个短时效、作用域受限的临时令牌(Scoped Token),并将其返回给引擎。
5.数据访问:引擎使用这个临时令牌直接从云存储读取数据文件。云存储服务只认令牌,不知道上层的SQL逻辑,从而实现了存算分离下的安全闭环。
Unity Catalog之所以能解决“逻辑与物理割裂”的难题,依赖于其底层架构中的几个关键技术支柱,特别是“目录与引擎分离”以及“凭证分发”机制。
4.1 目录与引擎的解耦设计
在传统架构中,目录往往嵌入在引擎内部或与特定集群绑定。UC采取了目录服务化(Catalog as a Service)的设计思路。UC作为一个独立运行的多租户服务,通过标准化的REST API与所有计算引擎交互。
这种分离带来了双重价值:
1.通用性:只有当目录独立于计算引擎存在时,它才能同时服务于Spark SQL、Python ML脚本、甚至第三方的Trino集群。
2.信任模型:这种分离迫使系统明确区分“受信任引擎”与“不受信客户端”。
o受信任引擎(Trusted Engine,如Databricks Runtime):通过机器身份认证,有能力在计算层正确执行行级过滤和列级掩码。UC可以将底层文件的访问凭证(Scoped Token)交给它,由引擎负责数据的读取和过滤。
o不受信客户端(Untrusted Client):无法保证其代码的安全性或逻辑的正确性(如用户本地运行的Python脚本)。对于这类客户端,UC不会下发底层存储凭证,而是要求其通过受信任的中介服务(如Data Filtering Service)访问数据,或者仅获取脱敏后的结果。
4.2 核心安全机制:凭证分发与单一路径原则
为了彻底移除用户对云控制台或静态密钥的依赖,UC接管了云存储的权限管理,建立了一个应用层与基础设施层之间的动态安全气隙(Air Gap)。
4.2.1 路径即资产(One-Asset-Per-Path Principle)
UC在系统层面强制执行一条不变性原则:云存储中的每一个对象(文件或目录),在UC中最多只能映射为一个资产。
当用户尝试创建一个指向 s3://my-bucket/data/finance 的外部表时,UC会检查该路径及其父/子路径是否已经被其他表或卷占用。如果存在重叠(Overlap),创建操作将被拒绝。这一约束消除了“歧义性”。在HMS中,用户可以创建两张表指向同一个路径,一张表配置了严格的ACL,另一张表则没有,攻击者可以利用未保护的表名访问同一份数据。UC通过路径唯一性约束,确保了该物理路径上的所有访问请求都必须解析到同一个UC对象,从而强制执行统一的治理策略。
4.2.2 临时凭证分发(Credential Vending)
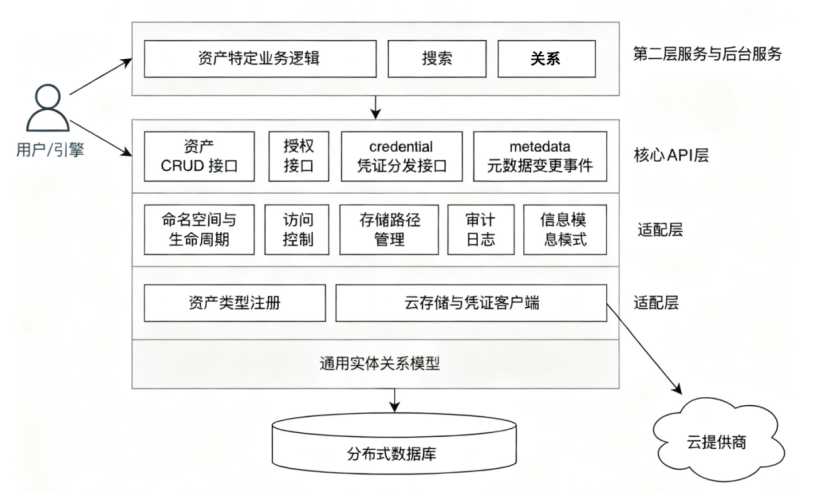
图1:UC服务的层次化架构,包含凭证分发模块
UC的凭证分发机制是其零信任架构的基石。其工作流程如下:
1.配置阶段:管理员在UC中配置“存储凭证(Storage Credential)”,这是一个封装了云厂商IAM角色(Role)的高特权对象。接着,管理员创建“外部位置(External Location)”,将存储凭证与特定的S3 Bucket路径绑定。
2.隔离阶段:普通用户从未直接接触IAM角色或Bucket策略,也不拥有云账号的控制台访问权限。
3.运行时阶段:当用户查询数据时,引擎向UC发起请求。UC验证用户对表的 SELECT 权限后,利用自身的IAM角色权限,向云厂商(如AWS STS)动态申请一个仅对当前查询涉及的文件路径有效的、时效极短(通常为1小时)的临时令牌(SAS Token或STS Token)。
4.访问阶段:UC将这个令牌返回给引擎,引擎使用令牌读取数据。
这种机制确保了即便用户代码中有恶意逻辑,它也无法窃取长期凭证,且其访问范围被严格限制在当前查询所需的数据分片内(最小权限原则)。
UC的设计初衷不仅是管理Databricks内部的数据,更是要成为企业全域数据的治理中枢。为此,UC在资产类型的扩展性和外部系统的集成上做了大量创新。
5.1 实体关系模型的泛化能力:从表格到AI
为了支持AI和非结构化数据,UC没有为每种新资产类型单独开发存储后端,而是构建了一个通用的实体关系(E-R)数据模型。
UC底层使用关系型数据库存储元数据。它定义了一套通用的Schema,包含 Guid, Name, ParentId, Owner, Properties 等通用字段。所有资产类型(表、模型、卷)都继承自这一通用模型。
·MLflow集成案例:为了支持MLflow模型注册表,Databricks团队并没有重写MLflow后端,而是通过UC的扩展机制,新增了 Registered Model 和 Model Version 两种资产类型。UC实现了一个适配层(Adapter Layer),将MLflow的REST API调用转化为对UC通用E-R模型的CRUD操作。这意味着ML模型自动继承了UC的所有通用特性——权限继承、审计日志、标签管理、搜索发现,而无需为模型管理单独开发这些功能。
·非结构化数据卷(Volumes):UC引入的“卷”概念,实际上是在对象存储的扁平命名空间上强加了目录结构。卷作为Schema下的一个对象,使得非结构化文件(如图片、日志、基因序列数据)可以像表一样被组织、授权和搜索。这对于AI训练场景至关重要,因为训练数据往往是以文件形式存在的。
5.2 目录联邦(Catalog Federation)
对于许多企业而言,数据迁移是一项浩大的工程,且数据往往分散在多个系统中(如Snowflake, Redshift, MySQL)。UC通过“联邦”功能,允许用户在不移动数据的情况下纳管外部系统。
用户在UC中创建一个指向外部系统的 Foreign Catalog。UC采用按需镜像(On-Demand Mirroring)策略。考虑到外部系统元数据的体量,UC不会全量同步所有元数据。相反,当用户查询联邦表时,UC实时连接外部系统获取最新的Schema信息,并在本地建立一个轻量级的影子对象。这使得UC成为了企业的“单一治理面板”。管理员可以在UC中统一查看和审计所有数据源的访问情况,即便是那些数据并未实际存储在Lakehouse中的系统。
5.3 开放生态:Delta Sharing与UniForm
UC内置了Delta Sharing服务器。这是一套基于REST的开放协议,允许将UC管理的表安全地共享给任何支持该协议的客户端(如Pandas, Tableau, Excel),而无需在接收端部署Databricks集群。
此外,为了解决Table Format War(Delta Lake vs Iceberg vs Hudi),UC推出了UniForm (Universal Format)。UC在写入Delta Lake数据时,能够自动生成并维护Iceberg和Hudi的元数据。这意味着存储在Delta Lake中的数据,可以像Iceberg表一样被外部引擎(如Snowflake, BigQuery)读取。UC负责维护不同格式元数据的双向同步,彻底打破了表格格式的锁定,真正实现了“存储一次,处处读取”。
作为独立服务运行的UC,面临着最大的技术挑战之一是网络延迟。与HMS(通常与引擎同局域网部署甚至嵌入式部署)不同,UC是一个全球分布的多租户SaaS服务,任何元数据访问都涉及跨网络的RPC调用。为了在增加网络跳数的情况下仍保持甚至超越本地目录的性能,UC实施了多层级的性能优化策略。
6.1 激进的批处理(Aggressive Batching)
在分布式系统中,网络往返(Round Trip)是影响性能较大的因素。一个简单的 SELECT * FROM table 查询,实际上需要获取大量元数据:表Schema、表属性、当前用户的权限、存储凭证、分区信息等。如果每个信息都单独发请求,延迟将不可接受。
UC采用了激进的批处理策略。UC客户端(运行在引擎侧)会将这些请求打包成一个“宽请求”(Fat Request)。服务端会并行处理这些子任务,一次性检索表定义、验证权限、生成云存储凭证,并将所有上下文信息打包返回。这不仅将几十次毫秒级的网络往返压缩为一次,还减轻了服务端的并发连接压力。
6.2 智能缓存架构
Databricks对生产环境的元数据访问模式进行了深入分析,发现了两个关键特征:
1.工作集(Working Set)小:如图2所示,绝大多数Metastore的活跃元数据量小于100MB。这意味着将热点元数据完全放入内存是可行的。
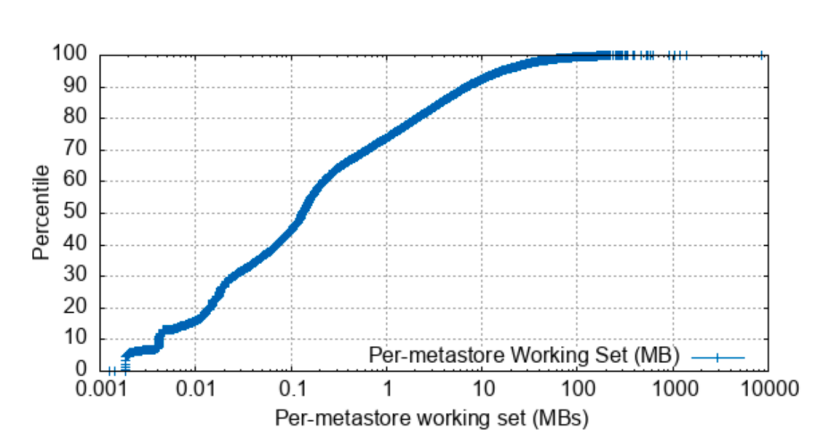
图2:所有UC元存储在稳定状态下的每个元存储工作集大小的累积分布函数(CDF)
2.时间局部性(Temporal Locality)强:如图3所示,如果一个表被访问了一次,它很大概率在接下来的几秒内会被再次访问(90%的叶子节点资产在100秒内被重访)。
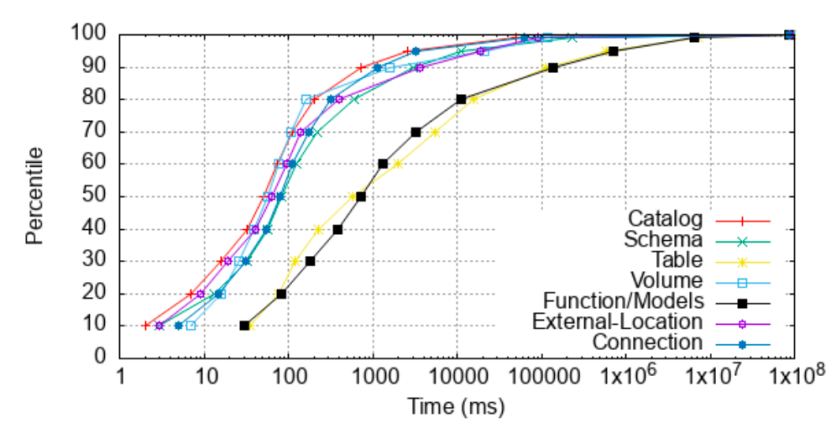
图3:相同资产访问间隔时间的累积分布函数(CDF),按不同资产类型绘制
基于此,UC实施了多级缓存:
·服务端缓存(Server-side Cache):UC服务节点在内存中缓存热点元数据。为了保证一致性,UC利用底层数据库的事务版本号(Version)来实现缓存失效。当底层DB更新时,缓存节点通过版本比对感知变化。
·客户端缓存(Client-side Cache):在引擎侧缓存不可变元数据(如Schema版本)和短时效的凭证。
·凭证缓存:云存储凭证的生成通常涉及与云厂商API的交互,延迟较高。UC会缓存这些凭证,在有效期内复用,极大减少了对云厂商STS服务的调用压力。
6.3 事务一致性与序列化隔离
UC必须支持ACID事务,特别是在处理表定义的并发修改时(如Schema Evolution)。UC利用底层关系型数据库的序列化隔离级别(Serializable Isolation)来保证元数据操作的原子性和一致性。相比于基于最终一致性存储(如DynamoDB)构建的目录,UC的强一致性模型大大简化了应用层的逻辑,确保在高并发下不会出现元数据损坏或节点自主决策冲突现象。
Databricks基于其全球数千家客户的生产数据,对UC的表现进行了详尽的评估。这部分内容揭示了真实世界中Lakehouse的使用模式,并用数据证明了UC架构设计的正确性。
7.1 资产分布的重尾效应与多样性
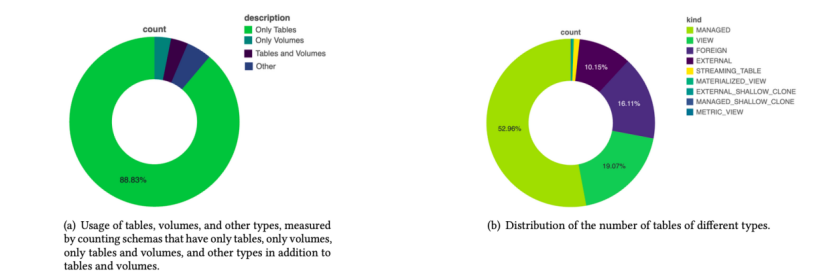
图4:不同资产类型的使用分布(表、卷、模型等)
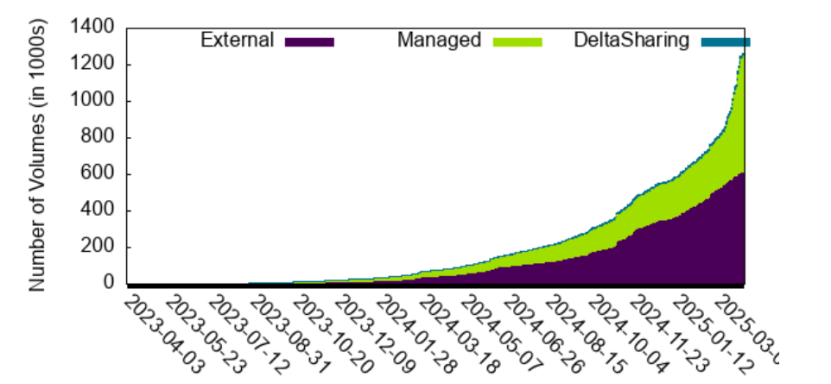
图5:创建的卷数量的增长随着时间的推移正在加速
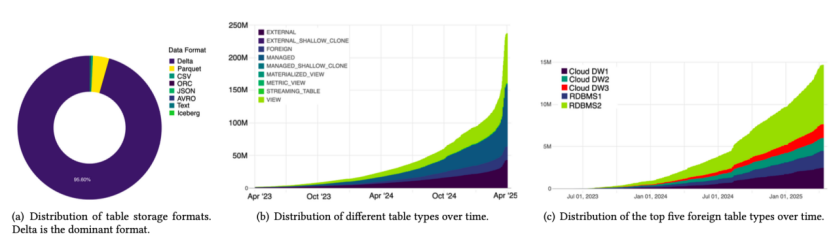
图6:表格存储格式的分布
生产环境数据揭示了几个趋势:
·资产多样性验证:数据显示,虽然表(Tables)仍然是主流,但卷(Volumes)的使用量正在加速增长(见图5)。这强有力地证明了将非结构化数据纳入统一治理的必要性。特别是在生成式AI爆发的背景下,大量RAG应用依赖Volume来存储向量索引和原始文档。
·表类型分布:约53%的表是Managed Tables(托管表),这表明用户越来越倾向于让平台全权管理数据生命周期(如自动清理垃圾文件),而不是自己管理S3文件。
·联邦的兴起:约16%的表是Foreign Tables,且来自Snowflake、Redshift等系统的表数量显著增长,验证了联邦功能的市场需求。这表明企业正在构建混合数据架构,而不是单一的单体数仓。
7.2 性能基准测试:UC vs HMS
为了验证远程服务的性能影响,Databricks对比了UC(远程SaaS服务)与配置为“本地模式”的HMS(最佳性能配置,引擎直连DB)。
·结果:尽管UC增加了网络开销且执行了更复杂的权限检查(FGAC),其端到端查询性能与本地HMS持平甚至略优。
7.3 统一治理带来的新能力:预测性优化
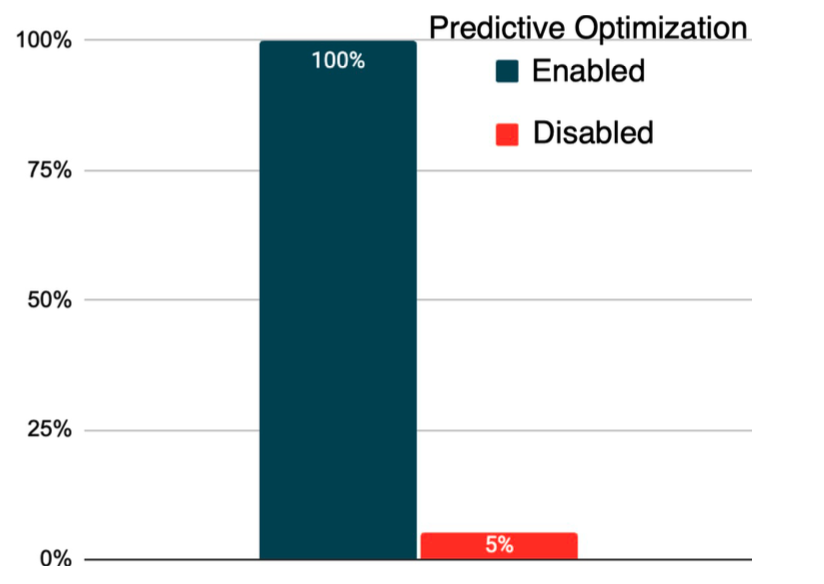
图7:预测性优化带来的查询延迟提升
由于UC拥有全量的元数据和统计信息,它可以实施预测性优化(Predictive Optimization)。这是一项只有在统一治理架构下才能实现的功能。
·机制:UC后台自动分析表的访问模式、文件碎片情况和集群负载。它智能地调度 OPTIMIZE(小文件合并)和 VACUUM(垃圾回收)任务,无需人工干预。
·成效:实验显示,对于1TB的TPC-DS数据集,预测性优化将某些查询的延迟降低了20倍,同时通过及时清理垃圾文件显著降低了存储成本。相比之下,传统的HMS只是被动的元数据存储,无法主动触发此类优化。
7.4 访问模式的混合性
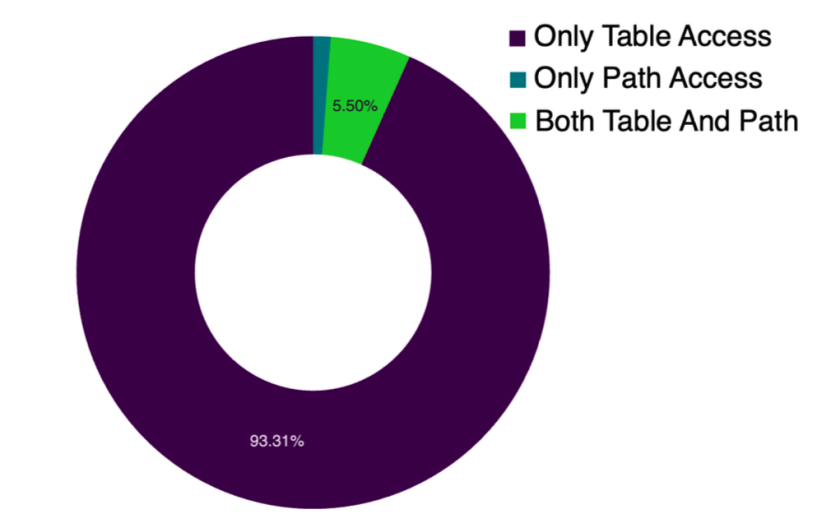
图8:通过表名访问 vs 通过路径访问的分布
数据显示,约7%的表访问依然通过物理路径进行。这看似比例不高,但往往涉及遗留系统或关键的ETL底层操作。UC的“单一路径原则”确保了这部分访问依然受到严格监管,填补了传统方案中最大的安全漏洞。这也提醒我们,在从传统架构向Lakehouse迁移的过程中,兼容物理路径访问是平滑过渡的关键。
该论文不仅是对Databricks新一代产品架构的介绍,更是对数据管理领域未来方向的探索尝试。
8.1 核心贡献总结
1.重新定义了Catalog:从单纯的元数据存储库,进化为主动的、统一的治理控制平面。
2.解决了“物理绕过”难题:通过凭证分发和路径资产化,封堵了Lakehouse架构长期存在的安全缺口。
3.实现了真正的通用性:证明了统一管理结构化数据、非结构化数据和AI模型在架构上是可行且高效的。
4.性能与功能的双赢:证明了通过工程优化(缓存、批处理),远程SaaS目录可以达到甚至超越本地目录的性能。
8.2 行业启示:数据与AI治理的融合
UC的设计理念对整个数据行业具有深远影响。随着大模型(LLM)应用的爆发,数据治理与AI治理(AI Governance)的边界将日益模糊。UC展示了如何在一个系统中同时管理RAG应用的向量索引(作为Table或Volume)、训练数据(作为Assets)和LLM模型本身(作为Model)。
未来,随着Agent和Tool Use的普及,Catalog将不仅管理静态数据,还将管理动态的“工具”和“API”。Unity Catalog这种基于通用实体模型、强调开放互操作性的设计,为构建下一代智能数据平台(Data Intelligence Platform)奠定了坚实的基石。它标志着数据治理从“阻碍业务的合规工具”转变为“赋能业务的资产管理平台”的新时代。
论文解读联系人:
刘思源
13691032906(微信同号)
liusiyuan@caict.ac.cn