



1
背景介绍
我们在使用MySQL数据库时,都是通过逻辑语义的Table_name来做SQL查询和修改,这一系列的访问请求又最终都会转化为实际的文件操作。
那么数据库是如何维护Table_name与对应数据文件的映射关系,基于这份映射又是如何完成文件操作?下面笔者将通过Fil_system对象来剖析一下这个过程。
2
数据结构
Fil_system是InnoDB管理物理文件的子模块,主要负责创建物理文件的内存管理结构,同时屏蔽物理文件中的复杂组织结构,为上层提供了简洁的文件操作接口。
为了理解Fil_system管理的内容,我们首先需要了解一个标准的InnoDB表空间文件在磁盘上是如何组织的。InnoDB的物理文件包括系统表空间文件ibdata,用户表空间文件ibd,日志文件ib_logfile,临时表空间文件ibtmp,undo独立表空间等。
除了redo日志文件,上述文件都具有统一的物理结构,都是由固定大小的页组成。每个表空间除了数据页外,还有重要的管理页(如FSP_HDR,即文件的第一页,记录了整个空间大小、空闲/已使用的区列表等全局信息)。
InnoDB则通过这些页面构建了从页(Page)-> 区(Extend)-> 段(Segment)-> 表空间(Tablespace)的分层文件组织形式,实现了对物理数据文件的高效管理。
了解到数据文件的磁盘组织结构,继续探讨在内存中的组织形式。Fil_system的引入,使上层只需要正确管理表空间对象tablespace即可实现数据文件的访问和修改。
具体来说,日常的CRUD操作中的Table_name在InnoDB中都会被映射为独立的Tablespace对象,具有唯一的space_id标识。在InnoDB运行期间,在内存中便会保存所有space_id, space_name以及相应tablespace的映射关系,这些都存储在Fil_system这个对象中。
如图1所示,Fil_system是在内存中维护表空间信息的全局对象,与其相关的数据结构有fil_space_t和fil_node_t。fil_space_t代表一个tablespace,fil_node_t代表表空间中的各个物理文件,比如redo日志由是多个文件组成一个逻辑上的循环文件组,就包含了多个fil_node_t,对于 Innodb_file_per_table设为1的常规表空间来讲,每个fil_space_t都代表一个tablespace,file_node_t也只有1个。fil_system_t中使用两个hash table维护映射关系,基于这份映射,当一个事务需要读取或修改数据时,能够快速定位到对应的 fil_space_t对象,fil_space_t负责管理所属自己的fil_node_t的文件链表,确定具体操作哪个fil_node_t,最终根据fil_node_t中记录的文件句柄,执行真正的文件读写操作。
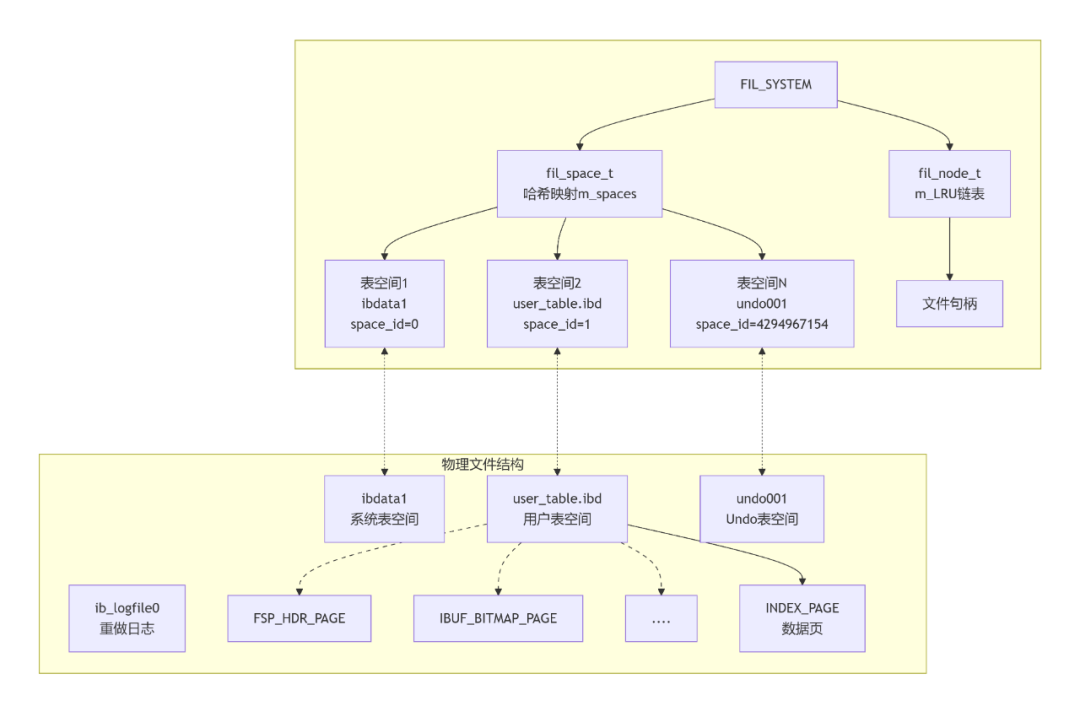
图1 FIL_SYSTEM的组成和映射
Fil_system的具体实现如下,其中m_shards是Fil_system的核心数据结构,它将所有表空间文件分散到多个Fil_shard(文件分片)中进行管理,这种设计通过分片锁而不是全局锁来提升并发性能。
从shard_by_id函数可以看出,系统根据space_id进行哈希分片:常规表空间使用space_id % UNDO_SHARDS_START,UNDO表空间有独立的分片区段。
Fil_system作为全局的文件系统管理器,将具体文件I/O任务委托给了其管理的多个分片去执行,自身主要是管理分片(如shard_by_id()等方法)、整体的文件打开上限(m_open_files_limit)以及负责执行跨分片操作(如close_all_files()、iterate()等需要遍历所有分片的操作)。
Fil_shard则维护了space_id到tablespace对象的哈希表m_spaces以及space_name到tablespace对象的哈希表m_names。此外,还通过m_LRU链表管理本分片内的文件节点,采用LRU(最近最少使用)策略,当需要关闭文件以释放资源时,优先关闭该列表末端的文件(详见章节3.3)。Fil_shard管理其分片内的表空间 (fil_space_t) 和文件节点 (fil_node_t),执行本分片内表空间和文件节点的新增、删除、重命名、读取等实际的IO操作。
fil_space_t是表空间的逻辑代表,通过 files向量管理属于该表空间的所有fil_node_t,并通过 m_deleted、stop_new_ops等标志管理空间状态。
fil_node_t负责管理单个物理文件的详细信息,可以看作是文件的代理人,通过 is_open、handle管理文件的打开状态和句柄,通过 n_pending_ios、n_pending_flushes跟踪挂起的IO操作等。
class Fil_system {public:Fil_shards m_shards; /** Fil_shards 管理器,默认有69个*/bool close_file_in_all_LRU(); /** 尝试关闭所有LRU列表中的一个文件 */void close_all_files(); /** 关闭所有打开的文件 */bool set_open_files_limit(size_t &new_max_open_files); /** 修改最大打开文件数限制 */size_t get_open_files_limit() const { return m_open_files_limit.get_limit(); }dberr_t iterate(Fil_iterator::Function &f); /** ** 遍历所有的表空间文件 */dberr_t scan() { return m_dirs.scan(); } /** 扫描目录以构建表空间ID到文件名的映射表 *//** 根据空间ID获取Fil_shard */Fil_shard *shard_by_id(space_id_t space_id) const {if (fsp_is_undo_tablespace(space_id)) {const size_t limit = space_id % UNDO_SHARDS;return m_shards[UNDO_SHARDS_START + limit];}return m_shards[space_id % UNDO_SHARDS_START];}private:fil::detail::Open_files_limit m_open_files_limit; /** 允许打开的最大文件数,默认1024 */space_id_t m_max_assigned_id; /** 现有表中的最大space_id,启动时打开space时也会赋值,创建新表时会赋值 */Tablespace_dirs m_dirs; /** 启动时扫描的文件目录,通过scan()方法建立表空间ID到物理文件路径的映射关系 */}class Fil_shard {using File_list = UT_LIST_BASE_NODE_T(fil_node_t, LRU); /**< 文件节点LRU列表类型 */using Space_list = UT_LIST_BASE_NODE_T(fil_space_t, unflushed_spaces); /**< 未刷盘表空间列表类型 */using Spaces = std::unordered_map<space_id_t, fil_space_t *>; /**< 表空间ID到表空间对象的映射 */using Names = std::unordered_map<const char *, fil_space_t *, Char_Ptr_Hash,Char_Ptr_Compare>; /**< 表空间名到表空间对象的映射 */public:size_t id() const { return m_id; } /** 返回分片ID */bool close_files_in_LRU(); /** 尝试关闭分片LRU列表中的一个文件 */void remove_from_LRU(fil_node_t *file); /** 将文件节点从LRU列表中移除 */void close_all_files(); /** 关闭Fil_shard中所有打开的文件。 */void complete_io(fil_node_t *file, const IORequest &type); /** 当I/O操作完成时更新文件中I/O计数等字段 */bool prepare_file_for_io(fil_node_t *file); /** 为I/O操作准备文件句柄。如果文件关闭则打开它。 */dberr_t space_rename(); /** 重命名单表表空间 */dberr_t space_delete(); /** 删除表空间,此操作将删除数据文件,并从file_system_t缓存中删除fil_space_t和fil_node_t条目。 */fil_space_t *space_create(); /** 创建一个表空间内存对象并将其放入fil_system哈希表 */dberr_t do_io(); /** 根据page_id读取或写入数据。 */dberr_t iterate(Fil_iterator::Function &f); /** 遍历Fil_shard中所有的表空间文件 */dberr_t get_file_size(fil_node_t *file, bool read_only_mode); /** 获取此文件的大小 */private:const size_t m_id; /** Fil_shard 分片ID */Spaces m_spaces; /** 按表空间ID哈希存储的表空间实例集合*/Names m_names; /** 按表空间名称哈希存储的表空间实例集合 */File_list m_LRU; /** 最近最少使用的已打开文件的LRU列表的基础节点 */Space_list m_unflushed_spaces; /** 包含未刷盘写入的表空间列表的基础节点 */};struct fil_space_t {using Files = std::vector<fil_node_t, ut_allocator<fil_node_t>>;Files files;}struct fil_node_t {fil_space_t *space;char *name;bool is_open;pfs_os_file_t handle;}
3
文件管理机制
3.1 关于Fil_system的初始化
Fil_system初始化是一个至关重要的过程,它为整个存储引擎的文件I/O操作搭建了基础框架。
初始化的过程始于innobase_init_files函数,它调用了fil_init。在此过程中,会创建一个全局唯一的Fil_system单例对象,并确定了InnoDB同时打开的文件数量上限以及分片个数。
紧接着通过fil_set_scan_dir设置数据文件绝对目录,然后进入fil_scan_for_tablespaces,并行扫描出所有的.ibd(用户表空间)和 .ibu(undo表空间)文件,读取每个文件的0号页面,从中解析获得文件对应的space_id,和文件名也就是Tablespace名做一个映射,被记录到 Fil_system的 m_dirs(其类型为Tablespace_dirs)中,建立一个从 space_id到物理文件路径的映射关系,这个mdirs在崩溃恢复时至关重要。
接着InooDB开始处理维持运行所需的核心文件,一个是系统表空间,通过 srv_sys_space.open_or_create打开或创建对应的 fil_space_t和 fil_node_t内存对象;一个是Redo Log,该文件通常被专属的Fil_shard管理。这些核心文件的文件句柄会保持常开状态,且不会被放入 LRU 列表进行管理。如果 InnoDB 检测到数据库是异常关闭的,则会进入崩溃恢复流程。
恢复过程会解析Redo Log,从最近的检查点(Checkpoint LSN)开始,重放已提交但未刷盘的事务。在此过程中,系统会按需调用fil_tablespace_open_for_recovery来打开重做日志中引用到的、但尚未打开的用户表空间文件(.ibd),此时便会用到m_dirs快速定位到需要恢复的物理文件。
在Crash Recovery结束后,把DD中所保存的Tablesapce全部进行Validate check一遍(Validate_files::check->fil_ibd_open->validate_to_dd),用于检查是否有丢失ibd文件或者数据有残缺等情况,在这个过程中,会把所有保存在DD中的Tablespace信息,并保存在Fil_system中。
需要注意的是,如果库表较多,validate_to_dd可能耗时较久。至此,整个InnoDB中所有的Tablespace的映射信息都会加载到内存中。此外,MySQL8.0加入了参数validate_tablespace_paths参数用于控制是否在正常启动时做表空间校验,以加快MySQL的启动速度。
|--> DDSE_dict_recover| |--> innobase_dict_recover| | |--> boot_tablespaces| | | |--> Validate_files::validate| | | |--> *multi thread scan*/| | | |--> n_threads=fil_get_scan_threads| | | |--> Validate_files::check| | | | |--> fil_ibd_open| | | | | |--> if(validate)| | | | | |--> Datafile::validate_to_dd| | | | | | |--> *校验第一页是否正常,并读取flushed_lsn*/| | | | | | |--> Datafile::validate_first_page| | | | | | | |--> *读取第一页,然后检验*/| | | | | | | |--> Datafile::read_first_page| | | | | | | | |--> os_file_read_no_error_handling| | | | | | | | | |--> os_file_read_no_error_handling_func| | | | | | | | | | |--> os_file_read_page| | | | | | | |--> *读取之前绝对路径,并与现在的对比*/| | | | | | | |--> fil_space_read_name_and_filepath| | | | | |--> end if (validate)| | | | | |--> fil_space_create| | | | | |--> Fil_shard::create_node *Attach a file to a tablespace*/
3.2 关于Fil_system的访问
3.3 关于文件状态的维护
在 InnoDB 中,Fil_system将所有的表空间文件管理职责分散到多个Fil_shard中,每个分片都维护着自己的 m_LRU链表 ,这个链表的主要作用,一个是跟踪所有已打开且当前没有正在进行I/O操作的用户表空间文件(fil_node_t)并组织起来;另一个是当整个系统打开的文件总数接近或超过上限(由 innodb_open_files参数控制)时,通过淘汰最近最少使用的文件来释放文件描述符。
即当文件在LRU链表中时,表示已打开但是目前状态空闲,是资源回收的候选对象。若不在LRU链表中,则表示文件正在忙碌(有挂起的IO),需要被保护起来,避免被关闭。
所以加入LRU的文件通常是用户表空间,将它们纳入LRU管理,可以在资源紧张时关闭不活跃的文件,从而高效地利用有限的文件描述符。系统关键文件,如系统表空间(ibdata)、重做日志(redo log)等通常不加入LRU,这些文件在数据库运行期间被频繁、持续地访问,需要常驻内存,保持打开状态以确保数据库核心功能的稳定运行。
LRU的运行机制详见以下函数:
1. prepare_file_for_io(将文件从 LRU 中移除):在进行物理IO的时候会调用该函数,如果当前文件没有其他未完成的I/O,说明它是空闲状态,则从LRU中将其移除,并增加挂起I/O计数,告诉系统当前文件即将转为忙碌状态,确保不会被意外关闭。
bool Fil_shard::prepare_file_for_io(fil_node_t *file) {....if (!file->is_open) {open_file(file);}if (file->n_pending_ios == 0) {remove_from_LRU(file);}++file->n_pending_ios;....}
2. close_file_in_all_LRU(从LRU中淘汰文件):若系统需要打开新文件但文件描述符不足时,会触发淘汰机制。
具体来说,在 open_file函数中,如果检查发现当前打开文件数(fil_n_files_open)已超过限制,则会调用Fil_system::close_file_in_all_LRU,close_file_in_all_LRU会采用轮询策略,依次检查每个 Fil_shard的m_LRU链表。在每个分片内,close_files_in_LRU函数会从 m_LRU链表的尾部开始向前扫描(UT_LIST_GET_LAST(m_LRU))。这是因为链表尾部是最近最少被访问的文件。它会检查文件状态(如 file->can_be_closed()),确保文件没有挂起的I/O或刷新操作,然后调用 close_file将其关闭,并从m_LRU链表中移除。
bool Fil_shard::open_file(fil_node_t *file) {have_right_for_open = acquire_right(fil_n_files_open, fil_system->get_open_files_limit());if (!have_right_for_open) { // 说明打开文件数已到上限/* 刷新表空间以便可以关闭LRU列表中的已修改文件 */fil_system->flush_file_spaces();// 核心关闭操作:尝试关闭所有LRU链表中的文件if (!fil_system->close_file_in_all_LRU()) {fil_system->wait_while_ios_in_progress(); // 如果关闭失败,等待进行中的I/O完成}}if (success) {add_to_lru_if_needed(file); // 如需要则加入LRU列表file->is_open = true; // 标记文件为已打开}}bool Fil_shard::close_files_in_LRU() {// 从链表上的最后一个节点开始淘汰,也就是最近最少使用的文件for (auto file = UT_LIST_GET_LAST(m_LRU); file != nullptr;file = UT_LIST_GET_PREV(LRU, file)) {if (file->can_be_closed()) {close_file(file);return true;}}return false;}
3. add_to_lru_if_needed(将文件加入LRU):当文件不再忙于I/O时,需要将其交还给LRU链表管理,以便系统后续进行资源调度。complete_io函数会在I/O操作结束后被调用。减少文件的 n_pending_ios计数。如果计数降为0,并且该文件属于需要LRU管理的类型(如用户表空间),则通过 UT_LIST_ADD_FIRST(m_LRU,file)将其重新插入到 m_LRU链表的头部,表示它最近被使用过。在 open_file函数成功打开一个文件后,也会将其加入到链表的头部中进行管理。
void Fil_shard::complete_io(fil_node_t *file, const IORequest &type) {--file->n_pending_ios;if (type.is_write()) {write_completed(file);}if (file->n_pending_ios == 0) {add_to_lru_if_needed(file);}}// 新打开的文件被放在头部,表示最近最多使用的文件void Fil_shard::add_to_lru_if_needed(fil_node_t *file) {if (Fil_system::space_belongs_in_LRU(file->space)) {UT_LIST_ADD_FIRST(m_LRU, file);}}
4
总结
Fil_system通过分片式架构(Fil_shard)管理所有表空间文件、将全局的文件操作压力分散到多个分片上以减少锁竞争,并通过LRU算法确保在系统文件打开数接近上限时能有效释放资源,同时为上层提供表空间和IO操作接口,简化了InnoDB对于物理文件的访问流程。
Fil_system的引入巧妙地平衡了性能、并发与资源消耗,它不仅保证了数据库日常操作的高效性,更在崩溃恢复等关键场景下确保了数据的一致性与持久性,是InnoDB可靠性的重要组成部分。
END
历史文章
【华为云MySQL技术专栏】MySQL InnoDB索引数据页面结构解析
 戳“阅读原文”,了解更多技术干货
