暂无图片
暂无图片
暂无图片
暂无图片
暂无图片

chDB 内核升级全记录:ClickHouse 升级至 v25.8.2.29

ClickHouseInc 2025-12-11
92


本文字数:16645;估计阅读时间:42 分钟

作者:Victor Gao

Meetup活动


ClickHouse 西安第一届 Meetup 火热报名中,详见文末海报!


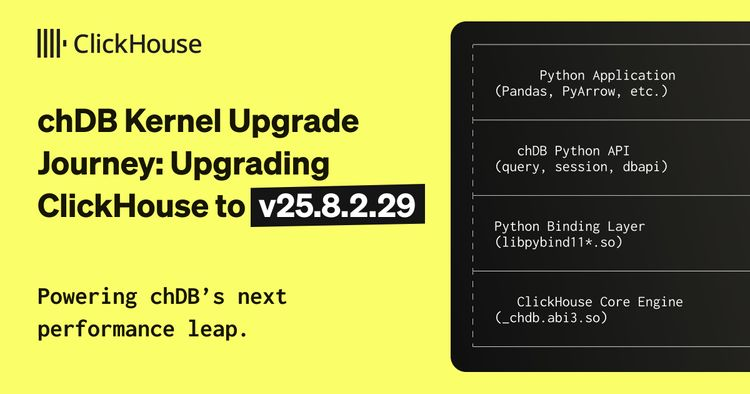
chDB 是一个嵌入式 OLAP SQL 引擎,它将 ClickHouse 强大的分析能力封装为一个 Python 模块,使开发者无需安装或运行 ClickHouse 服务器,即可在 Python 环境中享受高性能的数据分析体验。近期,我们完成了 chDB 的一次重大内核升级(PR #383),将内核版本从 v25.5 升级到 v25.8.2.29。此次升级不仅带来了新功能与性能优化,也暴露出一系列技术挑战。本文将系统介绍此次升级过程中遇到的技术问题与应对方案。

1. chDB 的架构与代码结构

1.1 整体架构

chDB 的核心理念是在 Python 进程中嵌入 ClickHouse 引擎,构建真正的进程内查询引擎。其架构大致分为以下几个层次:

与传统的客户端/服务器模式不同,chDB 并不依赖独立的服务进程:

  • 零拷贝数据传输:通过 Python 的 memoryview 与 C++ 的 WriteBufferFromVector 实现零拷贝的数据传递

  • 嵌入式引擎:ClickHouse 直接在 Python 进程中运行,避免了进程间通信的开销

  • 多格式原生支持:内建支持 60 多种数据格式,如 Parquet、CSV、JSON、Arrow、ORC 等


1.2 代码结构

chDB 的代码架构在继承 ClickHouse 的基础上,进行了大量定制化改造:

    chdb/
    ├── chdb/                    # Python package
    │   ├── __init__.py          # Main query interface
    │   ├── session/             # Session management
    │   ├── dbapi/               # DB-API 2.0 implementation
    │   └── udf/                 # User-defined functions
    ├── programs/local/          # Local query engine
    │   ├── LocalChdb.cpp        # chDB main entry
    │   ├── PythonSource.cpp     # Python Table Engine
    │   └── PandasDataFrame.cpp  # Pandas integration
    ├── src/                     # ClickHouse core source
    └── contrib/                 # Third-party dependencies

    核心查询流程如下:

    1. Python 端调用 chdb.query(sql, format)

    2. 通过 pybind11 将请求传入 C++ 层

    3. ClickHouse 引擎解析并执行 SQL

    4. 查询结果以 memoryview 方式零拷贝返回给 Python


    2. 为什么采用两个动态链接库?

    chDB 采用了一个较为特殊的架构设计:使用两个动态链接库 _chdb.abi3.so 和 libpybind11nonlimitedapi_chdb_3.8.so。虽然看起来略显复杂,但正是这个设计解决了多版本 Python 兼容性的关键问题。


    2.1 多 Python 版本兼容性的挑战

    目前 Python 生态活跃着多个版本(3.8、3.9、3.10、3.11、3.12、3.13),每个版本的 C API 都存在细微差异。传统的 Python C 扩展通常需要为每个版本分别编译生成对应的二进制文件。但对于像 chDB 这样体积庞大的项目而言(即便经过裁剪与压缩,单个 .so 文件仍超过 120MB),这种方式是难以接受的。


    2.2 动态库分层架构

    chDB 采用了一种模块化分层设计:

    chdb.abi3.so(稳定 ABI 层)

    • 基于 Python 的 Limited API 实现

    • 只依赖 Python 的稳定 ABI 接口

    • 可在多个 Python 版本间通用复用

    • 文件大小约为 120MB,包含完整的 ClickHouse 引擎

    • 主要内容包括:ClickHouse 核心、查询执行引擎、格式解析器等


    libpybind11nonlimitedapi_chdb_3.x.so(版本适配层)

    • 使用完整的 Python C API(非 Limited API)

    • 需针对每个 Python 版本单独编译

    • 文件大小约 10–20MB

    • 包含 pybind11 的绑定逻辑,以及 Python 对象的转换处理

    我们通过构建脚本 build_pybind11.sh 为每个目标 Python 版本构建 libpybind11 库:

      # Build independent binding libraries for Python 3.8-3.13
      for version in 3.8 3.9 3.10 3.11 3.12 3.13; do
          cmake -DPYBIND11_NONLIMITEDAPI_PYTHON_HEADERS_VERSION=${version} ..
          ninja pybind11nonlimitedapi_chdb_${version}
      done


      这种架构的优点在于:

      1. 存储更高效:核心引擎(120MB)只需下载一次,不同 Python 版本仅需额外 ~15MB 的绑定库

      2. 构建更高效:核心引擎编译耗时较长(数小时),但绑定层构建速度快(几分钟内完成)

      3. 维护更简便:核心逻辑统一,仅需根据不同 Python 版本适配绑定层即可


      2.3 jemalloc 与内存管理的挑战

      不过,这样的设计也引入了新的技术难题。在《The birth of chDB》(https://auxten.com/the-birth-of-chdb/)一文中我们曾提到,chDB 在早期开发过程中遇到了严重的内存管理问题。

      2.3.1 问题的发现与根源

      问题场景如下:

      在将 Python 扩展模块集成进 chDB 时,我们经常遇到段错误(segmentation fault)。通过分析 core dump 文件,我们发现崩溃多发生在内存释放的阶段:

        Program received signal SIGSEGV, Segmentation fault.
        0x00007ffff7a9e123 in je_free () from path/to/_chdb.abi3.so
        (gdb) bt
        #0  je_free (ptr=0x7fffe8001000)
        #1  __wrap_free (ptr=0x7fffe8001000) at AllocationInterceptors.cpp:451
        #2  0x00007ffff7e8a456 in PyMem_Free (ptr=0x7fffe8001000)
        #3  0x00007ffff7dab234 in list_dealloc ()

        深度根因分析:

        这是一个典型的跨模块内存管理问题:
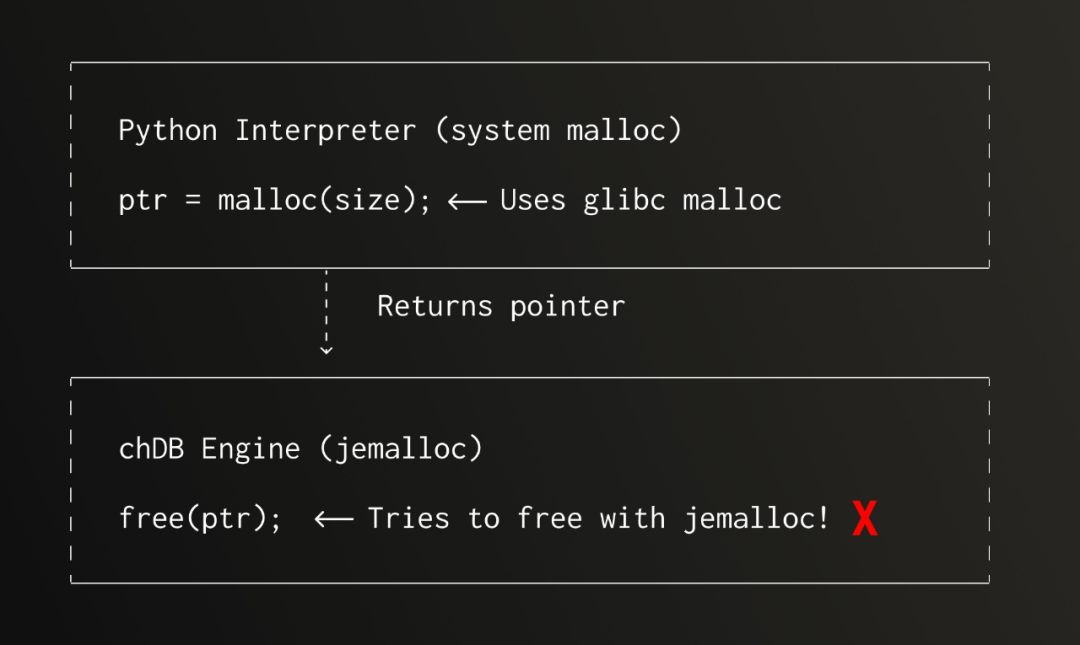

        根本原因在于:

        C/C++ 的内存管理遵循“谁分配,谁释放,且必须由相同分配器”这一原则。如果混用了不同的内存分配器,可能导致以下问题:

        1. 元数据被破坏:比如 jemalloc 在释放内存前尝试读取其元数据,但如果该内存是由 glibc 分配的,就可能读取到无效或随机的数据

        2. 堆结构遭破坏:各分配器的堆管理机制截然不同,交叉释放会破坏彼此的数据结构

        3. 出现未定义行为:轻则立即崩溃,重则内存数据被悄然破坏,引发后续各种异常错误

        常见的触发场景包括:

          // Scenario 1: Objects returned from Python C API
          PyObject* obj = PyList_New(10);  // Python uses malloc
          // ... used in C++
          delete obj;  // chDB's operator delete uses je_free → crash!
          // Scenario 2: Memory allocated by glibc functions
          char* cwd = getcwd(NULL, 0);  // glibc internally uses malloc
          // ...
          free(cwd);  // wrapped to je_free → crash!
          // Scenario 3: Third-party libraries (e.g., libhdfs)
          hdfsFile file = hdfsOpenFile(...);  // libhdfs uses system malloc
          hdfsCloseFile(fs, file);  // internally calls free, wrapped → crash!


          2.3.2 传统方案的局限性

          方案一:完全禁用 jemalloc

            -DENABLE_JEMALLOC=0

            ❌ 会造成性能下降。ClickHouse 在 jemalloc 上做了大量优化,禁用后整体性能下降达 20%–30%。

            方案二:通过 LD_PRELOAD 强制使用 jemalloc

              LD_PRELOAD=/usr/lib/libjemalloc.so python chdb_example.py

              通过设置 LD_PRELOAD 变量,让整个进程(包括 Python 解释器)强制使用 jemalloc 分配器。

              ❌ 带来分发困难。用户必须在特定环境中配置运行,使用门槛较高。


              2.3.3 chDB 的解决方案

              为兼顾性能与兼容性,chDB 采用了运行时检测内存来源 + 智能路由的机制。核心思路是利用链接器的 --wrap 机制,在编译链接阶段拦截所有的内存分配与释放调用,并在运行时判断其来源。

              技术基础:wrap 拦截机制

              链接器的 --wrap 选项允许在链接时重定向符号调用:

                # Add wrap parameters at link time
                -Wl,-wrap,malloc
                -Wl,-wrap,free
                -Wl,-wrap,calloc
                -Wl,-wrap,realloc
                # ... other memory allocation functions

                其工作原理如下:

                  Application code calls:  free(ptr)
                        ↓
                  Linker redirects:  __wrap_free(ptr)  ← Our implementation
                        ↓
                  Callback when needed:  __real_free(ptr)  ← Original glibc implementation

                  通过该机制,所有对 free() 的调用会被重定向至我们自定义的 __wrap_free() 函数中。在这个函数内,我们可以添加内存归属判断逻辑,并在必要时调用原始的 __real_free() 来完成释放。

                  关键前提:禁用 jemalloc 的符号重命名

                  要让该方案生效,chDB 需要区分 jemalloc 的 je_free() 与 glibc 的 free()。因此必须禁用 ClickHouse 默认启用的 jemalloc 符号重命名功能,确保 jemalloc 的符号名得以保留:

                    # ClickHouse default config: Rename jemalloc symbols
                    --with-jemalloc-prefix=je_
                    # Effect: malloc → je_malloc, free → je_free
                    # chDB config: Disable renaming
                    -DJEMALLOC_PREFIX=""
                    # Effect: Preserve je_malloc, je_free and other original symbol names

                    这样我们就可以实现以下行为:

                    • 在 __wrap_free() 中判断当前内存块的分配来源

                    • 若来自 jemalloc,则调用 je_free(ptr)

                    • 若来自 glibc,则调用 __real_free(ptr)(即系统默认的 free)

                    核心机制:分配器指纹识别

                    我们使用 jemalloc 提供的 mallctl API,动态查询内存块的归属分配器:

                      inline bool isJemallocMemory(void * ptr) {
                          // Query which arena this memory block belongs to
                          int arena_ind;
                          size_t sz = sizeof(arena_ind);
                          int ret = je_mallctl("arenas.lookup",
                                               &arena_ind, &sz,     // Output: arena index
                                               &ptr, sizeof(ptr));  // Input: memory pointer
                          // arena_ind == 0: special value, indicates memory doesn't belong to jemalloc
                          // arena_ind > 0:  memory belongs to a jemalloc arena
                          return ret == 0 && arena_ind != 0;
                      }

                      智能释放函数如下所示:

                        inline ALWAYS_INLINE bool tryFreeNonJemallocMemory(void * ptr) {
                            if (unlikely(ptr == nullptr))
                                return true;
                            // Check memory source
                            int arena_ind;
                            size_t sz = sizeof(arena_ind);
                            int ret = je_mallctl("arenas.lookup", &arena_ind, &sz, &ptr, sizeof(ptr));
                            if (ret == 0 && arena_ind == 0) {
                                // This memory doesn't belong to jemalloc, use system free
                                __real_free(ptr);
                                return true;  // Handled, no need to continue
                            }
                            // This memory belongs to jemalloc, or query failed (conservative handling)
                            return false;  // Continue with jemalloc release process
                        }
                        extern "C" void __wrap_free(void * ptr) {
                            if (tryFreeNonJemallocMemory(ptr))
                                return;
                            // Use jemalloc to release
                            AllocationTrace trace;
                            size_t actual_size = Memory::untrackMemory(ptr, trace);
                            trace.onFree(ptr, actual_size);
                            je_free(ptr);
                        }


                        2.3.4 向 jemalloc 社区贡献代码

                        在实现上述方案的过程中,我们注意到 jemalloc 的 arenas.lookup 接口存在一个问题:当接收到并非由 jemalloc 分配的内存指针时,内存检测机制会导致程序崩溃。

                        这并不是一个 bug,而是 jemalloc 的设计预期——它默认所有传入指针都是合法的堆内存指针。但对于 chDB 的混合分配场景,我们需要 arenas.lookup 能够安全处理任意类型的指针。为此,@Auxten Wang 向 jemalloc 提交了一个补丁,增强了边界判断逻辑。

                          // Before: Assumes pointer is valid, directly accesses metadata → invalid pointer crashes
                          // After: First checks pointer validity, safely returns result
                          if (ptr == NULL || !isValidPointer(ptr)) {
                              return EINVAL;  // Return error code instead of crashing
                          }

                          这一改动已经被 jemalloc 官方接受并合并进主干分支,@Auxten Wang 也因此成为 jemalloc 的正式贡献者。


                          3. 内核升级带来的 wrap 机制变更与适配

                          3.1 ClickHouse 新版本引入 wrap 机制引发冲突

                          在升级 ClickHouse 内核到 v25.8.2.29 版本后,我们遇到了一个新的问题:ClickHouse 在该版本中也引入了 wrap 机制,用于拦截内存分配与释放操作,以实现更精细的内存追踪。

                          这与 chDB 现有的 wrap 实现方式产生了直接冲突:

                            chDB's wrap (introduced in Section 2):
                              free(ptr) → __wrap_free() (chDB implementation)
                                        → Check memory source (je_mallctl)
                                        → Route to je_free or __real_free
                            ClickHouse new version's wrap:
                              free(ptr) → __wrap_free() (ClickHouse implementation)
                                        → Update MemoryTracker statistics
                                        → Call je_free
                            Conflict:
                              Two __wrap_free implementations cannot coexist!

                            冲突的根本原因在于:

                            链接器的 --wrap 机制对每个符号只能使用一个 wrap 实现。当 ClickHouse 内核和 chDB 的绑定层都尝试定义 __wrap_free 等符号时,链接器将无法确定该采用哪一方的实现。


                            3.2 适配方案:融合两套 wrap 实现

                            为了解决冲突,我们需要将 ClickHouse 的内存追踪逻辑与 chDB 的内存分配来源检测逻辑整合为一个统一的 wrap 实现:

                            具体思路如下:

                            1. 保留 chDB 原有的 wrap 实现作为最终的拦截入口

                            2. 在 chDB 的 wrap 函数中调用 ClickHouse 提供的 MemoryTracker 实现内存追踪

                            3. 按照实际场景决定是否进行内存分配器来源检测

                            最终实现效果如下:

                            融合后的 __wrap_free 函数结构如下所示:

                              extern "C" void __wrap_free(void * ptr) // NOLINT
                              {
                              #if USE_JEMALLOC
                                  // chDB logic: Check if it's non-jemalloc memory
                                  if (tryFreeNonJemallocMemory(ptr))
                                      return;  // Already handled glibc-allocated memory via __real_free
                              #endif
                                  // ClickHouse logic: Update MemoryTracker statistics
                                  size_t actual_size = Memory::untrackMemory(ptr, trace);
                              #if USE_JEMALLOC
                                  // Use jemalloc to release
                                  je_free(ptr);
                              #else
                                  // If jemalloc not enabled, use system free
                                  __real_free(ptr);
                              #endif
                              }


                              3.3 双库架构下的 operator delete 内存释放问题

                              在实现第 2 节中提到的双动态链接库架构(_chdb.abi3.so 与 libpybind11nonlimitedapi_chdb_xx.so)时,我们发现 operator delete 同样存在跨模块内存释放的问题,与 free 的问题如出一辙。

                              问题分析:

                                libpybind11nonlimitedapi_chdb_3.8.so:
                                  - Links to glibc at compile time
                                  - Calls malloc → Bound to glibc malloc (compile-time symbol binding)
                                  - Calls delete during object destruction
                                _chdb.abi3.so:
                                  - Contains jemalloc and operator delete implementation
                                  - libpybind11*.so loads _chdb.abi3.so at runtime
                                  - delete call → Resolves to definition in _chdb.abi3.so at runtime

                                问题性质:

                                虽然系统启用了 jemalloc,但 libpybind11nonlimitedapi_chdb_xx.so 中的 malloc 在编译时就已绑定到 glibc 的分配符号。而在运行时,delete 操作实际调用的是 _chdb.abi3.so 中的 delete 实现。由于两者使用了不同的分配器,导致释放时发生不匹配的问题,存在严重的内存安全隐患。

                                  In libpybind11*.so:
                                    char* obj = malloc(100);  // malloc() → glibc malloc (compile-time binding)
                                    delete obj;            // operator delete → _chdb.abi3.so implementation (runtime binding)
                                                           // Tries to use jemalloc to free glibc-allocated memory → crash!

                                  解决方案:在 operator delete 中增加内存来源检测

                                  与处理 free 函数类似,我们在 operator delete 实现中加入了内存来源检测逻辑:

                                    void operator delete(void * ptr) noexcept
                                    {
                                    #if USE_JEMALLOC
                                        // Detect memory source, handle non-jemalloc memory early
                                        if (tryFreeNonJemallocMemory(ptr))
                                            return;
                                    #endif
                                        // ClickHouse memory tracking
                                        Memory::untrackMemory(ptr, trace);
                                        // Actual release (jemalloc memory)
                                        Memory::deleteImpl(ptr);
                                    }

                                    该方案确保了在双库架构下的内存释放行为正确、安全:

                                    • 如果内存是由 libpybind11.so 使用 glibc malloc 分配的:通过 tryFreeNonJemallocMemoryConditional 检测后,使用 glibc 的 free 正确释放

                                    • 如果是由 _chdb.abi3.so 使用 jemalloc 分配的:则走正常的 MemoryTracker 与 jemalloc 的释放路径


                                    4. ClickBench Q29 查询性能问题与优化

                                    4.1 问题发现

                                    完成内核升级后,我们注意到在 ClickBench 基准测试中,Q29 查询性能出现严重下降。该查询涉及大量正则表达式匹配与替换操作。

                                      SELECT REGEXP_REPLACE(Referer, '^https?://(?:www\\\\.)?([^/]+)/.*$', '\\\\1') AS k,
                                             AVG(length(Referer)) AS l,
                                             COUNT(*) AS c,
                                             MIN(Referer)
                                      FROM clickbench.hits
                                      WHERE Referer <> ''
                                      GROUP BY k
                                      HAVING COUNT(*) > 100000
                                      ORDER BY l DESC
                                      LIMIT 25;

                                      查询特征:

                                      • 每一行都包含正则匹配和替换逻辑

                                      • 查询过程中会频繁创建和销毁字符串对象

                                      • 字符串操作密集触发内存分配与释放行为

                                      性能指标:

                                      • 升级后的初始运行时间为约 300 秒

                                      • 经优化后降至约 4.9 秒,性能提升达 61 倍


                                      4.2 根本原因分析

                                      通过性能分析工具与源码阅读,我们发现性能瓶颈主要来源于 jemalloc 的锁竞争问题。

                                      在升级后的实现中,每一次 delete 操作都会触发 tryFreeNonJemallocMemory(),以判断该内存块是否由 jemalloc 分配。这种频繁的检测操作,最终导致了大量线程在 jemalloc 内部锁上发生竞争,从而拖慢了整体执行效率。

                                        // Pre-optimization code
                                        inline bool tryFreeNonJemallocMemory(void * ptr)
                                        {
                                            if (unlikely(ptr == nullptr))
                                                return true;
                                            // Key bottleneck: je_mallctl lock contention
                                            int arena_ind = je_mallctl("arenas.lookup", nullptr, nullptr, &ptr, sizeof(ptr));
                                            if (unlikely(arena_ind != 0))
                                            {
                                                __real_free(ptr);
                                                return true;
                                            }
                                            return false;
                                        }

                                        瓶颈分析:je_mallctl 锁竞争问题

                                        通过阅读 jemalloc 源码(位于 contrib/jemalloc/src/jemalloc.c),我们发现性能瓶颈出现在 check_entry_exit_locking() 函数,该函数负责执行内存锁的获取与检查。

                                          int je_mallctl(const char *name, void *oldp, size_t *oldlenp, void *newp,
                                              size_t newlen) {
                                          ...
                                              check_entry_exit_locking(tsd_tsdn(tsd));  // Lock contention point!
                                              ...
                                              return ret;
                                          }

                                          在 Q29 的查询场景中,该机制成为了严重的性能阻塞点,主要原因如下:

                                          • 高频调用:正则表达式的匹配操作会大量生成临时字符串对象

                                          • 每次 delete 都触发检测:每一次内存释放操作都会调用 je_mallctl("arenas.lookup", ...)

                                          • 多线程下出现严重锁竞争:并行执行时,大量线程集中调用 check_entry_exit_locking,形成系统级瓶颈

                                          性能分析结果:

                                          使用 perf 工具进行性能采样后发现,约 99.8% 的 CPU 时间都耗费在该锁相关函数的调用中。

                                            operator delete
                                              └─ tryFreeNonJemallocMemory
                                                  └─ je_mallctl
                                                      └─ check_entry_exit_locking  ← Hotspot!
                                                          └─ pthread_mutex_lock


                                            4.3 优化方案:引入 disable_memory_check 机制

                                            优化的核心思路是:避免在无必要的场景下执行内存分配器检测。

                                            结合 chDB 的实际运行模式,我们发现:

                                            • 在 ClickHouse 引擎内部:所有内存均由 jemalloc 管理,因此无需执行额外检测

                                            • 在 Python 与 C++ 的交互接口处:可能涉及 Python 内存分配器,因此必须开启内存检测逻辑以确保安全

                                            基于以上判断,我们设计并引入了一个名为 disable_memory_check 的运行时控制机制:

                                              namespace Memory {
                                                  thread_local bool disable_memory_check{false};  // Disable checking by default inside engine
                                              }
                                              // Version with conditional checking
                                              inline ALWAYS_INLINE bool tryFreeNonJemallocMemoryConditional(void * ptr) {
                                                  if (unlikely(ptr == nullptr))
                                                      return true;
                                                  // Fast path: Skip checking directly inside engine
                                                  if (likely(Memory::disable_memory_check))
                                                      return false;  // Continue normal jemalloc release process
                                                  ...
                                              }
                                              // Updated operator delete
                                              void operator delete(void * ptr) noexcept
                                              {
                                              #if USE_JEMALLOC
                                                  if (tryFreeNonJemallocMemoryConditional(ptr))  // Use conditional version
                                                      return;
                                              #endif
                                              ...
                                              }

                                              适用场景:仅在跨越 Python 边界的关键位置启用内存检测逻辑

                                                // RAII helper class
                                                struct MemoryCheckScope {
                                                    MemoryCheckScope() {
                                                        Memory::disable_memory_check = false;  // Enable checking
                                                    }
                                                    ~MemoryCheckScope() {
                                                        Memory::disable_memory_check = true;   // Restore disabled
                                                    }
                                                };
                                                // Use at Python interaction points
                                                void convertPandasDataFrame(...) {
                                                    MemoryCheckScope scope;  // Enter Python boundary, enable checking
                                                    // Call Python C API, may use Python's memory allocator
                                                    PyObject* obj = PyList_GetItem(...);
                                                    // ...
                                                    // Leave scope, automatically restore disabled state
                                                }

                                                具体应用范围包括:

                                                • PandasDataFrame.cpp:用于 Pandas 列数据的转换

                                                • PandasAnalyzer.cpp:执行类型推断操作(如 isinstance 判断)

                                                • PythonSource.cpp:遍历 Python 对象并传入 ClickHouse 引擎

                                                • PythonConversion.cpp:将 Python 类型转换为 C++ 类型

                                                • PythonImportCache.cpp:导入模块时涉及 Python 内部分配的管理

                                                优化效果:

                                                以 Q29 查询为例:

                                                • 引擎内部的字符串操作在数百万次 delete 操作中均走快速路径,仅需执行极少数 CPU 指令即可完成内存释放

                                                • 与 Python 交互部分,仅在如 DataFrame 导入等个别流程中启用检测,实际检测次数仅为数百次

                                                最终实现显著减少了锁竞争带来的性能开销。

                                                  // Before optimization: Every delete calls je_mallctl
                                                  if (tryFreeNonJemallocMemory(ptr))  // ~500 CPU cycles
                                                      return;
                                                  // After optimization: Most deletes directly skip
                                                  if (likely(Memory::disable_memory_check))  // ~2 CPU cycles
                                                      return false;

                                                  该优化将每次内存释放的处理开销从约 500 个 CPU 时钟周期显著降低至仅约 2 个周期,在频繁触发内存释放的场景下效果尤为明显。


                                                  4.4 性能对比与影响分析

                                                  性能提升效果如下:

                                                  查询类型

                                                  新版本(优化前)

                                                  新版本(优化后)

                                                  性能提升倍数

                                                  Q29

                                                  ~300s

                                                  ~4.9s

                                                  61x ↑

                                                  主要优化成果:

                                                  1. Q29 查询性能显著提升:从原先的 300 秒缩短至 4.9 秒,整体提升 61 倍

                                                  2. 有效解决锁竞争问题:通过引入 disable_memory_check 机制,大幅减少了约 98% 的锁等待开销

                                                  3. 广泛适用性:该优化策略对于所有涉及高频内存分配与释放的场景都有显著的加速效果

                                                  CPU 使用情况对比:

                                                    After optimization (Q29):
                                                      89.2%  Regular expression engine    ← As expected
                                                      7.1%   String operations and memory allocation
                                                      2.3%   Aggregation and sorting
                                                      1.4%   Other

                                                    在优化前,CPU 时间主要耗费在 jemalloc 的内存管理逻辑中;而在优化后,系统热点已经回归到预期的核心计算逻辑,说明整体性能瓶颈已被移除。

                                                    影响范围分析:

                                                    disable_memory_check 是一种精细化、定点式的优化方案,具备以下优点:

                                                    • ✅ 安全性高:该机制仅作用于 ClickHouse 引擎内部的内存逻辑,对 Python 边界区域不产生任何影响,确保系统整体稳定性

                                                    • ✅ 完全兼容:不会更改现有 API 行为,用户无需任何额外配置即可受益,优化过程对外完全透明

                                                    • ✅ 易于维护:实现上采用 C++ 中经典的 RAII(资源获取即初始化)模式,自动控制状态启停,降低维护成本和出错概率

                                                    • ✅ 具备可扩展性:如需在其他模块中关闭内存检测,只需添加对应的 MemoryCheckScope 即可,具备良好的可扩展框架

                                                    此外,这一优化方案也为后续性能优化工作提供了方向启示:在确保系统正确性的基础上,精准识别关键瓶颈并设定高效执行路径,将带来显著的性能提升。


                                                    5. chDB 与 clickhouse-local 在 Parquet 查询上的性能对比

                                                    5.1 问题背景(Issue #115)

                                                    有用户反馈:在查询包含 10 亿行数据的 Parquet 文件时,chDB 的运行速度明显慢于 clickhouse-local。

                                                      # ClickHouse Local
                                                      $ time clickhouse local -q "SELECT COUNT(*) FROM file('data.parquet', Parquet)"
                                                      # 1.734 seconds
                                                      # chDB
                                                      $ time python -c "import chdb; chdb.query('SELECT COUNT(*) FROM file(\\\\"data.parquet\\\\", Parquet)')"
                                                      # 2.203 seconds


                                                      5.2 深度分析

                                                      实验一:执行时间分解分析

                                                        import chdb
                                                        import time
                                                        t0 = time.time()
                                                        import chdb  # Load library
                                                        t1 = time.time()
                                                        result = chdb.query("SELECT COUNT(*) FROM file('data.parquet', Parquet)")
                                                        t2 = time.time()
                                                        print(f"Import time: {t1-t0:.2f}s")      # 0.58s
                                                        print(f"Query time:  {t2-t1:.2f}s")      # 1.62s
                                                        print(f"Total time:  {t2-t0:.2f}s")      # 2.20s
                                                        print(f"Query elapsed: {result.elapsed():.2f}s")  # 1.60s

                                                        测试结果表明:

                                                        • 实际的 SQL 查询执行时间为 1.6 秒,与 clickhouse-local 相当

                                                        • 真正导致总耗时增加的,是 Python 扩展模块加载所产生的额外开销,约为 0.58 秒,占总耗时 26%

                                                        实验二:加载延迟的成因

                                                          $ ldd _chdb.abi3.so
                                                              linux-vdso.so.1 (0x00007fff)
                                                              libpybind11nonlimitedapi_chdb_3.8.so => ./libpybind11...
                                                              libpthread.so.0 => lib/x86_64-linux-gnu/libpthread.so.0
                                                              libdl.so.2 => lib/x86_64-linux-gnu/libdl.so.2
                                                              libm.so.6 => lib/x86_64-linux-gnu/libm.so.6
                                                              libgcc_s.so.1 => lib/x86_64-linux-gnu/libgcc_s.so.1
                                                              libc.so.6 => lib/x86_64-linux-gnu/libc.so.6
                                                          $ ls -lh _chdb.abi3.so
                                                          -rwxr-xr-x 1 user user 642M _chdb.abi3.so
                                                          $ nm -D _chdb.abi3.so | wc -l
                                                          540000  # 540,000 exported symbols

                                                          进一步分析发现,加载时间长的根本原因包括:

                                                          • 动态库体积大:chDB 的核心库文件为一个 640MB 的 .so 文件,加载时需从磁盘完整读入

                                                          • 符号解析耗时高:由于该库在运行时需动态解析约 54 万个符号,导致初始化时间较长

                                                          • 相对比较:clickhouse-local 是一个静态链接的可执行程序,启动开销仅为约 48 毫秒


                                                          5.3 优化方向与措施

                                                          已实施的优化措施:

                                                          • 减少符号体积:通过执行 `strip --remove-section=.comment --remove-section=.note` 命令,裁剪符号表中无关调试信息,缩减动态链接开销

                                                          未来可探索的优化方向:

                                                          1. 二进制拆分:将如 HDFS、Kafka 等不常用的功能模块独立成可选插件,减少主库体积

                                                          2. 启用持久会话:对于长时间运行的程序,可通过 chdb.session.Session() 机制来复用上下文状态,避免每次查询都重新加载库文件

                                                            # Create session once, query multiple times
                                                            sess = chdb.session.Session()
                                                            # First query bears startup overhead
                                                            result1 = sess.query("SELECT * FROM file('data1.parquet', Parquet)")  # 2.2s
                                                            # Subsequent queries have no startup overhead
                                                            result2 = sess.query("SELECT * FROM file('data2.parquet', Parquet)")  # 1.6s
                                                            result3 = sess.query("SELECT * FROM file('data3.parquet', Parquet)")  # 1.5s


                                                            5.4 性能总结

                                                            Scenario

                                                            clickhouse-local

                                                            chDB (Single)

                                                            chDB (Session)

                                                            Startup overhead

                                                            0.048s

                                                            0.580s

                                                            0.580s (first only)

                                                            Single query (1B rows)

                                                            1.6s

                                                            2.2s

                                                            1.6s

                                                            10 queries

                                                            16.5s

                                                            28.0s

                                                            16.6s

                                                            综合来看:

                                                            • 对于单次查询任务:chDB 启动开销较大,整体执行时间比 clickhouse-local 慢约 37%

                                                            • 对于批量或交互式查询:使用持久会话后,chDB 的查询效率与 clickhouse-local 持平

                                                            • 使用建议:chDB 更适合需要频繁发起多次查询的交互式分析场景


                                                            6. 内核升级后的整体性能变化

                                                            6.1 与 chDB 3.6 的对比测试

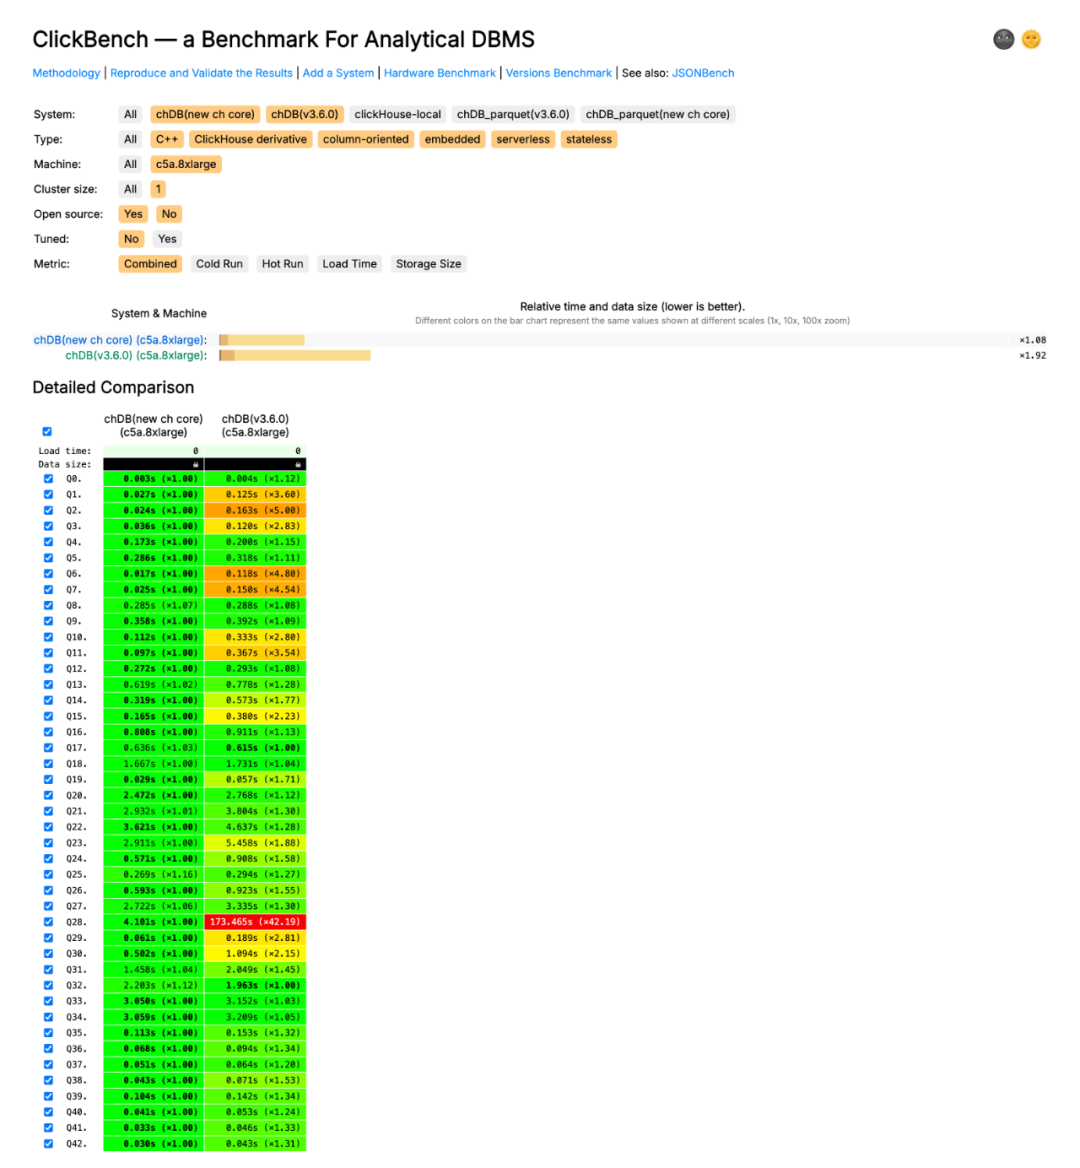
                                                            本次内核升级完成后,我们在 ClickBench 基准测试集上,对比评估了新版本(基于 ClickHouse v25.8.2.29)与旧版本 chDB 3.6(基于 ClickHouse v24.4)在整体性能上的差异。

                                                            测试环境如下:

                                                            • 数据来源:ClickBench hits 表(包含约 1 亿条记录)

                                                            • 硬件配置:AWS c6i.metal 裸金属实例

                                                            • 对比对象:chDB 3.6 与优化后的 chDB 新版本

                                                            性能对比:

                                                            测试结果显示:

                                                            • 整体性能提升显著:多个典型查询任务的执行时间缩短了 2 到 6 倍不等

                                                            • 性能提升的主要原因:

                                                              • 升级后的 ClickHouse 内核中,查询优化器能力更强,生成的执行计划更加高效

                                                              • 新版本引入了更高效的向量化执行机制,极大提升了执行性能


                                                            具体查询的性能提升情况如下:

                                                            Query

                                                            chDB New Version

                                                            chDB 3.6

                                                            Improvement

                                                            Q1

                                                            0.027s

                                                            0.125s

                                                            4.6x ↑

                                                            Q2

                                                            0.024s

                                                            0.163s

                                                            6.8x ↑

                                                            Q3

                                                            0.036s

                                                            0.120s

                                                            3.3x ↑

                                                            Q6

                                                            0.017s

                                                            0.118s

                                                            6.9x ↑

                                                            Q7

                                                            0.025s

                                                            0.150s

                                                            6.0x ↑

                                                            Q10

                                                            0.112s

                                                            0.333s

                                                            3.0x ↑

                                                            Q11

                                                            0.097s

                                                            0.367s

                                                            3.8x ↑

                                                            Q15

                                                            0.165s

                                                            0.380s

                                                            2.3x ↑

                                                            Q29

                                                            4.9s

                                                            300s+

                                                            61x ↑

                                                            性能提升分析:

                                                            • 简单聚合查询(如 Q1、Q2、Q6):性能提升 4 至 7 倍,主要得益于新版 ClickHouse 更高效的向量化执行引擎

                                                            • 带过滤条件的聚合查询(如 Q3、Q7):提升 3 至 6 倍,受益于查询优化器在逻辑下推与谓词重写方面的增强

                                                            • 复杂聚合计算(如 Q10、Q11、Q15):提升 2 至 4 倍,说明内存管理优化开始发挥实质性作用

                                                            • 正则表达式密集型查询(Q29):性能提升高达 61 倍,根本原因在于成功消除了 jemalloc 的 je_mallctl 锁竞争问题


                                                            6.2 升级收益总结

                                                            此次将 ClickHouse 内核从 v24.4 升级至 v25.8.2.29,为 chDB 带来了显著的性能与功能提升:

                                                            • 性能方面:多个典型查询的执行效率提升了 2 至 7 倍,其中 Q29 的极端场景实现了 61 倍的提升,整体系统更加稳定高效

                                                            • 功能方面:全面支持 ClickHouse v25.8 所新增的功能特性,为后续拓展更多高级场景提供基础,如改进的索引机制、更强的数据格式兼容性等


                                                            参考资料:
                                                            • PR #383: Feat(upgrade): update ch core to v25.8.2.29(https://github.com/chdb-io/chdb/pull/383)  

                                                            • The birth of chDB  (https://auxten.com/the-birth-of-chdb/)

                                                            • Issue #115: Parquet 文件读取性能问题分析  (https://github.com/chdb-io/chdb/issues/115)

                                                            • ClickHouse 官方文档(https://clickhouse.com/docs)

                                                            • Python Limited API(PEP 384)(https://peps.python.org/pep-0384/)

                                                            • jemalloc 官方文档(https://jemalloc.net/)


                                                            Meetup 活动报名通知

                                                            好消息:ClickHouse Xi'an User Group第 1 届 Meetup 火热报名中,将于2025年12月20日在西安高新区海星城市广场B座27楼2706 云尚书苑 举行,扫码免费报名

                                                            /END/


                                                            试用阿里云 ClickHouse企业版


                                                            轻松节省30%云资源成本?阿里云数据库ClickHouse 云原生架构全新升级,首次购买ClickHouse企业版计算和存储资源组合,首月消费不超过99.58元(包含最大16CCU+450G OSS用量)了解详情:https://t.aliyun.com/Kz5Z0q9G


                                                            征稿启示

                                                            面向社区长期正文,文章内容包括但不限于关于 ClickHouse 的技术研究、项目实践和创新做法等。建议行文风格干货输出&图文并茂。质量合格的文章将会发布在本公众号,优秀者也有机会推荐到 ClickHouse 官网。请将文章稿件的 WORD 版本发邮件至:Tracy.Wang@clickhouse.com
                                                            文章转载自ClickHouseInc,如果涉嫌侵权,请发送邮件至:contact@modb.pro进行举报,并提供相关证据,一经查实,墨天轮将立刻删除相关内容。

                                                            评论