与传统关系型数据库相比,大数据 SQL 计算的核心优化挑战在于数据倾斜问题。本文基于笔者在 Hive 及 SparkSQL 平台上的数据倾斜处理实战经验(其他引擎可能存在差异),聚焦于以下核心内容:
计算框架及数据倾斜简介
数据倾斜典型发生场景
数据倾斜的识别方法
数据倾斜的解决方案(参数调优、SQL 改写)
各计算引擎版本持续迭代,核心计算机制虽大体相似,但具体行为请以实际使用版本为准。
一、计算框架及数据倾斜简介
数据倾斜的本质在于任务分配不均。具体而言,当一个任务被拆分为多个子任务分发给不同执行单元处理时,若部分单元分配到的数据量远大于其他单元,就会导致处理速度失衡:数据量少的单元很快完成而闲置,数据量大的单元则需要耗费大量时间处理。在大数据计算场景中,这表现为少数任务处理的数据量远超其他任务。
大数据 SQL 计算引擎通常运行在多服务器组成的集群上。集群中的每台服务器(可类比为执行任务的“小组”)包含多个 CPU 核心(例如 128 核)。每个核心(类比为一个“工作者”)通常负责执行一个计算任务(Task)。
用户提交 SQL 作业后,引擎的 CBO(基于成本的优化器) 会生成优化后的执行计划。该计划将作业拆分为多个阶段(Stage),并依次将这些阶段分发到集群的计算节点上执行。每个阶段包含多个 Task。这些 Task 最终会分配到各个服务器 CPU 核心上执行计算。
示例sql:几个表join关联,其中包含一个groupby子查询
-- 假定如下表都是非分区表select t1.user_id,t1.field_name1,t2.field_name2,t3.field_name3,t4.field_name4from table_name1 t1left join table_name3 t2on t1.user_id=t2.user_idleft join table_name3 t3on t1.user_id=t3.user_idleft join (select openid,count(1) as field_name4from table_name4group by openid) t4on t1.openid=t4.openid
以上sql在Hive(MapReduce引擎)及SparkSQL中作业拆分如下:
咖色标记为Hive Job拆分,紫色框为SparkSQL Stage拆分
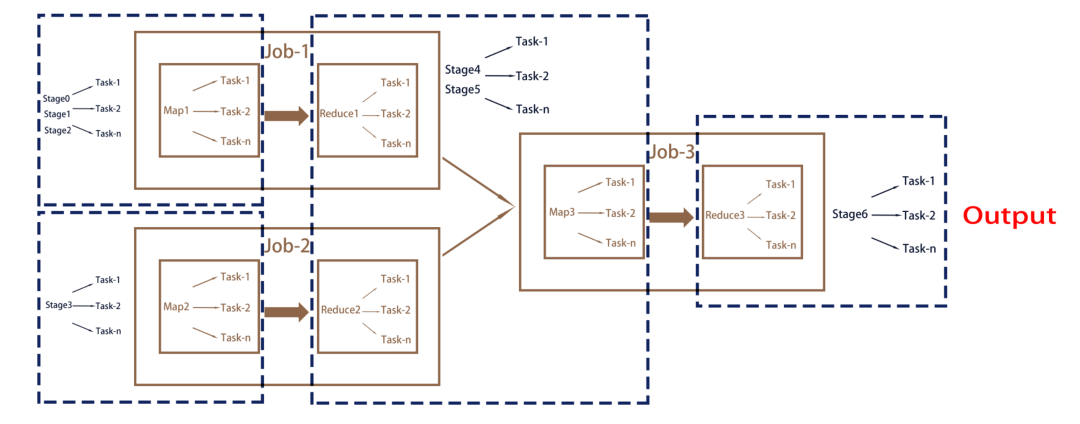
HIVE:JOB -> Map、Reduce -> Task
Job-1:完成t1、t2、t3三张表的join逻辑(一个MR,join的key都是user_id字段)。Map读取三张表的数据按照user_id排序写入临时文件。Reduce再拉取对应数据块完成join逻辑写入临时文件。
Job-2:完成table_name4的groupby逻辑。Map端按openid预聚合count(1)写磁盘,Reduce再全局聚合写磁盘。与Job-1没有依赖,并行计算。
Job-3:Map读取JOB-1和Job-2输出的数据,Reduce完成最后的Join操作。
SparkSQL:Job -> Stage -> Task(SparkSQL通常提交一条sql生成一个job)
stage0-stage2:分别读取t1、t2、t3的数据分区写磁盘(ShuffleWrite)。
stage3:读取table_name4的数据分区写磁盘(ShuffleWrite)。
stage4:在完成Job-1的Reduce逻辑后同时完成Job-3的Map逻辑然后写磁盘
(ShuffleRead + reduce计算 + ShuffleWrite),Hive在这里多了一步写磁盘。
stage5:在完成Job-2的Reduce逻辑后同时完成Job-3的Map逻辑然后写磁盘
stage6:完成最终的join关联然后Output输出文件。
HIVE不同Job之间如果没有依赖关系,可以并行计算。同一个Map或者Reudce中,不同的task并行计算。具体并行度取决于集群的资源分配。Hive可以通过hive.exec.parallel=true开启job并行,
通过set hive.exec.parallel.thread.number=16设置并发数(这里是16个)
SparkSQL遇到宽依赖(对应于Hive中的reduce)则新划分一个stage,同个stage中不同的task可以并行执行。
SparkSQL除了最后一个stage文件output输出没有ShuffleWrite外(ResultStage),其余都是ShuffleMapStage,会发生数据混洗;从多个stage角度来讲,假设一个作业依赖是:stage1 -> stage2 -> stage3,其中,stage1是stage2的ShuffleMapStage,stage2是stage1的reduce,stage2同时是stage3的ShuffleMapStage;
在涉及 reduce 阶段的计算中,map 阶段会生成键值对(key-value 对)。其中:
key 通常是等值 JOIN 条件字段、GROUP BY 维度字段或窗口函数 PARTITION BY 字段(如上例中的 user_id, openid)。
value 则包含该 key 对应记录行的相关数据。
随后,相同 key 的数据会被分发到同一个 reduce 节点进行计算。因此,排查数据倾斜问题的关键点通常是:是否存在少量特定 key 对应的数据量过大。
二、数据倾斜发生在哪里
数据倾斜主要发生在作业的两个阶段:Map 阶段 和 Reduce 阶段。
Map 阶段倾斜 (相对罕见)
主要原因: 读取不可分割的大文件(如某些压缩格式)。某个文件过大导致处理它的 Map Task 耗时远超其他 Map Task。
现状: 当前主流 HDFS 表多采用可分割的 ORC 等格式存储,此场景已极少发生。
Map 耗时长的其他常见原因 (非典型倾斜):
性能低下的自定义函数 (UDF): 在 Map 阶段执行的 UDF 效率低下。
数据膨胀: 执行多维聚合(维度组合爆炸)或包含大量 COUNT(DISTINCT) 操作,导致 Map 输出数据量远超输入。
Reduce 阶段倾斜 (最常见)
触发 Reduce 的操作: 以下 SQL 操作通常会引入 Reduce 阶段,是数据倾斜的高发区:
Join 操作(非 MapJoin Broadcast Join)
Group By 聚合
开窗函数 (Window Functions):例如 ROW_NUMBER() OVER (PARTITION BY ...), SUM() OVER (PARTITION BY ...) 等。
特殊场景:全局排序 (Order By)
使用 ORDER BY ... 进行全局排序时,所有数据最终会被发送到单个(或极少数)Reduce Task 进行排序。
典型问题示例: 执行 SELECT ... FROM ... ORDER BY column LIMIT N; (获取全局 Top N) 时,虽然最终只需 N 条结果,但排序过程仍需将所有数据集中到一个 Task 处理,极易引发严重倾斜。
select user_id,paymentfrom user_paymentorder by payment desclimit 10 -- 取top 10
三、 怎么辨别数据倾斜
HIVE倾斜:可通过日志或者yarn后台查看。如果执行日志reduce长时间卡主在进度99%则大概率是倾斜了(下截图来自百度图片)。
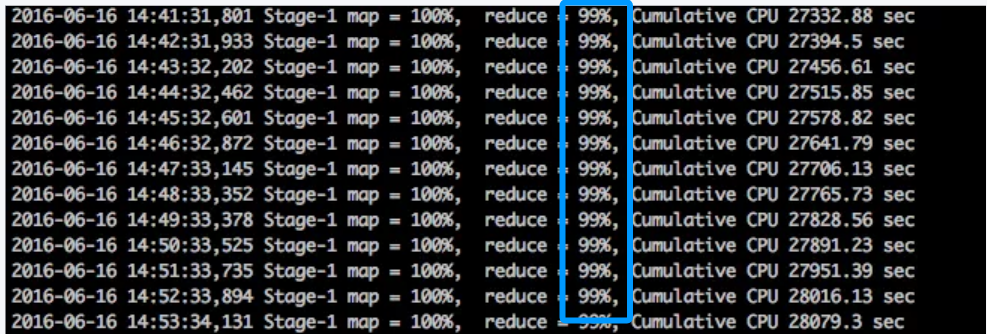
有一种特殊情况也会导致卡99%:数据体量大且数据计算逻辑复杂,比如在数据体量比较大的前提下进行笛卡尔join。
这时候可以通过点击日志中的Tracking url跳转到yarn后台,点开reduce看各个task耗时是否均衡。
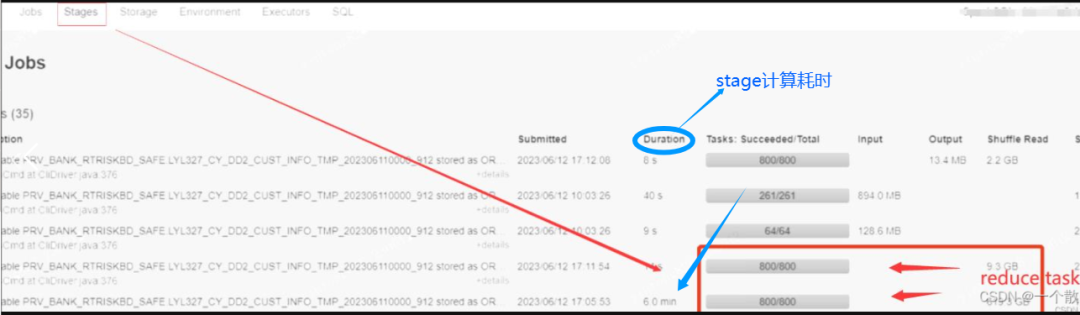
SparkSQL倾斜:可以通过SparkUI查看,先看哪个stage耗时长,然后点开长耗时的stage看其中各个task耗时有无倾斜(新版本的UI执行计划SQL页面耗时统计数据):
四、数据倾斜解决方案
数据倾斜解放方案主要有两种:
1. 剔除倾斜的记录行:比如这些数据是不必要的脏数据,null比较常见。
2. 倾斜数据打散均衡:可以通过参数配置或者改写SQL实现。
倾斜key抽样定位:
在SparkSQL中我们可以通过df.sample(n)
抽样,再对key进行分组计数,按计数降序排列找出倾斜key。
from pyspark.sql import functions as F(spark_df.sample(200000) # 抽样200,000行.groupBy("user_id") # 按用户分组.count() # 统计记录数.orderBy(F.desc("count")) # 降序排列.limit(10) # 取前10行.show())
sql抽样如下:
-- 抽样select field_key,count(1) as cntfrom table_namewhere rand() < 0.01 -- 根据实际数据量,抽样group by field_keyhaving count(1) > 10000 -- 根据业务实际情况,筛选大keyorder by cnt desc -- 按数据量进行排序limit 20 -- 查看数据量最多的20个key
特殊情况:在表join关联时,如果疑似倾斜,我们可能会挨个表去抽样。比如下面的sql第二个mr运行时间很长(t2表跟t3表join),我们会分别查看t2表和t3表的mobile_no字段有无倾斜key,但我们最后发现两个表都不存在哪个mobile记录行很多,有的同学就迷糊了。
这个倾斜的mr是t1跟t2join的结果再跟t3表进行join。t1表跟t2表进行join如果t2表有大量user_id关联不上会怎样?是不结果会出现大量null的mobile_no。
select t1.user_id,t1.field_name1,t2.field_name2,t3.field_name3from table_name1 t1left join table_name2 t2on t1.user_id=t2.user_idleft join table_name3 t3on t2.mobile_no=t3.mobile_no
剔除倾斜记录行
假设如下sql中,t1表存在大量null:
select t1.user_id,t1.field_name1,t2.field_name2from table_name1 t1left join table_name2 t2on t1.user_id=t2.user_id
我们则可以直接将left join改写为join(如果是groupby直接在where里剔除)
select t1.user_id,t1.field_name1,t2.field_name2from table_name1 t1join table_name2 t2on t1.user_id=t2.user_id-- 如果是join内连接,该where句可不加,计算引擎优化会自动过滤。-- where t1.user_id is not null
倾斜参数优化:
hive join倾斜参数:
hive.optimize.skewjoin:默认值是false,表示是否优化有倾斜键的表连接。如果为true, Hive将为连接中的表的倾斜键创建单独的计划。
hive.skewjoin.key:默认值为100000。如果在进行表连接时,相同键的行数多于该配置所指定的值,则认为该键是倾斜连接键。
hive.skewjoin.mapjoin.map.tasks:默认值为10000。倾斜连接键,在做MapJoin 的Map任务个数。需要与hive.skewjoin.mapjoin.min.split一起使用。
hive.skewjoin.mapjoin.min.split:默认值为33554432,即32MB。指定每个split块最小值,该值用于控制倾斜连接的Map任务个数。
此外,如果是大表join小表,则可以通过mapjoin优化倾斜,配置参数如下:
hive.auto.convert.join:在Hive 0.11版本以后,默认值为true,表示是否根据文件大小将普通的repartition连接将化为Map的连接。
hive.smalltable.filesize/hive.mapjoin.smalltable.filesize:默认值为25000000(bytes)。两个配置表示的含义都是当小表的数据小于该配置指定的阀值时,将尝试使用普通repartition连接转化Map连接。该配置需要和hive.auto.convert.join配合使用。
hive groupby倾斜参数:
set hive.map.aggr:true 开启map端聚合
set hive.groupby.mapaggr.checkinterval:map端聚合数据条数,如果map数据量超过该该记录数,会按记录数拆分新增task处。一般设置为100000
set hive.groupby.skewindata:true开启该参数,HIVE会生成的查询计划会有两个 MapReduce Job。该参数不适用于groupby+countdistinct去重计数
第一个 MapReduce Job 中,Map 的输出结果集合会随机分布到 Reduce 中,每个Reduce 做部分聚合操作并输出结果。相同的 GroupBy Key 有可能被分布到不同的 Reduce 中,负载均衡;
第二个 MapReduce Job 再根据预处理的数据结果,按照 GroupBy Key 分布到 Reduce 中(这过程可以保证相同的GroupBy Key被分布到同一个Reduce中),最后完成最终的聚合操作
倾斜SQL优化:
join倾斜-大表join小表:
在sql语句中添加mapjoin的hint(/*+mapjoin(t2)*/),将reduce倾斜压力均衡到map端计算,mapjoin该hint需置于select语句最前面。
需注意:mapjoin不适用于full join,left join或者right join小表是主表的情况。
-- hive命令可能被禁用,这里开启set hive.ignore.mapjoin.hint=false;select /*+mapjoin(t2)*/ t2.product_type,sum(t1.salses) as sum_salefrom sales_table t1join dim_product_info t2on t1.product_id = t2.product_idgroup by t2.product_type
join倾斜-大表join大表:
场景一:固定倾斜key,倾斜key join关联不上,可以将key单独拿出来处理,比如下面的sql:
select t1.field1,t1.mobile_no,t2.field2from table_a t1left join table_b t2on t1.mobile_no=t2.mobile_no
如果t1.mobile_no存在null倾斜,可考虑如下改写:
select t1.fields,t1.mobile_no,t2.field2from table_a t1left join table_b t2on t1.mobile_no=t2.mobile_nowhere t1.mobile_no is not null -- 筛选非空union allselect t1.fields,null as mobile,null as field2from table_a -- 因为null关联不上,此处省略join步骤where mobile_no is null
也可以这样:
select t1.field1,t1.mobile_no,t2.field2from table_a t1left join table_b t2-- 引入随机数打散null-keyon nvl(t1.mobile_no,rand())=t2.mobile_no-- 如果table_b的mobile_no有缺失的话,过滤掉,一般不加null过滤-- 执行计划也会加上该filter操作;and t2.mobile_no is not null
如果条件允许,可以考虑把join两个表非倾斜的数据拆出来进行join,然后把倾斜key的数据单独取出来进行mapjoin。最后两个job再union all起来。
场景二:倾斜key能关联上,且无小表不可走mapjoin,大表添加随机数n种,相较小表数据膨胀n倍。
优化样例-拆分:
select a.id,a.field_a,b.field_bfrom( -- 加入随机数select id,field_a,ceiling(rand()*10) as rnd_namefrom table_awhere id in ('倾斜健')) ajoin( -- 数据膨胀select id,subview.rnd_name,field_bfrom table_b blateral view explode(array(1,2,3,4,5,6,7,8,9,10)) subview as rnd_namewhere b.id in ('倾斜健')) bon a.id=b.id and a.rnd_name=b.rnd_nameunion all -- 拼接非倾斜部分的joinselect a.id,a.field_a,b.field_bfrom table_a ajoin table_b bon a.id=b.idwhere a.id not in ('倾斜健') and b.id not in ('倾斜健')
使用添加随机数+数据膨胀这种方法,一定程度上解决了数据倾斜,但数据膨胀增加了shuffle数据量,增加了磁盘io,排序计算,网络传输开销;膨胀的倍数不宜过大,这里要根据实际情况权衡;
如果明确倾斜键,大表join大表,也可以针对指定倾斜键打散:
select a.id,a.field_a,b.field_bfrom( -- 加入随机数select id,field_a,case when id in ('倾斜健') then ceiling(rand()*10) else 0 end as rnd_namefrom table_a) ajoin( -- 数据膨胀select id,subview.rnd_name,field_bfrom table_b blateral view explode(case when id in ('倾斜健') then array(0,1,2,3,4,5,6,7,8,9,10)else array(0) end) subview as rnd_namewhere b.id in ('倾斜健')) bon a.id=b.id and a.rnd_name=b.rnd_name
场景三:多表join的特殊情况
有如下一段sql,我们从日志里发现了倾斜
select a.filed_aa,c.field_cc,count(b.id) as cntfrom table_a ajoin table_b bon a.field_b=b.field_bjoin table_c con a.field_c=c.field_cgroup by a.filed_aa,c.field_cc
该sql,三个表都是大表,表a和表c数据量1个亿+,表b数据量100亿+,通过统计key的分布,我们发现倾斜出在表b上,表b的field_b分布极为不均衡;这类情况mapjoin不合适,都是大表;也不完全一定要按打散b表的field_b字段,膨胀a表field_a字段处理;如果b表的field_b字段先groupby聚合能解决这个倾斜问题,那么逻辑可以这样改写:
select a.filed_aa,c.field_cc,sum(b.cnt) as cntfrom table_a ajoin ( select field_b,count(1) as cnt from table_b group by field_b) b -- 如果聚合后解决了field_b倾斜问题on a.field_b=b.field_bjoin table_c con a.field_c=c.field_cgroup by a.filed_aa,c.field_cc
此类优化方案还是要视具体情况分析
groupby倾斜:
groupby有map预聚合的机制在,诸如sum、min、max等计算函数处理起来都很快。像下面这种针对groupby字段添加随机数打散优化的情况很少见:
select groupby_field,sum(cnt) as cnt -- 全局聚合from( -- key打散聚合select ceiling(rand() * 10) as rnd -- 添加随机数打散,groupby_field -- 分组字段,count(1) as cntfrom table_namegroup by ceiling(rand() * 10),groupby_field) tgroup by groupby_field
groupby倾斜多出现于groupby+countdistinct。因为去重计数在map预聚合时,一个key对应的value无法直接聚合成一条数据(因为要全局去重计数)。一般处理是将groupby+countdistinct做两个mr改写,比如如下原sql:
select typename,count(distinct user_id) as user_cntfrom tablename1group by typename
改写为:
select typename,count(1) as cntfrom(select typename,user_idfrom tablename1group by typename,user_id) tgroup by typename
某些计算引擎可能会对sql做优化,比如在sparksql中执行以上原sql,实际执行就是下方优化后的语句。
是不是所有groupby去重计数存在倾斜都要按照上面这种写法改成两个mr?
不是的,如果去重计数的字段枚举值很少,经过map端聚合后,流向reduce的数据量也很少,无须做两个mr改写。
比如从商品维表里查看各个部门在售商品大类数(我们假定商品维表2亿+,其中A部门商品id 1亿+倾斜,但商品大类最多不超过20种)
-- 直接提交即可,无需改写select department_name,count(distinct goods_type) as type_cntfrom dim_goodsgroup by department_name
同一个字段不同条件多个countdistinct解决方案:
如果分组聚合后是对同一个字段进行去重计数只是条件不同时,每个countdistinct数据会膨胀一倍,为减少数据量,可以考虑如下改写方案:
原sql:20个countdistinct,数据膨胀20倍。
select group_field,count(distinct case when flag1=1 then userid end) as dis1,count(distinct case when flag2=1 then userid end) as dis2-- ,..... 此处省略若干字段,总共20个去重计数字段,count(distinct case when flagn=1 then userid end) as disnfrom db_table_namegroup by group_field
优化后的sql:数据只膨胀2倍(后续计算引擎可能会优化,在hive2和sparksql2版本里当前执行计划如上膨胀20倍)
select group_field,count(case when flag1=1 then userid end) as dis1,count(case when flag2=1 then userid end) as dis2-- ,..... 此处省略若干字段,count(case when flagn=1 then userid end) as disnfrom(select group_field,userid,max(flag1) as flag1,max(flag2) as flag2,...,max(flagn) as flagnfrom db_table_namegroup by group_field,userid) tgroup by group_field
全局排序-取topn
如果数据量很大,orderby会把所有数据记录行全扔到一个reduce里进行排序,耗时极长。
原sql如下:
select user_id,paymentfrom tablename t1order by payment desclimit 10
优化方案如下:
将数据打散成n个分区,然后每个分区里进行排序取topn,最后再取各个分区的topn进行全局topn排序。
优化sql如下:
select user_id,paymentfrom( -- 局部排序select user_id,payment,row_number() over(partition by ceil(rand()*20)order by payment desc) as rnkfrom tablename t1) twhere rnk<=10 -- 每个分区取top 10order by payment desclimit 10select user_id
全局排序
假设我们有一个表,表名:tablename1,数据有100亿行,按字段p进行row_number全局排序,这时候我们可以这样处理,先求出字段p归一化的对应的值,pn归一化转化公式为:pn-min(p字段)/(max(p字段)-min(p字段);归一化后的值在0-1之间
这里可以先计算出字段的最大值,最小值,将得到的结果表mapjoin到明细表;假设这个字段命名为p1
with t1 as(select id,p1,ceil(p1*1000) as sub_level,row_number() over(partition by ceil(p1*1000) order by p1) as sub_orderfrom table_source),t2 as (-- 获取每个分桶的起始排序(使用sum over累加计算得出的当前分桶与比他小的分桶累计了多少条记录)select sub_level,(sum(cnt) over(order by sub_level) - cnt) as base_orderfrom(-- 获取每个分桶的数量select sub_level,count(1) as cntfrom t1group by sub_level) t)-- 起始排序 + 组内排序就是全局排序select id,p1,base_order + sub_order as global_order -- 全局排序字段from t1left join t2 on t1.sub_level = t2.sub_level
该方式将p值数据打散成1000份,分到1000个reduce里,每个reduce内做局部排序,最后再全排;这样能避免100亿行数据分到1个task里;如果切片后数据存在倾斜,可以将切片数再设置大点,亦或看下切片总记录行,使用case when手工做下切片调整,把倾斜的key使用随机数再打散;
假设将p值切成了5个分片,计算结果如下:
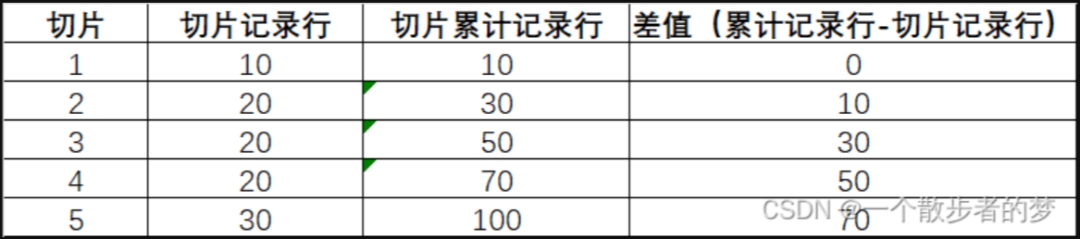
这时,如果一条记录p2在切片2上,在切片2的局部排序是14,那p2的全局排序是差值+局部排序=10+14=24
部分内容整理自本人原博客“SparkSQL优化”-一个散步者的梦