



个人微信ID:cqhg_bigdata,加我备注来意送你一份【OPPO】基于Apache Flink SQL构建实时数仓手册
一、项目背景与业务挑战
1.1 真实业务场景
我们服务的某头部汽车制造商,其智能网联平台已接入超过120万辆智能汽车,每辆车每天产生约5-10MB的实时数据,涵盖车辆状态、驾驶行为、传感器读数、故障码等15类数据。每日原始数据量达6TB,峰值QPS超过50万。
1.2 核心业务需求
二、架构设计与技术选型
2.1 整体架构图
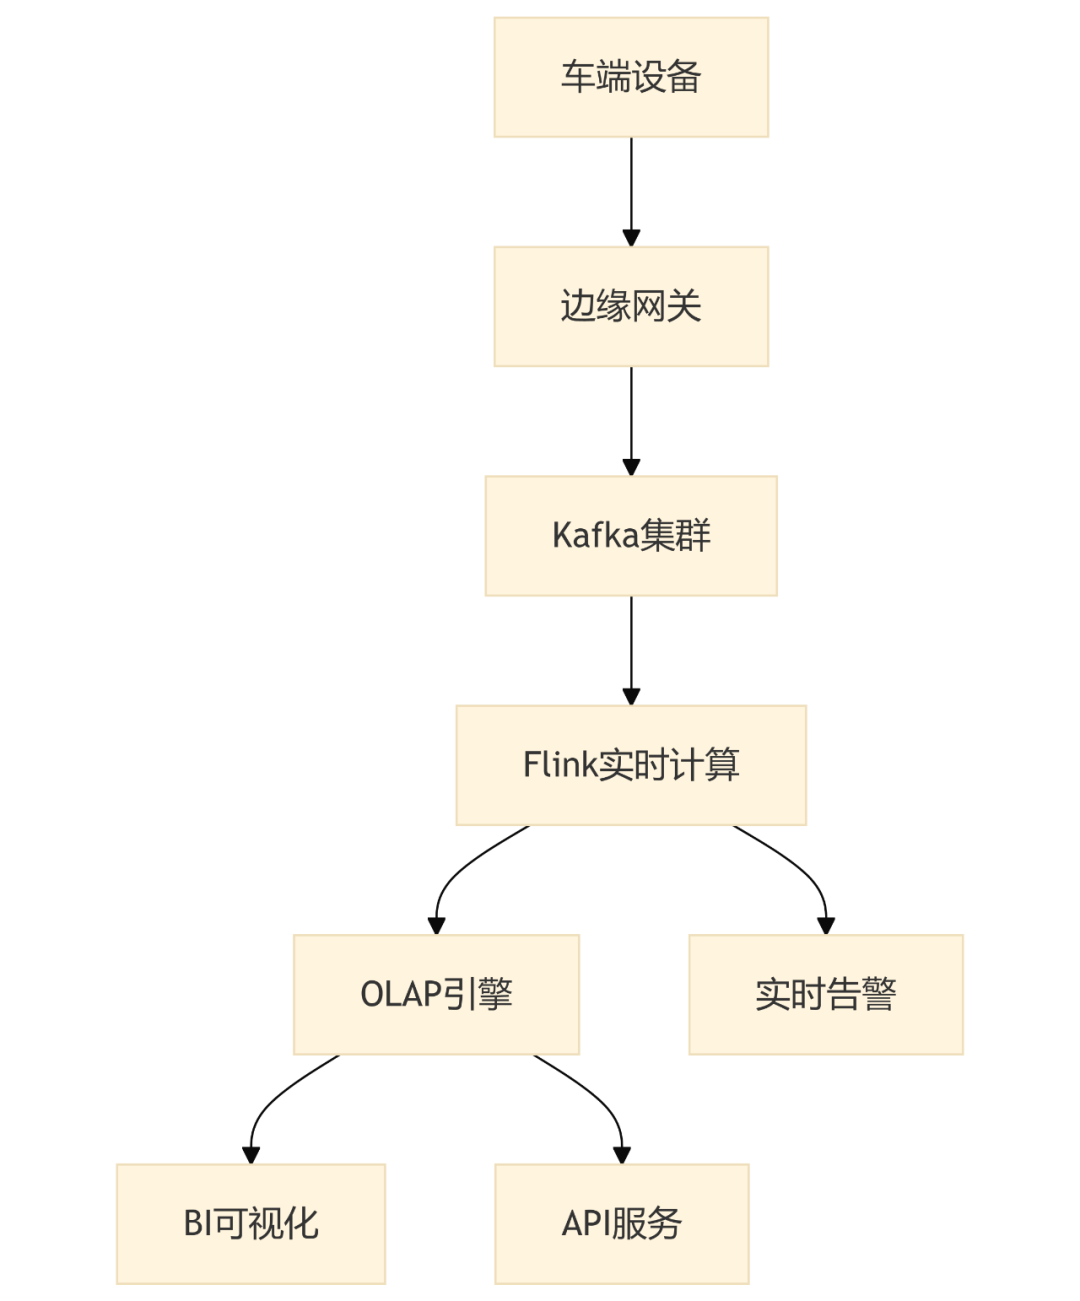
2.2 技术栈深度选型对比
2.3 数据流向架构
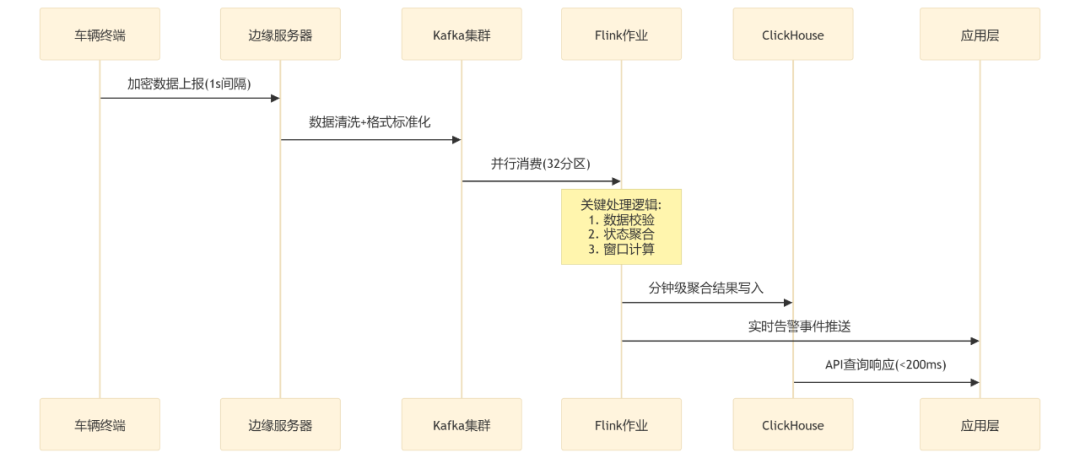
三、核心实现细节
3.1 数据模型设计
原始数据Topic分区策略
// 基于VIN码后4位进行分区,确保同一车辆数据有序性
String vin = "LGWEF2A51NL123456";
int partition = Math.abs(vin.substring(vin.length() - 4).hashCode()) % 32;

// 实际分区配置
properties.put("partitioner.class",
   "com.auto.iot.partitioner.VINPartitioner");
分层数据仓库设计
原始层(ODS)
  ├── vehicle_raw (原始JSON数据, 保留7天)
  └── vehicle_parsed (解析后结构数据)

聚合层(DWD)
  ├── vehicle_status_5s (5秒聚合状态)
  ├── driving_behavior_1min (驾驶行为分钟聚合)
  └── battery_stats_10min (电池统计)

应用层(ADS)
  ├── realtime_alerts (实时告警表)
  ├── driver_profile (驾驶员画像)
  └── fleet_monitoring (车队监控看板)
3.2 Flink关键作业实现
状态管理与容错配置
StreamExecutionEnvironment env = StreamExecutionEnvironment
    .getExecutionEnvironment();

// 开启Checkpoint,每30s一次
env.enableCheckpointing(30000);
env.getCheckpointConfig().setCheckpointingMode(CheckpointingMode.EXACTLY_ONCE);
env.getCheckpointConfig().setMinPauseBetweenCheckpoints(5000);
env.getCheckpointConfig().setTolerableCheckpointFailureNumber(3);

// RocksDB状态后端,应对大状态场景
env.setStateBackend(new EmbeddedRocksDBStateBackend());
env.getCheckpointConfig().setCheckpointStorage(
    "hdfs://nameservice/flink/checkpoints");
驾驶行为识别关键逻辑
-- Flink SQL实现急刹车检测
CREATE VIEW sudden_braking_events AS
SELECT
    vin,
    window_start,
    window_end,
    COUNT(*) as event_count,
    AVG(deceleration) as avg_deceleration
FROM TABLE(
    TUMBLE(
        TABLE vehicle_status,
        DESCRIPT OR(event_time),
        INTERVAL '10' SECONDS
    )
)
WHERE speed > 30
AND deceleration > 3.5-- 减速度超过3.5m/s²
GROUP BY vin, window_start, window_end
HAVING COUNT(*) >= 2;  -- 10秒内发生2次以上
3.3 性能优化实战
Kafka消费者调优
# flink-consumer-config.yaml
consumer:
bootstrap.servers:"kafka-01:9092,kafka-02:9092"
group.id:"vehicle-realtime-group"
auto.offset.reset:"latest"
enable.auto.commit:false# 由Flink管理offset
fetch.min.bytes:65536     # 减少fetch次数
fetch.max.wait.ms:100
max.partition.fetch.bytes:1048576
max.poll.records:2000
内存管理配置
// TaskManager内存配置(32GB服务器)
taskmanager.memory.process.size: 28672m
taskmanager.memory.managed.size: 12288m
taskmanager.numberOfTaskSlots: 4

// 网络缓冲区优化
taskmanager.memory.network.min: 128mb
taskmanager.memory.network.max: 512mb
四、监控与可观测性体系
4.1 关键监控指标看板
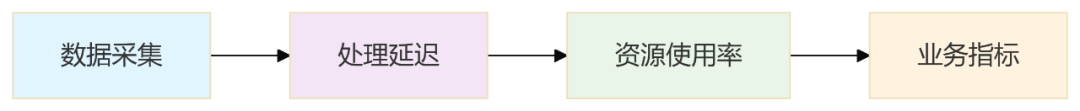
实际监控面板指标
4.2 告警规则配置示例
# prometheus-rules.yaml
groups:
-name:flink-job-alerts
    rules:
      -alert:HighRestartRate
        expr:rate(flink_job_numRestarts[5m])>0.1
        for:5m
        labels:
          severity:warning
        annotations:
          summary:"Flink作业频繁重启"

      -alert:CheckpointFailure
        expr:flink_job_lastCheckpointDuration>300000
        for:2m
        labels:
          severity:critical
五、真实案例分析
5.1 案例:电池热失控预警
问题背景
2023年夏季高温期间,某批次车辆电池温度异常率上升0.3%
解决方案
-- 多指标关联预警
WITH battery_anomalies AS (
    SELECT
        vin,
        battery_id,
        temperature,
        voltage,
        timestamp,
        CASE
            WHEN temperature > 45 AND voltage_drop > 0.15
            THEN'CRITICAL'
            WHEN temperature > 40 AND SOC < 0.2
            THEN 'WARNING'
        END as alert_level
    FROM battery_realtime
    WHERE temperature IS NOT NULL
      AND timestamp >= NOW() - INTERVAL '1' HOUR
)
SELECT
    vin,
    battery_id,
    alert_level,
    COUNT(*) as anomaly_count
FROM battery_anomalies
WHERE alert_level IS NOT NULL
GROUP BY vin, battery_id, alert_level
HAVING COUNT(*) >= 3;
实施效果
5.2 业务价值量化
六、踩坑经验与反思
6.1 关键问题与解决方案
问题1:数据倾斜导致背压
现象:少数热门车辆(测试车辆)数据量是普通车辆的1000倍+解决方案:
// 采用两级分组策略
DataStream<VehicleData> processed = source
    .keyBy(data -> data.getVin().hashCode() % 100)  // 预分组
    .process(new PreAggregateFunction())
    .keyBy(data -> data.getCityCode())  // 业务分组
    .window(TumblingEventTimeWindows.of(Time.seconds(10)))
    .aggregate(new BusinessAggregate());
问题2:Checkpoint超时
根因:大状态(500GB+)导致Checkpoint写入HDFS超时优化措施:
启用增量Checkpoint 调整Checkpoint间隔从1min到3min 使用本地SSD作为临时存储
问题3:Exactly-Once语义的代价
发现:端到端的Exactly-Once导致15%的性能损失权衡决策:对告警类业务使用Exactly-Once,对统计类业务使用At-Least-Once
6.2 性能基准测试结果
七、具体实施建议
7.1 部署架构建议
生产环境最小规模:
├── Kafka集群:6节点(16核64GB,3TB SSD)
├── Flink集群:8 TaskManager(32核128GB)
├── ClickHouse:3分片2副本(24核256GB)
└── Zookeeper:3节点(8核16GB)
7.2 开发规范
状态管理:定期清理TTL状态,避免无限增长 资源隔离:核心作业使用独立TaskManager组 版本控制:Flink作业版本化部署,支持快速回滚 数据验证:实现端到端数据一致性校验管道
7.3 成本优化建议
冷热数据分离:7天热数据存SSD,历史数据存HDD 弹性伸缩:基于Kafka Lag自动扩缩容Flink任务 数据编码:采用Protobuf替代JSON,减少40%网络传输 存储分层:原始数据7天,聚合数据30天,统计结果永久保存
八、未来演进方向
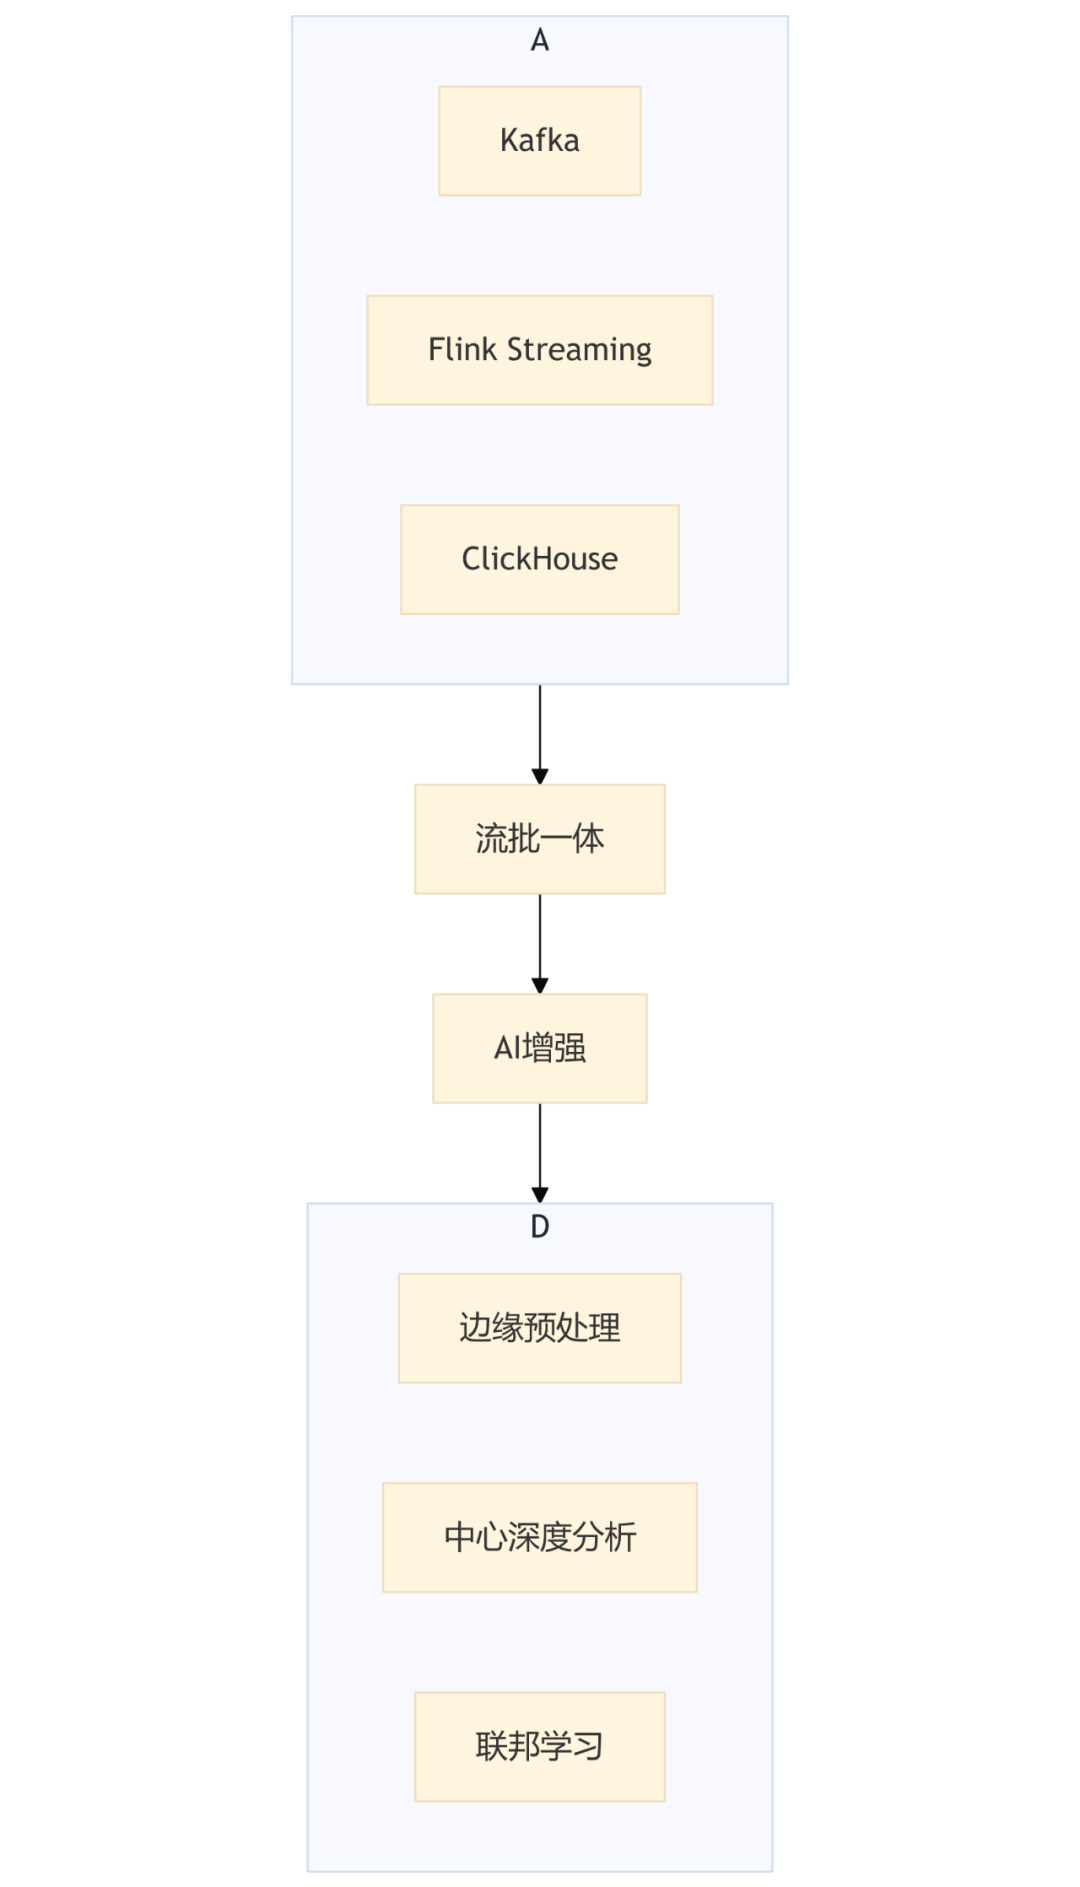
8.1 技术演进路线
流批一体:探索Flink Unified Batch & Streaming AI集成:实时车辆异常检测模型(LSTM+CNN) 边缘计算:部分计算下沉到区域边缘节点 数据湖集成:Iceberg/Hudi实现实时数据湖
8.2 架构演进示意图
九、总结
经过两年多的实战迭代,基于Flink+Kafka的实时数仓架构已稳定支撑百万级车辆的数据处理需求。关键成功因素包括:
分层设计:清晰的ODS/DWD/ADS数据分层 适度冗余:关键链路的双活部署 可观测性:完善的多维度监控体系 渐进演进:小步快跑,持续优化
该架构日均处理千亿级事件,端到端延迟控制在秒级,为智能汽车的数据驱动业务提供了坚实的技术底座。随着车联网数据规模的持续增长,实时数仓的架构范式仍在不断演进,但稳定性、扩展性和成本效益的核心设计原则将始终不变。
#实时数仓 #flink实时计算 #汽车IoT #百万级数据处理
资
料
下
载
广告人士勿入,切勿轻信私聊,防止被骗
点下方的“❤”支持我们,非常感谢!
文章转载自陈乔数据观止,如果涉嫌侵权,请发送邮件至:contact@modb.pro进行举报,并提供相关证据,一经查实,墨天轮将立刻删除相关内容。
