



点击蓝字关注我们
现在,大语言模型(Large Language Models, LLMs)在各类自然语言处理任务中表现抢眼——无论是撰写文章、回答问题,还是辅助编程,它们都展现出惊人的能力。然而,随着应用场景不断拓展,其固有局限也逐渐暴露:一方面,模型的知识通常冻结在训练截止时间点,难以反映最新事件或动态信息;另一方面,在缺乏可靠依据的情况下,模型有时会生成看似合理却完全虚构的内容,也就是业内常说的“幻觉”(hallucination)。
为应对这些挑战,研究者和工程师们开始探索多种增强策略,试图在保持模型强大语言能力的同时,提升其准确性与可信度。其中,检索增强生成(Retrieval-Augmented Generation, RAG)和模型上下文协议(Model Context Protocol, MCP)成为两个备受关注的方向。RAG 通过在生成前从外部知识源中检索相关信息,将实时、权威的内容注入回答过程;而 MCP 则更侧重于规范模型如何理解、整合和利用上下文信息,从而在复杂交互中维持逻辑一致性与事实准确性。
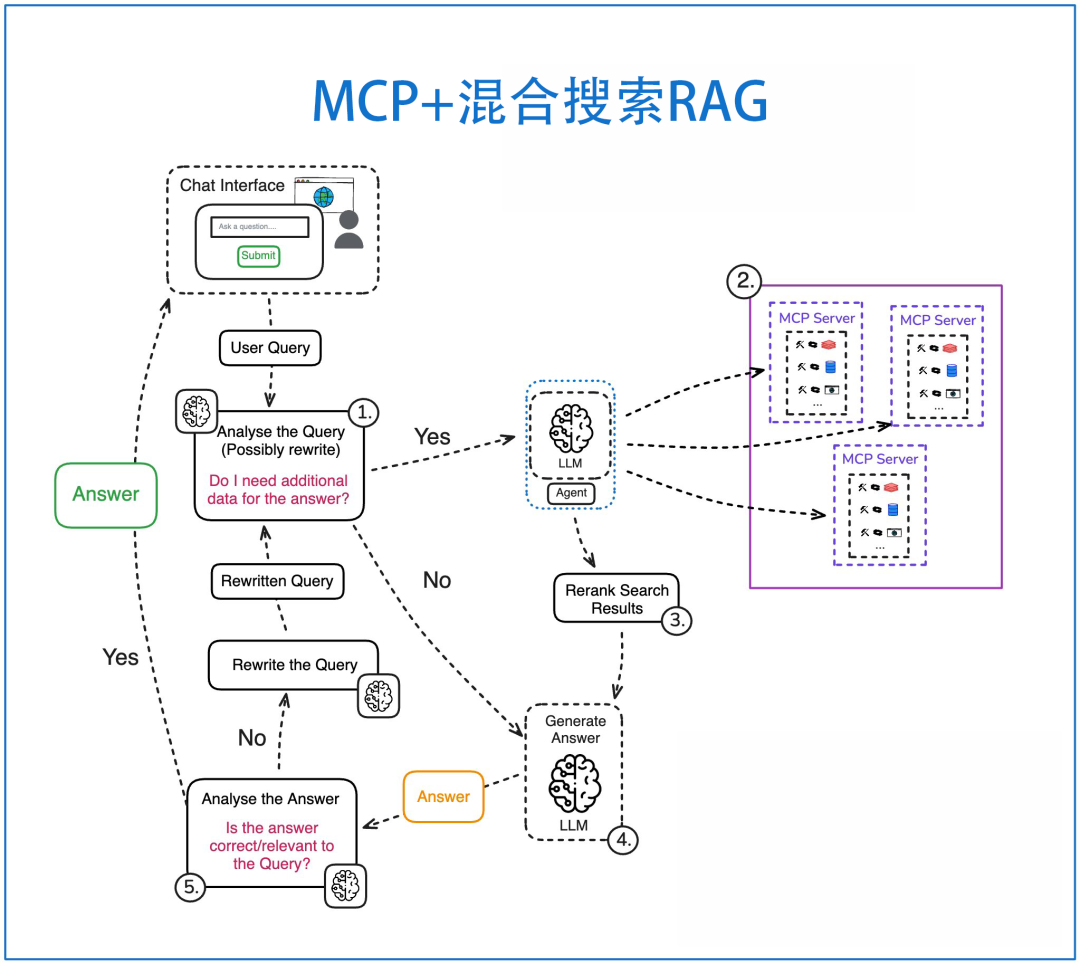
更进一步地,当MCP与混合搜索(hybrid search)技术结合形成新的RAG时,系统的检索生成能力得到更显著增强,相比于传统的RAG,速度、效果、准确性、幻觉抑制等方面有更为优异的表现。混合搜索融合了关键词匹配、向量语义检索乃至结构化查询、RRF等多种检索范式,能够在不同场景下灵活调用最合适的检索策略。MCP 则在此基础上,对来自多源、多模态检索结果进行统一上下文建模,确保大模型在生成响应时不仅“看到”了相关信息,还能“理解”这些信息之间的关联与优先级。这种协同机制让 AI 系统在面对复杂、动态或高度专业的问题时,既能快速定位关键事实,又能以连贯、准确的方式组织答案——真正实现从“能说会道”到“言之有据”的跃迁。
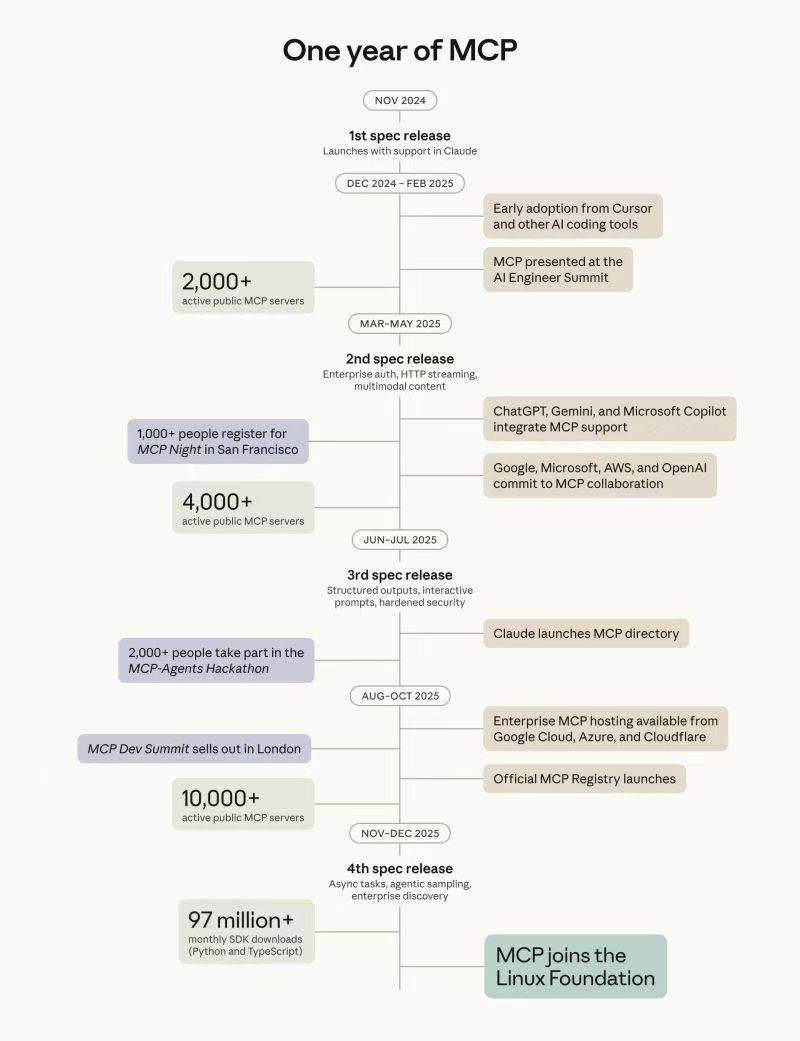
MCP经过一年的发展,最新统计显示其月SDK下载量超过97million+之多。
一、传统 RAG 的局限性
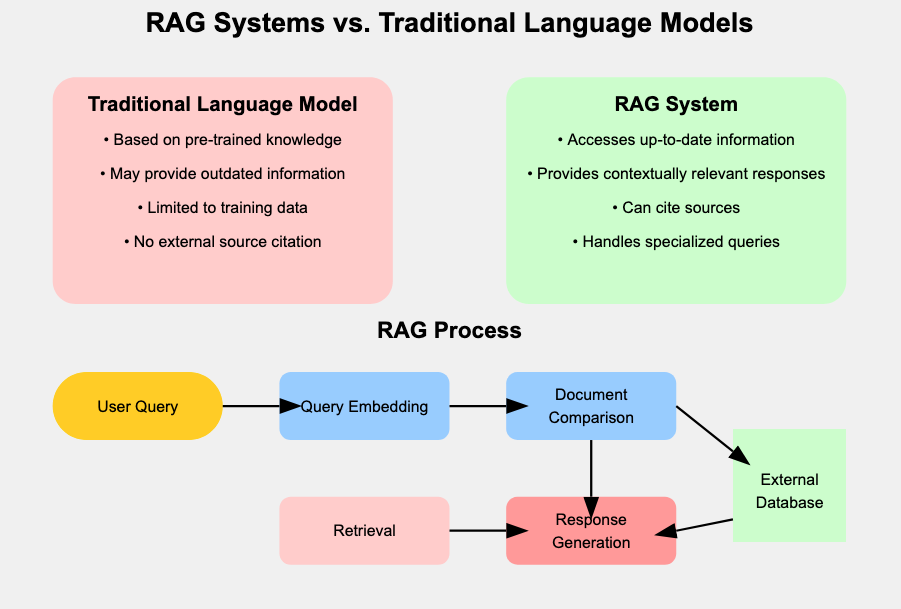
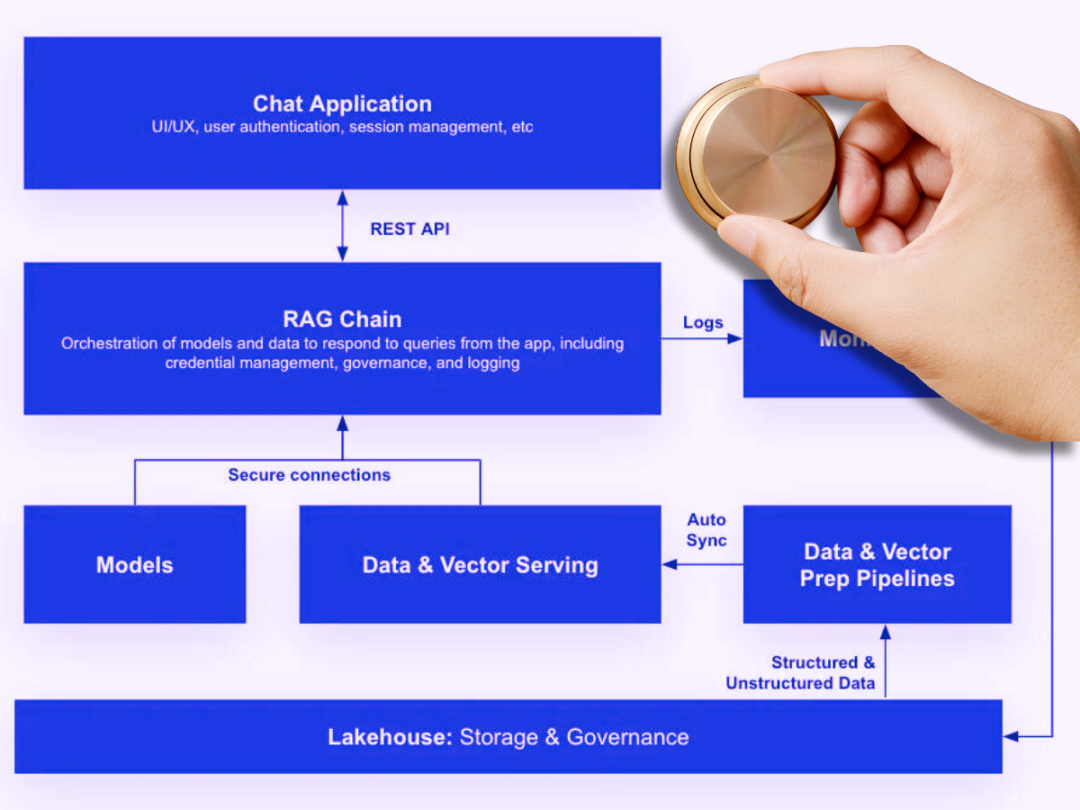
RAG(Retrieval-Augmented Generation,检索增强生成)是当前大模型领域的热门方向。它将信息检索技术与生成模型相结合,旨在解决大模型在知识准确性、上下文理解以及最新信息利用等方面的挑战。尤其是在搜索、聊天机器人、文档分析和决策支持领域。传统的RAG系统帮助弥合了静态语言模型与现实世界信息动态演变需求之间的差距。
然而,许多人可能对 RAG 存在一些误解,认为只要通过 RAG 导入一些额外知识,模型就能完美掌握并回答相关问题。但现实与想象往往有差距。你在实际尝试后可能会发现,RAG 的准确率似乎并不那么理想。
从 RAG 自身的技术原理来看,目前存在以下问题:
检索准确率不足:首先,RAG 的核心是将知识转化为“向量”,导入“向量数据库”,然后将用户输入转化为向量,在向量数据库中匹配相似向量,最后让大模型对检索内容进行总结。
生成内容不完整:由于 RAG 处理的是文档切片,这些切片的局部性导致它无法看到整篇文档的信息,因此在回答“列出 XXX”或“总结 XXX”这类问题时,答案通常不完整。
缺乏整体视角:RAG 无法判断需要多少切片来回答问题,也无法判断文档之间的关联。例如在法律条款中,新解释可能覆盖旧条款,但 RAG 无法判断哪个是最新的。
线性过程:检索-生成流水线通常是静态且非自适应的。它不能在任务中途改变策略,也不能根据中间反馈进行迭代。
多轮检索能力弱:RAG 缺乏多轮、多查询检索能力,这对于推理任务至关重要。它本质上并不支持多步骤的推理或决策。复杂问题通常需要多次检索和计算的链式连接。
协调性差:涉及多工具交互(如搜索API、计算器或内部系统)的任务通常需要外部编排逻辑,增加实现开销。
虽然一些新兴技术如 GraphRAG 和 KAG 在一定程度上能解决这些问题,但它们仍不成熟,当前的 RAG 技术距离预期效果还有很大差距。
这时,由MCP(模型上下文协议)驱动,结合混合搜索形成的新型RAG应运而生,通过为AI客户端提供上下文、工具和提示。它可以暴露文件、文档、数据库等数据源,并执行上下文感知执行。
可以规划并朝着目标迈进
使用多种工具和资源
反复推理
如有必要,反思并修正其方法
二、什么是 Agentic RAG
Agentic RAG通过引入代理行为,扩展了传统的检索增强生成。与标准RAG不同,它不仅仅是检索文档;它规划、推理并执行任务,以生成更智能、更具上下文感知的输出。
通过整合迭代推理和任务分解,Agentic RAG 能够处理复杂的工作流程、多步查询,并动态与外部系统交互以获取可作的洞察。
Agentic RAG的核心特征
迭代检索——持续优化查询以获取最相关的信息
任务分解——将复杂问题拆解为可管理的子任务
与MCP集成——连接外部应用以增强输出
动态规划——为连续任务智能决策
情境管理——在持续任务或对话中保持意识
相较于标准RAG的优势
动态适应性——实时调整检索和推理策略
更好的上下文理解——跟踪不断演变的任务和多步查询
工作流程自动化——直接集成到业务流程中以提升效率
可扩展性——支持复杂的企业级用例
三、通过实例理解
下面通过一个案例来理解其优势与不同
我们将为一个电子商务数据集使用语义搜索示例。如果用户想找“烧烤架”,自然语义搜索可以是:“我需要买一个烧烤架”:
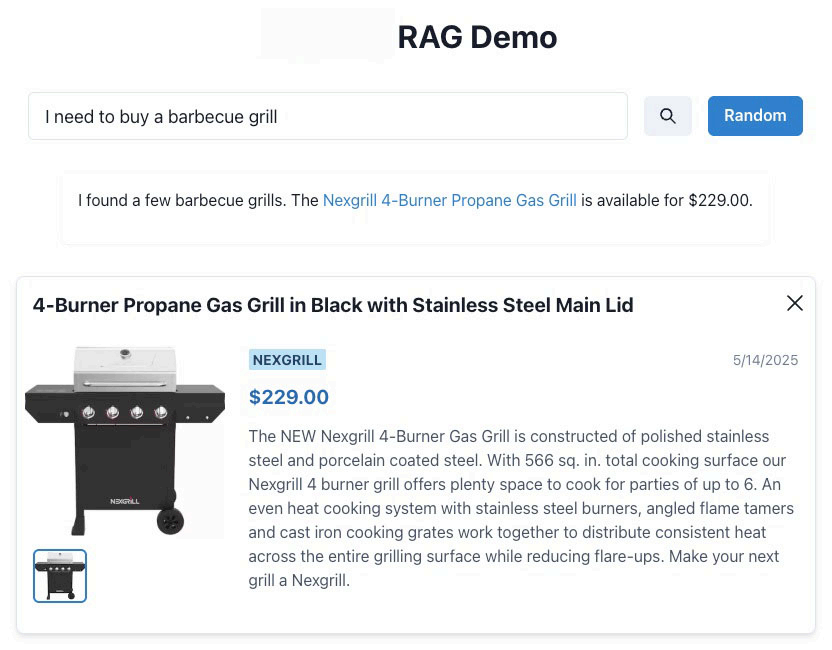
语义搜索帮助缩小了搜索范围,匹配“烧烤架”相关产品,并推荐得分最高的产品。按同样的模式,用户会预期找到“窗帘杆”产品,因此会输入“我需要一个StyleWell窗帘杆”这样的查询。
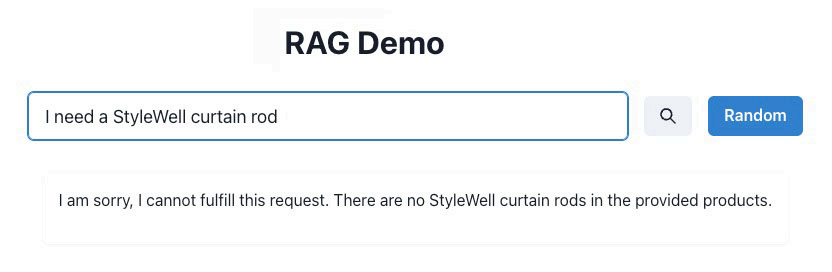
通过传统RAG搜索不到相应的产品。
这时,MCP+混合搜索就派上用场了。如果我们在之前的查询中稍作思考,最好的方法是检索语义上相似的结果,首先按“StyleWell”品牌筛选。LLM如何实现这一点?通过使用设计用于增强信息检索或执行操作能力的工具。agent首先决定是否有足够的信息回答查询,如果没有,就会触发动作获取所需数据。可以创建一个MCP服务器,LLM可以检索相关产品。使用“search_products”工具,可以进行带有价格、品牌和日期筛选的矢量搜索。
from fastmcp import FastMCPimport jsonimport sysfrom datetime import datetimefrom mongo import search_products_by_embeddingsfrom ai import get_embeddingsmcp = FastMCP("Agentic RAG Demo")@mcp.tool()async def search_products(query: str,limit: int = 10,min_price: float = 0,max_price: float = 1000000,brand: str = None,min_date: datetime = None,max_date: datetime = None) -> str:"""Search for products in the database.Args:query: The search query embeddings: strlimit: Optional limit to the number of results. Min 10: intmin_price: Optional minimum price: floatmax_price: Optional maximum price: floatbrand: Optional brand: strmin_date: Optional minimum date to filter by date: datetimemax_date: Optional maximum date to filter by date: datetimeReturns:JSON string containing search results"""embeddings = await get_embeddings(query)matching_products = search_products_by_embeddings(embeddings, limit, min_price, max_price, brand, min_date, max_date)return json.dumps(matching_products, cls=DateTimeEncoder)if __name__ == "__main__":try:mcp.run(transport="stdio")except Exception as e:print(f"Error in MCP server: {str(e)}", file=sys.stderr)sys.exit(1)
通过mcp,第一次LLM调用将返回带以下信息的数据检索指令:
{"response_type": "tool","tool_name": "search_products","tool_args": {"query": "curtain rod","brand": "StyleWell"}}
它会自动将“StyleWell”设置为“品牌”过滤器以获取数据,这样我们的Agentic RAG系统就能返回更好的响应。
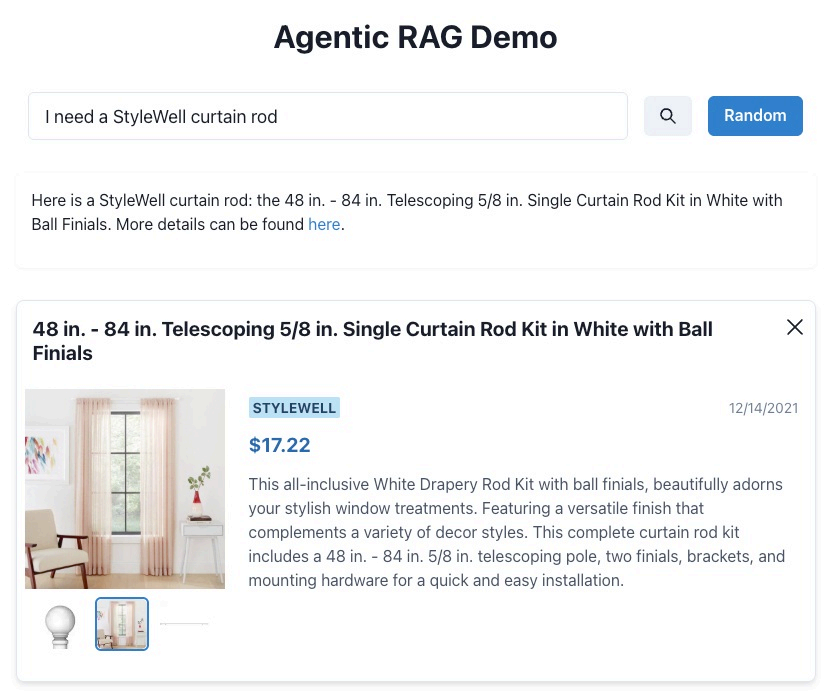
另一个更好的过滤示例是请求近期信息。如果用户需要请求当年某产品的信息,语义搜索中最相关的结果可能不包含匹配,但在使用基于代理的方法时,会应用正确的过滤。
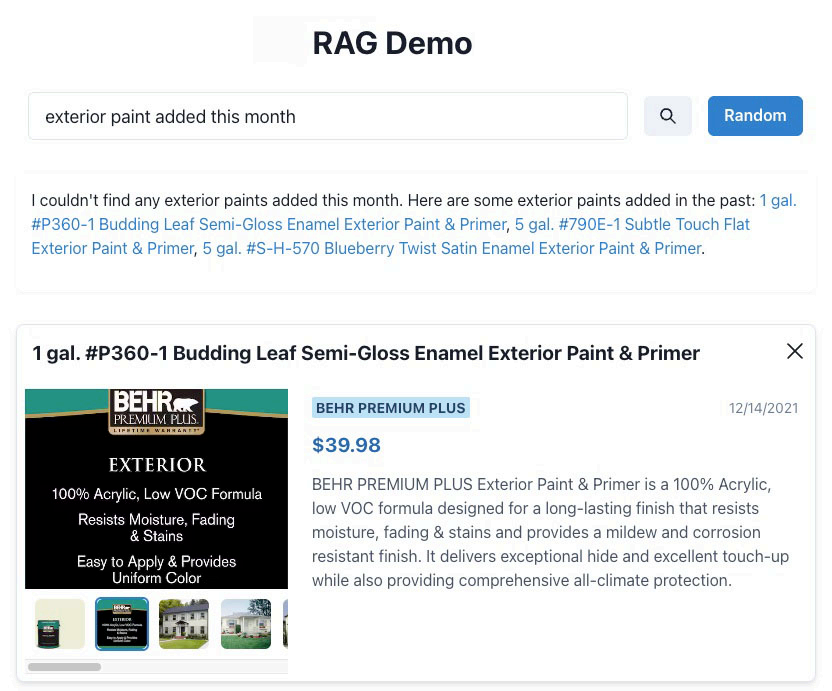
传统RAG搜索不到结果。
而通过mcp,作为用户查询的一部分,可以发送带有当前日期的元数据信息,以便代理请求获取产品信息,例如:
{"response_type": "tool","tool_name": "search_products","tool_args": {"query": "exterior paint","min_date": "2025-05-01","max_date": "2025-05-19","limit": 10}}
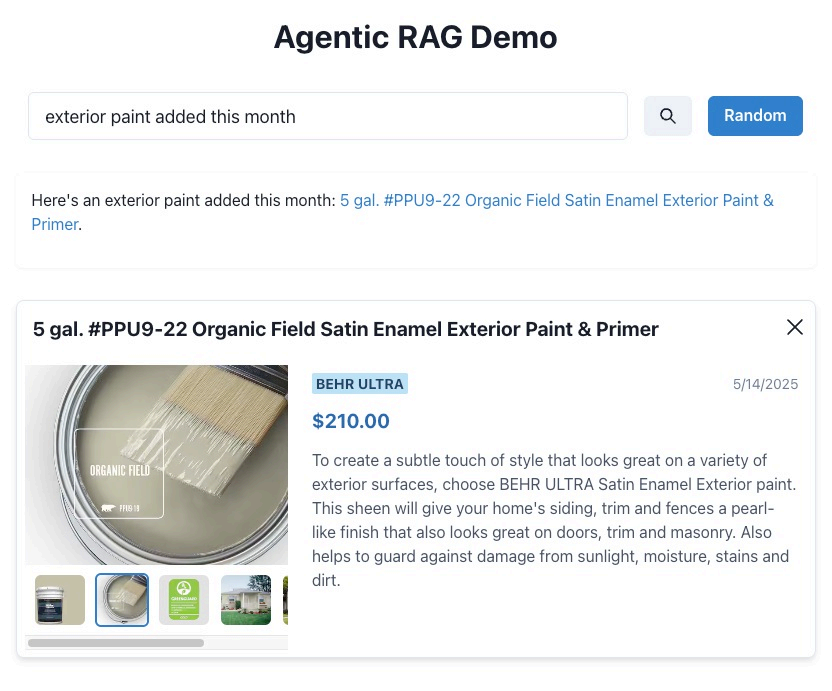
上面简单示例通过MCP加上混合搜索远远超越传统RAG的检索能力。
四、企业的战略影响
对于探索下一代AI解决方案的企业来说,支持MCP的Agentic RAG代表了能力的飞跃。它使企业能够构建智能助手,不仅能访问信息,还能在最小监督下推理、制定策略和执行任务,提供潜在客户搜索和相关性系统。
这一演进也简化了AI产品开发:开发者无需为每个边缘情况硬编码逻辑,而是定义模块化组件,让agent动态协调解决方案。
传统的RAG系统让我们更接近实用、信息感知型的语言模型。但随着企业需求向更复杂、互动性和更可靠的AI解决方案演变,具备多元规划的MCP+混合搜索的Agentic RAG为下一个RAG的新范式。
关于公司
感谢您关注新智锦绣科技(北京)有限公司!作为 Elastic 的 Elite 合作伙伴及 EnterpriseDB 在国内的唯一代理和服务合作伙伴,我们始终致力于技术创新和优质服务,帮助企业客户实现数据平台的高效构建与智能化管理。无论您是关注 Elastic 生态系统,还是需要 EnterpriseDB 的支持,我们都将为您提供专业的技术支持和量身定制的解决方案。
欢迎关注我们,获取更多技术资讯和数字化转型方案,共创美好未来!
 |  |
Elastic 微信群 | EDB 微信群 |
发现“分享”和“赞”了吗,戳我看看吧
