



1
背景
INNODB_LOCKS和
INNODB_LOCK_WAITS两张系统表用来展示InnoDB中的行锁等待关系,但是这两张表在8.0中被移到了Performance Schema库下并改名为
data_locks和
data_lock_waits,且需要客户启用Performance Schema性能监控插件后才能采集相关信息。启用Performance Schema后会采集大量事件来监视MySQL的运行状态,进而对MySQL实例产生性能影响。
2
使用方式
特性开关:innodb_rds_data_lock_info_enabled默认关闭,支持Session和Global级别动态修改,在使用时可以Session级别开启
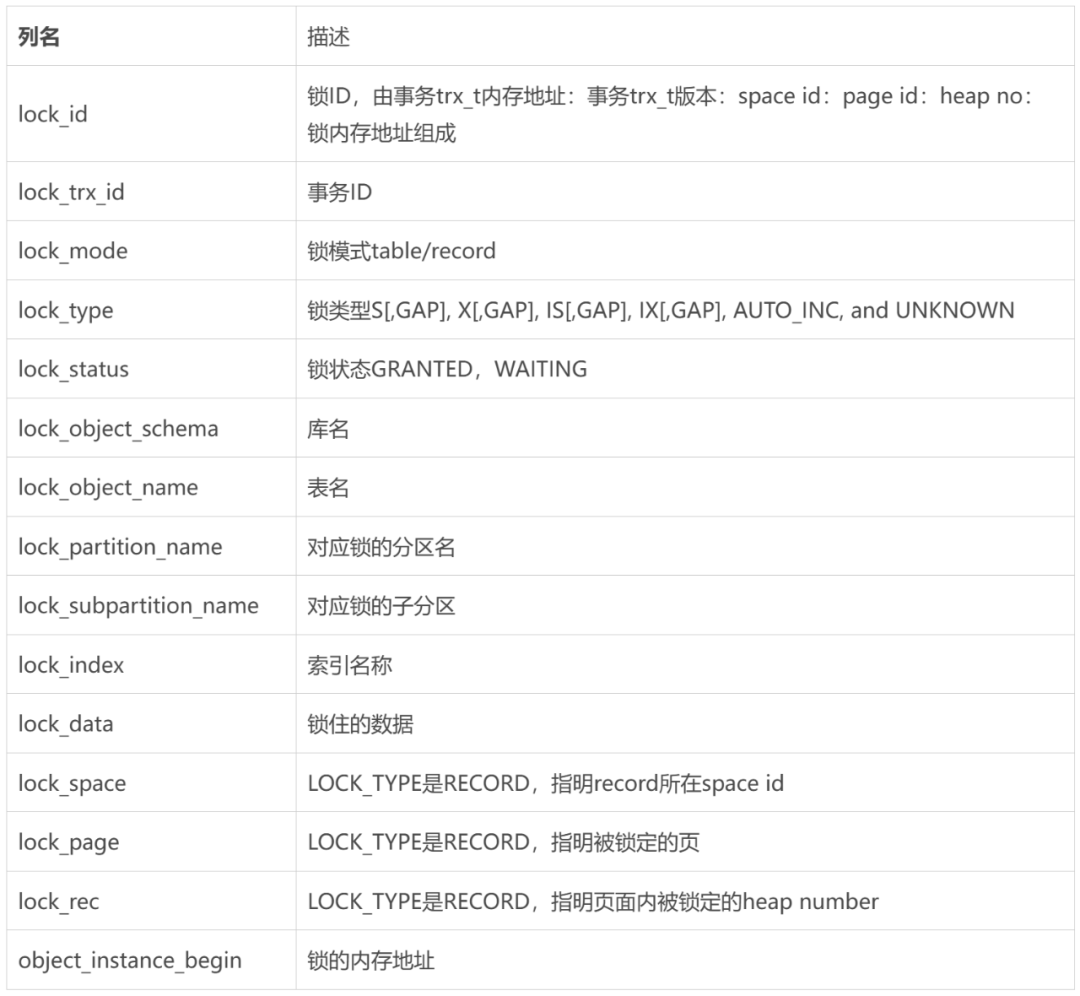
RDS_INNODB_DATA_LOCK_INFO:展示行锁相关信息的表
mysql> desc information_schema.RDS_INNODB_DATA_LOCK_INFO;+------------------------+-----------------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+------------------------+-----------------+------+-----+---------+-------+| lock_id | varchar(128) | NO | | | || lock_trx_id | bigint unsigned | NO | | | || lock_mode | varchar(32) | NO | | | || lock_type | varchar(32) | NO | | | || lock_status | varchar(32) | NO | | | || lock_object_schema | varchar(64) | NO | | | || lock_object_name | varchar(64) | NO | | | || lock_partition_name | varchar(64) | YES | | | || lock_subpartition_name | varchar(64) | YES | | | || lock_index | varchar(64) | YES | | | || lock_space | bigint unsigned | YES | | | || lock_page | bigint unsigned | YES | | | || lock_rec | bigint unsigned | YES | | | || object_instance_begin | bigint | NO | | | || lock_data | varchar(8192) | YES | | | |+------------------------+-----------------+------+-----+---------+-------+15 rows in set (0.01 sec)
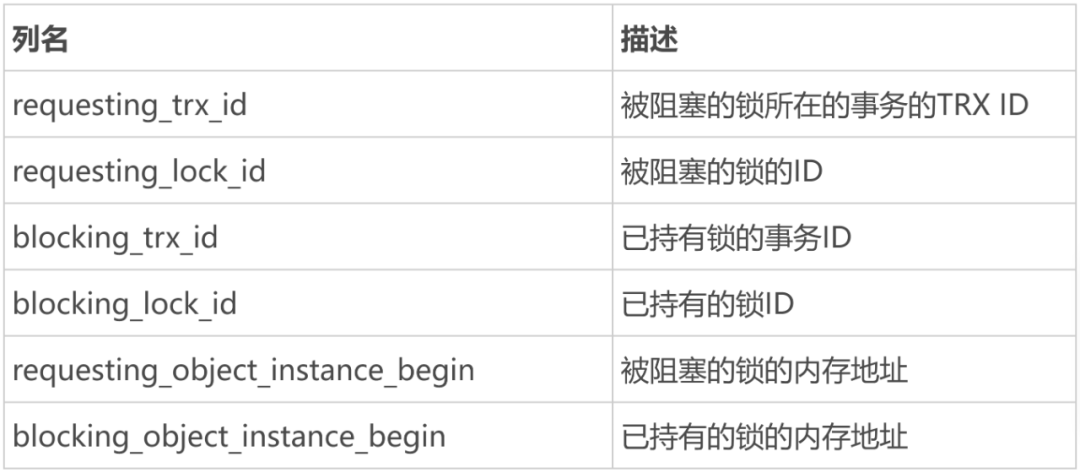
RDS_INNODB_DATA_LOCK_WAIT_INFO:展示行锁之间的等待关系
mysql> desc information_schema.RDS_INNODB_DATA_LOCK_WAIT_INFO;+----------------------------------+-----------------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+----------------------------------+-----------------+------+-----+---------+-------+| requesting_trx_id | bigint unsigned | NO | | | || requesting_lock_id | varchar(128) | NO | | | || requesting_object_instance_begin | bigint | NO | | | || blocking_trx_id | bigint unsigned | NO | | | || blocking_lock_id | varchar(128) | NO | | | || blocking_object_instance_begin | bigint | NO | | | |+----------------------------------+-----------------+------+-----+---------+-------+6 rows in set (0.02 sec)
使用示例
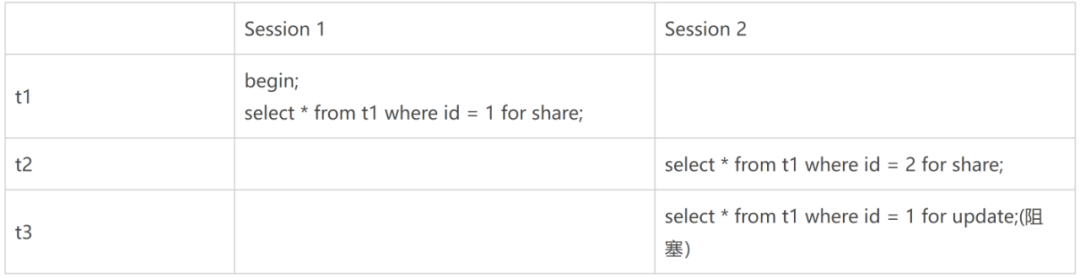
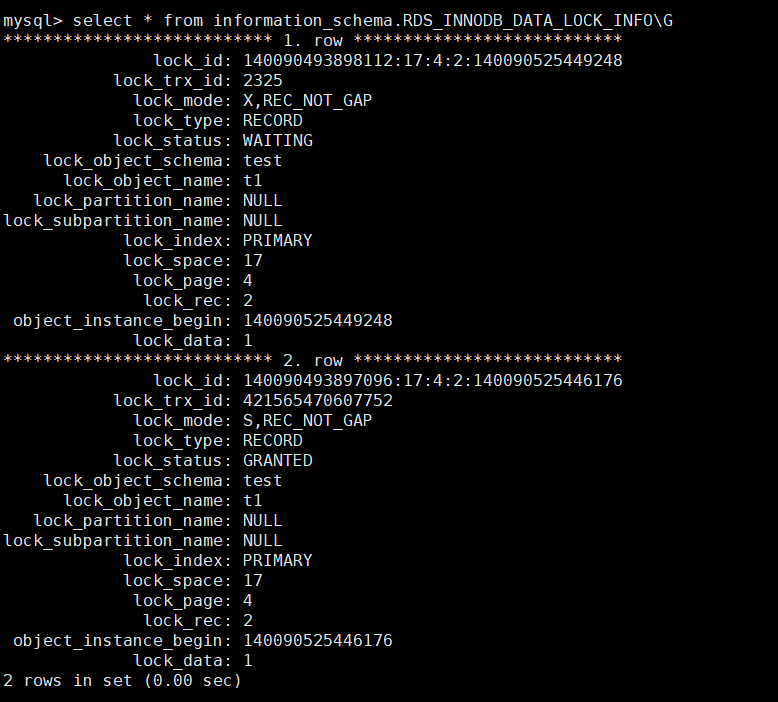
假设我们创建了一张表,其主键为ID。在会话1中我们开启了一个事务,不进行提交,此时该会话会一直持有表t1中行id=1的行的S类型的行锁。当会话2执行SELECT * FROM t1 WHERE id = 1 FOR UPDATE的操作时,需要获取X级别的行锁,但由于行锁S和X类型的互斥而被阻塞。此时我们可以通过查询锁视图的表,找到阻塞的会话,将对应的事务提交或这回滚,来让会话2继续运行。
我们可以通过查询RDS_INNODB_DATA_LOCK_WAIT_INFO这张表来获得系统中锁相关的信息,表中第一行我们可以看到事务2325对test库t1表中第四个页面的第二条记录加X类型的行锁(非间隙锁)时产生阻塞。第二行表示事务421565470607752已经持有了test库t1表中第四个页面的第二条记录S类型的行锁。这样我们就能基本判断出行锁的阻塞关系了。
但是对于一个高并发的系统,即事务数量很多时,我们很难通过这种方式直接找到两个事务的等待关系,因此在更多的时候,我们可以直接使用RDS_INNODB_DATA_LOCK_WAIT_INFO这张表来快速找到会话之间的等待关系。这里我们发现ID为2324的事务在被会话421565470607752阻塞。然后再根据事务ID在INFORMATION_SCHEMA.INNODB_TRX这张表中找到对应的会话ID进行提交或者KILL的操作,来释放锁进而恢复业务。
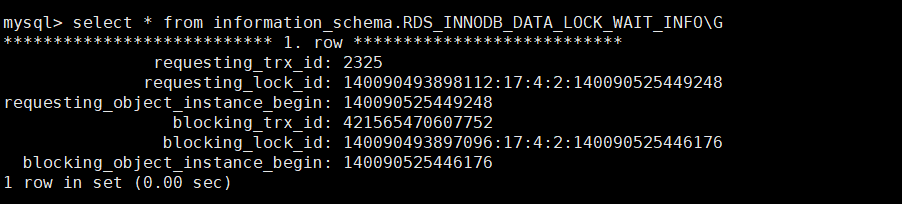
根据上面的原理,我们可以这两个操作拼接成如下SQL语句方便直接查询到阻塞的会话ID,然后进行提交或回滚。
SELECT trx.trx_mysql_thread_id AS THREAD_IDFROM INFORMATION_SCHEMA.INNODB_TRX trxJOIN INFORMATION_SCHEMA.RDS_INNODB_DATA_LOCK_WAIT_INFO lockinfoON trx.trx_id = lockinfo.blocking_trx_id;
3
源码实现
为了实现这两个锁视图,我们首先需要了解InnoDB是如何实现行锁的。所以接下来我们首先会简单介绍InnoDB行锁的实现,然后再介绍如何实现行锁视图。
3.1 InnoDB锁基本概念
下图展示了InnoDB中锁的维护方式。InnoDB中每一个锁对象由lock_t的对象来表示。对于行锁来说,只要确定了这一行所在的表的space_id,在表空间的页面号,在页面内的行号,我们就可以确定这行记录的位置。因此每个行锁的lock_t会维护space_id, page_no,和n_bits来标识对应的行。如果是表锁,只需要引用对应表的dict_table_t的对象即可。相反dict_table_t的对象中的locks链表也包含了该表上所有表锁的信息。最终这些锁对象lock_t结构体会存储在哈希桶中,由lock_sys_t来维护。
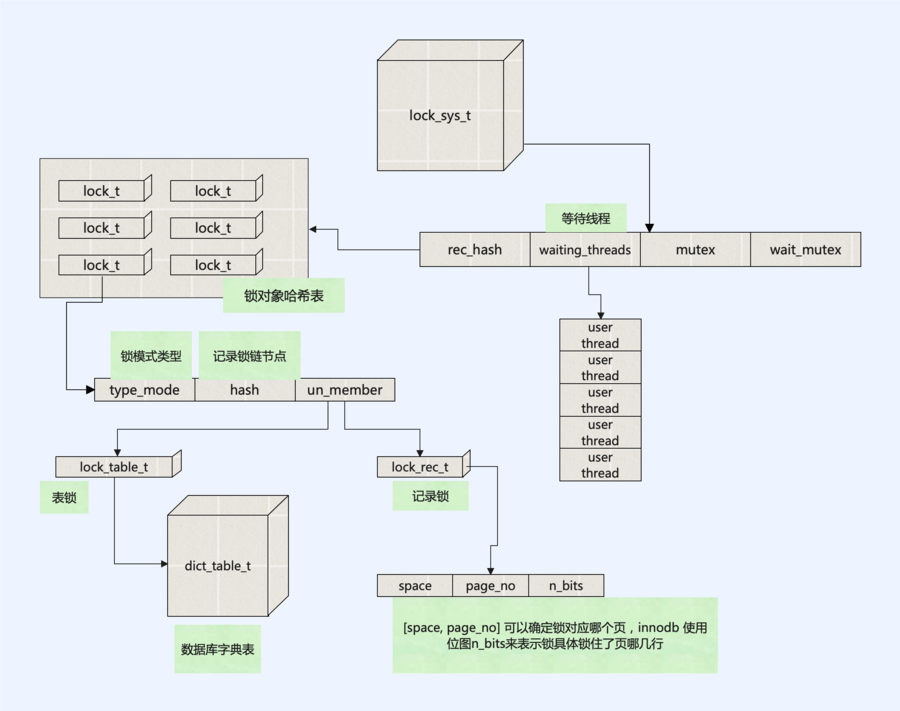
lock_sys_t: 一个全局唯一的对象,用来维护InnoDB中所有的锁对象,核心成员变量如下
struct lock_sys_t {/** 主要是针对老版本lock_sys_t->mutex锁的优化,现在拆分为三个维度global,page,table,1. 事务提交或回滚时,释放所有行锁和表锁会用到 global_latch。2. 事务加行锁时,会用到page_shards的分片的锁。3. 事务加表锁时,会用到table_shards的分片的锁。*/locksys::Latches latches;/** 记录锁全局hash,里面是lock_t的对象*/hash_table_t *rec_hash;/** 互斥锁,用于保护waiting_threads */Lock_mutex wait_mutex;/** 阻塞线程等待队列. */srv_slot_t *waiting_threads;/** 阻塞线程等待队列的链尾. */srv_slot_t *last_slot;/** 等锁最长时间. */std::chrono::steady_clock::duration n_lock_max_wait_time;};
lock_t:每个行锁或表锁的内存对象,核心成员变量如下
struct lock_t {/** 锁所属的事务对象 */trx_t *trx;/** 这个事务所有相关的锁对象 */UT_LIST_NODE_T(lock_t) trx_locks;/** 锁对象所在的索引 */dict_index_t *index;/** 锁对象链表,相同数据页的锁对象单链表进行管理,每个数据页的锁对象链表是全局lock_sys->rec_hash的一个桶 */lock_t *hash;/* 具体的一个锁对象,是union类型,表示要么是行锁 要么是表锁 */union {/** Table lock,主要记录的是dict_table_t的对象*/lock_table_t tab_lock;/** Record lock,主要记录page_id和heap no*/lock_rec_t rec_lock;};/* 存储行锁模式、行锁类型、行锁状态等信息 */uint32_t type_mode;}
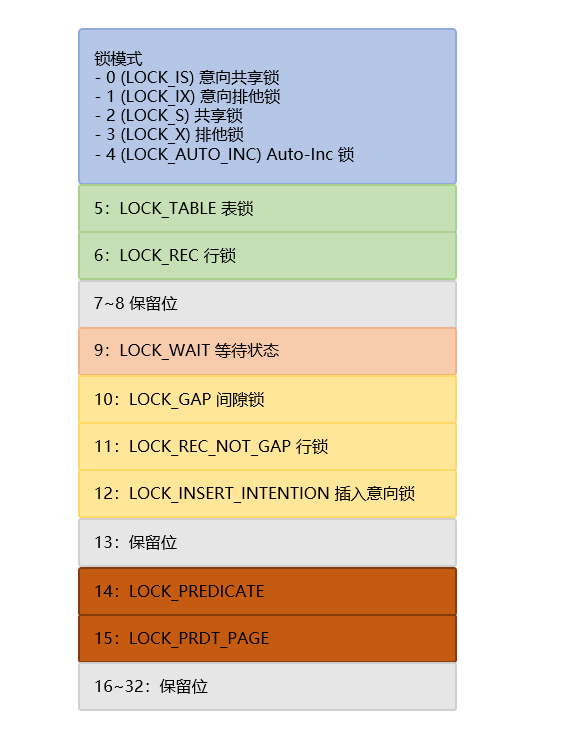
type_mode:
1-4位表示锁模式,包括意向共享锁、意向排它锁、共享锁、排它锁还是自增锁;
5和6位表示锁是表类型,表锁或行锁其中一个;
9位表示是否锁等待;
10到32位表示是记录锁类型,LOCK_GAP表示间隙锁,LOCK_REC_NOT_GAP表示行锁,临键锁是LOCK_ORDINARY,此值为0,也就是当不设置LOCK_GAP和LOCK_REC_NOT_GAP时,锁的类型就为临键锁。
除了全局锁维度,innodb在事务维度也会维护锁相关的信息,每个事务对应的内存结构体trx_t中有一个trx_lock_t的结构体,trx_lock_t中wait_lock和trx_locks会分别记录当前事务等待和已经授权的锁的信息。这也是我们实现锁视图时所用到的重要的结构体。
struct trx_lock_t {ulint n_active_thrs; /*!< number of active query threads *//*事务的状态*/trx_que_t que_state; /*!< valid when trx->state== TRX_STATE_ACTIVE: TRX_QUE_RUNNING,TRX_QUE_LOCK_WAIT, ... *//*事务正在请求的锁*/lock_t* wait_lock; /*/*事务发生了死锁,在死锁检测中被选为进行回滚的事务*/bool was_chosen_as_deadlock_victim;/*开始等待时间 */time_t wait_started;/** 预分配的记录锁的内存池. 在事务创建的时候预分配,默认预创建REC_LOCK_CACHE 8个lock_t对象,如果使用完再进行扩展 */lock_pool_t rec_pool;/** 预分配的表锁的内存池. */lock_pool_t table_pool;/* 指向所有已经获取的锁,一个事务可以持有多个锁 */trx_lock_list_t trx_locks;/* 持有锁的数量 */ulint n_rec_locks;};
3.2 InnoDB锁视图实现方式
InnoDB行锁视图是实现在Information_schema库下,类似其他IS表的视图在i_s.cc下定义了两个系统表
RDS_INNODB_DATA_LOCK_INFO
struct st_mysql_plugin i_s_innodb_data_lock_info = {STRUCT_FLD(name, "RDS_INNODB_DATA_LOCK_INFO"),STRUCT_FLD(init, innodb_locks_init),}static int innodb_locks_init(void* p) /*!< in/out: table schema object */{ST_SCHEMA_TABLE* schema;DBUG_ENTER("innodb_locks_init");schema = (ST_SCHEMA_TABLE*) p;schema->fields_info = innodb_data_lock_fields_info;schema->fill_table = trx_i_s_common_fill_table;DBUG_RETURN(0);}
RDS_INNODB_DATA_LOCK_WAIT_INFO
struct st_mysql_plugin i_s_innodb_data_lock_wait_info = {STRUCT_FLD(name, "RDS_INNODB_DATA_LOCK_WAIT_INFO"),STRUCT_FLD(init, data_lock_wait_info_init),}static int data_lock_wait_info_init(void* p){ST_SCHEMA_TABLE* schema;DBUG_ENTER("data_lock_wait_info_init");schema = (ST_SCHEMA_TABLE*) p;schema->fields_info = innodb_lock_wait_fields_info;schema->fill_table = trx_i_s_common_fill_table;DBUG_RETURN(0);}
两个系统表填充数据都是调用的trx_i_s_common_fill_table的函数,复用的是查询innodb_trx表时调用的函数,整体流程如下
trx_i_s_common_fill_table/* Step 1. 检查权限有PROCESS_ACL */if (check_global_access(thd, PROCESS_ACL)) {return 0;}/* Step 2. cache加写锁 */trx_i_s_cache_start_write(cache); ///* 并查询事务链表,将锁信息添加到cache中 */trx_i_s_possibly_fetch_data_into_cache(cache);/* Step 3. cache解锁 */trx_i_s_cache_end_write(cache); //解锁/* Step 4. cache加读锁 */trx_i_s_cache_start_read(cache);/* Step 5. 根据cache的内容填充i_s的系统表,查询的是哪张就会填哪张表,下面的函数3选1 */fill_innodb_trx_from_cache() // innodb_trxfill_data_lock_info_from_cache() // rds_innodb_data_lock_infofill_data_lock_wait_info_from_cache() // rds_innodb_data_lock_wait_info/* Step 6. cache解锁 */trx_i_s_cache_end_read(cache)
check_global_access检查权限,需要调用者拥有PROCESS_ACL的权限
trx_i_s_cache_start_write(cache);通过cache中的rw lock给cache加写锁
cache为trx_i_s_cache,是一个全局变量,目前包含三个类型为i_s_table_cache_t的子模块innodb_trx, innodb_locks和innodb_lock_waits,用来在三张视图查询时,将查询结果进行缓存
trx_i_s_possibly_fetch_data_into_cache:这个函数是构造出锁视图的核心函数,数据添加到对应的cache中,这个过程需要获取全局锁的内存管理系统lock_sys和事务内存管理系统trx_sys的锁,因此可能会短暂阻塞用户的读写业务。
int trx_i_s_possibly_fetch_data_into_cache(trx_i_s_cache_t *cache) /*!< in/out: cache */{// 与上一次读间隔100毫秒才能查询if (!can_cache_be_updated(cache)) {return (1);}// 获取lock_sys和trx_sys的锁{locksys::Global_exclusive_latch_guard guard{UT_LOCATION_HERE};trx_sys_mutex_enter();fetch_data_into_cache(cache);trx_sys_mutex_exit();}return (0);}
static bool add_trx_relevant_locks_to_cache(trx_i_s_cache_t *cache, const trx_t *trx, i_s_locks_row_t **requested_lock_row){/** 如果事务处于等待状态 */if (trx->lock.que_state == TRX_QUE_LOCK_WAIT) {i_s_locks_row_t *blocking_lock_row;const lock_t *wait_lock = trx->lock.wait_lock;wait_lock_heap_no = wait_lock_get_heap_no(wait_lock);/* 将等待的锁放入到cache中 */*requested_lock_row =add_lock_to_cache(cache, wait_lock, wait_lock_heap_no,lock_status_str);/* 这里做了一个参数rds_skip_i_s_trx_blocking_locks,防止遍历时间过长影响业务,可以及时中断查询 */if (current_thd != nullptr &¤t_thd->variables.rds_skip_i_s_trx_blocking_locks) {return (true);}/* 找到阻塞的锁,并将他添加到cache中 */locksys::find_blockers(*wait_lock, [&](const lock_t &curr_lock) {const trx_t *trx = lock_get_trx(&curr_lock);if (!trx->lock.wait_lock) {lock_status_str = "GRANTED";} else {lock_status_str = "WAITING";}/* 添加阻塞的锁到rds_lock_data_info的cache中 */blocking_lock_row = add_lock_to_cache(cache, &curr_lock,/* heap_no is the samefor the wait and waitedlocks */wait_lock_heap_no,lock_status_str);/* 将他们的关联关系加入到data_lock_wait_info表对应的cache中 */add_lock_wait_to_cache(cache, *requested_lock_row, blocking_lock_row)}}
找到阻塞的锁的方法
const lock_t *find_blockers(const lock_t &wait_lock,std::function<bool(const lock_t &)> visitor) {locksys::Trx_locks_cache wait_lock_cache{};// 行锁,从lock_sys中的rec_hash桶中根据space_id, page_no, heap_no哈希值找到对应行上已经持有的锁if (lock_get_type_low(&wait_lock) == LOCK_REC) {const uint16_t heap_no = lock_rec_find_set_bit(&wait_lock);const auto found = wait_lock.hash_table().find_on_record(RecID{&wait_lock, heap_no}, [&](lock_t *lock) {if (lock == &wait_lock) {return true;}if (locksys::has_to_wait(&wait_lock, lock, wait_lock_cache)) {return visitor(*lock);}return false;});return found == &wait_lock ? nullptr : found;}// 如果是表锁,会遍历dict_table_t中的locks,找到该表上已经持有的锁for (auto lock : wait_lock.tab_lock.table->locks) {if (lock == &wait_lock) {return nullptr;}if (locksys::has_to_wait(&wait_lock, lock, wait_lock_cache)) {if (visitor(*lock)) {return lock;}}}return nullptr;}
如果是表锁,先去当前lock对应的dict_table_t,dict_table_t中会记录所有表持有的锁,进行遍历,然后判断兼容性。
如果是行锁,根据page_id + heap no计算出的哈希值,从lock_sys->rec_hash的哈希桶中找到对应的桶,然后对哈希链表进行遍历,也就是找到对同一行记录加过的锁,进行兼容性判断,兼容性判断过程在rec_lock_check_conflict()函数中。
最后我们会从cache中读取刚刚构造出的锁信息,然后构造出每个表的字段。
4
总结
锁等待时间通常是影响数据库响应时间的核心因素之一,本文简单介绍了InnoDB中锁的维护方式,以及RDS 8.0在Information_schema库下实现的锁视图RDS_INNODB_DATA_LOCK_INFO和RDS_INNODB_DATA_LOCK_WAIT_INFO的实现原理和使用方式。锁视图提供了深入查看数据库内部锁等待的重要手段。熟练使用这些视图,将极大提升定位数据库锁相关问题的效率。
END
历史文章
 戳“阅读原文”,了解更多技术干货
