



在数据仓库建设与运维的长期实践中,数据倾斜是绕不开的“老大难”问题。尤其是在基于 Hive、Spark 等分布式计算框架构建的数仓中,一旦出现数据倾斜,往往会导致任务运行超时、资源耗尽,甚至直接失败,严重影响数据产出效率与质量。
注:本文方案主要基于 Hive/Spark 生态,核心思路可迁移至其他分布式数仓框架。
一、先搞懂:数据倾斜的本质与常见场景
在讲方案前,我们必须先明确数据倾斜的本质:分布式计算框架中,数据在各个 Task 间分配不均,导致部分 Task 需要处理远超其他 Task 的数据量,成为整个任务的性能瓶颈。
1.1 数据倾斜的核心指标(可视化判断)
通过计算框架的任务监控面板,可通过以下指标快速判断数据倾斜:
1.2 数据倾斜的 3 大常见场景
场景 1:Key 分布不均(最常见) 某电商数仓中,用户行为表(dwd_user_behavior)的“用户 ID”字段存在大量重复——头部 1% 的用户(高频活跃用户)贡献了 30% 的行为数据,导致在按“用户 ID”分组统计用户活跃度时,对应 Task 数据量超 50GB,直接超时失败。
场景 2:关联操作导致的倾斜 订单表(dwd_orders)与用户表(dwd_users)关联时,订单表中存在大量“匿名用户”(user_id 为 null 或固定默认值 0),这些无效 Key 全部集中到一个 Task 处理,导致该 Task 处理数据量激增。
场景 3:聚合/窗口函数导致的倾斜 在计算商品近 30 天的累计销量时,使用窗口函数 partition by 商品 ID,部分爆款商品的订单数据量超千万条,窗口函数计算时单 Task 压力过大。
1.3 数据倾斜的判断流程(流程图)
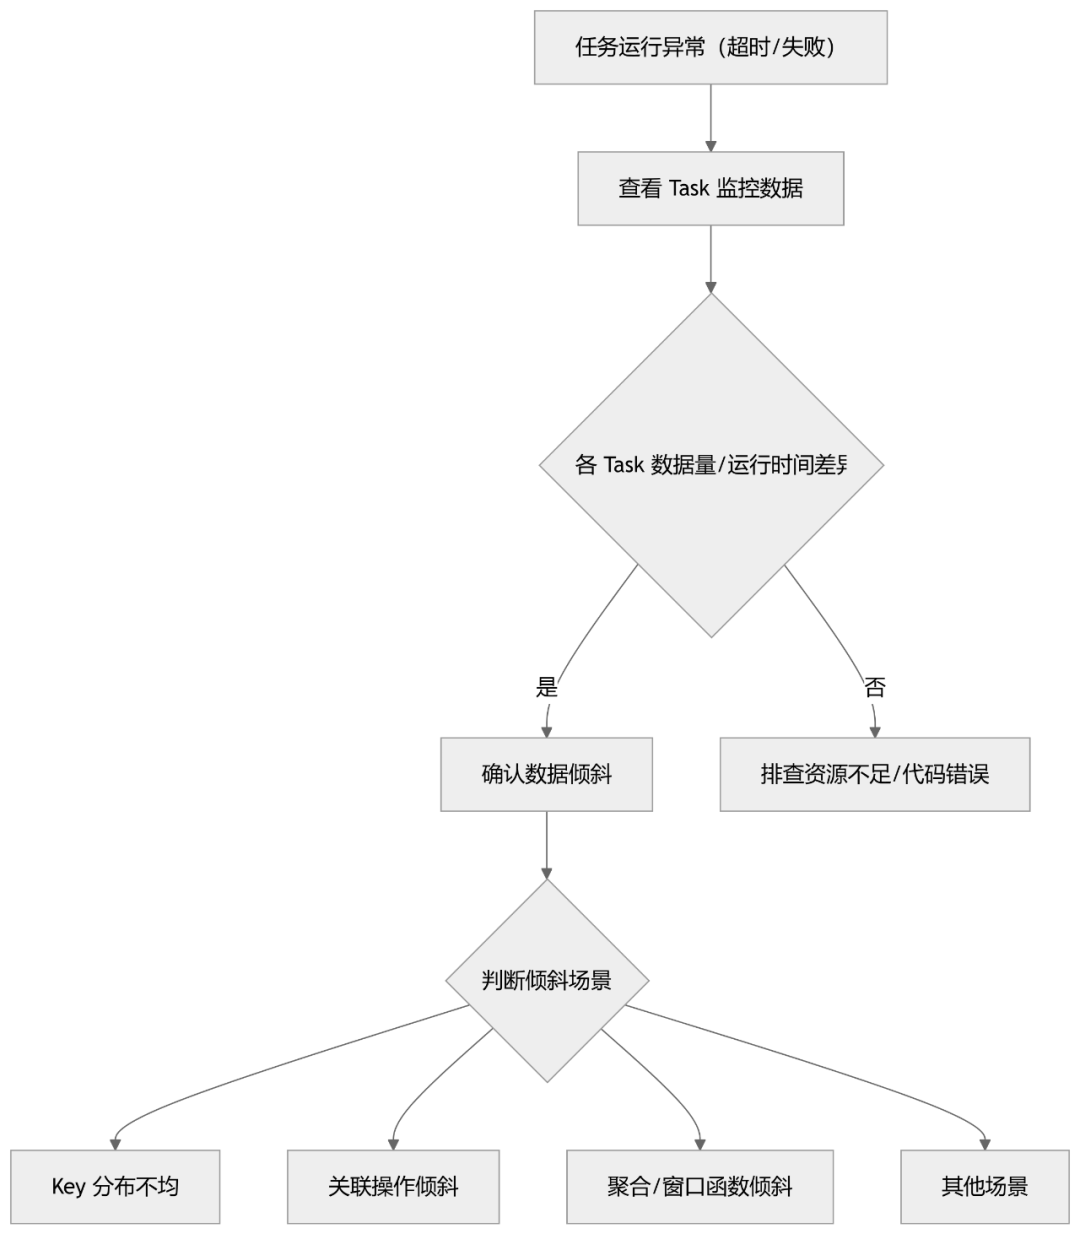
二、12 种根治方案:从简单到复杂,覆盖全场景
方案 1:过滤/清洗无效 Key——快速解决“无效数据导致的倾斜”
1. 核心逻辑
删除或过滤掉数据中无意义的 Key(如 null、空字符串、默认值 0 等),从源头减少倾斜 Task 的数据量。
2. 真实案例
某零售数仓中,订单表(dwd_orders)与门店表(dwd_stores)关联时,订单表中有 1200 万条记录的 store_id 为 null(无效订单),这些 null 值全部集中到一个 Task 处理,导致任务超时 2 次。
3. 操作步骤
-- 优化前:未过滤 null 值,存在倾斜
SELECT o.order_id, s.store_name
FROM dwd_orders o
LEFT JOIN dwd_stores s ON o.store_id = s.store_id;

-- 优化后:过滤无效的 null 值
SELECT o.order_id, s.store_name
FROM (SELECT * FROM dwd_orders WHERE store_id IS NOT NULL) o
LEFT JOIN dwd_stores s ON o.store_id = s.store_id;
4. 反思总结
该方案实施成本最低,适用于“无效 Key 占比高”的场景,但需注意:若无效 Key 是业务需要保留的数据(如匿名用户订单),不可直接过滤,需结合其他方案处理。
方案 2:随机打散倾斜 Key——解决“单一 Key 数据量过大”问题
1. 核心逻辑
对倾斜的 Key 进行随机拼接(如拼接随机数),将其打散成多个不同的 Key,使数据均匀分布到多个 Task;处理完成后,再将打散的 Key 还原,进行最终聚合。
2. 真实案例
某电商数仓中,用户行为表(dwd_user_behavior)的“用户 ID=10086”(高频活跃用户)对应 800 万条数据,按用户 ID 分组统计时,该 Key 对应的 Task 数据量超 60GB,运行超时。
3. 操作步骤(以 Spark SQL 为例)
-- 优化前:直接分组,存在倾斜
SELECT user_id, COUNT(*) AS behavior_count
FROM dwd_user_behavior
GROUP BY user_id;

-- 优化后:随机打散倾斜 Key
-- 步骤 1:对倾斜 Key 拼接随机数(如 0-9),打散分组
WITH tmp AS (
SELECT
    CASE WHEN user_id = '10086'THEN CONCAT(user_id, '_', FLOOR(RAND()*10))
         ELSE user_id
    END AS new_user_id,
    1AS cnt
FROM dwd_user_behavior
),
-- 步骤 2:对打散后的 Key 分组统计
tmp2 AS (
SELECT new_user_id, SUM(cnt) AS sub_count
FROM tmp
GROUP BY new_user_id
)
-- 步骤 3:还原 Key,进行最终聚合
SELECT
  SUBSTRING_INDEX(new_user_id, '_', 1) AS user_id,
SUM(sub_count) AS behavior_count
FROM tmp2
GROUP BY SUBSTRING_INDEX(new_user_id, '_', 1);
4. 流程图(随机打散 Key 逻辑)
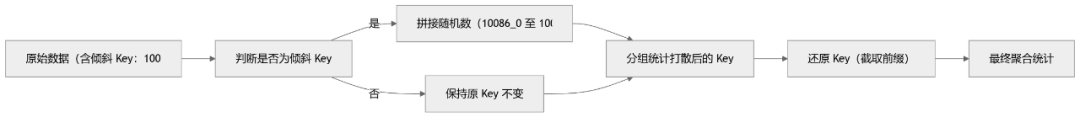
5. 反思总结
该方案适用于“单一 Key 数据量过大”的场景,实施简单,无需调整集群参数;但需提前明确倾斜 Key 的具体值,若倾斜 Key 较多(如 100 个以上),则需要通过查询自动识别倾斜 Key,避免硬编码。
方案 3:Key 加盐(通用版打散)——解决“未知倾斜 Key”问题
1. 核心逻辑
与方案 2 类似,但无需提前知道倾斜 Key,对所有 Key 统一拼接随机数(加盐),打散后分组统计,最后还原 Key 聚合。适用于“倾斜 Key 不明确”的场景。
2. 真实案例
某物流数仓中,运单表(dwd_waybills)的“物流网点 ID”字段存在多个倾斜 Key,但由于数据量较大(日均 5000 万条),无法提前逐一识别,直接分组统计时多个 Task 同时超时。
3. 操作步骤(Hive SQL 为例)
-- 优化前:直接分组,倾斜 Key 未知导致超时
SELECT site_id, COUNT(*) AS waybill_count
FROM dwd_waybills
GROUP BY site_id;

-- 优化后:Key 加盐打散
-- 步骤 1:所有 Key 拼接随机数(0-19),分成 20 个组
WITH tmp AS (
SELECT
    CONCAT(site_id, '_', FLOOR(RAND()*20)) AS salted_site_id,
    1AS cnt
FROM dwd_waybills
),
-- 步骤 2:打散后分组统计
tmp2 AS (
SELECT salted_site_id, SUM(cnt) AS sub_count
FROM tmp
GROUP BY salted_site_id
)
-- 步骤 3:还原 Key,最终聚合
SELECT
  SUBSTRING_INDEX(salted_site_id, '_', 1) AS site_id,
SUM(sub_count) AS waybill_count
FROM tmp2
GROUP BY SUBSTRING_INDEX(salted_site_id, '_', 1);
4. 反思总结
该方案通用性强,无需识别倾斜 Key,但会增加一次聚合操作的开销;随机数的范围(如 0-19)需根据数据量调整,建议分成的组数为集群并发 Task 数的 1-2 倍,避免打散后仍存在局部倾斜。
方案 4:空 Key 单独处理——解决“null/默认值 Key 倾斜”
1. 核心逻辑
对于 null、空字符串等无效 Key,单独过滤出来处理(如直接赋值为特定值、随机分配 Key),避免其集中到一个 Task;有效 Key 正常关联/聚合,最后合并结果。
2. 真实案例
某金融数仓中,客户交易表(dwd_customer_trans)与客户信息表(dwd_customers)关联时,交易表中有 300 万条记录的 customer_id 为 null,这些 null 值全部集中到一个 Task,导致该 Task 运行 2 小时后失败。
3. 操作步骤
-- 优化前:直接关联,null Key 导致倾斜
SELECT t.trans_id, c.customer_name
FROM dwd_customer_trans t
LEFT JOIN dwd_customers c ON t.customer_id = c.customer_id;

-- 优化后:空 Key 单独处理
-- 步骤 1:拆分数据为“空 Key 组”和“非空 Key 组”
WITH non_null_trans AS (
SELECT * FROM dwd_customer_trans WHERE customer_id IS NOT NULL
),
null_trans AS (
SELECT * FROM dwd_customer_trans WHERE customer_id ISNULL
),
-- 步骤 2:非空 Key 正常关联
non_null_result AS (
SELECT t.trans_id, c.customer_name
FROM non_null_trans t
LEFT JOIN dwd_customers c ON t.customer_id = c.customer_id
),
-- 步骤 3:空 Key 直接赋值(业务允许的默认值)
null_result AS (
SELECT trans_id, '匿名客户'AS customer_name
FROM null_trans
)
-- 步骤 4:合并结果
SELECT * FROM non_null_result
UNION ALL
SELECT * FROM null_result;
4. 反思总结
该方案专门针对“无效 Key 倾斜”,处理逻辑清晰,不会影响有效数据的计算;需注意业务对无效 Key 的处理规则(如是否允许赋值为默认值),避免违反业务逻辑。
方案 5:Map 端 Join——解决“小表关联大表导致的倾斜”
1. 核心逻辑
当关联操作的一方是小表(数据量≤10GB,可加载到内存)时,将小表广播到所有 Map 节点,在 Map 端直接完成关联,避免 Reduce 阶段的 Key 聚合,从根本上消除倾斜。
2. 真实案例
某电商数仓中,商品表(dwd_products,数据量 50 万条,约 2GB)与订单明细表(dwd_order_details,数据量 1 亿条,约 100GB)关联时,由于商品表是小表,默认的 Reduce 端关联导致部分商品对应的订单数据过多,出现倾斜。
3. 操作步骤(Spark/Hive 均支持)
-- Hive 中启用 Map 端 Join(通过参数设置)
SET hive.auto.convert.join=true; -- 自动识别小表,启用 Map Join
SET hive.mapjoin.smalltable.filesize=10737418240; -- 小表阈值设为 10GB

-- Spark 中启用 Map 端 Join(broadcast 函数)
SELECT /*+ BROADCAST(c) */ t.order_id, t.product_id, c.product_name
FROM dwd_order_details t
LEFT JOIN dwd_products c ON t.product_id = c.product_id;
4. 流程图(Map 端 Join 逻辑)
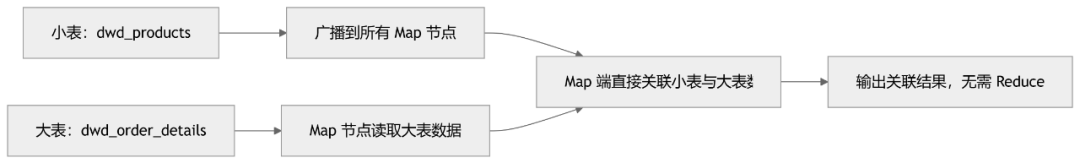
5. 反思总结
Map 端 Join 是解决“小表关联大表”倾斜的最优方案,效率极高;但需注意小表的大小阈值,若小表超过阈值(如 10GB 以上),广播到所有节点会占用大量内存,可能导致节点 OOM,此时需拆分小表或使用其他方案。
方案 6:大表拆分成小表——解决“大表关联大表导致的倾斜”
1. 核心逻辑
当两个关联的表都是大表(均超过 10GB)时,将其中一个大表按 Key 范围拆分成多个小表,然后分别与另一个大表的对应分区进行关联,最后合并结果,避免单 Task 处理过多数据。
2. 真实案例
某互联网数仓中,用户日志表(dwd_user_logs,日均 2 亿条,150GB)与用户画像表(dwd_user_profiles,日均 5000 万条,30GB)关联时,由于两个表都是大表,Reduce 端关联出现严重倾斜,任务运行 4 小时后失败。
3. 操作步骤
-- 步骤 1:将大表 dwd_user_logs 按 user_id 范围拆分(如拆分成 10 个小表)
CREATE TABLE dwd_user_logs_split_${i} (
  log_id STRING,
  user_id STRING,
  log_time STRING,
  action   STRING
)
PARTITIONED BY (split_id INT)
AS SELECT
  log_id, user_id, log_time, action,
CAST(HASH(user_id) % 10 AS INT) AS split_id -- 按 user_id 哈希取模拆分
FROM dwd_user_logs;

-- 步骤 2:将用户画像表按相同规则拆分
CREATE TABLE dwd_user_profiles_split_${i} (
  user_id STRING,
  age INT,
  gender STRING,
  city STRING
)
PARTITIONED BY (split_id INT)
AS SELECT
  user_id, age, gender, city,
CAST(HASH(user_id) % 10 AS INT) AS split_id
FROM dwd_user_profiles;

-- 步骤 3:对应拆分分区逐一关联,最后合并结果
WITH join_result AS (
SELECT t.log_id, t.user_id, p.age, p.gender
FROM dwd_user_logs_split_0 t
JOIN dwd_user_profiles_split_0 p ON t.user_id = p.user_id
UNION ALL
SELECT t.log_id, t.user_id, p.age, p.gender
FROM dwd_user_logs_split_1 t
JOIN dwd_user_profiles_split_1 p ON t.user_id = p.user_id
-- ... 依次关联 split_2 至 split_9
)
SELECT * FROM join_result;
4. 反思总结
该方案适用于“大表关联大表”的场景,但实施成本较高,需要拆分表并逐一关联;拆分的数量需根据集群并发能力调整,避免拆分过多导致任务数量激增。
方案 7:调整并行度——通过资源分配缓解倾斜
1. 核心逻辑
数据倾斜的本质是 Task 数量不足,导致单个 Task 处理数据过多。通过增加 Reduce Task 的数量(调整并行度),让数据更均匀地分布到多个 Task 中,缓解倾斜压力。
2. 真实案例
某政务数仓中,人口统计报表任务(基于 8000 万条人口数据聚合)的默认 Reduce Task 数量为 50,导致每个 Task 处理 160 万条数据,部分 Task 运行超时;调整并行度后,任务正常完成。
3. 操作步骤(Hive/Spark 参数设置)
-- Hive 调整 Reduce 并行度
SET mapreduce.job.reduces=200; -- 增加 Reduce Task 数量为 200
-- 或通过数据量自动计算并行度
SET hive.exec.dynamic.partition.mode=nonstrict;
SET hive.exec.reducers.bytes.per.reducer=536870912; -- 每个 Reduce 处理 512MB 数据

-- Spark 调整并行度
SET spark.sql.shuffle.partitions=200; -- Shuffle 阶段并行度设为 200
SET spark.default.parallelism=200; -- 整体任务并行度设为 200
4. 反思总结
该方案是“兜底方案”,实施简单,无需修改代码;但仅适用于“数据倾斜不严重”的场景,若存在极端倾斜 Key(如单个 Key 数据量占比 50%),调整并行度效果有限,还会浪费资源。
方案 8:使用倾斜优化参数——框架层面自动缓解倾斜
1. 核心逻辑
Hive、Spark 等框架提供了专门的倾斜优化参数,开启后框架会自动识别倾斜 Key,通过拆分倾斜 Task、重试等机制缓解倾斜,无需手动修改代码。
2. 操作步骤(关键参数设置)
3. 真实案例
某电商数仓中,商品销售表与用户表关联任务,开启 Spark 自适应倾斜优化后,任务运行时间从 3 小时缩短至 45 分钟,无需修改任何代码。
4. 反思总结
该方案适用于“快速验证倾斜是否可缓解”的场景,是首选的“无代码修改”方案;但不同框架的优化效果存在差异,对于极端倾斜场景,仍需结合其他方案使用。
方案 9:窗口函数优化——解决“窗口函数 partition 倾斜”
1. 核心逻辑
当窗口函数(如 row_number、sum() over())的 partition by 字段存在倾斜时,通过“先局部窗口计算,再全局合并”的方式,拆分倾斜的 partition,避免单 Task 处理过多数据。
2. 真实案例
某直播数仓中,计算主播近 7 天的直播时长累计(使用 sum(duration) over(partition by anchor_id order by live_date)),头部 10 个主播的直播场次占比 30%,导致对应的 partition 计算超时。
3. 操作步骤
-- 优化前:直接窗口计算,partition 倾斜
SELECT
  anchor_id, live_date, duration,
SUM(duration) OVER(PARTITION BY anchor_id ORDER BY live_date) AS total_duration
FROM dwd_anchor_live;

-- 优化后:拆分 partition 计算
-- 步骤 1:对倾斜的 anchor_id 加盐,拆分 partition
WITH tmp AS (
SELECT
    anchor_id, live_date, duration,
    CASE WHEN anchor_id IN ('anchor_001', 'anchor_002') -- 倾斜的主播 ID
         THEN CONCAT(anchor_id, '_', FLOOR(RAND()*5))
         ELSE anchor_id
    END AS new_anchor_id
FROM dwd_anchor_live
),
-- 步骤 2:局部窗口计算(拆分后的 partition)
tmp2 AS (
SELECT
    anchor_id, live_date, duration, new_anchor_id,
   SUM(duration) OVER(PARTITION BY new_anchor_id ORDER BY live_date) AS sub_total
FROM tmp
),
-- 步骤 3:计算每个主播的全局累计值(合并拆分的 partition)
tmp3 AS (
SELECT
    anchor_id, live_date, duration,
   SUM(sub_total) OVER(PARTITIONBY anchor_id ORDER BY live_date) AS total_duration
FROM tmp2
)
SELECT anchor_id, live_date, duration, total_duration
FROM tmp3;
4. 反思总结
该方案专门针对窗口函数倾斜,核心是“拆分大 partition 为小 partition”;需注意局部计算后合并的逻辑正确性,避免累计值计算错误。
方案 10:数据预处理——从源头避免倾斜
1. 核心逻辑
在数据接入数仓时(ODS 层),对存在倾斜隐患的数据进行预处理,如:去重、拆分大文件、均匀分区等,从源头减少倾斜的可能性。
2. 真实案例
某电商数仓的 ODS 层用户行为表(ods_user_behavior),每日数据集中在一个 100GB 的大文件中,且文件内数据按用户 ID 无序排列,导致后续数仓分层任务(DWD 层)处理时出现严重倾斜。
3. 操作步骤
步骤 1:拆分大文件 使用 Hadoop 的 split 命令,将 100GB 的大文件拆分成 20 个 5GB 的小文件:
hadoop fs -split -l 5368709120 ods/user_behavior/20250101.log ods/user_behavior/split/步骤 2:按均匀字段分区 在 ODS 层建表时,按“日志时间(log_time)”分小时分区,避免数据集中在单个分区:
CREATE TABLE ods_user_behavior ( user_id STRING, action STRING, log_time STRING ) PARTITIONED BY (dt STRING, hour STRING) ROW FORMAT DELIMITED FIELDS TERMINATED BY '\t';步骤 3:数据去重 对重复的用户行为数据去重,减少无效数据量:
INSERT OVERWRITE TABLE ods_user_behavior PARTITION (dt='20250101', hour='00') SELECT DISTINCT user_id, action, log_time FROM ods_user_behavior_raw WHERE dt='20250101' AND hour='00';
4. 反思总结
数据预处理是“治根”方案,能从源头减少倾斜,但需要在数仓设计阶段提前规划;适用于“长期存在倾斜隐患”的数据表,一次性处理后,后续所有依赖该表的任务都能受益。
方案 11:使用列式存储与索引——提升倾斜数据查询效率
1. 核心逻辑
将倾斜数据所在的表转换为列式存储(如 Parquet、ORC),并建立索引(如 Hive 的 Bloom Filter 索引),减少查询时的数据扫描量,提升倾斜 Task 的处理效率。
2. 真实案例
某医疗数仓中,病历表(dwd_medical_records)为文本格式(TextFile),查询时需要全表扫描,倾斜 Key 对应的 Task 扫描数据量超 80GB;转换为 ORC 格式并建立索引后,扫描量减少至 10GB,任务正常完成。
3. 操作步骤
-- 步骤 1:创建 ORC 格式的表(列式存储)
CREATE TABLE dwd_medical_records_orc (
  patient_id STRING,
  record_time STRING,
  disease STRING
)
STORED AS ORC
TBLPROPERTIES ('orc.compress'='SNAPPY'); -- 启用 Snappy 压缩

-- 步骤 2:插入数据(从文本表转换)
INSERT OVERWRITE TABLE dwd_medical_records_orc
SELECT patient_id, record_time, disease
FROM dwd_medical_records;

-- 步骤 3:建立 Bloom Filter 索引(针对倾斜的 patient_id 字段)
ALTER TABLE dwd_medical_records_orc
ADD INDEX idx_patient_id (patient_id) AS 'bloomfilter'
WITH DEFERRED REBUILD;

-- 步骤 4:重建索引
MSCK REBUILD INDEX idx_patient_id ON dwd_medical_records_orc;
4. 反思总结
该方案适用于“查询频繁的倾斜表”,能提升查询效率,但需要额外的存储空间和索引维护成本;列式存储的压缩率通常比文本格式高 3-5 倍,可显著减少数据传输和扫描开销。
方案 12:任务拆分与调度优化——避免倾斜任务资源竞争
1. 核心逻辑
将存在倾斜的任务拆分成多个子任务,分时段调度,避免多个倾斜任务同时运行占用大量资源;同时为倾斜任务分配单独的资源队列,保障其资源供给。
2. 真实案例
某数仓中有 3 个倾斜任务(用户行为统计、订单分析、商品销量统计),原调度计划为同一时间运行,导致资源竞争,所有任务均超时;拆分后分时段运行,并分配单独资源队列,任务均正常完成。
3. 操作步骤
步骤 1:任务拆分 将原有的“全量数据统计任务”拆分为“倾斜 Key 统计子任务”和“非倾斜 Key 统计子任务”,分别创建调度脚本。
步骤 2:分时段调度 通过 Airflow 调度工具,设置任务依赖和运行时间: 00:00-02:00:运行非倾斜 Key 统计子任务(资源需求低)
02:00-05:00:运行倾斜 Key 统计子任务(资源需求高)
步骤 3:资源队列分配 在 YARN 中创建专门的倾斜任务队列(queue_skew),分配 50% 的集群资源,确保倾斜任务有足够的资源:
-- yarn-site.xml 配置
<property>
  <name>yarn.scheduler.capacity.root.queues</name>
  <value>default,queue_skew</value>
</property>
<property>
  <name>yarn.scheduler.capacity.root.queue_skew.capacity</name>
  <value>50</value>
</property>
4. 反思总结
该方案是“运维层面的优化”,适用于“多个倾斜任务共存”的场景;通过调度和资源分配,避免资源竞争,无需修改代码,但需要运维人员对集群资源有清晰的规划。
三、方案选型指南:快速匹配你的场景
为了方便大家快速选择合适的方案,整理了以下选型表格,结合场景、实施成本、效果进行对比:
四、实践反思:数据倾斜优化的 3 个关键认知
1. 不要盲目优化,先定位倾斜根源
优化前必须通过监控面板明确倾斜的类型(Key 分布不均/关联倾斜/窗口函数倾斜)、倾斜 Key 的具体值、数据量占比等信息,避免“头痛医脚”。笔者早期曾未定位根源就盲目增加并行度,不仅未解决问题,还浪费了大量资源。
2. 优先“低成本方案”,再考虑“高成本方案”
优化方案的实施成本排序:参数调整(方案 7、8)< 代码修改(方案 1、2、3、4、5)< 数据预处理(方案 10)< 任务拆分/表拆分(方案 6、12)。优先尝试低成本方案,若效果不佳再逐步升级。
3. 优化是动态过程,需持续监控调整
数据分布会随业务变化而变化,今天有效的优化方案,可能明天就失效。需要建立长期监控机制,定期检查任务运行状态,及时调整优化策略。
五、总结
数据倾斜的本质,是大数据计算中"分而治之"思想与"数据自然分布"之间的矛盾。它不仅是一个技术问题,更是对数据特征、业务逻辑、计算框架三者关系的深度考验。
资
料
下
载
广告人士勿入,切勿轻信私聊,防止被骗
点下方的“❤”支持我们,非常感谢!
