



很多人以为 MySQL 优化就是“加索引”“改 SQL”。其实,最大的坑,往往藏在你看不见的地方——比如一条看似无害的默认配置,一个 ORM 自动生成的 JOIN,一次“为了安全”的全表锁。
下面列举的我亲自见识过的32个误区,有些是我半夜被叫起来救火的元凶,有些是同事信誓旦旦“绝对没问题”结果炸了的“神操作”。希望你看完后,能少背几次锅,少熬几个通宵。
内容稍微有点长,建议大家收藏后慢慢看,以后用得着的时候能方便找到。
误区1:“只要加索引,查询就快”
案例1:函数毁一切
某系统查询接口突然变慢。查看慢日志发现:
SELECT * FROM orders WHERE DATE(create_time) = '2024-11-10';
开发说:“我给 create_time 加了索引啊!”
我说:“你加了也没用——因为 DATE() 函数让索引失效了。”
后来改成范围查询(MySQL8.0+版本也可以用函数索引,但是建议优先用范围查询替代):
WHERE create_time >= '2024-11-10 00:00:00'AND create_time < '2024-11-11 00:00:00'
QPS 从 30 直接飙到 5200。
案例2:隐式转换的“温柔陷阱”
有一次用户登录失败率飙升。排查发现:
-- user_id 是 VARCHAR(32)SELECT * FROM sessionsWHERE user_id = 789012;
注意:这里用了数字 789012,而不是字符串 '789012'。
MySQL 为了比较,会把表中所有 user_id 转成数字。结果是进行了全表扫描!800万行,每次登录都要扫一遍。改回字符串后,响应时间从 6.3 秒降到 8 毫秒。
另外,隐式转换的案例还有很多,例如字符集不同、排序规则不同等也会造成。所以需要谨记索引不是贴上去就生效,它很“娇气”——函数、类型不匹配、最左前缀破坏,都会让它“罢工”。
误区2:“查询字段都建索引,索引越多越好”
案例3:索引爆炸的代价
新来的实习生为了“保险”,给一张商品表(50个字段)建了30多个单列索引。上线第一天,商品上架接口从 200ms 涨到 3.5 秒。
为什么?每插入一条商品记录,InnoDB 要更新主键索引 + 30多个二级索引。磁盘IO直接拉满,写入队列堆积如山。
后来我们只保留了三个联合索引:
(category_id, is_on_sale, sort_order)(brand_id, price)(sku_code) —— 唯一索引
写性能恢复,查询也没变慢。
案例4:冗余索引拖垮备份
某次凌晨全量备份失败,原因是磁盘空间不足。一查:一张日志表有 12GB 数据,但索引占了 28GB!
原来历史遗留问题:既有 (user_id) 索引,又有 (user_id, action) 联合索引。前者完全冗余!用 sys.schema_redundant_indexes 一查,删掉冗余索引后,备份时间缩短60%,磁盘省了16GB。
建议:定期用percona-tookits工具检查冗余、未使用索引,如查看性能视图 performance_schema.table_io_waits_summary_by_index_usage,别让索引变成“数字脂肪”。
误区3:“分页用 LIMIT OFFSET 就行,每次只返回一部分数据,高效方便”
案例5:百万级分页拖垮数据库
后台有个“导出全部异常订单”功能,前端一页一页拉数据:
SELECT * FROM ordersWHERE status = 'failed'ORDER BY idLIMIT 1000000, 50;
当翻到第2万页时,这条SQL跑了47秒,锁表导致其他订单更新超时。
后来我们改成基于游标的分页:
第一次:WHERE id > 0 ORDER BY id LIMIT 50下一次:WHERE id > [上次最后一条id] ORDER BY id LIMIT 50
导出时间从18分钟降到42秒,且不再影响线上业务。
案例6:前端“无限滚动”的灾难
一个应用的动态流用 OFFSET 实现无限下拉。用户刷到第500页时,APP卡死。
原因?每次都要跳过前25000条(50条/页 × 500页)。即使有索引,也要遍历这么多行。
解决方案:前端传“最后一条的 created_at + id”,后端用:
WHERE (created_at < ? OR (created_at = ? AND id < ?))ORDER BY created_at DESC, id DESCLIMIT 50;
完美支持深度分页,且性能稳定。
误区4:“COUNT(1) 比 COUNT(*) 快”
案例7:迷信 COUNT(1) 的幻觉
看到有个“性能规范”文档写着:“禁止用 COUNT(*),必须用 COUNT(1)”。
我问为什么?答:“网上都说更快。”
我当场在测试库跑对比:
表:1000万行,InnoDB,无WHERE条件
SELECT COUNT(*):平均 2.1 秒
SELECT COUNT(1):平均 2.1 秒
SELECT COUNT(id)(id为主键):也是 2.1 秒
完全一样!
MySQL 官方文档明确说:InnoDB 对 COUNT(*) 有特殊优化,且不会真的去数每一行(除非必须)。所谓“快慢”,是 MyISAM 时代的旧闻。
案例8:手写计数器翻车现场
为了“加速首页统计”,开发在 Redis 里维护了一个 total_users 计数器,每次注册就 INCR。
结果?某天系统异常重启,部分注册请求成功但没触发 INCR,导致页面显示“10万用户”,实际数据库有10.3万。
后来我们建议: 放弃实时精确计数,改用定时任务每5分钟同步一次,前端展示“约10万用户”——既快又稳。
结论:别为微小的理论差异牺牲正确性和可维护性。
误区5:“SQL慢就是数据库的问题”
案例9:N+1 查询的隐形杀手
用户详情页加载慢。查数据库,单条SQL只要 15ms。但前端一次请求,要查:
用户基本信息(1次)
用户订单列表(1次)
每个订单的商品详情(N次,N=订单数)
一个用户有50个订单?那就是52次数据库查询!
我们改成:
用 JOIN 一次性拉取用户+订单+商品;
或者用 IN 批量查商品:SELECT * FROM products WHERE id IN (1,2,3,...)
页面加载从 3.2 秒降到 320 毫秒。
案例10:缓存穿透引发DB雪崩
某个商品详情接口没做缓存,恶意用户用脚本刷不存在的ID(如 ?id=999999999)。
每次请求都穿透到数据库,执行:
SELECT * FROM products WHERE id = 999999999;
虽然很快(主键索引),但QPS冲到5万,连接池耗尽,正常用户无法下单。
解决方案:
对空结果也缓存(比如缓存 NULL,有效期2分钟)
加布隆过滤器(Bloom Filter)提前拦截无效ID
误区6:盲目相信“经验公式”
案例11:“百万行必须分表”?未必!
有团队看到用户表超过100万行,立刻启动分库分表,花了两个月改造。
结果呢?核心查询都是 WHERE user_id = ?,主键索引毫秒响应。分表后反而要跨节点查,复杂度飙升,故障率上升。
而另一张只有8万行的“配置变更日志表”,因为频繁
SELECT * FROM config_log ORDER BY created_at
且无索引,每次查都全表扫描,拖慢整个管理后台。
案例12:“TEXT不能建索引”?错!
有人说:“TEXT字段不能建索引,所以别用。”
其实,InnoDB 支持对 TEXT 前缀建索引:
ALTER TABLE articles ADD INDEX idx_title (title(50));
我们有个搜索热词表,keyword 是 TEXT 类型,建了前缀索引后,模糊匹配 LIKE '手机%' 速度从 1.8 秒降到 30 毫秒。
当然,如果是 LIKE '%手机%',那确实索引无效——但那是另一个问题了。
案例13:子查询引发的全表扫描风暴
有个报表需求:找出最近30天下单超过5次的用户。
开发小刘写了这样的SQL:
SELECT user_idFROM ordersWHERE user_id IN (SELECT user_idFROM ordersWHERE create_time > NOW() - INTERVAL 30 DAYGROUP BY user_idHAVING COUNT(*) > 5);
看起来逻辑清晰?但在MySQL 5.7之前(甚至某些8.0场景),这种 IN (子查询) 会被物化为临时表且无法有效使用索引,导致外层查询对 orders 全表扫描。
实际执行计划显示:外层扫描了2800万行。
可以用JOIN 方式来改写:
SELECT o1.user_idFROM orders o1INNER JOIN (SELECT user_idFROM ordersWHERE create_time > NOW() - INTERVAL 30 DAYGROUP BY user_idHAVING COUNT(*) > 5) o2 ON o1.user_id = o2.user_id;
改写后,执行时间从 22 秒降到 0.4 秒。
子查询≠高效。在MySQL中,相关子查询(correlated subquery)尤其危险,可能被反复执行N次。
误区8:“MyISAM比InnoDB快,读多就该用它”
案例14:为了“快”丢了数据
几年前,一个项目组坚持用 MyISAM 存文章表:“我们99%是读,MyISAM快,还支持全文索引!”
结果某天服务器意外断电,重启后发现:最近两小时的文章全部丢失。因为 MyISAM 没有事务、没有崩溃恢复机制。
更糟的是,他们用 LOCK TABLES 做“伪事务”,高并发时经常死锁,编辑后台卡死。
后来迁移到 InnoDB + 全文索引(MySQL 5.6+已支持),虽然写入略慢,但数据安全了,锁粒度细了,整体可用性反而提升。
现在的建议:除非你明确知道自己在做什么(比如只读日志归档),否则一律用 InnoDB。它的行级锁、MVCC、崩溃恢复,是现代应用的基石。
误区9:“批量操作用一条大SQL更快”
案例15:一条INSERT搞崩主从复制
运营要导入100万条优惠券。开发为了“高效”,拼成一条超长SQL:
INSERT INTO coupons (code, user_id, ...) VALUES('A001', 1001, ...),('A002', 1002, ...),...('A1000000', 1999999, ...);
结果?这条SQL在主库执行花了18秒,binlog 写了600MB。从库回放时,单线程SQL_THREAD 被卡住,主从延迟飙升到15分钟,导致用户领券成功但页面显示“未领取”。
正确做法:分批提交,每1000条一个事务:
for batch in chunks(data, 1000):execute("INSERT INTO coupons VALUES " + batch)commit()
既避免长事务锁表,又防止主从延迟爆炸。
另外,还有一个风险,大事务还会导致:
undo log 膨胀
MVCC 快照过旧,触发 ORA-1555 类错误(MySQL叫“snapshot too old”)
备份时一致性快照难以获取
误区10:“EXPLAIN 看 rows 少就一定快”
案例16:rows=1,却跑了10秒?
有次排查慢SQL,看到 EXPLAIN 结果:
type: refkey: idx_user_idrows: 1Extra: Using where
看起来完美?但实际执行要10秒!
深入一看:WHERE 条件里有个 LIKE '%关键词%',虽然走了索引定位到 user_id=123 的那一行,但还要对整行做全文模糊匹配,而那条记录的 content 字段有 20MB!
问题在于EXPLAIN 的 rows 只反映“索引扫描行数”,不反映“每行处理成本”。
后来我们对 content 建了 FULLTEXT 索引;也可以提前过滤掉大字段,只在必要时 SELECT。
其实Using filesort 或 Using temporary 即使 rows 很小,也可能很慢。一定要看 Extra 列!
误区11:ORDER BY 字段有索引就一定快
案例17:索引存在,却走了 filesort
开发写了个排行榜:
SELECT user_id, score FROM user_rankWHERE dt= '2025-12-20'ORDER BY score DESC LIMIT 100;
他在 score 上建了索引,但没注意 WHERE 条件是 dt。结果MySQL先用dt过滤出50万行,再对这50万行按score排序——Using filesort,耗时 8 秒。
更高效的做法:建联合索引 (dt, score desc),让过滤+排序一步到位。ORDER BY 能用索引的前提是——索引能覆盖 WHERE + ORDER BY 的完整路径,且方向一致。
误区12:SELECT * 写起来方便,没什么性能差异
案例18: select * 把网络带宽干爆
一张用户表有 30 个字段,其中 avatar_data 是 MEDIUMBLOB(存头像二进制)。
前端只需要 user_id, name, avatar_url,但 DAO 层写了 SELECT *。
结果:每次查 1000 个用户,返回 200MB 数据,API 网关 OOM,CDN 回源流量飙升。
改成明确字段后,响应体积从 200MB → 120KB,接口成功率从 78% → 99.99%。
另外,SELECT * 还会有如下问题:
增加解析成本:每次需要根据元数据信息多一次解析成具体字段的操作
阻止覆盖索引(Covering Index)生效
表结构变更时容易引发兼容性问题
误区13:IN 比 OR 快,所以永远用 IN
案例19:IN 列表太长,反而变慢
有个批量查询接口:
SELECT * FROM customer_info WHERE id IN (1,2,3,...,50000);
开发听说 “IN 比 OR 快”,就放心用了。
但 MySQL 对 IN 列表过长时,优化器可能放弃索引,转而全表扫描(尤其当列表无序、重复多时)。
实测:5 万个 ID 的 IN 查询,耗时 12 秒;拆成 50 次 1000 个 ID 的查询,总耗时 1.8 秒。
建议:IN 列表控制在 1000 以内(200以内更好),超长用临时表或分批查。
误区14:主键必须是自增 INT
案例20:分布式系统硬塞自增ID
微服务架构下,订单服务部署在多个实例,开发坚持用 AUTO_INCREMENT 主键,结果后期出现了问题:
要依赖数据库生成ID,无法本地预分配
分库后 ID 冲突风险高
扩容困难
数据合并困难
后来改用 Snowflake 或 UUID(有序版),虽然主键变长,但解耦了服务与数据库,吞吐量翻倍。
TIPS:
InnoDB 的聚簇索引确实偏好短、单调递增的主键,但业务可扩展性 > 微小性能差异
即使使用自增方式,也建议用bigint,以免int被用尽
如果下游有分布式数据库做统计等,更建议用雪花算法生成
误区15:TEXT/BLOB 字段不能放 InnoDB 表里
案例21:把内容表拆到 MyISAM,后悔莫及
为“避免影响性能”,开发把文章内容(TEXT)单独建 MyISAM 表。结果出现了如下问题:
无法和主表事务一致
崩溃后数据丢失
不支持行锁,编辑冲突频发
其实 InnoDB 从 5.6 起已优化大字段存储(off-page),只要不频繁 UPDATE 大字段,完全可用。如果项目已经引入了MongoDB等数据库,则也可以考虑将此内容存放在其他数据库中。
误区16:用 TRUNCATE 比 DELETE 快,所以清表都用它
案例22:TRUNCATE 导致主从不一致
运维脚本用 TRUNCATE logs 清日志表。但在某些 MySQL 版本(如 5.6), TRUNCATE在binlog 中记录为DDL,从库可能因权限或结构差异执行失败,导致主从中断。另外,TRUNCATE是DDL操作,如果表特别大,执行此操作时,也会全局影响数据库的性能。
安全做法:用分批删,既能走索引,又保证主从一致,性能也相对稳定。
DELETE FROM logs WHEREcreate_time >=... andcreate_time < ...
当然,也不是绝对的。 如果表特别大,delete删除会耗费很多时间,且产生大量的binlog,分批DELETE删需要有足够的空间,且控制休眠等,此时就需要考虑在业务低峰期用truncate方式清理。
误区17:开启 query_cache 能提升性能
案例23:Query Cache 反成性能杀手
某老系统开着 query_cache_type=ON。表面看“命中率高”,但高并发下,任何写操作都会导致相关缓存全部失效(Cache Invalidation),引发“缓存雪崩式锁竞争”。
MySQL 8.0 直接移除了 Query Cache,就是因为它在现代多核环境下弊大于利。
因此建议:除非是极低频更新的只读系统,否则关闭 Query Cache。
误区18:VARCHAR(255) 是默认“标准长度”,都用这个类型
案例24:255 引发的索引长度超限
开发习惯性写 VARCHAR(255),后来想给 email 字段建唯一索引,结果报错:
Specified key was too long; max key length is 767 bytes
因为 utf8mb4 下,255 × 4 = 1020 字节 > 767。
解决方案:改为 VARCHAR(191)(191×4=764)或升级到 MySQL 5.7+ 并开启 innodb_large_prefix=ON。
更深层问题:过长的 VARCHAR 会浪费内存(排序、临时表)、增加行大小,影响页利用率。
误区19:EXPLAIN 显示 “Using index” 就一定高效
案例25:覆盖索引查了 100 万行
SELECT user_id FROM orders WHERE status = 'paid';
idx_status_user (status, user_id) 是覆盖索引,EXPLAIN 显示 “Using index”。
但 status = 'paid' 有 120 万行!虽然没回表,但扫描 120 万索引项依然很慢。
优化方式:加时间范围 AND create_time > NOW() - INTERVAL 7 DAY,或业务上分页/聚合。
记住:“Using index” 只说明没回表,不代表扫描行数少。
误区20:MySQL 会自动选择最优索引
案例26:优化器选错索引,QPS 跌 90%
一张商品表有以下2个索引:
idx_category (category_id)idx_price (price)
查询:
SELECT category_id ,price FROM productsWHERE category_id = 10 AND price BETWEEN 100 AND 200;
MySQL 估算 category_id=10 有 5 万行,price 范围有 8 万行,于是选了 idx_price。
但实际 category_id=10 AND price... 只有 200 行!
优化操作:强制使用联合索引 (category_id, price),或用 ANALYZE TABLE 更新统计信息(优化器依赖统计信息,而统计信息可能过期或不准)
误区21:用 NULL 节省空间
案例27:NULL 导致索引失效 + 逻辑混乱
用户表 phone VARCHAR(20) DEFAULT NULL,查询“有手机号的用户”:
SELECT * FROM users WHERE phone != '';
结果漏掉所有 phone IS NULL 的记录!正确写法应是 phone IS NOT NULL AND phone != ''。更糟的是,NULL 值在索引中特殊处理,<>可能导致范围查询失效。
建议:能不用 NULL 就不用,用空字符串或默认值代替,逻辑更清晰,索引更可靠。
误区22:批量 UPDATE 用一条 SQL 更快
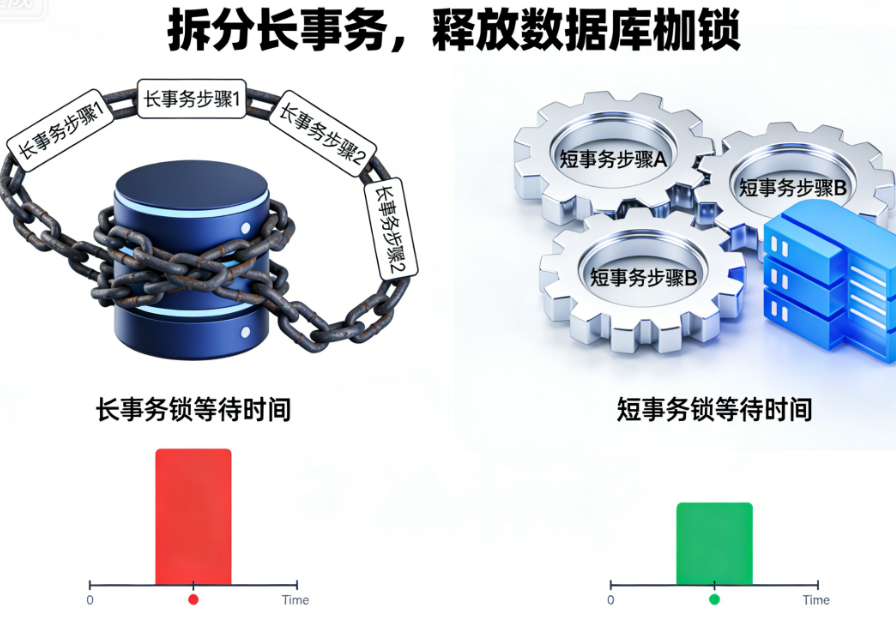
案例28:一条 UPDATE 锁表 3 分钟
运营要给 50 万用户发积分:
UPDATE users SET points = points + 10 WHERE status = 'active';
结果InnoDB 行锁升级为间隙锁+临键锁,阻塞所有用户登录、下单操作。
推荐的做法应该是:因为当前系统不建议降级隔离级别,因此建议分批更新,每 1000 条提交一次,并加 ORDER BY id LIMIT 1000 避免锁跳跃。
误区23:备份用 mysqldump 就够了
案例29:mysqldump 锁表导致服务不可用
凌晨 2 点跑 mysqldump --all-databases,没加 --single-transaction。
结果MyISAM 表被 LOCK,InnoDB 表虽不锁但一致性差,备份期间 API 超时率飙升。
生产环境备份建议:
InnoDB:用 --single-transaction --routines --triggers 等参数
超大库:用 xtrabackup 热备
定期验证备份可恢复性!
误区24:连接池越大越好
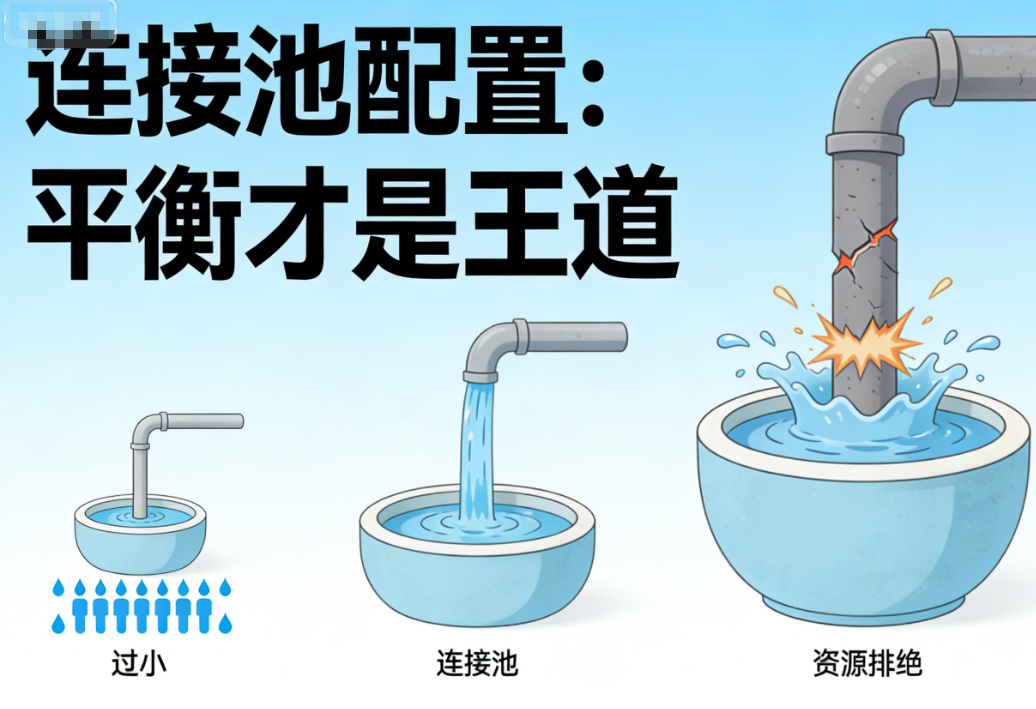
案例30:max_connections=10000,结果全卡死
应用配置连接池 2000(10个节点),数据库 max_connections=10000。
高峰期并发激增,大量连接 idle 占用内存,MySQL 内存耗尽,开始 swap,整体变慢。
原因:连接数 ≠ 并发能力。每个连接消耗 ~256KB 内存,还占用线程资源。
建议:用 thread_pool(MySQL企业版或percona分支)或中间件(ProxySQL)复用连接。
误区25:utf8 就是真正的 UTF-8
案例31:用户昵称存不下表情符
开发用 CHARSET=utf8 存用户昵称。结果用户输入 “👨👩👧👦”(家庭 emoji),MySQL 报错:Incorrect string value。
因为 MySQL 的 utf8 实际是 utf8mb3,最多 3 字节,而 emoji 需要 4 字节。
建议用utf8mb4并确保:
表字符集:CHARSET=utf8mb4
连接字符集:SET NAMES utf8mb4
应用层也使用utf8(真正的UTF8)
误区26:外键能保证数据一致性,所以要用
案例32:外键拖垮写入性能
订单表加了外键指向用户表,结果每插入一条订单,都要查用户是否存在,高并发下外键检查成为瓶颈,且难以分库。
高并发场景建议:应用层保证一致性(如先查用户是否存在),放弃数据库外键,换取扩展性及性能。
误区27:SHOW PROCESSLIST 能看到所有慢查询
案例33:慢查询“消失”了
排查性能问题,SHOW PROCESSLIST 看不到慢 SQL,以为就是没有慢查询了。原来那些SQL已经执行完但很慢,而PROCESSLIST 只显示“正在执行”的。
正确做法:开启慢SQL监控slow_query_log,定期用pt-query-digest分析历史慢日志
误区28:GROUP BY 自动排序,所以不用 ORDER BY
案例34:分页数据乱跳
SELECT user_id, COUNT(*) FROM orders GROUP BY user_id LIMIT 10;
开发按照以往经验以为GROUP BY会按 user_id 排序,但 MySQL 8.0 后默认不再隐式排序!结果每次分页数据顺序不一致,用户看到重复/跳过记录,因此如果需要按照指定字段排序时,必须显式加ORDER BY user_id。
误区29:临时表都是内存表,很快
案例35:临时表写磁盘,IO 爆了
复杂报表用子查询生成临时表,当临时表超过 tmp_table_size(默认 16MB),MySQL 会自动转成MyISAM磁盘表,引发大量磁盘 IO。
建议:
优化 SQL 减少中间结果
监控Created_tmp_disk_tables 指标
调大 tmp_table_size 和 max_heap_table_size
误区30:MySQL 8.0 新特性越多越好,赶紧升级
案例36:升级后索引失效
某项目从5.7 升级到 8.0,发现部分查询反而变慢了。
原因是MySQL 8.0 默认 sql_mode 更严格,且直方图统计、降序索引等新特性需手动启用,旧索引策略可能不再最优,从而导致原先可能不慢的SQL因为索引使用不当而变慢。
因此,在做数据库升级前务必做如下操作:
全量回归测试
检查 sql_mode 兼容性
重新分析表统计信息
别盲目开新特性
误区31:“默认配置够用”
很多人装完MySQL就直接跑生产。结果发现经常出现慢SQL,系统出现卡顿现象,检查参数发现都是默认值,尤其是:
innodb_buffer_pool_size 还是128MB(机器有64GB内存)
max_connections 是151,高峰期连接拒绝
slow_query_log 没开,出了问题找不到慢SQL
大小写
IO参数
内存参数等
建议至少检查并调整如下参数:
innodb_buffer_pool_sizeinnodb_buffer_pool_instancesinnodb_log_buffer_sizetmp_table_sizemax_heap_table_sizemax_connectionsthread_cache_sizetable_open_cacheinnodb_io_capacityinnodb_io_capacity_maxinnodb_flush_log_at_trx_commitsync_binloginnodb_log_file_sizesort_buffer_sizejoin_buffer_sizeread_buffer_sizeslow_query_logserver_idlower_case_table_namesoptimizer_switchtime_zone
误区32:“ORM框架不用管SQL”
用 Hibernate、MyBatis 的同学常说:“我不管SQL,框架会优化。”结果自动生成的 N+1 查询、SELECT *、无索引字段排序,比手写SQL还烂。
建议:定期抓取生产慢日志,反向推动开发优化 ORM 用法。比如:
禁止 fetchType=EAGER;
强制分页必须带索引字段;
禁止在循环里调 DAO。
结语:
最后说几句掏心窝的话:MySQL 优化,不是“知道多少技巧”,而是知道哪些事情绝对不能做。很多“优化”,其实是过度设计、盲目跟风、懒于验证的结果。
真正负责的DBA经常做的事是:
看慢日志
跑 EXPLAIN
测压生产影子流量
和开发一起了解业务
愿你写的每一行 SQL,都能在深夜安静地跑完,不惊醒任何一个战友。
如果你也曾被某个“常识”坑过,欢迎留言分享,点赞+在看,让更多战友绕开这些雷区!
也麻烦大家关注微信公众号“数据库干货铺”。
