



引言:物化视图不是“银弹”,选对刷新策略才是关键
在StarRocks中,物化视图(Materialized View, MV)被广泛用于加速聚合查询、预计算维度下钻、减少重复计算等场景。然而,StarRocks提供了三种刷新策略:
异步自动刷新(Async) 同步自动刷新(Sync) 手动刷新(Manual)
许多团队在初次使用时,往往只关注“建了MV就能提速”,却忽略了刷新策略对数据新鲜度、资源消耗与查询性能三者平衡的深远影响。
一、StarRocks物化视图刷新机制详解
1.1 三种刷新策略的核心区别
| 同步刷新(Sync) | 强一致(写后立即可见) | |||
| 异步刷新(Async) | 最终一致(延迟秒~分钟级) | |||
| 手动刷新(Manual) | REFRESH MATERIALIZED VIEW | 按需一致 |
⚠️ 注意:StarRocks 3.0+ 版本中,同步刷新仅支持 Duplicate Key 模型 且 无聚合函数 的简单投影型物化视图。一旦包含
COUNT
、SUM
等聚合,系统会自动降级为异步刷新。
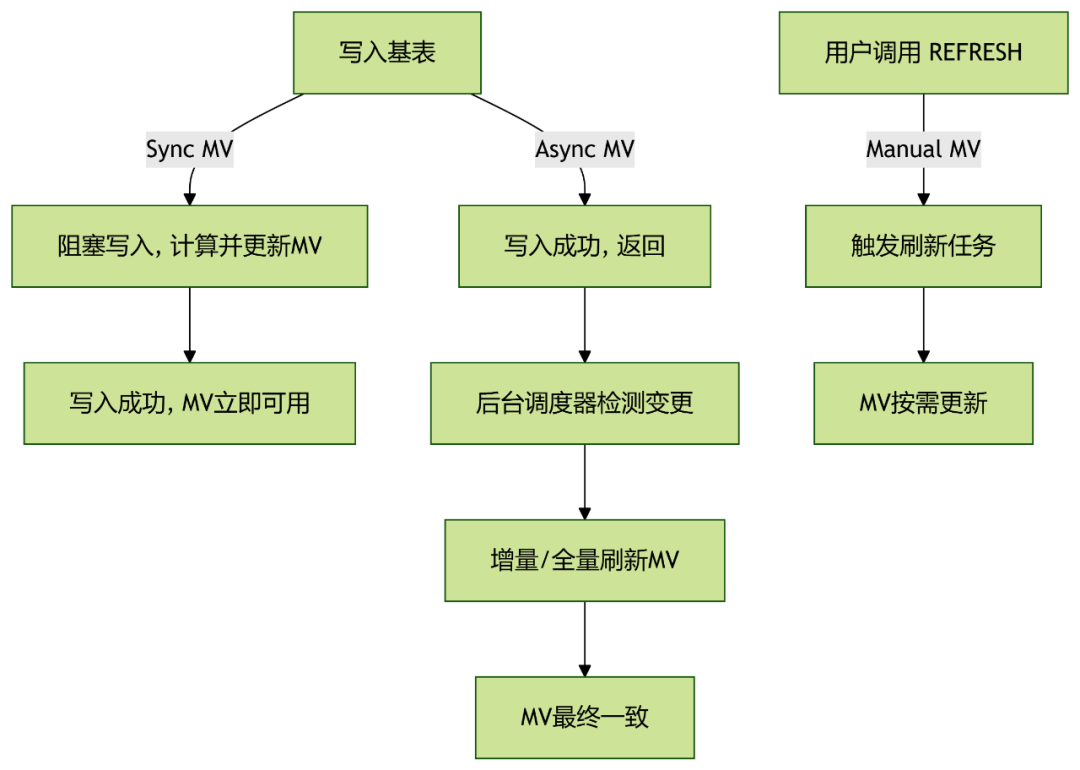
1.2 刷新流程对比
二、真实使用体验与反思
2.1 案例1:广告实时看板(异步刷新的胜利)
业务背景:
某广告平台需实时展示“每小时广告点击率(CTR)”,数据源为 Kafka → StarRocks(Aggregate 模型),每秒写入 5k+ 行。
初始方案:
尝试使用 同步刷新 的物化视图:
CREATE MATERIALIZED VIEW mv_ctr_sync
DISTRIBUTED BY HASH(ad_id) BUCKETS 10
REFRESH SYNC
AS
SELECT
  ad_id,
  date_trunc('hour', event_time) AS hour,
sum(clicks)  sum(impressions) AS ctr
FROM ad_events
GROUP BY ad_id, hour;
问题:
写入延迟飙升至 2–3 秒(原为 200ms) MV 因含聚合函数,实际被降级为异步刷新,但用户误以为是同步,导致看板数据“看似实时实则滞后”
优化方案:
改用 异步刷新 + 合理刷新间隔:
CREATE MATERIALIZED VIEW mv_ctr_async
REFRESH ASYNC EVERY(30 SECOND)
AS
SELECT
  ad_id,
  date_trunc('hour', event_time) AS hour,
sum(clicks) AS total_clicks,
sum(impressions) AS total_impr,
sum(clicks)  sum(impressions) AS ctr
FROM ad_events
GROUP BY ad_id, hour;
效果:
写入延迟恢复至 250ms 看板数据延迟稳定在 30–60 秒 查询 QPS 提升 8 倍(原 120 QPS → 980 QPS)
✅ 反思:不要被“Sync”标签迷惑,先确认 StarRocks 是否支持该 MV 类型的同步刷新。
2.2 案例2:风控规则引擎(手动刷新更稳)
业务背景:
金融风控系统需每日凌晨基于用户行为日志生成“高风险用户画像”,用于次日规则匹配。
错误尝试:
使用异步刷新,设 EVERY(1 HOUR)
,但因日志表夜间批量导入(100GB+),MV 刷新任务频繁超时失败。
正确做法:
改用 手动刷新 + 调度系统联动:
# Airflow DAG 中
starrocks_query("REFRESH MATERIALIZED VIEW mv_risk_profile;")
优势:
避免后台刷新任务与 ETL 争抢资源 可在数据导入完成后精准触发 失败可重试,不影响主流程
✅ 反思:对 T+1 或批处理场景,手动刷新提供更强的可控性与稳定性。
2.3 案例3:用户画像标签(同步刷新的有限适用)
业务背景:
用户标签系统需在用户更新手机号后立即生效,用于客服系统查询。
方案:
使用 Duplicate Key 模型 + 投影型 MV(无聚合),启用同步刷新:
-- 基表
CREATE TABLE user_profile (
  user_id BIGINT,
  phone VARCHAR(20),
  email VARCHAR(100)
) ENGINE=OLAP
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10;

-- 物化视图(仅投影)
CREATE MATERIALIZED VIEW mv_user_phone
REFRESH SYNC
AS
SELECT user_id, phone FROM user_profile;
结果:
用户更新后,客服系统立即查到新手机号 写入延迟仅增加 5–10ms
✅ 反思:同步刷新仅适用于简单投影,且写入量不能太大(< 1k TPS)。
三、性能对比实验(实测数据)
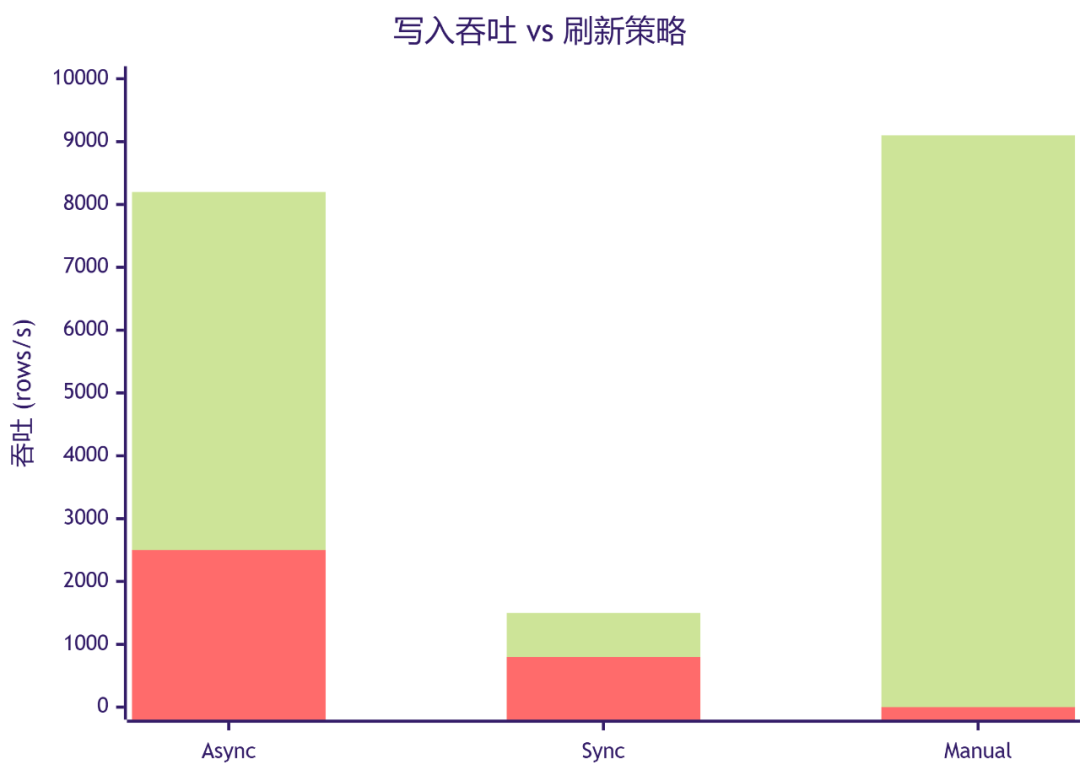
我们在 StarRocks 3.1 集群(3 BE + 1 FE)上进行基准测试:
📊 可视化对比:
结论:
异步/手动显著提升写入吞吐 同步仅在低频更新场景可行 查询延迟三者差距不大(因都命中MV)
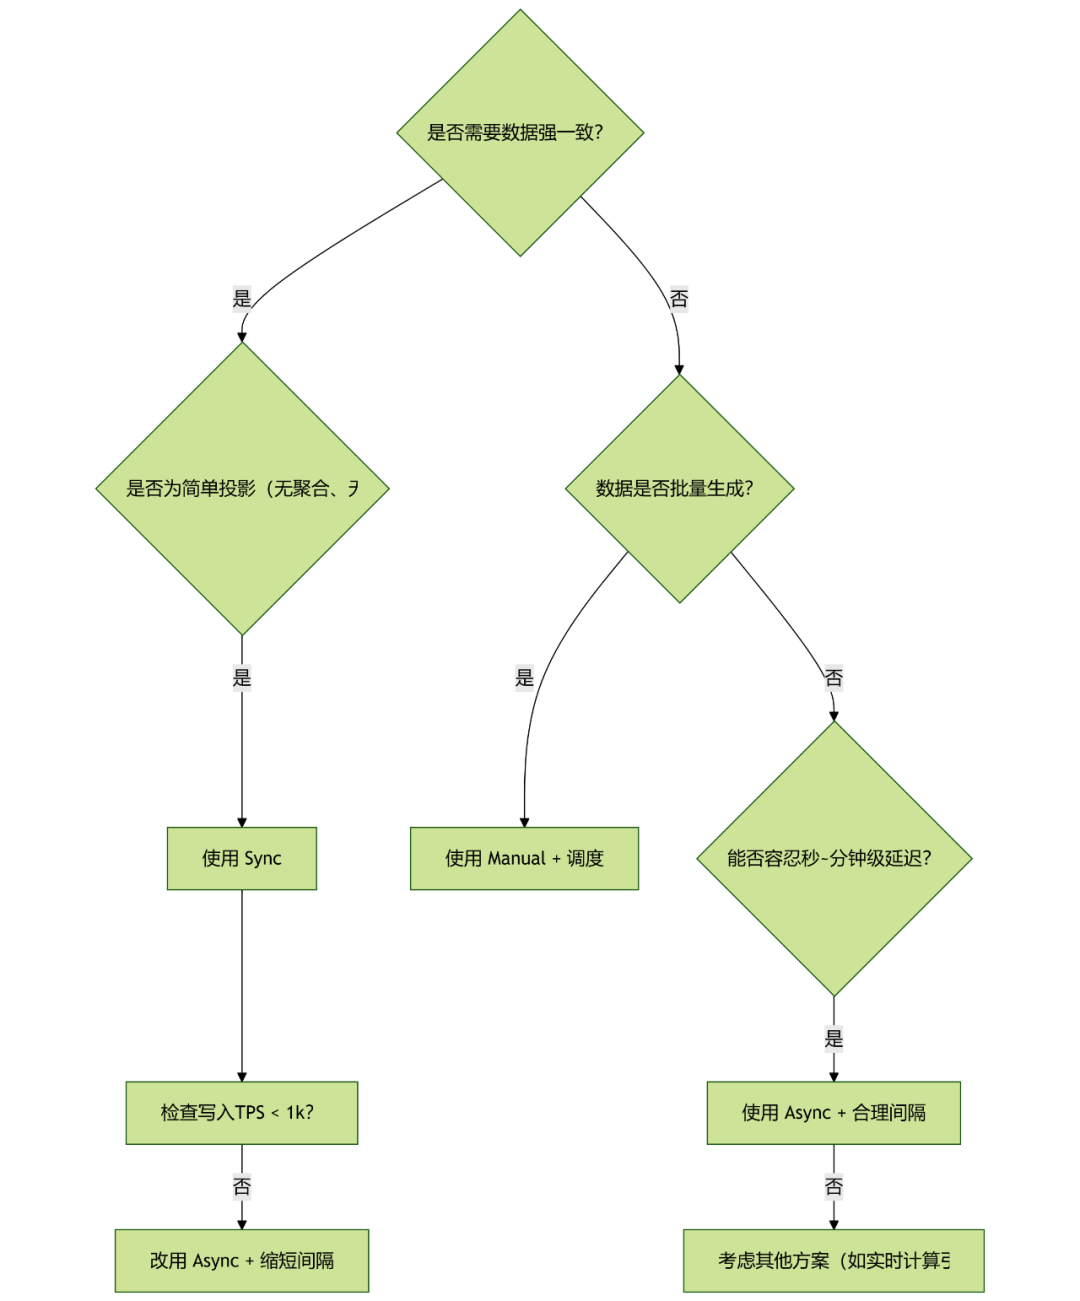
四、选型决策树:三步确定最佳策略
五、落地建议与最佳实践
5.1 异步刷新(推荐大多数场景)
设置合理间隔:高频数据用 EVERY(10–60 SECOND)
,低频用EVERY(5–30 MINUTE)监控刷新任务:通过 SHOW PROC '/routine_load_job'
或information_schema.task_runs
跟踪失败避免大表全量刷新:确保基表有合理分区,MV 可增量刷新
5.2 同步刷新(谨慎使用)
仅用于 Duplicate Key 模型 + 投影型 MV 写入量控制在 1k TPS 以内 务必实测写入延迟影响
5.3 手动刷新(批处理首选)
与 Airflow/DolphinScheduler 等调度系统集成 在数据导入完成后触发 可配合 REFRESH MATERIALIZED VIEW mv PARTITION (p20251220)
实现分区级刷新
结语:没有“最好”,只有“最合适”
StarRocks 的物化视图刷新策略不是功能堆砌,而是在一致性、性能与成本之间做权衡的艺术。我们在实践中发现:
80% 的场景适合异步刷新,15% 适合手动,仅 5% 能用同步。
关键在于理解业务对数据新鲜度的真实容忍度,而非盲目追求“实时”。希望本文的案例与决策框架,能帮你避开我们踩过的坑,真正发挥 StarRocks MV 的性能潜力。
资
料
下
载
广告人士勿入,切勿轻信私聊,防止被骗
点下方的“❤”支持我们,非常感谢!
