



在AI应用开发如火如荼的今天,一款名为seekdb的数据库正悄然改变着开发者处理数据的方式。
过去一年,AI应用开发面临一个现实困境:传统数据库对于AI场景显得笨重,而轻量级数据库又在功能上有所欠缺。这一僵局在2025年11月18日被打破——蚂蚁集团旗下OceanBase发布了首款AI数据库seekdb,并宣布开源。
作为专为AI时代打造的数据库产品,seekdb的出现让开发者仅用三行代码就能快速构建知识库、智能体等AI应用,轻松应对百亿级多模数据检索。
1. 什么是seekdb?
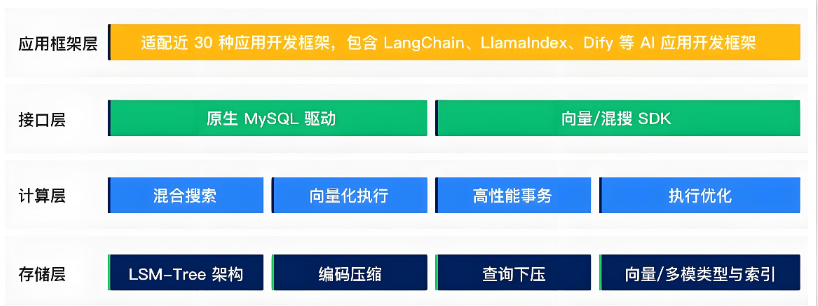
seekdb不是传统数据库的功能叠加,而是专为AI时代重构的AI原生数据库。它深度融合AI推理与数据处理能力,支持向量、全文、标量及空间地理数据的统一混合搜索。
与传统数据库仅仅“存储”数据不同,seekdb能 “理解”数据语义。这一突破使得开发者能够在一个数据库中同时支撑事务、分析与AI混合搜索,在数据源头驱动实时、可信的智能。
seekdb完全兼容MySQL协议,同时具备轻量级和高性能的特点。最低仅需1核CPU、2GB内存即可运行,让个人开发者甚至在笔记本上就能轻松体验企业级数据库的能力。
2. 快速部署:多种方式满足不同需求
seekdb提供多种部署方式,适应从开发测试到生产环境的不同需求。
2.1 docker方式
Docker部署是最快的方式,适合快速体验和测试环境:
docker pull oceanbase/seekdb:latestdocker run -d --name seekdb -p 2881:2881 oceanbase/seekdb:latest
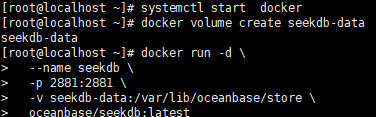
等待约30秒,看到“boot success”提示即表示启动完成。
2.2 二进制方式
二进制包安装适合Linux生产环境。通过yum工具可快速安装:
sudo yum-config-manager --add-repo https://mirrors.aliyun.com/oceanbase/OceanBase.reposudo yum install seekdb obclientsudo systemctl start seekdb
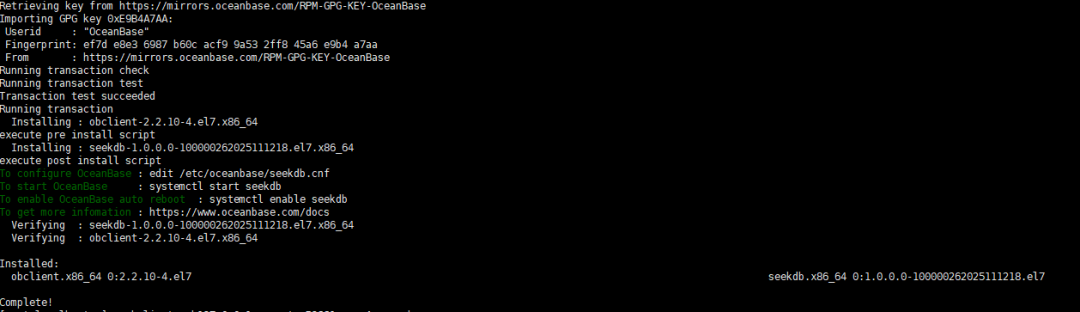
docker或二进制方式部署完毕后,可以使用客户端进行操作。
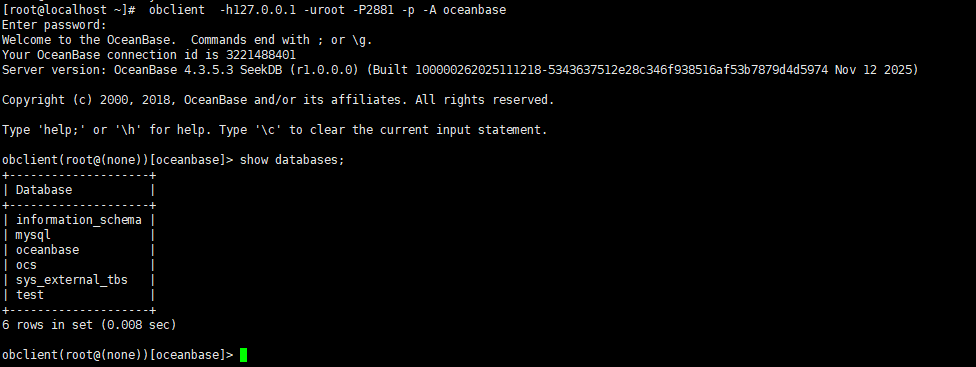
也可以做建表、查询等操作
obclient(root@(none))[oceanbase]> use test;Database changedobclient(root@(none))[test]> create table tb1(id int primary key,name varchar(20));Query OK, 0 rows affected (0.250 sec)obclient(root@(none))[test]> insert into tb1 select 1,'a';Query OK, 1 row affected (0.022 sec)obclient(root@(none))[test]> select * from tb1;+------+------+| id | name |+------+------+| 1 | a |+------+------+1 row in set (0.009 sec)obclient(root@(none))[test]> select now();+---------------------+| now() |+---------------------+| 2025-12-28 19:50:50 |+---------------------+1 row in set (0.003 sec)
2.3 嵌入式模式
嵌入式模式是seekdb的一大亮点,特别适合AI应用和原型设计。在Python应用中,可以将其作为库直接使用:
先安装seekdb
pip3 install pyseekdb
之后就可以在python应用中使用seekdb
import pyseekdbclient = pyseekdb.Client(path="./seekdb.db", database="test")
这种模式下,seekdb自动管理生命周期,无需独立的服务器进程,适合临时开发使用。
正式使用还是建议使用独立的seekdb进行,例如下面两个例子:
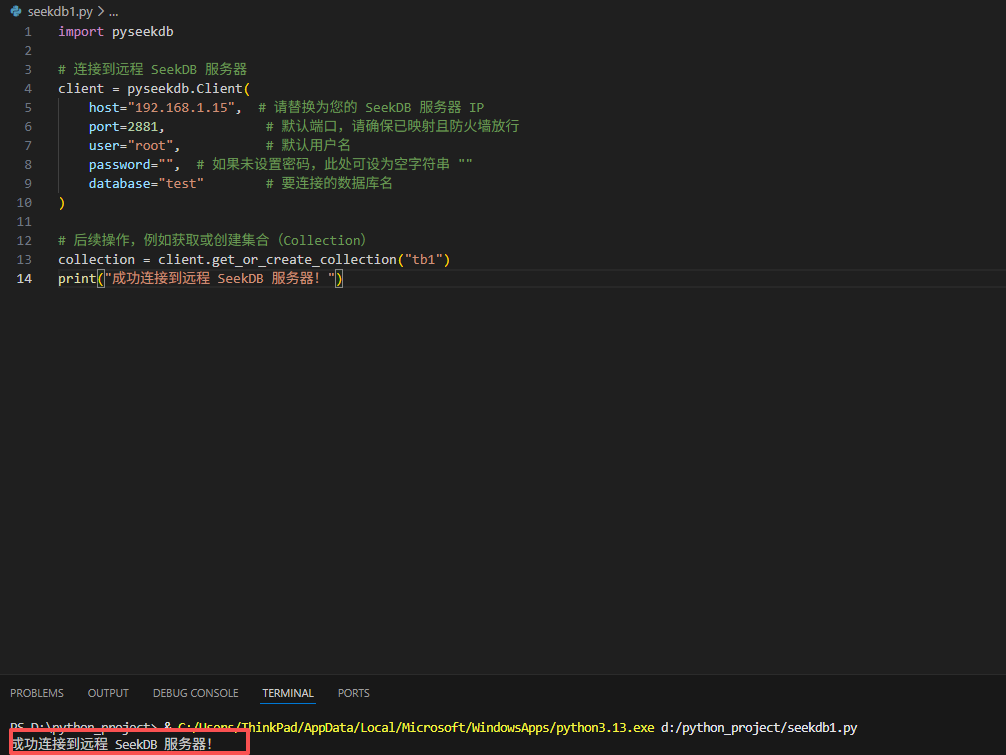
远程测试连接
import pyseekdb# 连接到远程 SeekDB 服务器client = pyseekdb.Client(host="192.168.1.15", # 请替换为您的 SeekDB 服务器 IPport=2881, # 默认端口,请确保已映射且防火墙放行user="root", # 默认用户名password="", # 如果未设置密码,此处可设为空字符串 ""database="test" # 要连接的数据库名)# 后续操作,例如获取或创建集合(Collection)collection = client.get_or_create_collection("tb1")print("成功连接到远程 SeekDB 服务器!")
结果如下:
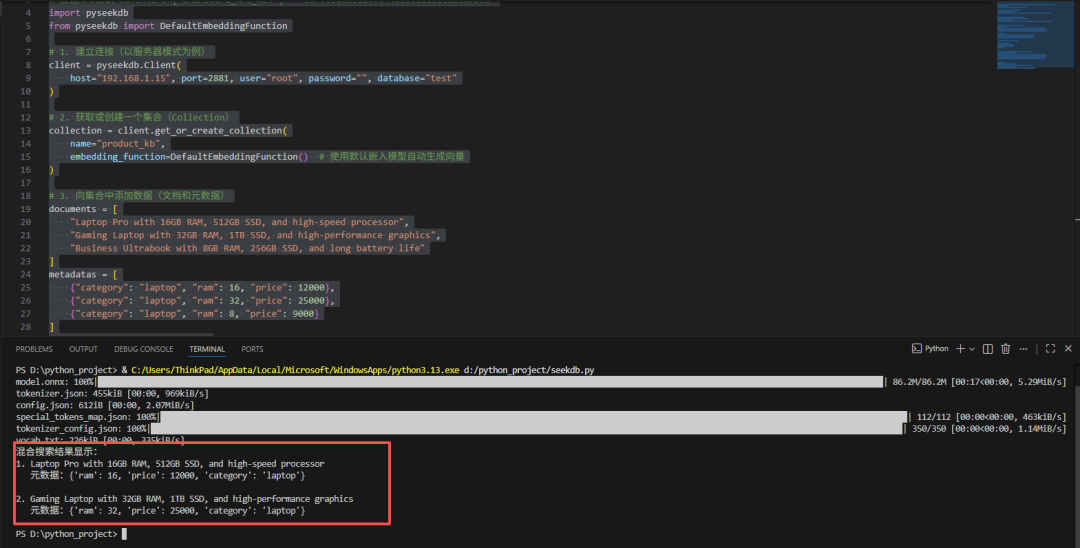
执行混合搜索
# 设置API密钥 os.environ["DASHSCOPE_API_KEY"] = "sk-799a659d10f644db9521192032587956"import pyseekdbfrom pyseekdb import DefaultEmbeddingFunction# 1. 建立连接(以服务器模式为例)client = pyseekdb.Client(host="192.168.1.15", port=2881, user="root", password="", database="test")# 2. 获取或创建一个集合(Collection)collection = client.get_or_create_collection(name="product_kb",embedding_function=DefaultEmbeddingFunction() # 使用默认嵌入模型自动生成向量)# 3. 向集合中添加数据(文档和元数据)documents = ["Laptop Pro with 16GB RAM, 512GB SSD, and high-speed processor","Gaming Laptop with 32GB RAM, 1TB SSD, and high-performance graphics","Business Ultrabook with 8GB RAM, 256GB SSD, and long battery life"]metadatas = [{"category": "laptop", "ram": 16, "price": 12000},{"category": "laptop", "ram": 32, "price": 25000},{"category": "laptop", "ram": 8, "price": 9000}]ids = ["doc1", "doc2", "doc3"]collection.upsert(documents=documents,metadatas=metadatas,ids=ids)# 4. 执行混合查询:结合语义、元数据过滤和全文检索results = collection.query(query_texts="powerful computer for professional work", # 语义搜索where={"category": "laptop", "ram": {"$gte": 16}}, # 元数据过滤where_document={"$contains": "RAM"}, # 全文检索n_results=2 # 返回数量)# 5. 处理结果print("混合搜索结果显示:")for i, doc in enumerate(results['documents'][0]):print(f"{i+1}. {doc}")print(f" 元数据:{results['metadatas'][0][i]}\n")
三行代码
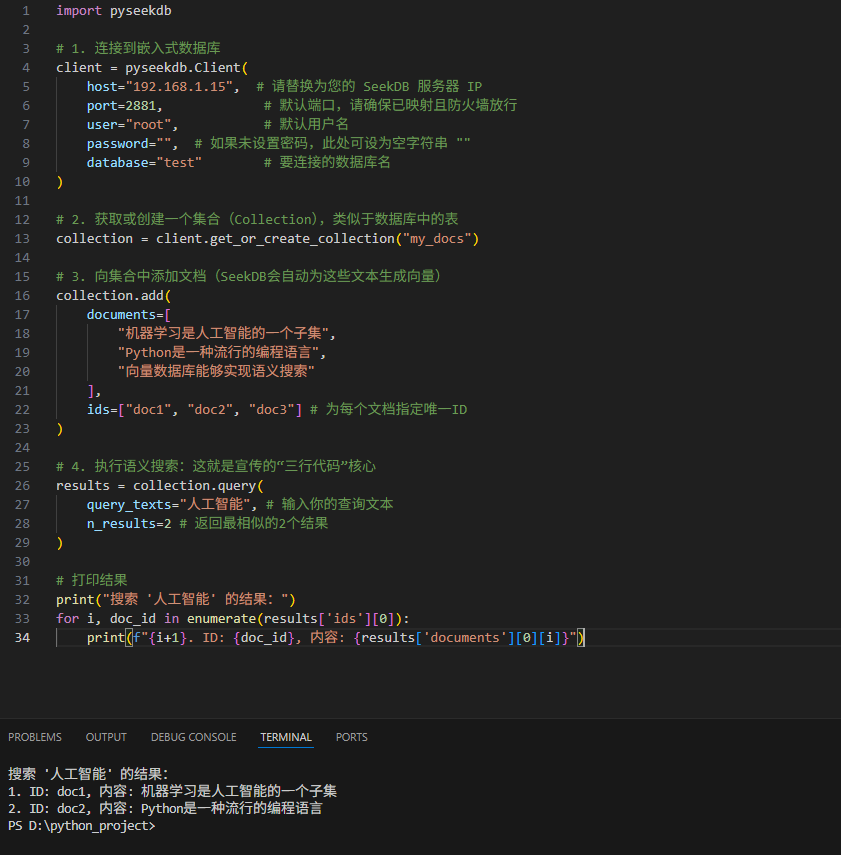
回到标题所说的,3行代码搞定AI搜索的例子
import pyseekdb# 1. 连接到嵌入式数据库client = pyseekdb.Client(host="192.168.1.15", # 请替换为您的 SeekDB 服务器 IPport=2881, # 默认端口,请确保已映射且防火墙放行user="root", # 默认用户名password="", # 如果未设置密码,此处可设为空字符串 ""database="test" # 要连接的数据库名)# 2. 获取或创建一个集合(Collection),类似于数据库中的表collection = client.get_or_create_collection("my_docs")# 3. 向集合中添加文档(SeekDB会自动为这些文本生成向量)collection.add(documents=["机器学习是人工智能的一个子集","Python是一种流行的编程语言","向量数据库能够实现语义搜索"],ids=["doc1", "doc2", "doc3"] # 为每个文档指定唯一ID)# 4. 执行语义搜索:这就是宣传的“三行代码”核心results = collection.query(query_texts="人工智能", # 输入你的查询文本n_results=2 # 返回最相似的2个结果)# 打印结果print("搜索 '人工智能' 的结果:")for i, doc_id in enumerate(results['ids'][0]):print(f"{i+1}. ID: {doc_id}, 内容: {results['documents'][0][i]}")
3. SeekDB能做什么?——真实案例场景
场景1:企业知识库,让文档"活"起来
以前,构建一个企业知识库需要如下组件
用MySQL存储文档元数据
用Elasticsearch处理关键词搜索
用向量数据库处理语义搜索
现在,用SeekDB只需三行代码:
# 三行代码,构建企业知识库
client = SeekDB.Client()client.create_collection("company_knowledge")client.add_documents(["公司政策文档", "产品说明书"])
实际效果:员工问"新员工入职流程是什么?",系统能准确理解语义,返回最相关文档,而非只匹配关键词。
场景2:智能客服,响应更快更准
传统客服系统:需要多系统配合,响应慢,容易出错。
SeekDB实现:
# 智能客服问答def ask(question):results = collection.query(question, n_results=1)return results[0].content
效果:客户问"怎么修改密码?",系统能直接返回最准确的操作步骤,无需人工干预。
场景3:金融风控,毫秒级响应
金融场景要求:数据不出库,响应在毫秒级。
SeekDB实现:
# 金融风控查询results = collection.query("近7天交易超5万元、位置异常且行为类似历史欺诈样本",n_results=5)
效果:传统方案需要跨系统调用,耗时数秒;SeekDB在1秒内完成,数据安全无泄露。
4. SeekDB vs MySQL:能取代MySQL么
4.1 为什么SeekDB不叫"替代MySQL"?
SeekDB不是要取代MySQL,而是解决MySQL在AI场景下的不足。MySQL在传统业务系统中依然非常强大,SeekDB专注于AI应用开发,与MySQL形成互补。正如一位资深开发者所说:"我们公司同时在用MySQL处理订单系统,用SeekDB构建智能客服,两者配合得非常好。"(并不是某些人说的MySQL要被替代)
4.2 SeekDB是否可以替代MySQL?
答案是否定的。SeekDB和MySQL不是"你死我活"的关系,而是"各司其职"的搭档:
传统业务系统(订单、用户管理) 需要复杂事务处理的场景 成熟稳定的生产环境 | |
AI应用开发(RAG知识库、智能客服) 需要语义搜索的场景 资源有限的环境(边缘设备、小型应用) |
4.3 为什么要关注SeekDB?
随着AI应用,特别是RAG知识库、智能客服等场景用的越来越多,seekdb也需要和MySQL等传统数据库一样被关注,另外还有如下原因:
技术趋势:AI应用正在爆发,但数据处理复杂度高
国产替代:SeekDB是国产数据库的创新代表
易用性:三行代码就能上手,无需学习曲线
轻量级:最低配置1核2GB,普通电脑也能运行
正如OceanBase CEO杨冰所说:"AI的真正瓶颈不在模型,而在数据。"SeekDB正是为了解决这个瓶颈而生。它让AI开发从"复杂系统"变成"简单代码",专注于实现"数据驱动智能"。
5. 结语
正如知识库中所说:"SeekDB在继承了淘宝和支付宝背后的OceanBase数据库核心引擎高性能优势与MySQL全面兼容特性的基础上,通过深度优化数据搜索架构,为开发者提供了更符合AI应用数据处理需求的各项能力。"
