



OB 4.3.5 推出了堆表结构有一段时间了,在堆表之前 OB 的表数据组织特点一直是索引组织表。MySQL 用户对此习以为常,ORACLE 用户却是使用堆表习惯了。OB 的堆表跟 ORACLE 的堆表比起来是否又完全一样呢? 本文通过 OB 4.3.5 的堆表一些基础研究来回答这些问题。
堆组织表官方介绍
堆表配置和创建方法
索引组织表(Index Organized Table)
数据是按照主键存储和排序的,当往表中插入一行数据时,数据会按照其主键的顺序插入到表中。在这种结构下,数据和索引合二为一,主键为聚簇索引,主键不存在额外的空间开销,数据的访问也更加高效。
堆组织表(Heap Organized Table)
堆组织表(堆表)中的数据不会根据主键排序存储,当往表中插入一行数据时,数据的顺序是随机的。在这种结构下,主键索引实际为二级唯一索引,即非聚簇索引,数据和索引解耦,数据写入不需要考虑排序,使得数据的写入性能更佳。
OB 4.3.5 BP1 版本开始推出堆组织表。
首先是租户参数 default_table_organization
设置创建新表时默认的表组织模式。当前版本配置项 default_table_organization
仅适用于 OceanBase 数据库 MySQL 模式用户租户,sys
(系统)租户和 ORACLE
模式用户租户不支持。取值有 HEAP
和 INDEX
两种。
修改示例:
alter system set default_table_organization='HEAP';
show parameters like '%default_table_organization%';
其次也可以在建表的时候通过 ORGANIZATION = INDEX|HEAP
指定哪种表组织模式。如:
CREATE TABLE iot_demo (
    c1 INT PRIMARY KEY,
    c2 DATETIME)
    ORGANIZATION = INDEX
    WITHCOLUMNGROUP (eachcolumn);

CREATETABLE heap_demo (
    c1 INT PRIMARY KEY,
    c2 DATETIME)
    ORGANIZATION = HEAP
    WITHCOLUMNGROUP (eachcolumn);
堆组织表使用限制
按堆组织表存储数据的分区表的本地唯一索引键( Unique Key Local
)或堆组织表主键表的主键(Primary Key
),必须包含所有分区列(Partition Key
)。堆组织表创建索引时,索引名不能和主键第一列列名相同。 OceanBase 数据库堆组织表暂不支持以下 DDL 操作: 主键约束操作 修改列为主键 主键列类型长度由大改小 加主键列 修改主键为自增列 删主键列 分区分裂
索引组织表和堆表实验
查看和修改默认设置
[admin@server61 oceanbase]$ obclient -h127.1 -umq@SERVICE:s_mysql -P2883 -p'dbaDBA123' -c -A test
Welcome to the OceanBase.  Commands endwith ; or \g.
Your OceanBase connection id is 576865
Server version: OceanBase 4.3.5.2 (r102020032025061118-97ae08114e71f5cb7f2a8302e1f0a792d5c10bf8) (Built Jun 11 2025 19:06:44)

Copyright (c) 2000, 2018, OceanBase and/or its affiliates. All rights reserved.

Type 'help;' or '\h' for help. Type'\c'toclear the currentinput statement.

obclient(mq@SERVICE:s_mysql)[test]> showparameterslike'%default_table_organization%'\G
*************************** 1.row ***************************
         zone: zone1
     svr_type: observer
       svr_ip: 10.0.0.61
     svr_port: 2882
         name: default_table_organization
    data_type: STRING
        value: HEAP
         info: The default_organization configuration option allows you toset the defaulttableorganizationmodeto either HEAP (unordered datastorage) orINDEX (the datarowsare held in an index defined on the primary keyfor the table) when creating new tables.
      section: TENANT
        scope: TENANT
       source: DEFAULT
   edit_level: DYNAMIC_EFFECTIVE
default_value: INDEX
    isdefault: 0
1rowinset (0.007 sec)
OCP 为 4.3.5 版本新建 MySQL 租户给出的 OLAP 参数模板里已经默认将表组织格式调整为堆表(HEAP
)了。
collation_connection: utf8mb4_bin
collation_server: utf8mb4_bin
default_load_mode: FULL_DIRECT_WRITE
default_table_merge_engine: PARTIAL_UPDATE
default_table_organization: HEAP
default_table_store_format: column
direct_load_allow_fallback: 0
ob_query_timeout: 604800000000
ob_sql_work_area_percentage: 30
ob_trx_timeout: 604800000000
parallel_degree_policy: AUTO
parallel_min_scan_time_threshold: 10
_io_callback_thread_count: 64
_io_read_batch_size: 128K
_io_read_redundant_limit_percentage: 50
_nested_loop_join_enabled: false
新建一个普通堆表并初始化数据
DDL 建表测试
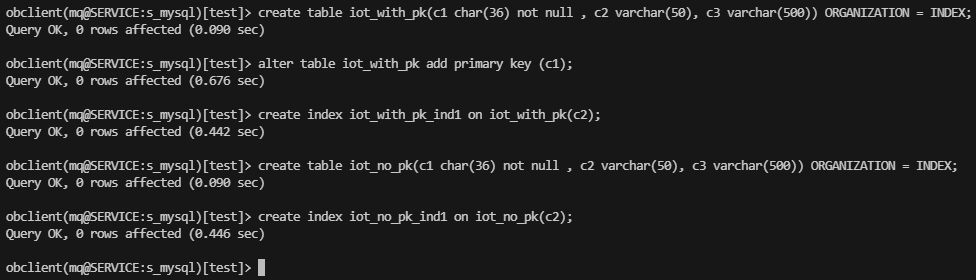
create table iot_with_pk(c1 char(36) not null , c2 varchar(50), c3 varchar(500)) ORGANIZATION = INDEX;
alter table iot_with_pk add primary key (c1);
create index iot_with_pk_ind1 on iot_with_pk(c2);

create table iot_no_pk(c1 char(36) not null , c2 varchar(50), c3 varchar(500)) ORGANIZATION = INDEX;
create index iot_no_pk_ind1 on iot_no_pk(c2);
create table heap_with_pk(c1 char(36) notnull , c2 varchar(50), c3 varchar(500)) ORGANIZATION = HEAP;
altertable heap_with_pk add primary key (c1);
droptableifexists heap_with_pk;
createtable heap_with_pk(c1 char(36) notnull primary key , c2 varchar(50), c3 varchar(500)) ORGANIZATION = HEAP;
createindex heap_with_pk_ind1 on heap_with_pk(c2);

createtable heap_no_pk(c1 char(36) notnull , c2 varchar(50), c3 varchar(500)) ORGANIZATION = HEAP;
createindex heap_no_pk_ind1 on heap_no_pk(c2);
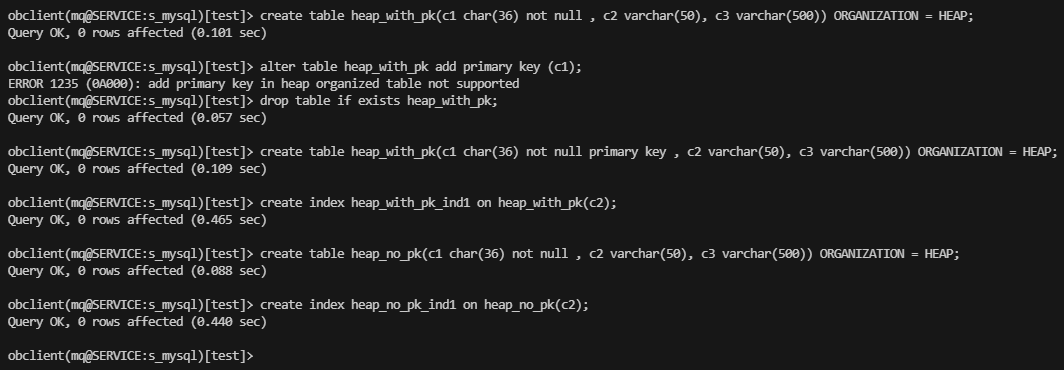
结论:暂不支持给堆表后期加主键。
加载测试数据
SET SESSION cte_max_recursion_depth = 100000;

INSERT/*+ append enable_parallel_dml parallel(4) */INTO iot_with_pk (c1, c2, c3)
WITHRECURSIVE numbers(n) AS (
    SELECT1
    UNIONALL
    SELECT n + 1
    FROM numbers
    WHERE n < 100000
)
SELECT
    UUID() as c1,
    CONCAT('Str_', LEFT(MD5(RAND()), 10)) as c2,
    REPLACE(CONCAT(
        'LongText_',
        MD5(RAND()), '_',
        MD5(RAND()), '_',
        MD5(RAND()), '_',
        MD5(RAND()), '_',
        MD5(RAND()), '_',
        'End'
    ), '-', '') as c3
FROM numbers;

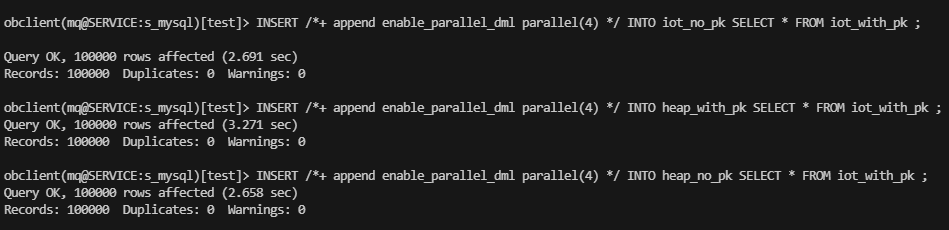
INSERT/*+ append enable_parallel_dml parallel(4) */INTO iot_no_pk SELECT * FROM iot_with_pk ;
INSERT/*+ append enable_parallel_dml parallel(4) */INTO heap_with_pk SELECT * FROM iot_with_pk ;
INSERT/*+ append enable_parallel_dml parallel(4) */INTO heap_no_pk SELECT * FROM iot_with_pk ;
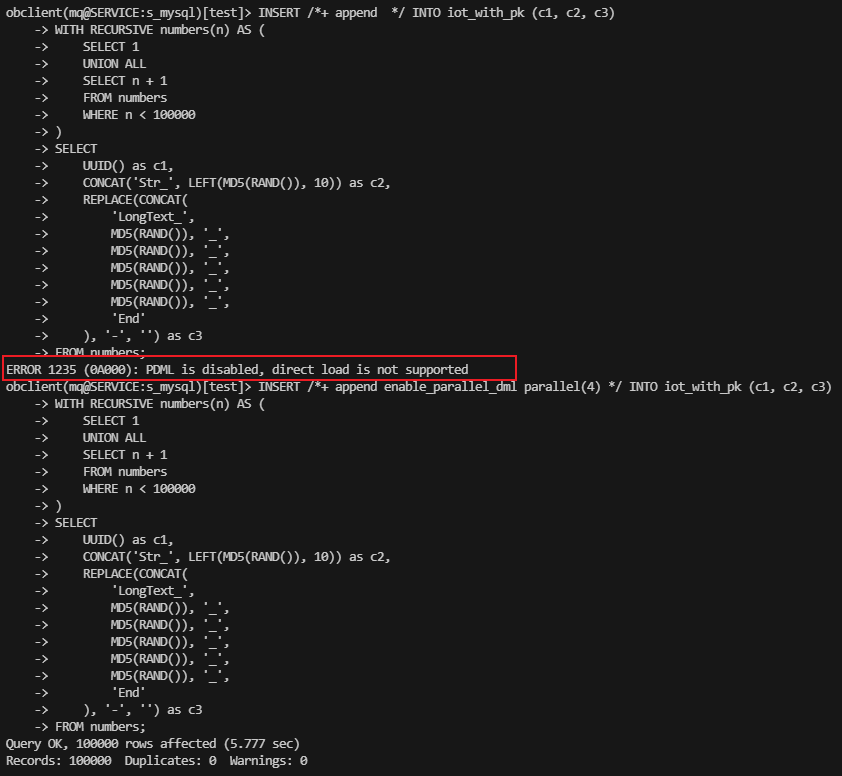
结论:需要开启 PDML 才能使用旁路写入。
合并一把。
alter system major freeze;
SELECT  * FROM  oceanbase.dba_OB_ZONE_MAJOR_COMPACTION;
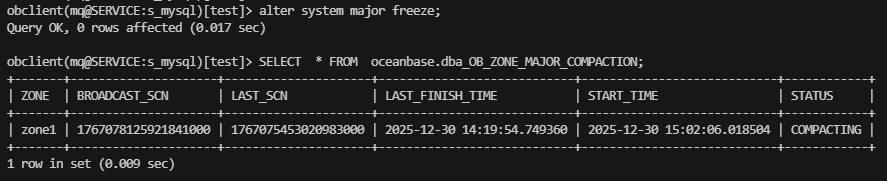
合并太慢了,加并发。
alter system set compaction_low_thread_score=16;
show parameters like '%compaction_low%'\G
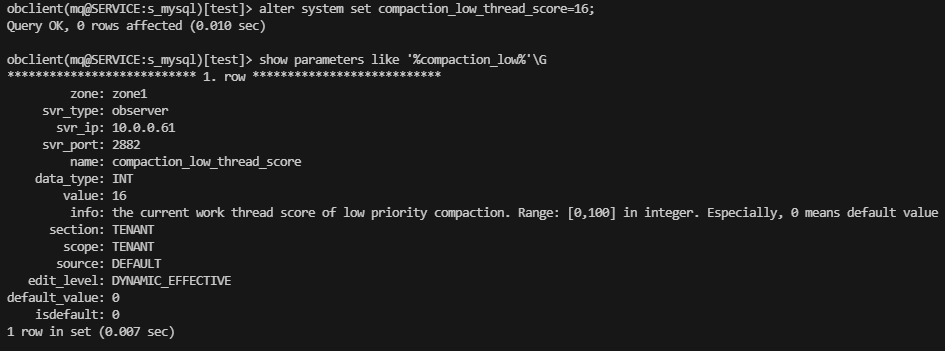
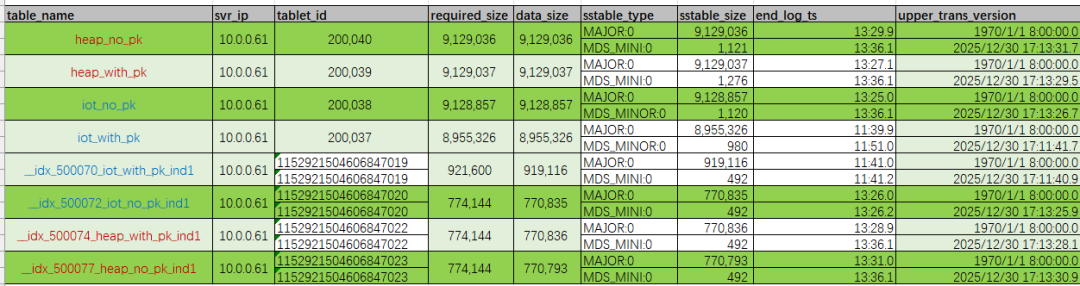
感觉合并还是很慢,看看这个表的存储情况。
SELECT /*+ read_consistency(weak) query_timeout(1000000000) */ t1.database_name, t1.table_name, t1.tablet_id, round(sum(t2.required_size)/1024) required_size_kb, count(*) cnt
FROM oceanbase.DBA_OB_TABLE_LOCATIONS t1
  JOIN oceanbase.DBA_OB_TABLET_REPLICAS t2 ON (t1.tablet_id=t2.tablet_id AND t1.ls_id=t2.ls_id and t1.svr_ip=t2.svr_ip and t1.SVR_PORT=t2.svr_port )
WHERE t1.ROLE='LEADER' and (t1.table_name like '%iot%' or t1.table_name like '%heap%')
GROUP BY t1.database_name, t1.table_name
;
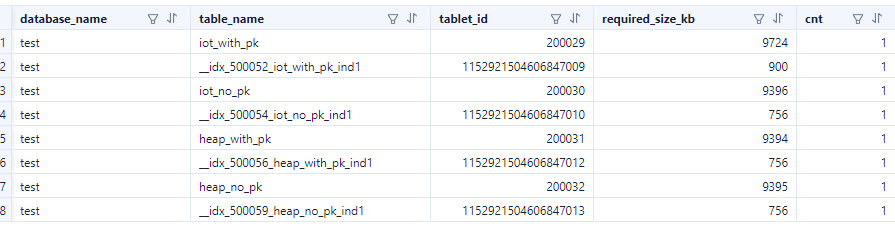
SELECT /*+ read_consistency(weak) query_timeout(1000000000) */ t1.table_name, t1.svr_ip, t1.tablet_id , t2.required_size, t2.data_size, concat(s.table_type, ':', s.cg_idx) sstable_type, s.size sstable_size, scn_to_timestamp(s.END_LOG_SCN) end_log_ts, scn_to_timestamp(s.upper_trans_version) upper_trans_ts
FROM oceanbase.DBA_OB_TABLE_LOCATIONS t1
  JOIN oceanbase.DBA_OB_TABLET_REPLICAS t2 ON (t1.tablet_id=t2.tablet_id AND t1.ls_id=t2.ls_id and t1.svr_ip=t2.svr_ip and t1.SVR_PORT=t2.svr_port )
  JOIN oceanbase.GV$OB_SSTABLES s ON (t1.ls_id=s.ls_id AND t1.svr_ip=s.svr_ip and t1.SVR_PORT =s.svr_port AND t1.tablet_id=s.tablet_id)
WHERE t1.database_name in ('test') AND t1.ROLE IN ('LEADER') AND s.table_type <> 'MEMTABLE' and (t1.TABLE_NAME like '%iot%' or t1.table_name like '%heap%')
ORDER BY table_name, svr_ip, end_log_ts;
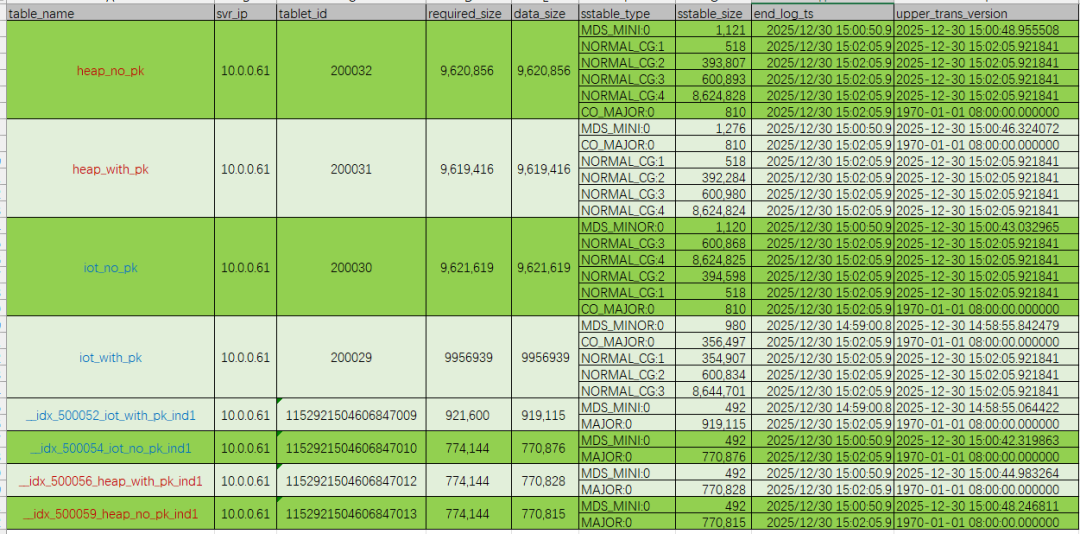
结论:
堆表的无主键跟有主键的列存 CG 数量相比二者一样,大小方面差不多(无主键表略大一点点)。 索引组织表的无主键跟有主键的列存 CG 数量相比无主键多一个,大小方面有主键表更大一些。 堆表索引无主键跟有主键的 SSTABLE 数量相比二者一样,大小方面也一样。 索引组织表索引无主键跟有主键的 SSTABLE 数量相比二者一样,大小方面有主键表索引更大一些。 无主键表方面堆表跟索引组织表的列存 CG 数量相比二者一样,大小方面差不多(索引组织表略大一点点);索引大小方面二者一样。 有主键方面堆表跟索引组织表的列存 CG 数量相比堆表多一个,大小方面差不多(索引组织表略大一些);索引大小方面索引组织表的更大一些。
select m.svr_ip, m.tablet_id, l.table_name, m.action, scn_to_timestamp(COMPACTION_SCN ) compaction_ts, start_time, end_time ,MACRO_BLOCK_COUNT ,REUSE_PCT
from oceanbase.GV$OB_MERGE_INFO m join oceanbase.DBA_OB_TABLE_LOCATIONS l on (m.svr_ip=l.svr_ip and m.tablet_id=l.tablet_id and m.svr_port=l.svr_port)
where  (l.table_name like '%iot%' or l.table_name like '%heap%')
order by start_time desc ;
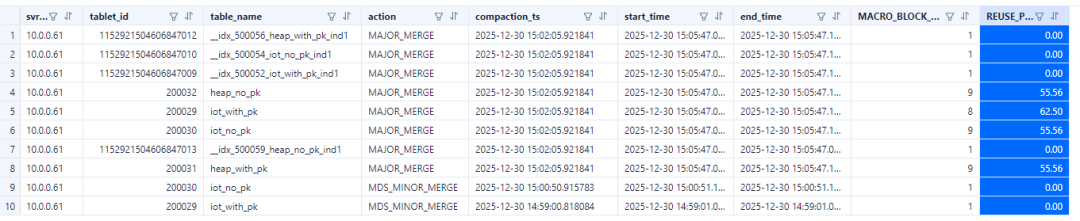
感觉合并很慢,但是查看实际合并耗时又很快。还有别的原因。
obclient(mq@SERVICE:s_mysql)[test]> show parameterslike'%ob_compaction_schedule_interval%'\G
*************************** 1.row ***************************
         zone: zone1
     svr_type: observer
       svr_ip: 10.0.0.61
     svr_port: 2882
         name: ob_compaction_schedule_interval
    data_type: TIME
        value: 120s
         info: the timeintervalto schedule compaction, Range: [3s,5m]Range: [3s, 5m]
      section: TENANT
        scope: TENANT
       source: DEFAULT
   edit_level: DYNAMIC_EFFECTIVE
default_value: 120s
    isdefault: 1
1rowinset (0.007 sec)
结论:合并有调度时间,默认触发后 2 分钟后开始合并。难怪感觉有点慢。
执行计划对比分析
SQL 如下,都查看实际执行计划。
call dbms_stats.GATHER_TABLE_STATS ('test','iot_with_pk',method_opt=>'for all columns size auto', DEGREE=>4 );
call dbms_stats.GATHER_TABLE_STATS ('test','iot_no_pk',method_opt=>'for all columns size auto', DEGREE=>4 );
call dbms_stats.GATHER_TABLE_STATS ('test','heap_with_pk',method_opt=>'for all columns size auto', DEGREE=>4 );
call dbms_stats.GATHER_TABLE_STATS ('test','heap_no_pk',method_opt=>'for all columns size auto', DEGREE=>4 );

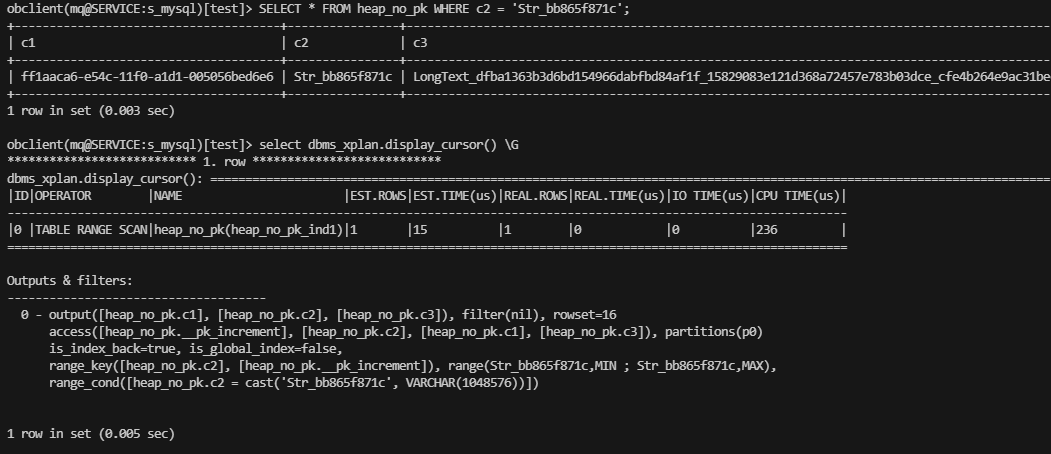
SELECT * FROM iot_with_pk WHERE c2 = 'Str_bb865f871c';
SELECT * FROM iot_no_pk WHERE c2 = 'Str_bb865f871c';

SELECT * FROM heap_with_pk WHERE c2 = 'Str_bb865f871c';
SELECT * FROM heap_no_pk WHERE c2 = 'Str_bb865f871c';
每运行一个 SQL 后迅速运行下面 SQL 获取实际执行计划。
select dbms_xplan.display_cursor() \G
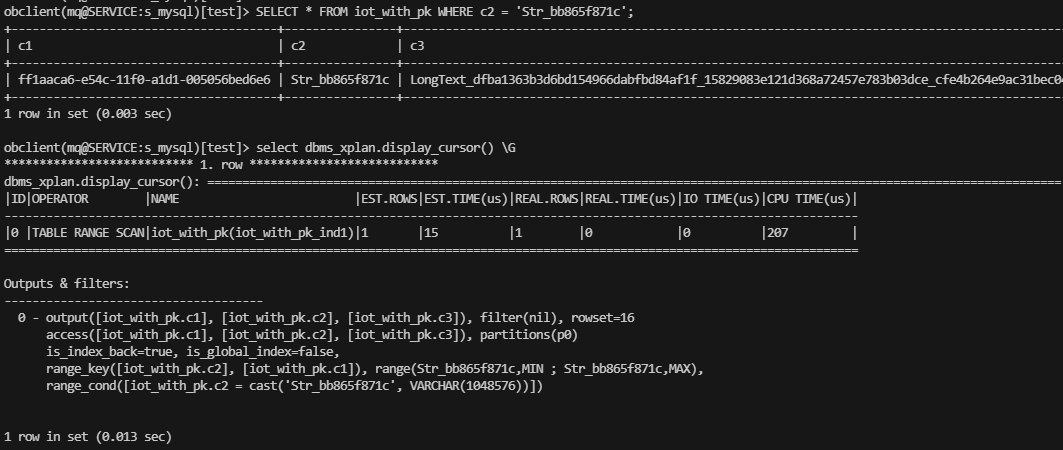
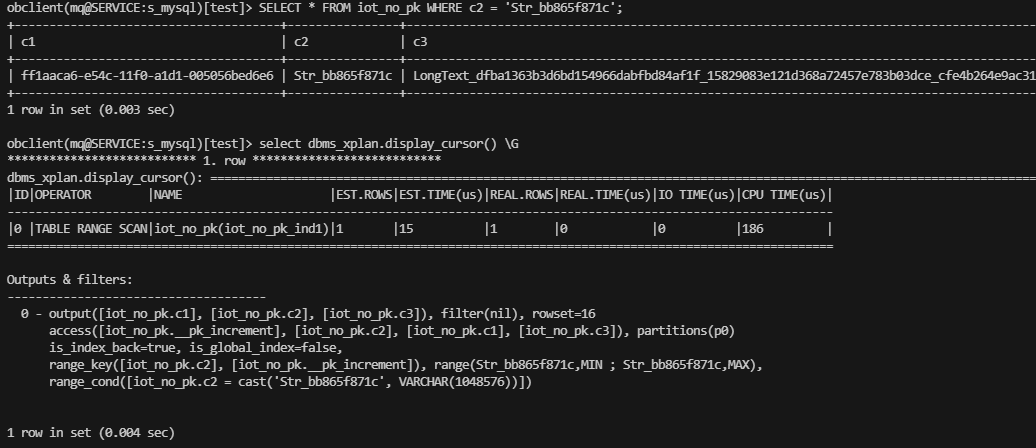
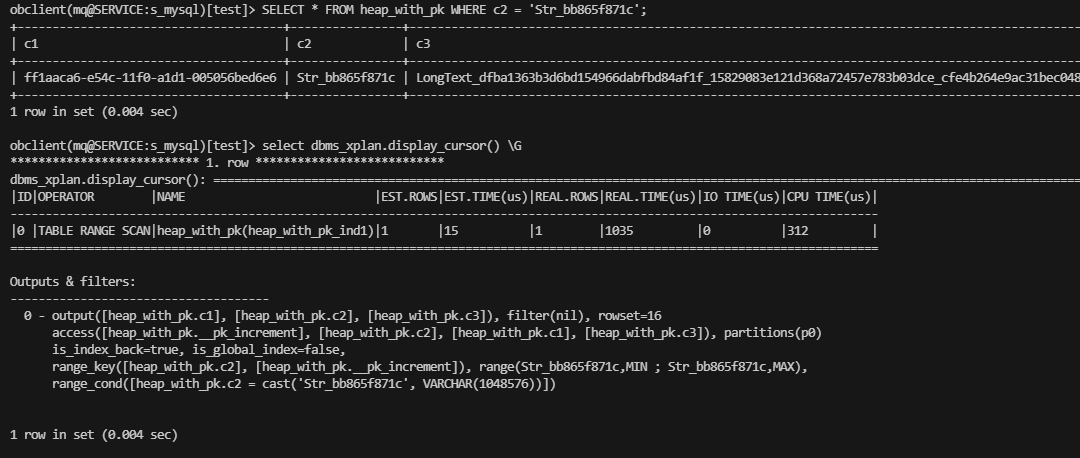
结论:
对于索引组织表,有主键表的二级索引里存储了主键的列信息,无主键表的二级索引里存储了隐藏列 __pk_increment
信息。对于堆表,有主键表和无主键表的二级索引里存储的都是隐藏列 __pk_increment
信息。
扩大查询范围。
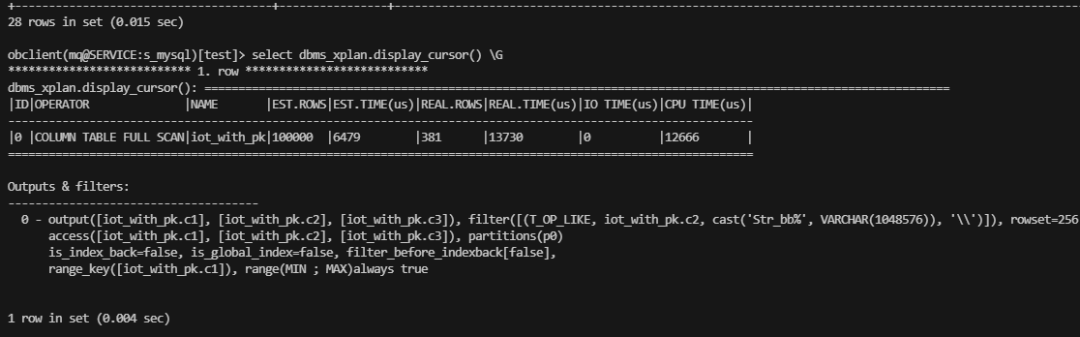
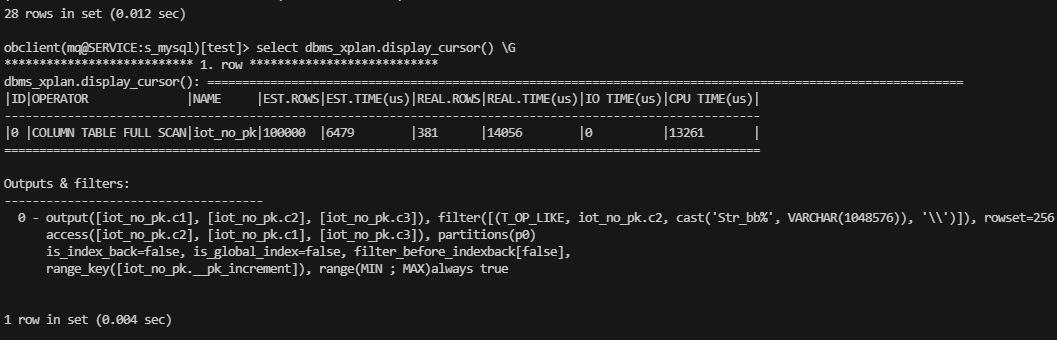
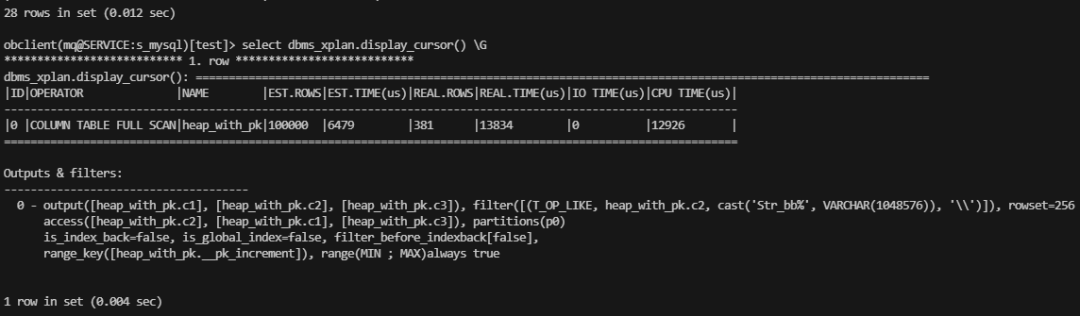
SELECT * FROM iot_with_pk WHERE c2 like 'Str_bb8%';
SELECT * FROM iot_no_pk WHERE c2 like 'Str_bb8%';

SELECT * FROM heap_with_pk WHERE c2 like 'Str_bb8%';
SELECT * FROM heap_no_pk WHERE c2 like 'Str_bb8%';
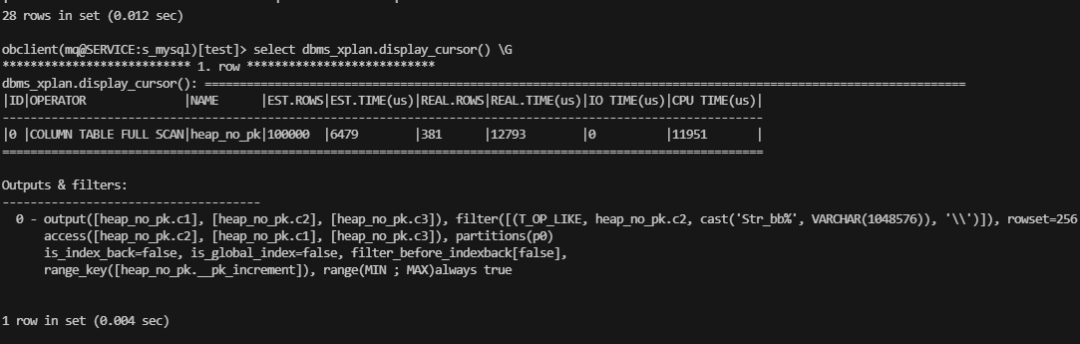
结论:
列存表 SQL 的实际执行计划里返回的实际行数 REAL.ROWS
跟结果集行数相比偏大。这个估计是 BUG 。所有场景下的 LIKE 操作都认为全表扫描成本更低。
将列存表全部改为行存表再测试
alter table iot_with_pk addcolumngroup (allcolumns)  ;
altertable iot_no_pk addcolumngroup (allcolumns)  ;
altertable heap_with_pk addcolumngroup (allcolumns)  ;
altertable heap_no_pk addcolumngroup (allcolumns)  ;
altertable iot_with_pk dropcolumngroup (eachcolumn)  ;
altertable iot_no_pk dropcolumngroup (eachcolumn)  ;
altertable heap_with_pk dropcolumngroup (eachcolumn)  ;
altertable heap_no_pk dropcolumngroup (eachcolumn)  ;

altersystem major freeze;

SELECT  * FROM  oceanbase.dba_OB_ZONE_MAJOR_COMPACTION;
SQL 以及执行计划
SELECT * FROM iot_with_pk WHERE c2 like 'Str_bb8%';
SELECT * FROM iot_no_pk WHERE c2 like 'Str_bb8%';

SELECT * FROM heap_with_pk WHERE c2 like 'Str_bb8%';
SELECT * FROM heap_no_pk WHERE c2 like 'Str_bb8%';

select dbms_xplan.display_cursor() \G
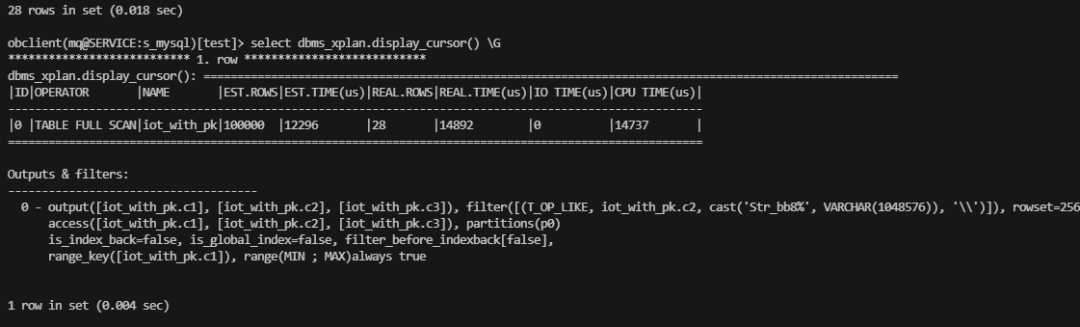
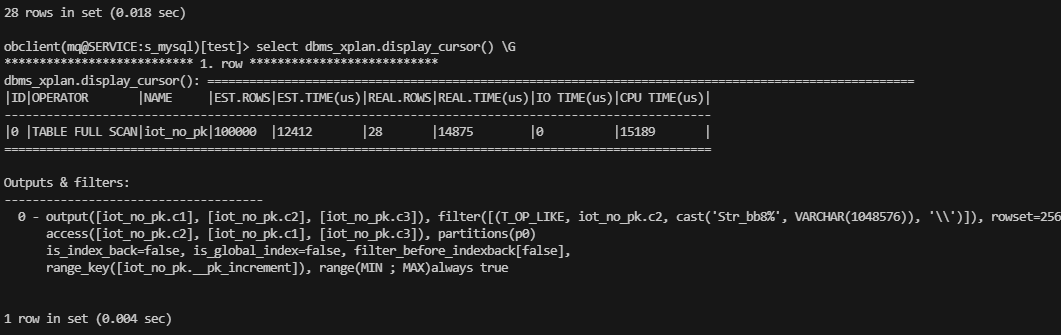
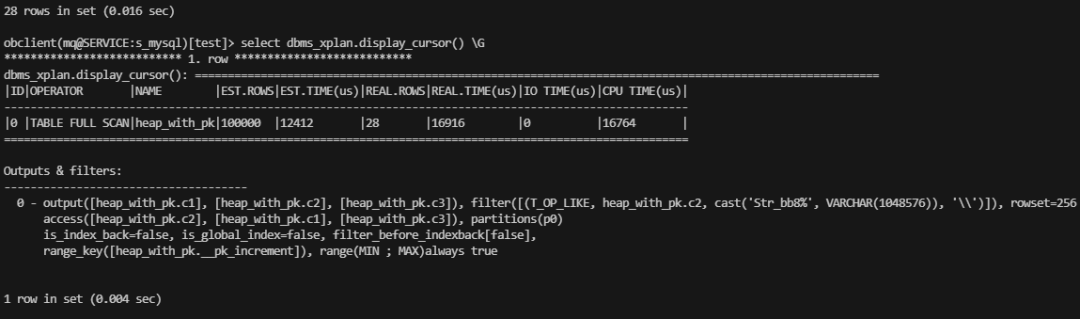
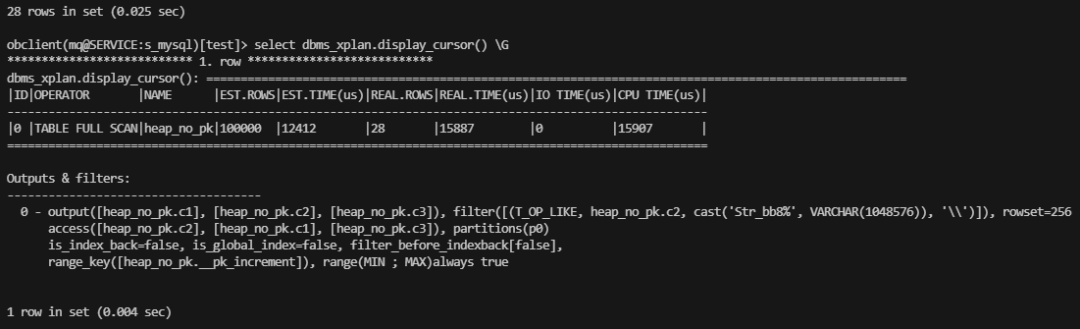
结论:
行存表 SQL 实际执行计划里的 REAL.ROWS
跟实际结果集行数一致。其他特点跟列存表的表现一样,优化器认为全表扫描的成本比索引扫描要低,所以 LIKE 查询全部走了全表扫描。
测试结论
初步测试下来看,堆表和索引组织表特点如下:
索引组织表有主键的时候,二级索引里存储的值包含主键的值。 索引组织表无主键的时候,二级索引里存储的值是内部隐藏列 __pk_increment
,这个跟堆表是一样的。关于这点目前还不是完全确认。堆表有主键或者无主键,二级索引里存储的值都是内部隐藏列 __pk_increment
,这个跟索引组织表是一样的。
更多堆表和索引组织表的特点还有赖后续更多测试。 OB 社区版官网论坛里给了一个实验环境,有兴趣的可以直接上去申请在线体验堆表的功能。 论坛地址:https://www.oceanbase.com/demo/oceanbase-ap-heap-performance
