



阶段1:基于Spark/Flink的引擎依赖(V1.x),初始架构强耦合Spark/Flink引擎,连接器需为不同的引擎重复开发,维护成本高; 阶段2:连接器与引擎解耦(V2.x),重构连接器API,实现批流一体:同一数据源仅需一套代码,支持 Spark/Flink 双引擎。采用 Java SPI 实现插件动态注册; 阶段3:自研Zeta引擎(V2.3+),专为数据集成场景设计,解决 Spark/Flink 在 CDC 同步、资源占用高等问题。核心特性: 引擎内置Hazelcast(替代 ZooKeeper),状态存储自管理; 支持单节点低资源运行(1 核 CPU 处理多表实时同步)
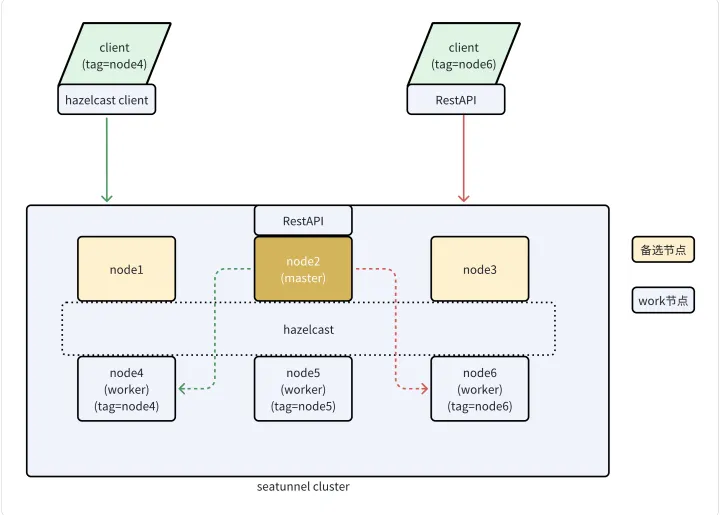
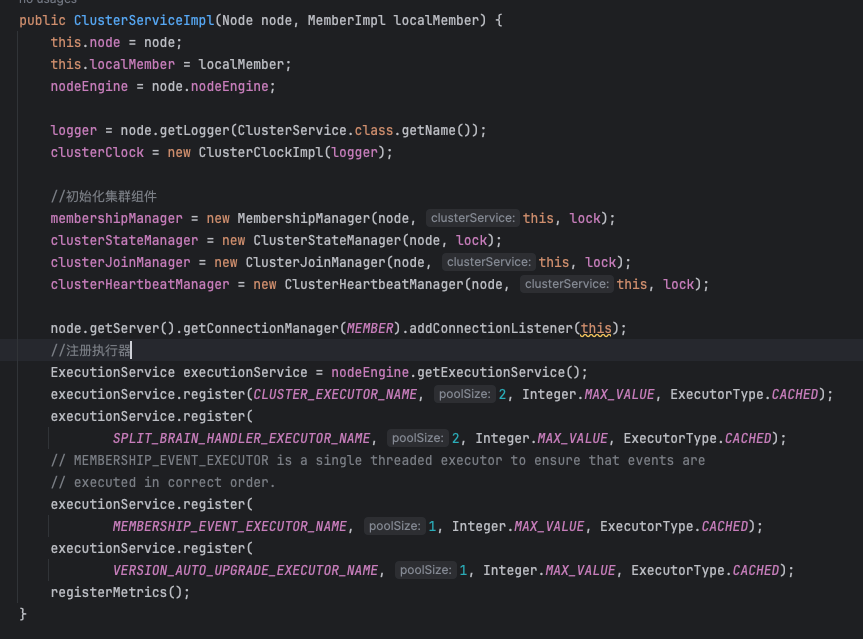
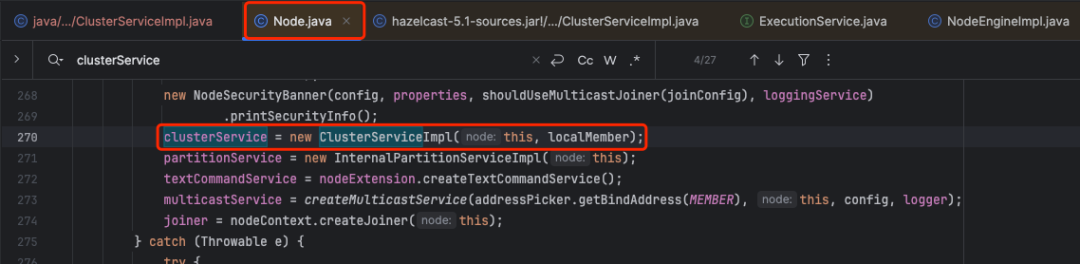
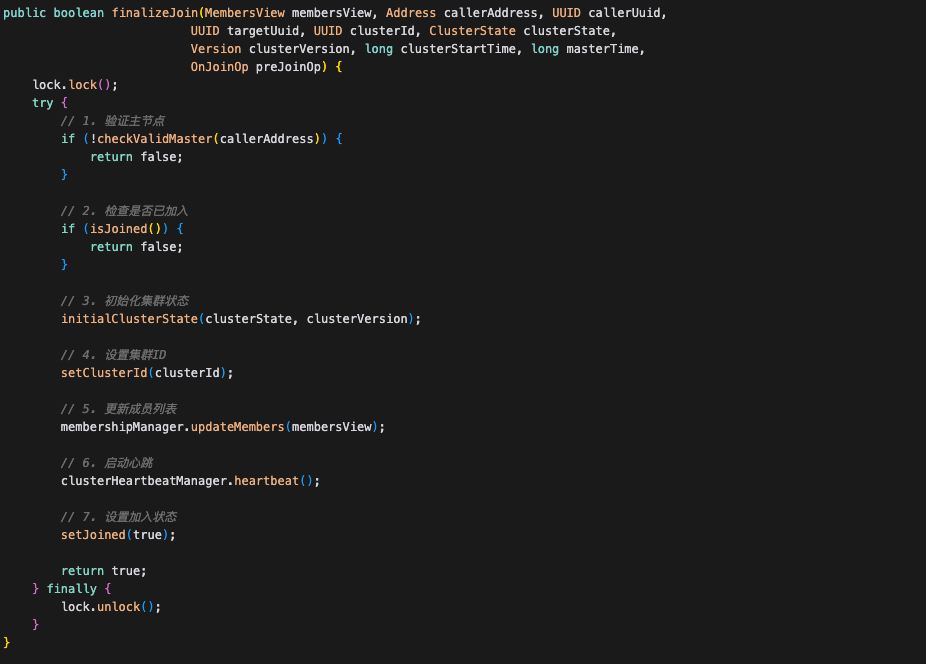
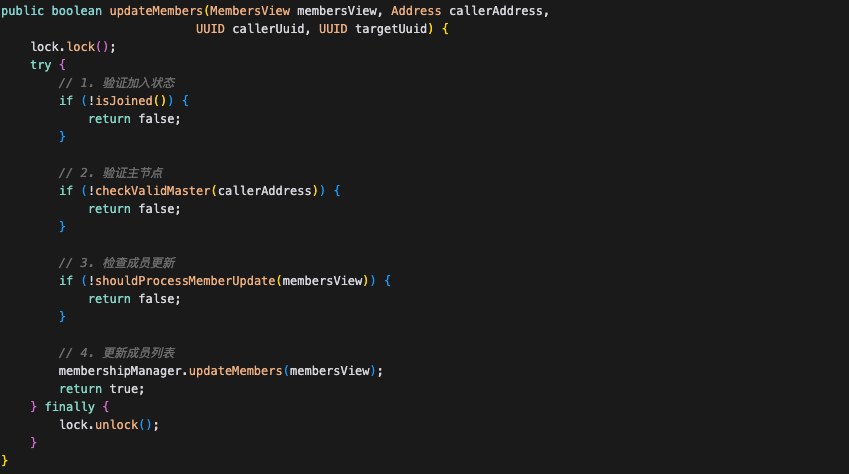
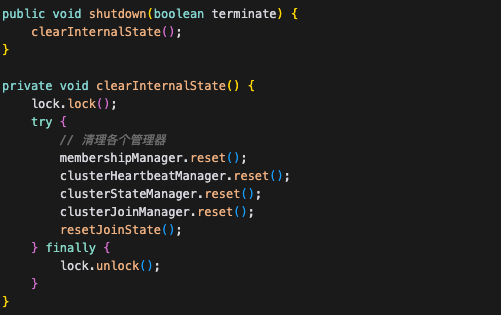
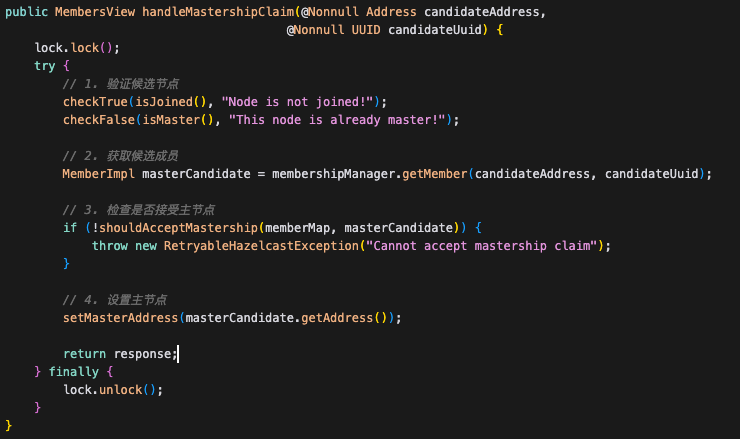
ClusterServiceImpl,负责集成Hazelcast实现分布式集群管理,例如:节点变更、Master选举、心跳等;
- membershipManager,负责管理集群成员;
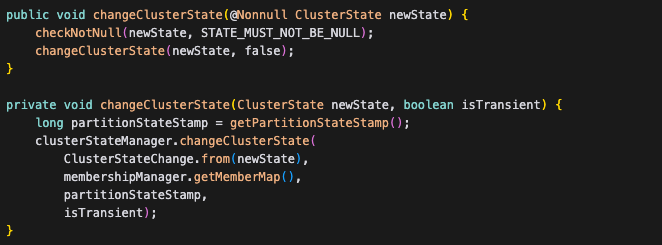
- clusterStateManager,负责存储节点状态,管理集群状态事务,当一个节点接入集群时,他的初始状态被重置;
- clusterJoinManager,负责管理节点加入线程,如果不是主节点,将主节点发送给该请求;如果是主节点,处理请求,并通知其他成员新加入的节点;
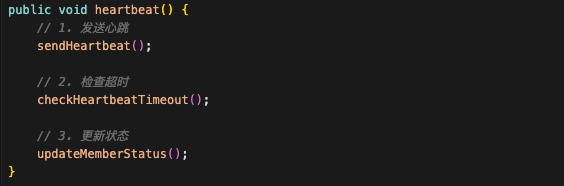
- clusterHeartbeatManager,负责管理节点的心跳和发送线程,该类周期性的发送心跳,如果检测到某个成员不在活动范围,则将该成员踢出集群;
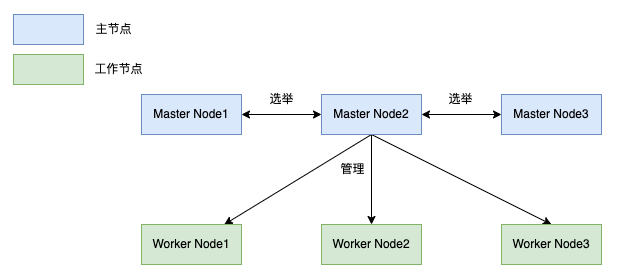
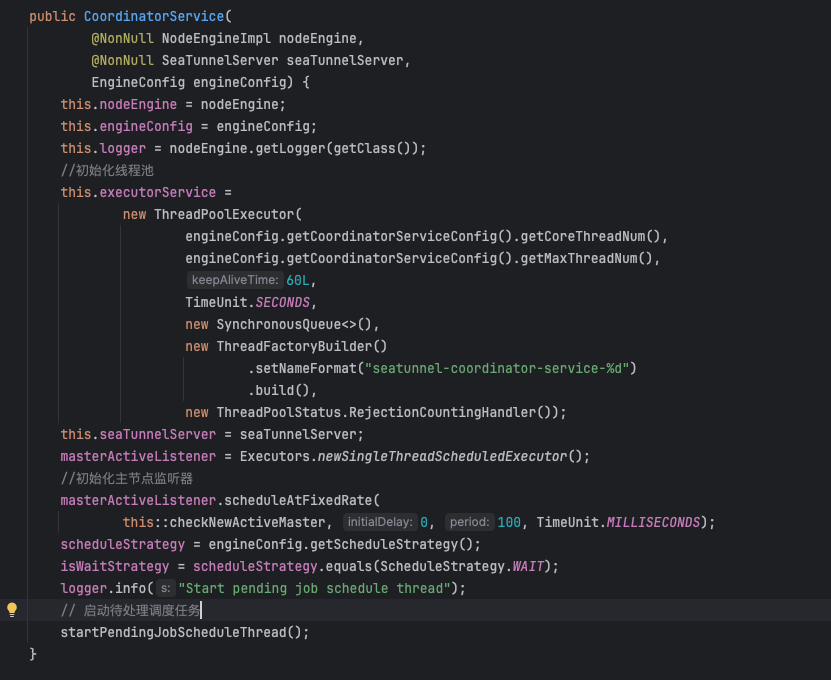
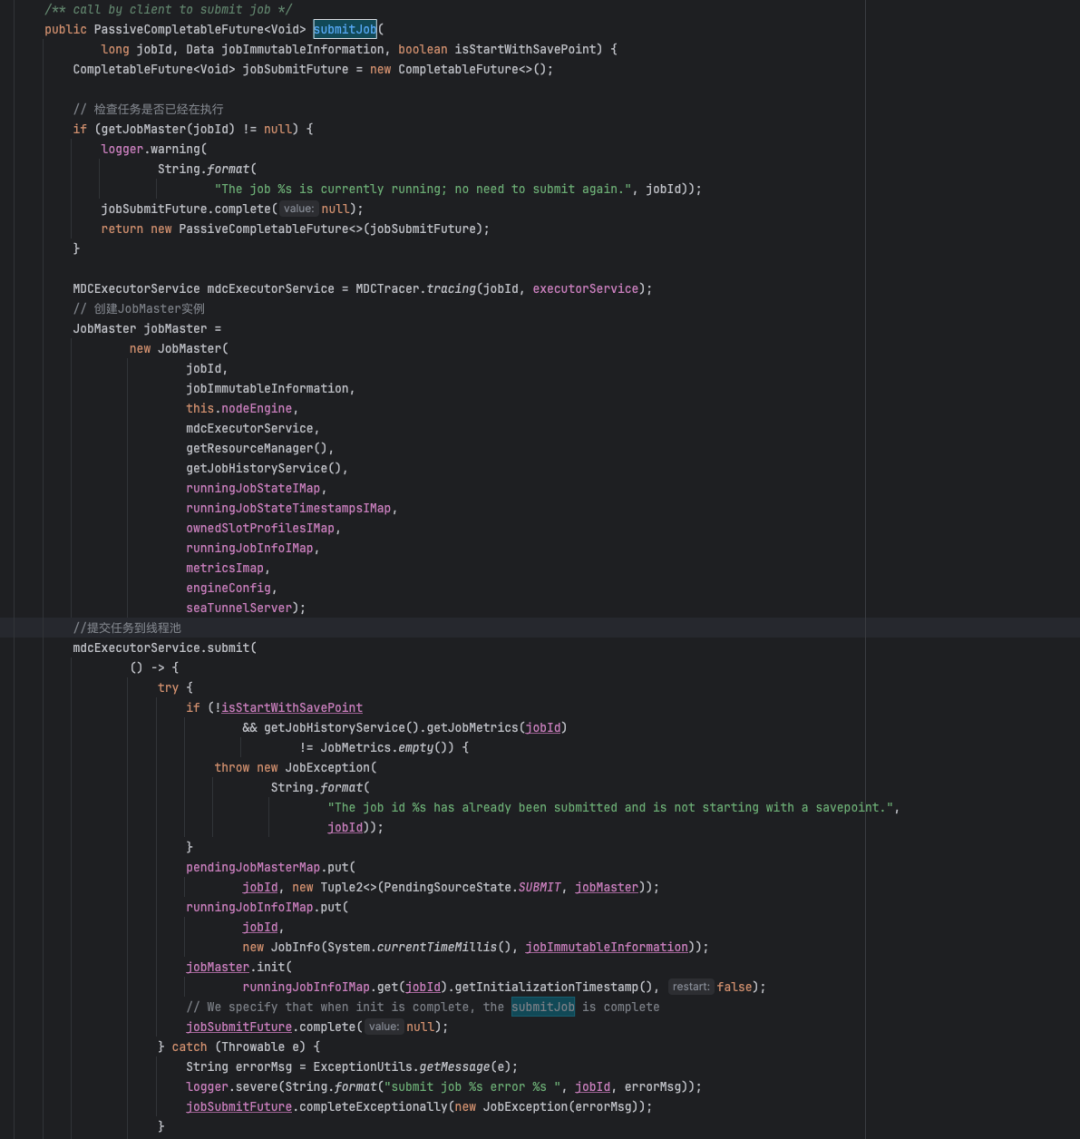
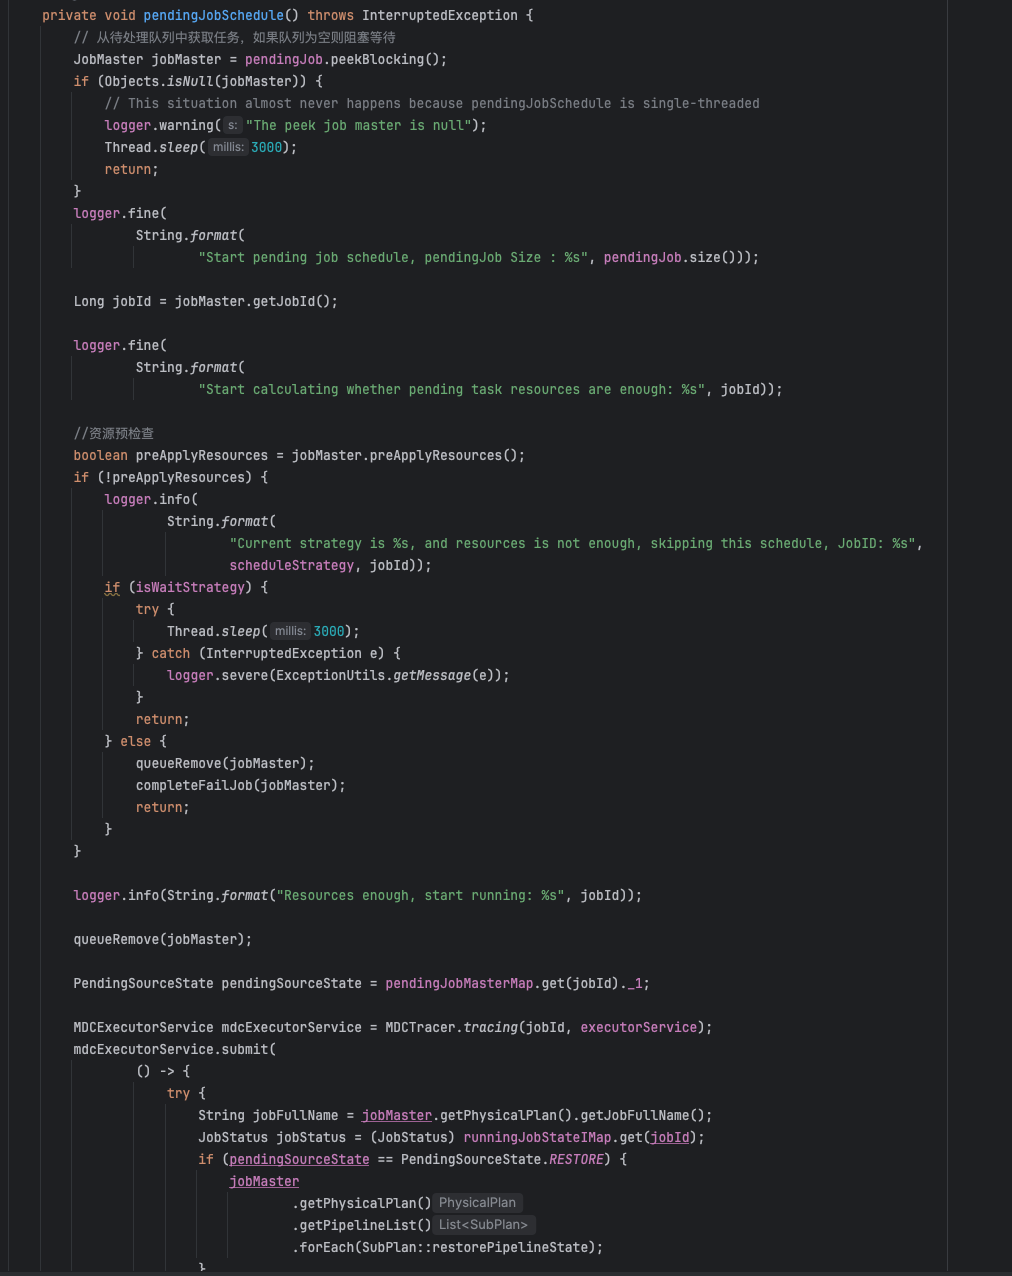
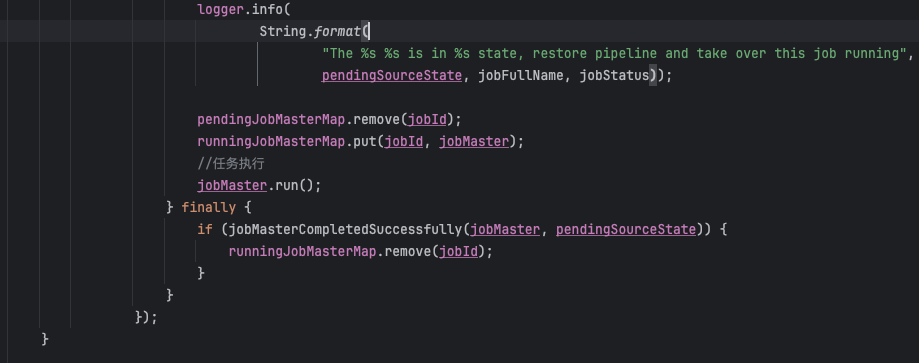
CoordinatorService是集群的Master服务,提供了每个作业从LogicalDag到ExecutionDag,再到PhysicalDag的生成流程,并最终创建作业的JobMaster进行作业的调度执行和状态监控;
- JobMaster,负责生成真正的执行流程,获取可用资源在Worker节点上执行;
- CheckpointService,负责作业的Checkpoint流程控制;
- ResourceManager, 负责作业资源的申请和管理;
- Metric Service,负责作业监控信息的统计和汇总;
文章转载自SeaTunnel,如果涉嫌侵权,请发送邮件至:contact@modb.pro进行举报,并提供相关证据,一经查实,墨天轮将立刻删除相关内容。
