



openGauss NUMA优化
1、NUMA架构
早期计算机内存控制器没有整合到CPU,所有内存访问都需要经过北桥芯片来完成。这种架构称为UMA(Uniform Memory Access,一致性内存访问),总线模型保证了CPU所有的内存访问都是一致的,不必考虑不同内存地址之间的差异。
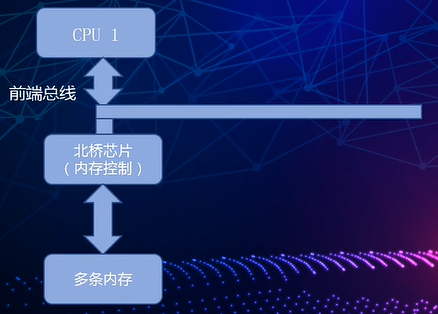
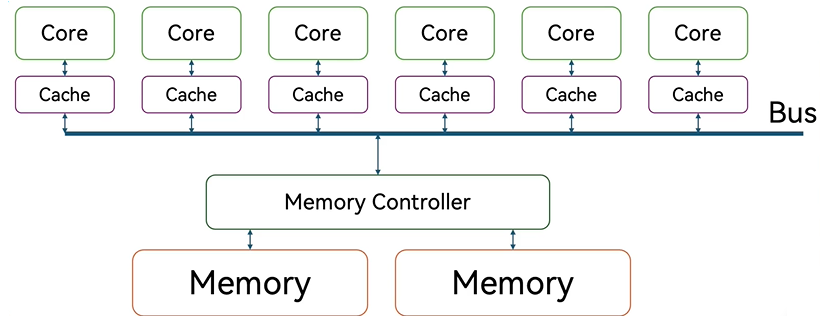
随着发展,一个CPU可能就满足不了需求了,就加了很多CPU挂到总线上:也就是下图的SMP架构。SMP对称多处理架构如下图所示,所有核心共用一个总线,一致地访问内存,所有处理器地位平等。此时就出现了内存瓶颈,第一个是北桥芯片内存控制器,第二个主要是前端总线会出现瓶颈。就如同多个马车同时通过城门一样。
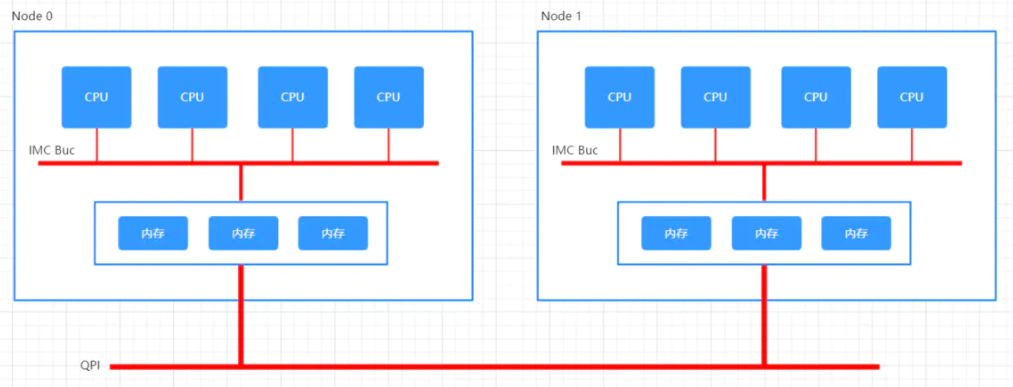
为应对上述瓶颈,出现了NUMA(Non-Uniform Memory Access,非一致性内存访问 )架构,每个CPU中集成了北桥芯片内存控制器,可以直连本地内存。访问其他CPU的内存需要通过互联总线QPI。访问远程内存的延迟会明显高于访问本地内存,出现了访问内存非一致性。
NUMA节点由一个或者多个CPU及其直连的本地内存组成。
2、openGauss的NUMA优化
openGauss在NUMA架构上进行了多层次的优化。主要包括以下几个方面:数据结构的NUMA分配、线程绑定与亲和性优化、内存分配优化、进程管理优化、MOT引擎的深度NUMA优化。关键数据结构按照NUMA节点分区分配,减少跨CPU访问冲突。
2.1 PGPROC数组分区适配NUMA
在InitProcGlobal函数中当检测到多NUMA节点时,PGPROC数组会按照节点分区进行分配,numa_alloc_onnode 函数用于在指定的 NUMA 节点上分配内存,第一个入参表示内存分配大小(单位是字节),第二个入参表示目标NUMA节点编号;他申请的内存需要通过numa_free 来释放。
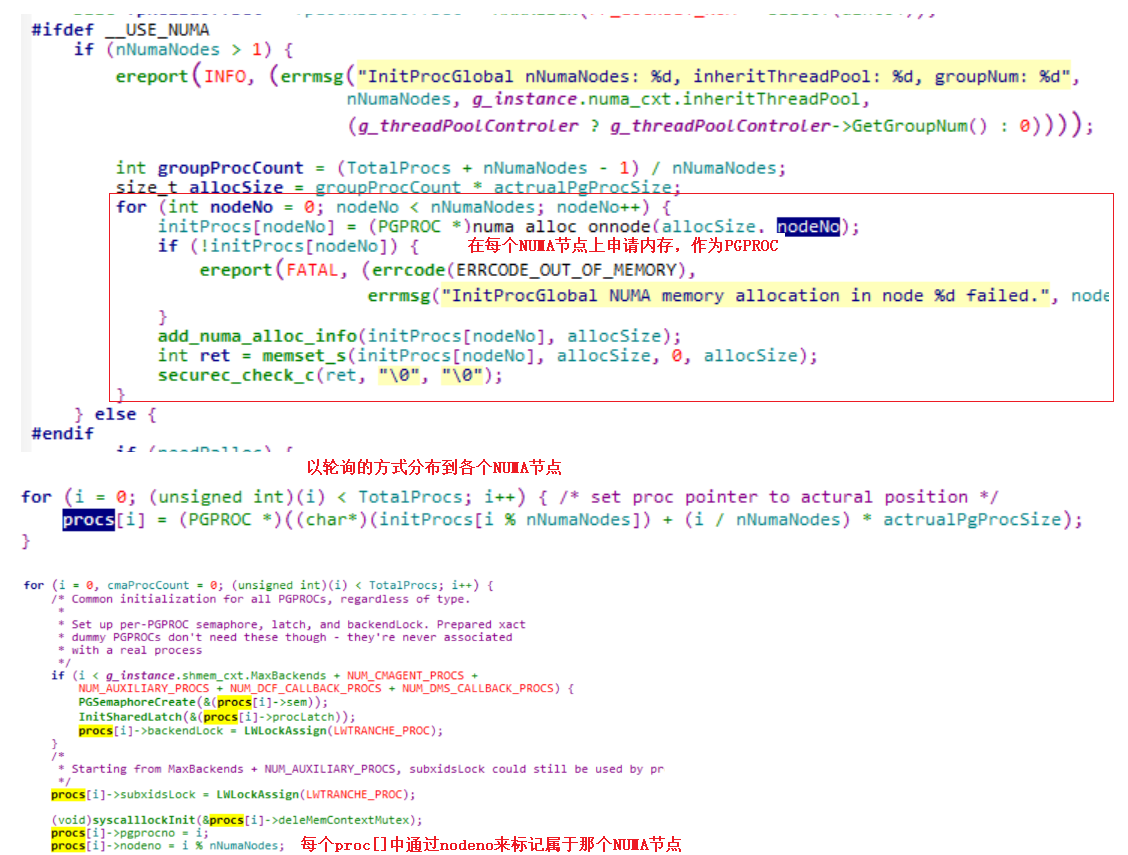
进行分配的时候,实现本地化进程分配:遍历空闲链表,优先选择同NUMA节点的PGPROC
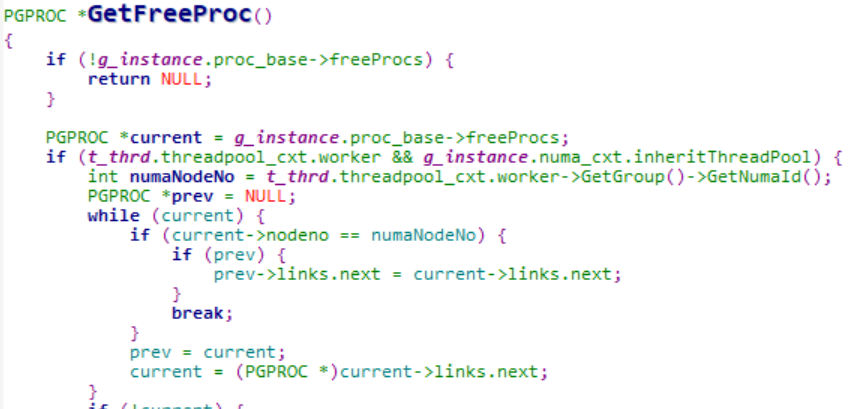
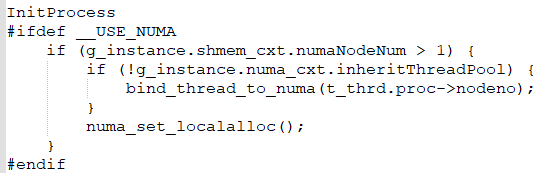
线程绑定优化时,通过bind_thread_to_numa函数将线程绑定到指定NUMA节点的CPU,并在进程初始化时设置本地内存分配策略:numa_set_localalloc设置本地内存分配优先的策略
这种分区设计实现了:
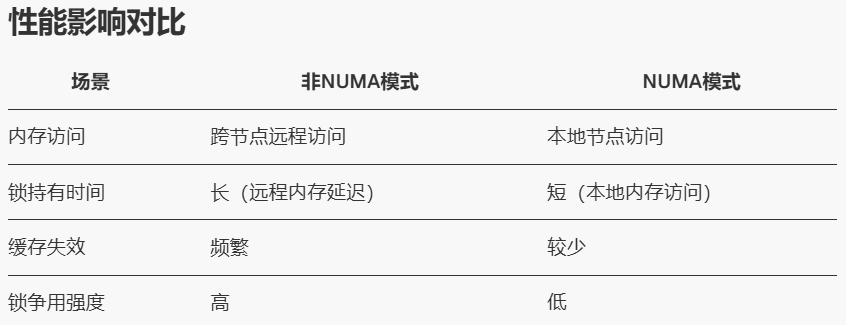
1)内存局部性:进程主要访问本地NUMA节点的内存,减少远程内存访问延迟
2)锁竞争减少:避免了所有进程竞争单一全局PGPROC数组造成的ProcArrayLock瓶颈
3)缓存友好:相关数据结构在相同NUMA节点上,提高CPU缓存命中率
通过这些机制,PGPROC数组分区显著提升了多核NUMA架构下的并发性能。
关于锁竞争减少,这点需要注意,NUMA优化后并不能减少ProcArrayLock锁的申请次数,该锁申请的时机:InitProcessPhase2:进程初始化第二阶段,将PGPROC添加到ProcArray使其对其他后端可见时:
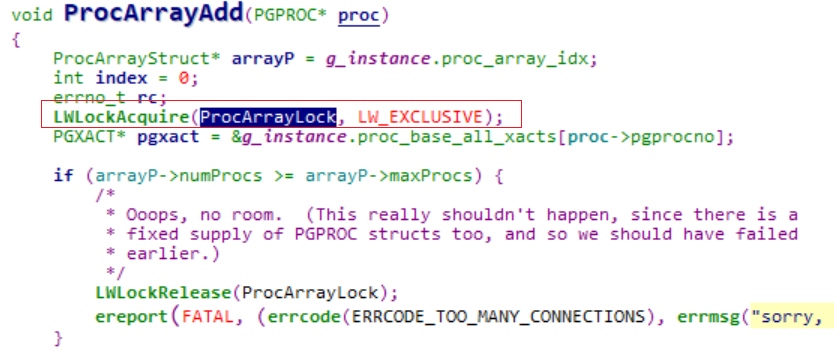
那么他是如何减少锁竞争的呢?
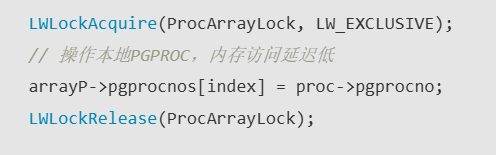
- 锁持有时间缩短:NUMA分配使线程主要操作本地内存,当持有ProcArrayLock时,对PGPROC的访问更快:
- 内存访问优化:每个NUMA节点的PGPROC在本地内存分配,减少远程访问
- 缓存局部性提升:线程优先使用本地节点的PGPROC,提高缓存命中率。本地节点缓存友好
2.2 WAL插入锁数组分区适配NUMA
首先需要了解下openGauss的WAL group insert优化,我们知道为了保证事务一致性及持久性,INSERT、UPDATE、DELETE等操作会写WAL日志,该WAL日志持久化到磁盘前会先放到WAL BUFFER中。为了保证日志写入的顺序性,在插入WAL前需要获取一个互斥锁来保护该临界区资源,插入完成后才能释放锁。并发很大时,锁的竞争就成为了性能瓶颈点。
ARM架构下LSE(Large System Extensions)原子操作为组插入提供了更好的硬件支持,并且ARM 服务器通常具有更多核心,组插入在超高并发场景下收益更明显,所以openGauss使用组提交方式提升性能:
- 在同一个时间窗口所有线程在争抢锁之前加入到一个组中,第一个加入组的线程作为leader,通过CAS原子操作来实现队列的管理;
- 仅leader线程代表整个组去抢锁,组中其他线程休眠,等待leader唤醒;
- 争抢到锁后,leader线程将组内所有线程的WAL日志遍历一遍,得到需要的空间大小,将该组所有WAL依次写入WAL BUFFER中,每个线程得到各自的不同LSN
- Leader线程释放锁,唤醒其他所有follower线程
- Follower线程需要写入的WAL已被leader写入,直接进入后面的流程
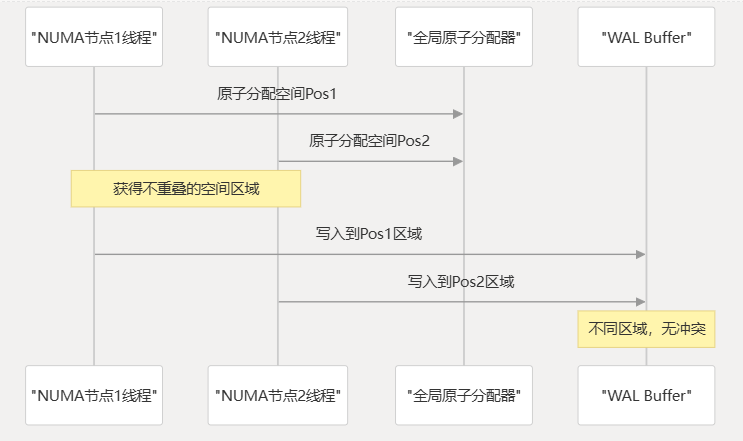
这里需要考虑一个问题:组插入锁按照NUMA节点分组,每个节点使用本地锁组,当不同NUMA节点线程并发时,都需要写入WAL BUFFER,此时就会申请不同锁,他们都可以获取到,都可以向WAL buffer插入,此时顺序性如何保证?
此时就需要依赖原子操作来完成并发写入WAL buffer。当然,原子操作也会有spin锁。
将WAL插入锁分组,每个NUMA节点一个,这样线程绑定后,该线程的WAL插入时若作为leader,就申请该线程对应的NUMA节点的WAL插入锁,从而减少锁竞争。
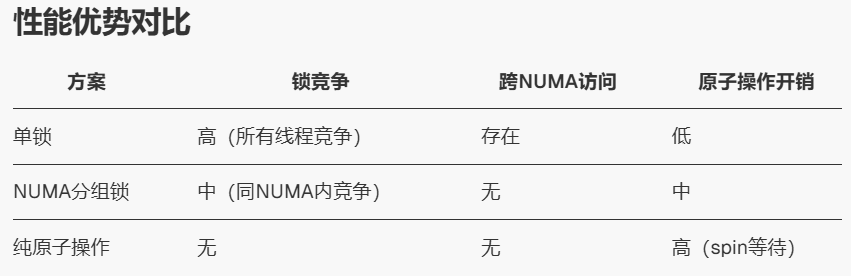
- 如果只使用一个锁,不同NUMA线程和同NUMA的线程都会竞争这一个锁,高并发场景下锁竞争很激烈;
- 如果使用WAL组插入锁,不同NUMA节点的线程使用不同锁,WAL顺序性通过原子操作来保护;
- 如果使用WAL组插入锁,相同NUMA节点的线程使用相同锁,锁竞争相对减少,这样就不会陷入原子操作的spin锁中,减少原子操作的spin代价;
- 不用插入锁,也可以通过原子操作来完成,只不过它的spin锁代价就会很大
原子分配插入位置如下图所示:
这个优化在减少跨NUMA锁竞争的同时,通过组提交和原子操作平衡了性能与一致性。
2.3 NUMA线程绑核
详情查看之前总结:https://www.modb.pro/db/70793
