



接上文继续研究 OB 4.3.5 的堆表特性。 这次主要是研究分区表的数据和索引存储。研究方法依然是先看索引组织表的特性,然后在堆表跟索引组织表之间进行对比。
索引组织表和堆表实验(二)
创建索引组织表分区表
为了简化细节,分区表用行存格式,不开租户自动并行,创建的是 RANGE 分区表,初始记录 10w。
-- 创建分区表,使用 UNIX_TIMESTAMP(c4) 作为分区键
CREATETABLE iot_pt (
    c1 CHAR(36) NOTNULL,
    c2 VARCHAR(50),
    c3 VARCHAR(500),
    c4 TIMESTAMPNOTNULLDEFAULTCURRENT_TIMESTAMP
)  ORGANIZATION INDEX
PARTITIONBYRANGE (UNIX_TIMESTAMP(c4)) (
    PARTITION p202501 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-02-01 00:00:00')),
    PARTITION p202502 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-03-01 00:00:00')),
    PARTITION p202503 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-04-01 00:00:00')),
    PARTITION p202504 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-05-01 00:00:00')),
    PARTITION p202505 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-06-01 00:00:00')),
    PARTITION p202506 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-07-01 00:00:00')),
    PARTITION p202507 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-08-01 00:00:00')),
    PARTITION p202508 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-09-01 00:00:00')),
    PARTITION p202509 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-10-01 00:00:00')),
    PARTITION p202510 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-11-01 00:00:00')),
    PARTITION p202511 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-12-01 00:00:00')),
    PARTITION p202512 VALUESLESSTHAN (UNIX_TIMESTAMP('2026-01-01 00:00:00'))
) WITH COLUMNGROUP(all columns);
创建存储过程插入 10 万条测试数据
-- 创建存储过程插入 10 万条测试数据
DELIMITER $$

CREATE PROCEDURE InsertIOTData()
BEGIN
    DECLARE i INTDEFAULT0;
    DECLARE total_rows INTDEFAULT100000;
    DECLARE rows_per_month INTDEFAULT8333; -- 每个分区约8333条
    DECLARE month_offset INT;
    DECLARE base_unix_time BIGINT;
    DECLARE target_unix_time BIGINT;
    DECLARE insert_date TIMESTAMP;

    -- 设置基础时间(2025年1月1日)
    SET base_unix_time = UNIX_TIMESTAMP('2025-01-01 00:00:00');

    -- 显示开始时间
    SELECTCONCAT('开始插入数据: ', NOW()) AS'开始时间';

    -- 禁用自动提交,提高插入性能
    SET autocommit = 0;
    STARTTRANSACTION;

    -- 循环插入10万条数据
    WHILE i < total_rows DO
        -- 计算月份偏移(0-11个月)
        SET month_offset = FLOOR(i  rows_per_month);

        -- 确保month_offset在0-11范围内
        IF month_offset > 11 THEN
            SET month_offset = 11;
        ENDIF;

        -- 计算目标时间戳(在指定月份内均匀分布)
        SET target_unix_time = base_unix_time +
                               (month_offset * 30 * 24 * 3600) +  -- 月份偏移
                               (MOD(i, 28) * 24 * 3600) +         -- 0-27天的偏移
                               (MOD(i, 24) * 3600) +              -- 小时偏移
                               (MOD(i, 60) * 60) +                -- 分钟偏移
                               MOD(i, 60);                        -- 秒偏移

        -- 将UNIX时间戳转换为TIMESTAMP
        SET insert_date = FROM_UNIXTIME(target_unix_time);

        -- 插入数据
        INSERTINTO iot_pt (c1, c2, c3, c4)
        VALUES (
            UUID(),  -- 生成UUID
            CONCAT('Device_', LPAD(MOD(i, 1000), 4, '0')),  -- 设备ID
            CONCAT('Sensor data: ', FLOOR(RAND() * 1000),
                   ', Temp: ', ROUND(20 + RAND() * 20, 2),
                   '°C, Humidity: ', ROUND(30 + RAND() * 50, 2), '%',
                   ', Status: ', IF(RAND() > 0.5, 'ON', 'OFF')),
            insert_date
        );

        -- 每10000条记录显示进度
        IF i % 10000 = 0 AND i > 0 THEN
            SELECTCONCAT('已插入 ', i, ' 条记录 (', ROUND(i/1000, 1), '%)') AS'进度';
        ENDIF;

        SET i = i + 1;
    ENDWHILE;

    -- 提交事务
    COMMIT;
    SET autocommit = 1;

    SELECTCONCAT('数据插入完成! 总共插入 ', i, ' 条记录') AS'完成';
END
$$

DELIMITER ;

-- 执行存储过程插入数据
CALL InsertIOTData();
主键和唯一约束测试
给分区表加主键和唯一约束。
alter table iot_pt add primary key (c1);

alter table iot_pt add unique key (c1);

create index iot_pt_uk_local on iot_pt(c1) local;
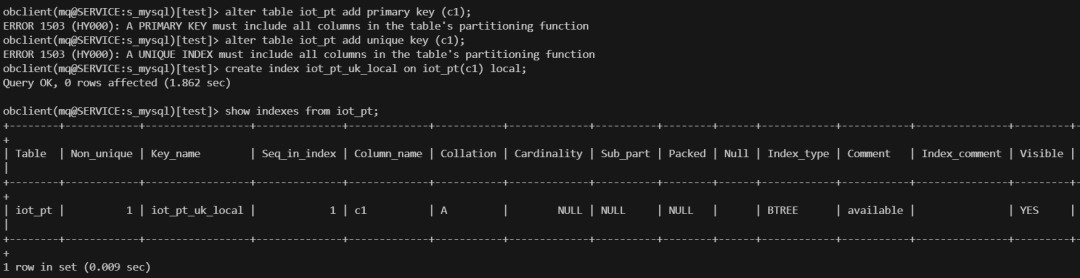
结论:
分区表的主键和唯一键约束要求约束列包含所有分区列。
select /*+ opt_param('hidden_column_visible','true') */ __pk_increment , c1, c2, c4 from iot_pt where __pk_increment = 10 ;
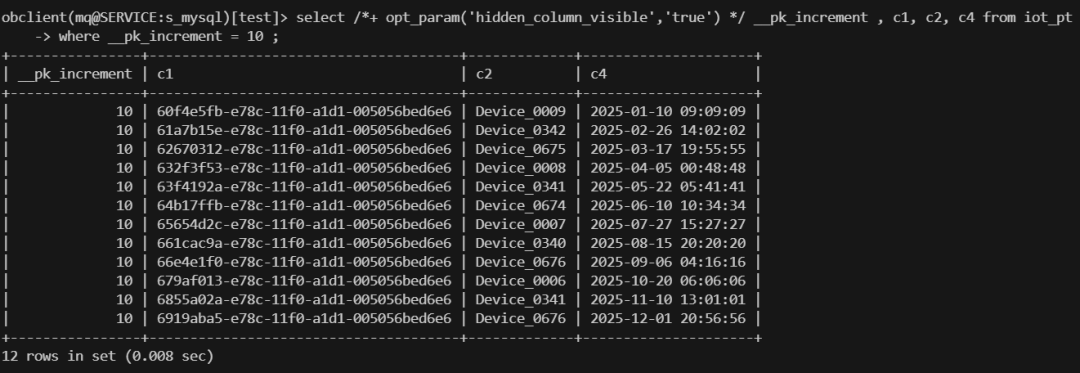
结论
IOT 分区表无主键时会内部有一个隐藏列 __pk_increment
并且这个列是单个分区内部自增且唯一,全局层面不唯一。
select c1, c2, c4 from iot_pt where c1='632f3f53-e78c-11f0-a1d1-005056bed6e6' ;
select dbms_xplan.display_cursor()\G
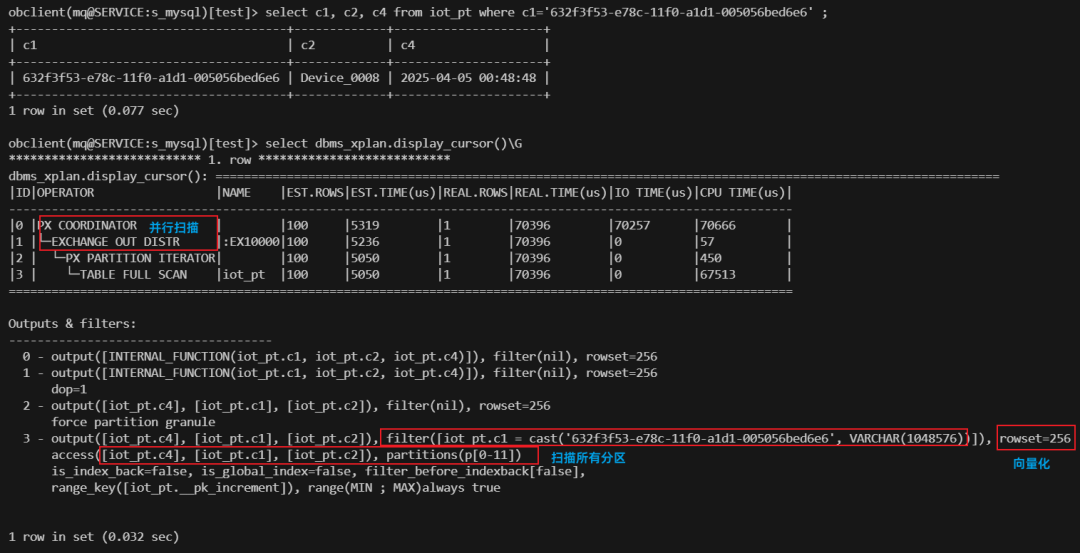
结论:
IOT 无主键表全表扫描是各个分区并行扫描,分区内扫描顺序是隐藏列 __pk_increment
顺序。
IOT 分区表唯一索引测试
create unique index iot_pt_uk on iot_pt(c1);
create unique index iot_pt_uk_local on iot_pt(c1,c4) local ;
show indexes from iot_pt_uk;
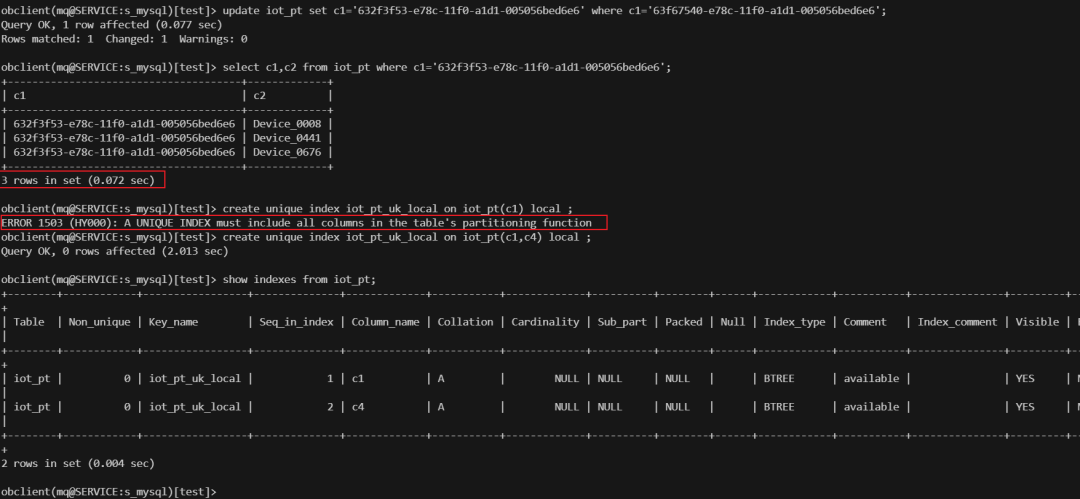
结论:
IOT 分区表加本地唯一索引要求索引列包含所有分区列。
select c1, c2, c4 from iot_pt where c1='632f3f53-e78c-11f0-a1d1-005056bed6e6' ;
select dbms_xplan.display_cursor()\G
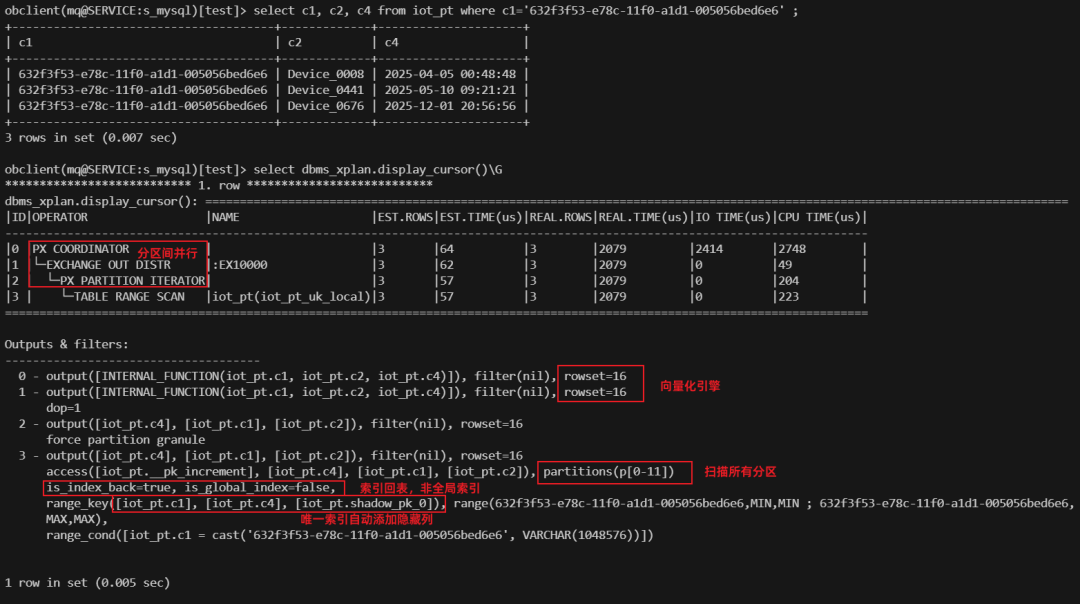
结论:
IOT 无主键表唯一索引列会自动新增隐藏列 shadow_pk_0
,其原因是 OB 的索引可以存储 NULL 值。据说为了实现唯一加一个隐藏列。这个隐藏列不同于_pk_increment
。
alter table iot_pt alter index iot_pt_uk_local invisible ;
show indexes from iot_pt;
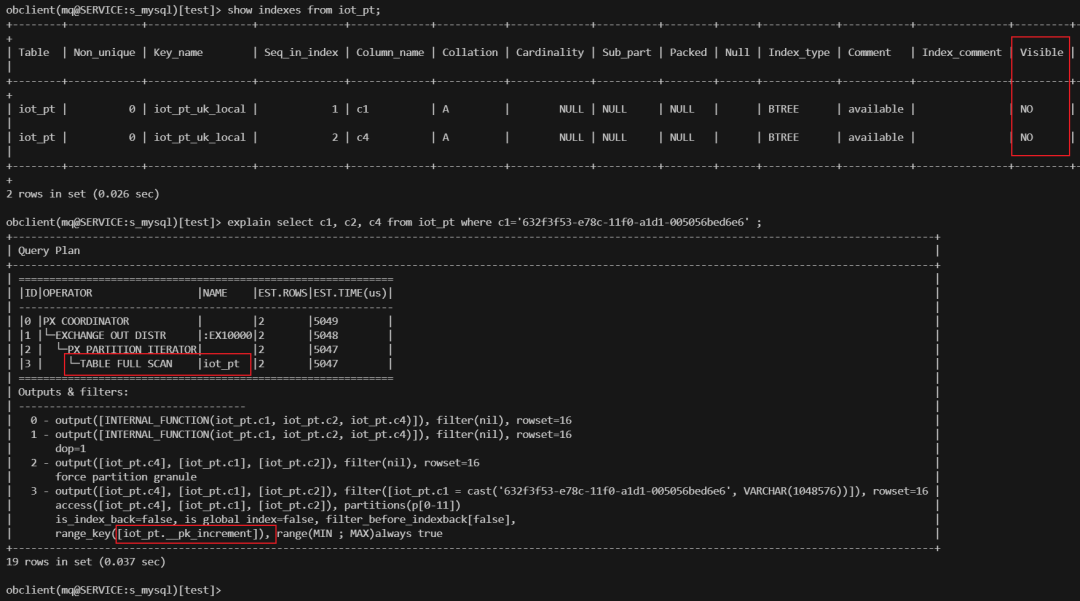
结论:
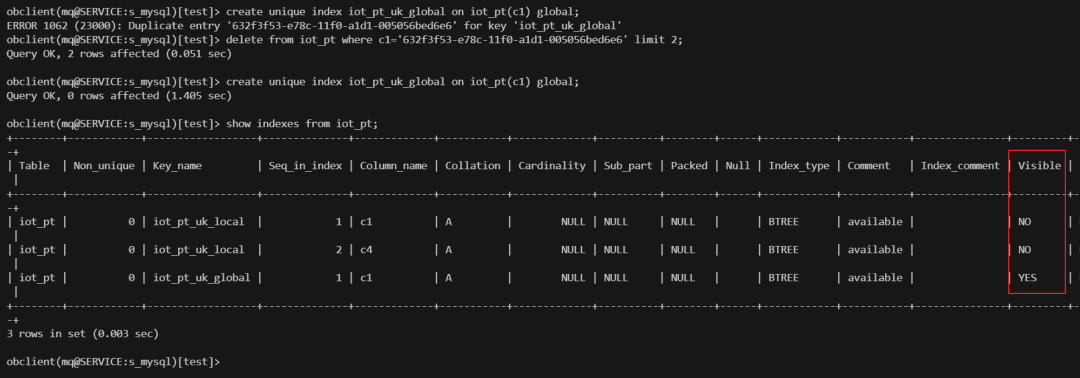
OB 表的索引可以隐藏,不被优化器使用。
create unique index iot_pt_uk_global on iot_pt(c1) global;
select c1, c4 from iot_pt where c1='632f3f53-e78c-11f0-a1d1-005056bed6e6' ;
select dbms_xplan.display_cursor()\G
select c1, c2, c4 from iot_pt where c1='632f3f53-e78c-11f0-a1d1-005056bed6e6' ;
select dbms_xplan.display_cursor()\G
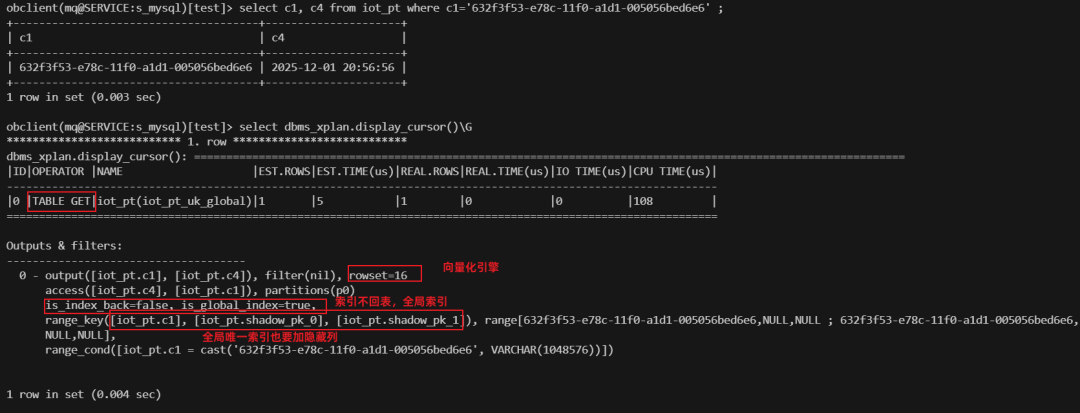
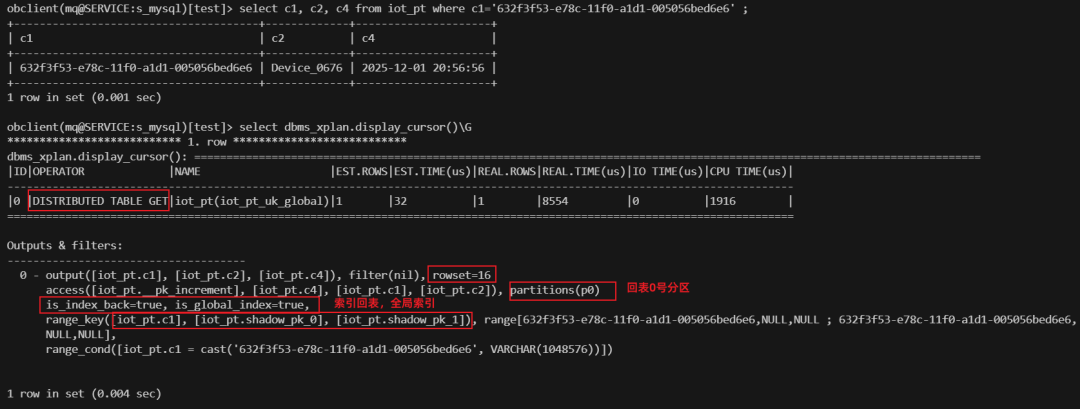
结论:
IOT 分区表全局唯一索引包含两个隐藏列: shaodow_pk_0
和shadow_pk_1
,不同于隐藏列__pk_increment
。IOT 分区表全局唯一索引里应该是包含了分区列,所以第一个索引查询不用回表。
IOT 分区表普通本地索引测试
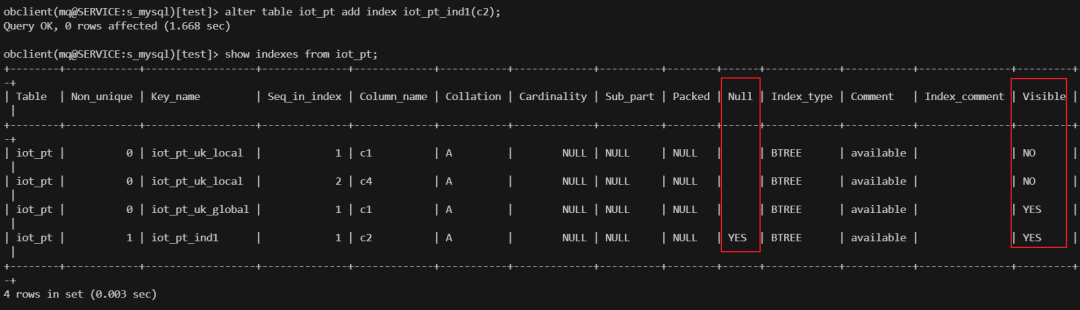
alter table iot_pt add index iot_pt_ind1(c2);
select c1, c2, c4 from iot_pt where c2='Device_0676' and c4 BETWEEN '2025-01-01 00:00:00' and '2025-01-10 00:00:00' ;
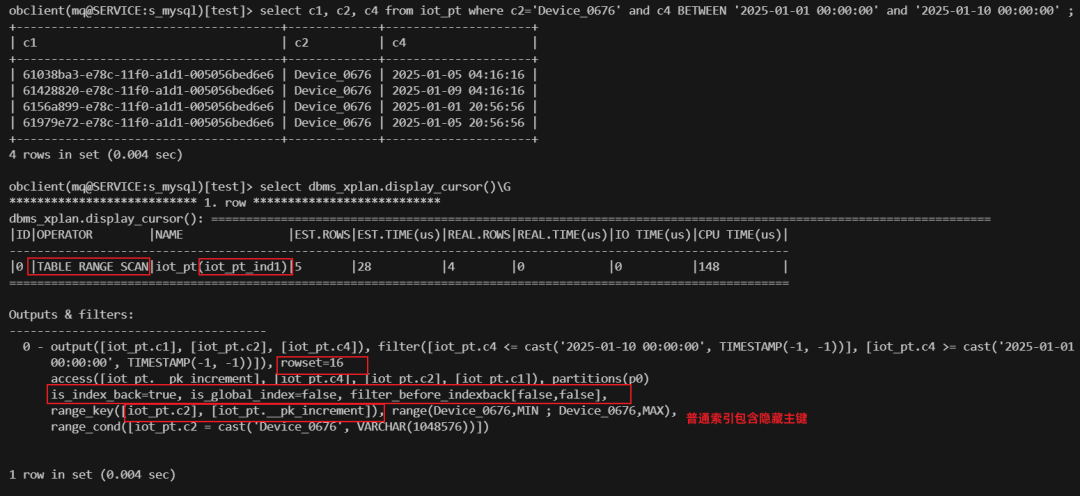
结论:
IOT 分区表本地普通索引包含隐藏列 __pk_increment
。该查询条件有分区字段做了分区裁剪,所以最终是单分区的索引扫描执行计划( TABLE RANGE SCAN(索引名)
)。
IOT 分区表变有主键表后测试
alter table iot_pt add primary key(c1,c4);

obclient(mq@SERVICE:s_mysql)[test]> select /*+ opt_param('hidden_column_visible','true') */ __pk_increment , c1, c2, c4 from iot_pt where __pk_increment = 110 ;
ERROR 1054 (42S22): Unknown column '__pk_increment' in 'where clause'
结论:
IOT 分区表加了主键后,内部隐藏列 __pk_increment
列消失。
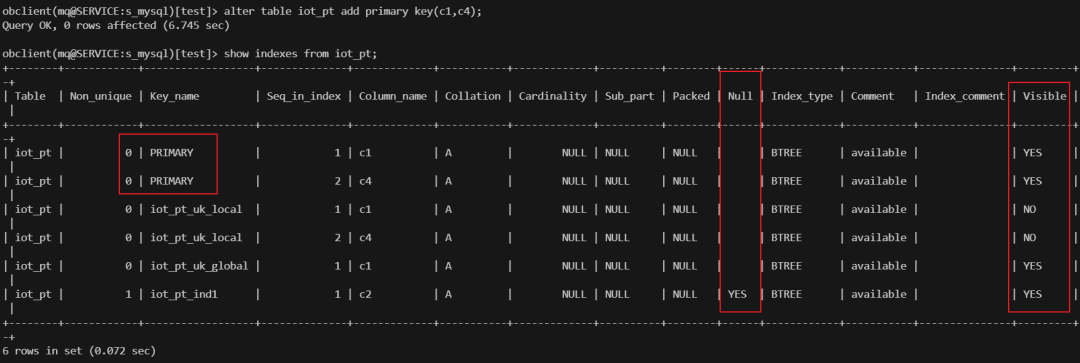
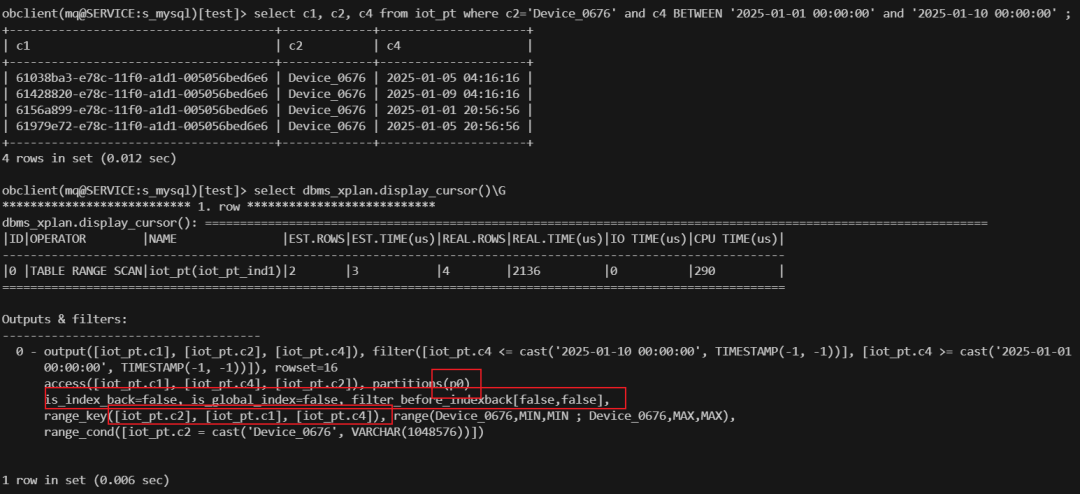
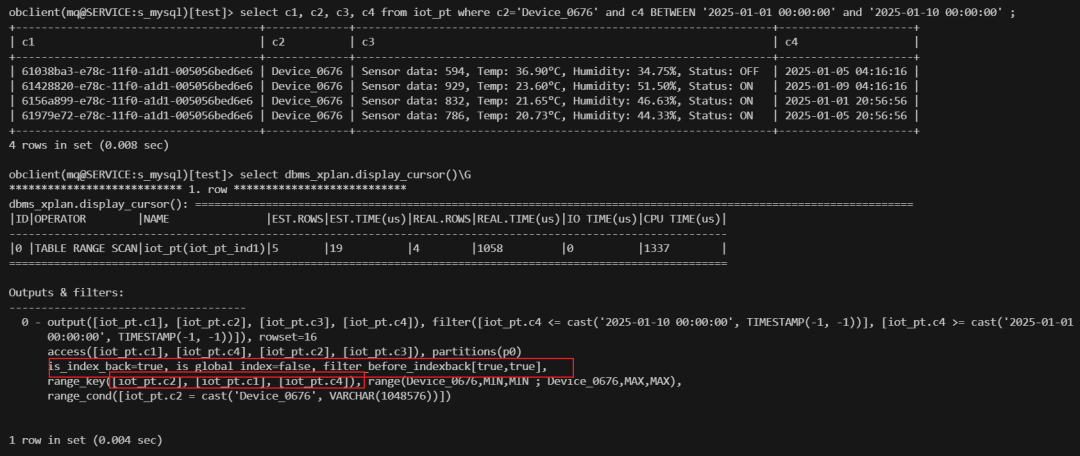
结论:
IOT 分区表有主键时普通本地索引里包含主键列信息。
select c1, c2, c4 from iot_pt where c1='632f3f53-e78c-11f0-a1d1-005056bed6e6' ;
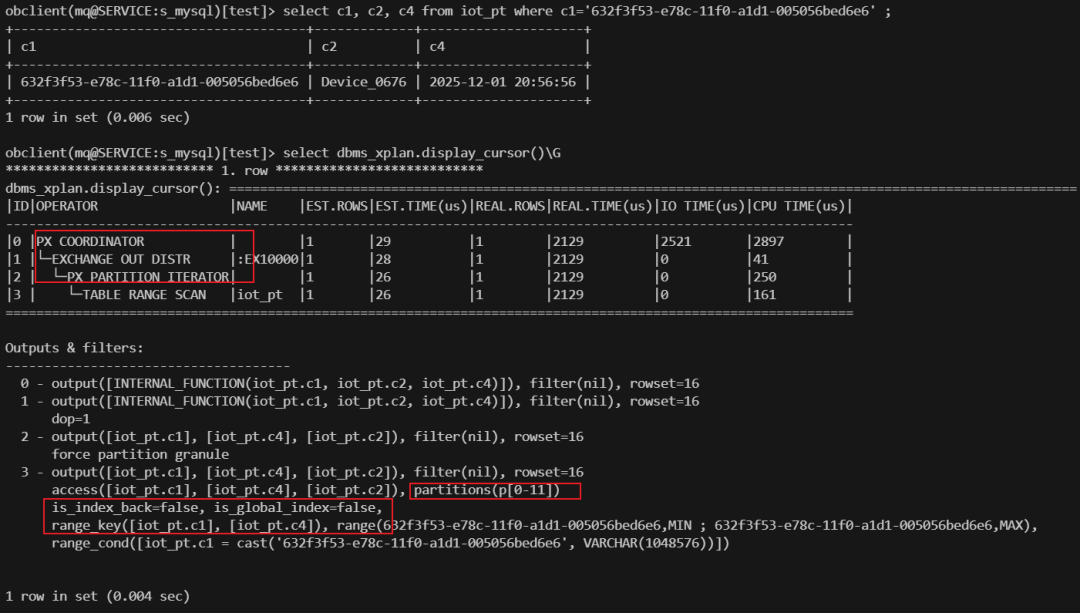
结论:
IOT 分区表有主键时,查询条件只有主键列部分列,走主键索引扫描: TABLE RANGE SCAN(主键索引名)
,其中主键索引名就是表名。
HEAP 表测试
新建 HEAP 分区表
obclient(mq@SERVICE:s_mysql)[test]> alter table iot_pt organization heap;
ERROR 1235 (0A000): organization in the alter table statement not supported
结论:
暂不支持 IOT 表变更为堆表。
CREATE TABLE heap_pt (
    c1 CHAR(36) NOTNULL,
    c2 VARCHAR(50),
    c3 VARCHAR(500),
    c4 TIMESTAMPNOTNULLDEFAULTCURRENT_TIMESTAMP
)  ORGANIZATION HEAP
PARTITIONBYRANGE (UNIX_TIMESTAMP(c4)) (
    PARTITION p202501 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-02-01 00:00:00')),
    PARTITION p202502 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-03-01 00:00:00')),
    PARTITION p202503 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-04-01 00:00:00')),
    PARTITION p202504 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-05-01 00:00:00')),
    PARTITION p202505 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-06-01 00:00:00')),
    PARTITION p202506 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-07-01 00:00:00')),
    PARTITION p202507 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-08-01 00:00:00')),
    PARTITION p202508 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-09-01 00:00:00')),
    PARTITION p202509 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-10-01 00:00:00')),
    PARTITION p202510 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-11-01 00:00:00')),
    PARTITION p202511 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-12-01 00:00:00')),
    PARTITION p202512 VALUESLESSTHAN (UNIX_TIMESTAMP('2026-01-01 00:00:00'))
) WITH COLUMNGROUP(all columns);

insert/*+ append enable_parallel_dml parallel(4) */into heap_pt select * from iot_pt;

select/*+ opt_param('hidden_column_visible','true') */ __pk_increment , c1, c2, c4 from heap_pt where __pk_increment = 10 ;
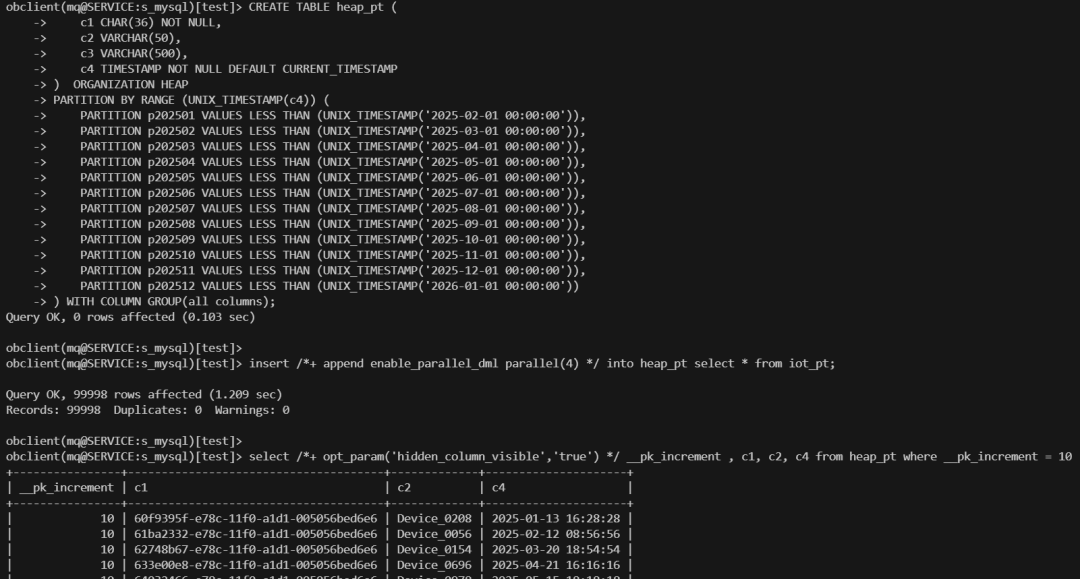
结论:
HEAP 分区表也有内部隐藏列 __pk_increment
,并且只在分区内部自增和唯一。
HEAP 分区表无主键时查询测试
select c1, c2, c4 from heap_pt where c1='6864d475-e78c-11f0-a1d1-005056bed6e6' ;
select dbms_xplan.display_cursor()\G
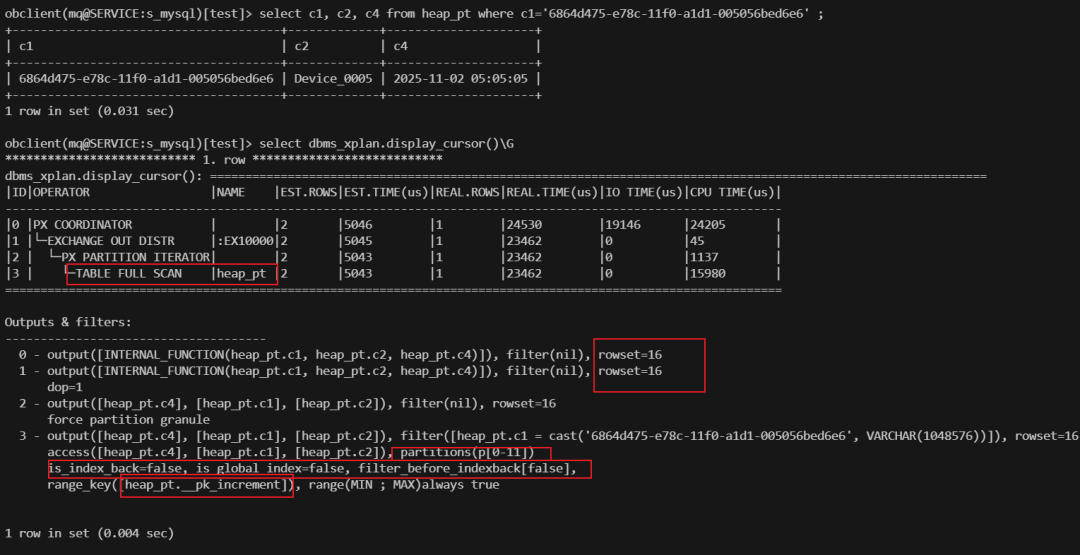
结论:
HEAP 分区表所有分区并行扫描,每个分区按照隐藏列 __pk_increment
顺序扫描。
create unique index heap_pt_uk on heap_pt(c1);
create unique index heap_pt_uk_local on heap_pt(c1,c4) local ;
show indexes from heap_pt;
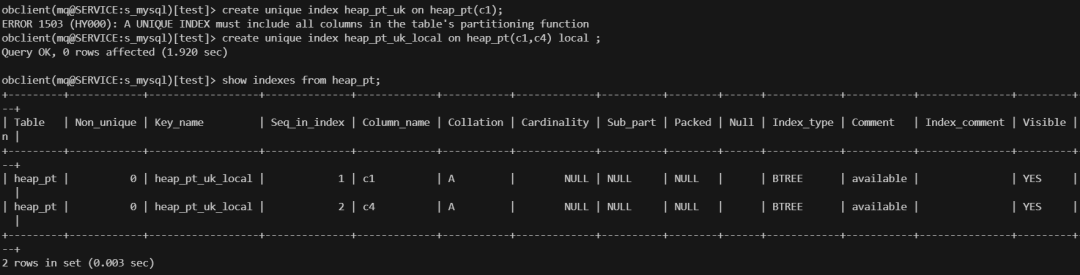
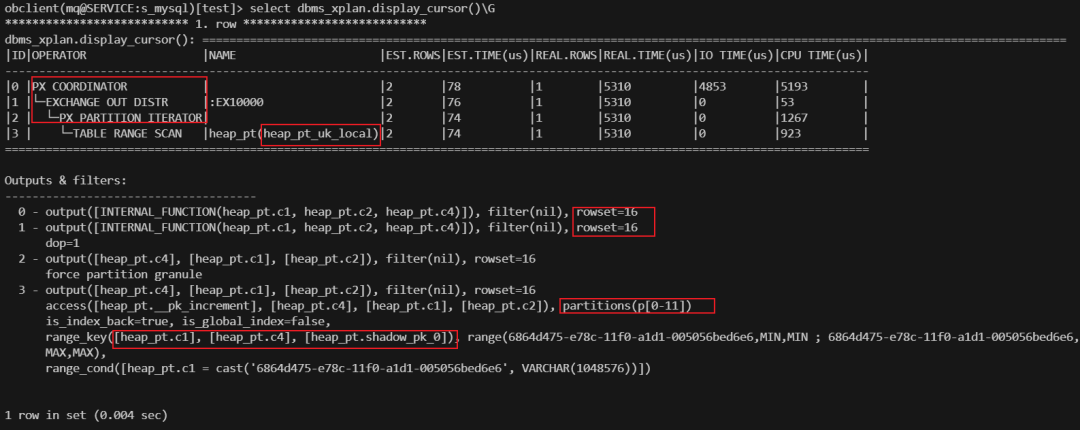
结论:
HEAP 分区表的本地唯一索引也必须包含所有分区列。 HEAP 分区表的本地唯一索引同样有隐藏列 shadow_pk_0
,不同于隐藏列__pk_increment
。HEAP 分区表查询走本地唯一索引时,需要并行扫描所有分区。
alter table heap_pt alter index heap_pt_uk_local invisible;
create unique index heap_pt_uk_global on heap_pt(c1) global ;
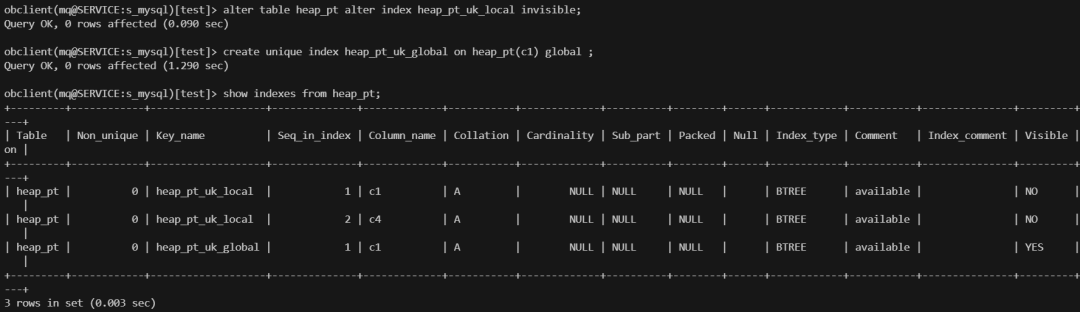
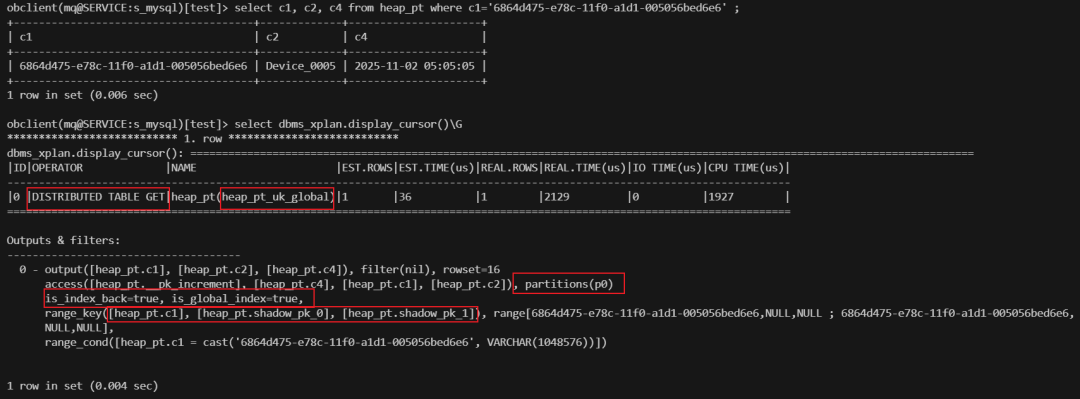
结论:
HEAP 分区表全局唯一索引同样有两个隐藏列( shadow_pk_0
和shadow_pk_1
)。HEAP 分区表全局索引扫描能返回具体的分区,所以回表的时候是单个分区的索引扫描,但是这个是分布式的执行计划: DISTRIBUTED TABLE GET
。
create index heap_pt_ind1 on heap_pt(c2) local;
select c1, c2, c4 from heap_pt where c2='Device_0676' and c4 BETWEEN '2025-01-01 00:00:00' and '2025-01-10 00:00:00' ;
select dbms_xplan.display_cursor()\G
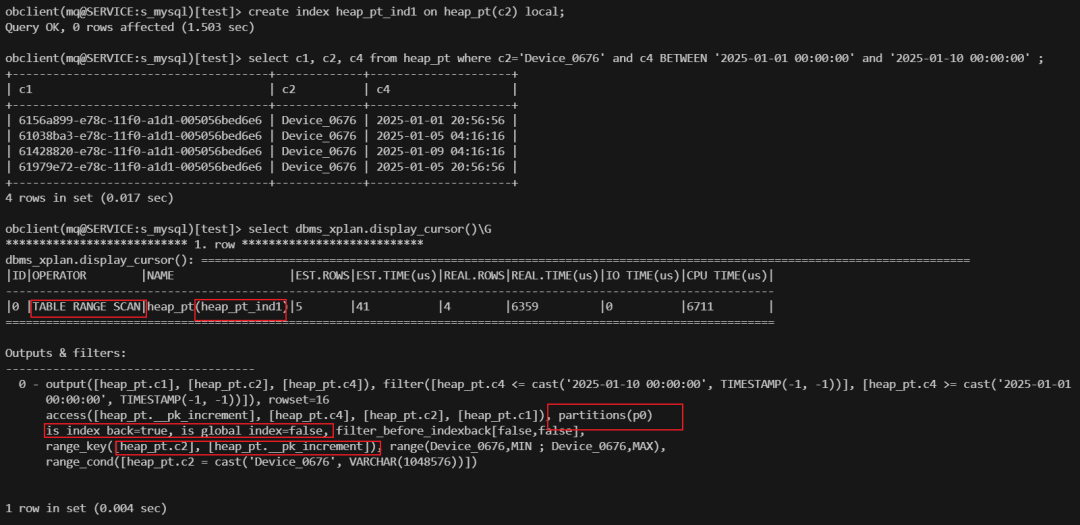
结论:
HEAP 分区表普通本地索引列包含隐藏列 __pk_increment
列。查询有分区字段先做分区裁剪,最后只扫描单个分区的索引并回表,所以执行计划是: TABLE RANGE SCAN
,没有并行。
HEAP 分区表有主键时查询测试
CREATE TABLE heap_pt_with_pk (
    c1 CHAR(36) NOTNULL,
    c2 VARCHAR(50),
    c3 VARCHAR(500),
    c4 TIMESTAMPNOTNULLDEFAULTCURRENT_TIMESTAMP
)  ORGANIZATION HEAP
PARTITIONBYRANGE (UNIX_TIMESTAMP(c4)) (
    PARTITION p202501 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-02-01 00:00:00')),
    PARTITION p202502 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-03-01 00:00:00')),
    PARTITION p202503 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-04-01 00:00:00')),
    PARTITION p202504 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-05-01 00:00:00')),
    PARTITION p202505 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-06-01 00:00:00')),
    PARTITION p202506 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-07-01 00:00:00')),
    PARTITION p202507 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-08-01 00:00:00')),
    PARTITION p202508 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-09-01 00:00:00')),
    PARTITION p202509 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-10-01 00:00:00')),
    PARTITION p202510 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-11-01 00:00:00')),
    PARTITION p202511 VALUESLESSTHAN (UNIX_TIMESTAMP('2025-12-01 00:00:00')),
    PARTITION p202512 VALUESLESSTHAN (UNIX_TIMESTAMP('2026-01-01 00:00:00'))
) WITH COLUMNGROUP(all columns);
insert/*+ append enable_parallel_dml parallel(4) */into heap_pt_with_pk select * from heap_pt;

select c1, c2, c4 from heap_pt_with_pk where c1='6864d475-e78c-11f0-a1d1-005056bed6e6' ;
select dbms_xplan.display_cursor()\G
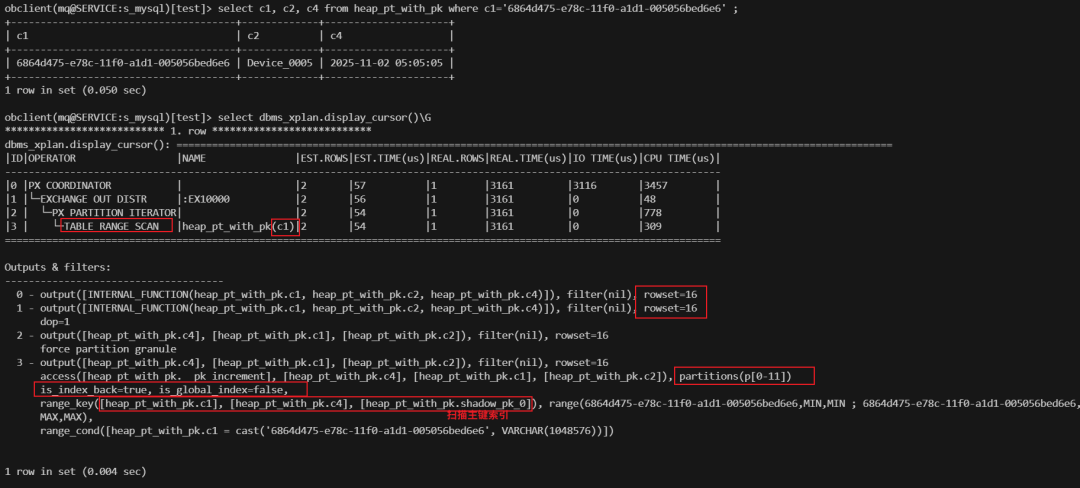
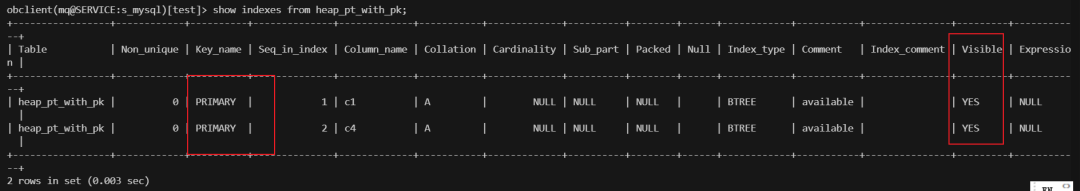
结论:
HEAP 分区表查询查询条件只有主键列的一部分,所以是对主键索引的扫描,算子是: TABLE RANGE SCAN
。HEAP 分区表查询走的主键索引扫描,主键索引不是数据,所以还有索引回表操作。
select c1, c2, c4 from heap_pt_with_pk where c1='6864d475-e78c-11f0-a1d1-005056bed6e6' and c4='2025-11-02 05:05:05';
select dbms_xplan.display_cursor()\G
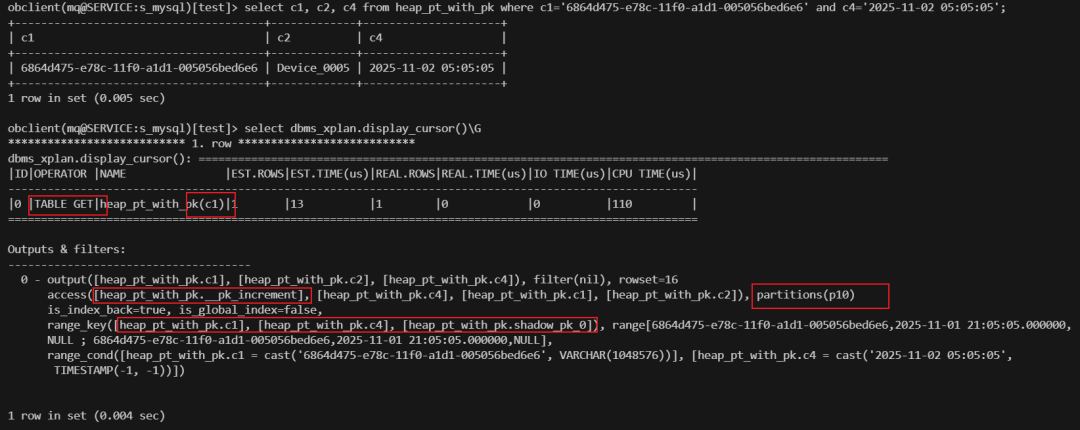
结论
当 HEAP 分区表有主键时查询的查询条件是所有主键列时,执行计划算子变为: TABLE GET
。但是这个主键索引数据应该是跟分区表的分区数据在一起的,所以执行计划算子不是DISTRIBUTED TABLE GET
。HEAP 分区表的主键索引也包含有隐藏列 shadow_pk_0
。HEAP 分区表的主键索引查询也有索引回表逻辑。 对于 HEAP 普通表也是同理,主键索引扫描返回时很有可能也要回表(除非查询列就是主键列的部分或全部。
create unique index heap_pt_with_pk_uk_global on heap_pt_with_pk(c1) global;
select c1, c2, c4 from heap_pt_with_pk where c1='6864d475-e78c-11f0-a1d1-005056bed6e6' ;
select dbms_xplan.display_cursor()\G
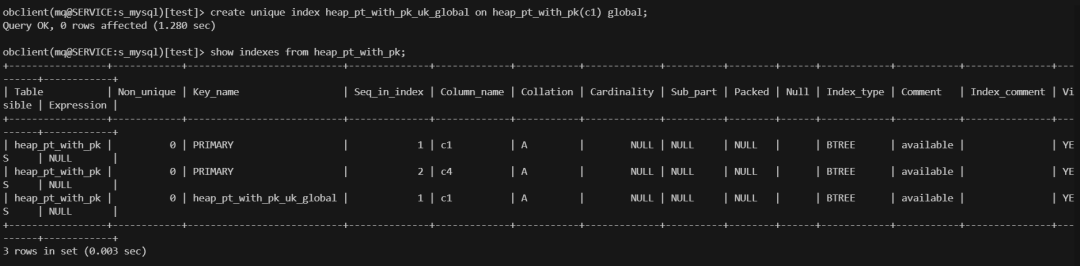
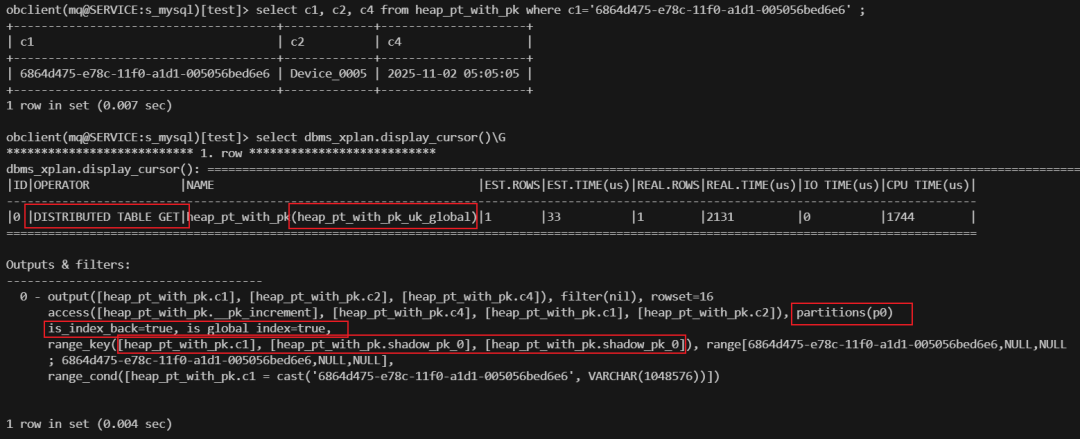
结论:
HEAP 分区表的全局唯一索引同样包含两个隐藏列( shaodow_pk_0
出现两次)。这个跟 IOT 分区表不一样。这个 HEAP 分区表查询走全局唯一索引虽然只返回一笔记录,但要回表。全局索引跟表是不同的 TABLET ,所以执行计划算子是 DISTRIBUTED TABLE GET
。
create index heap_pt_with_pk_ind1 on heap_pt_with_pk(c2) local;
select c1, c2, c4 from heap_pt_with_pk where c2='Device_0676' and c4 BETWEEN '2025-01-01 00:00:00' and '2025-01-10 00:00:00' ;
select dbms_xplan.display_cursor()\G
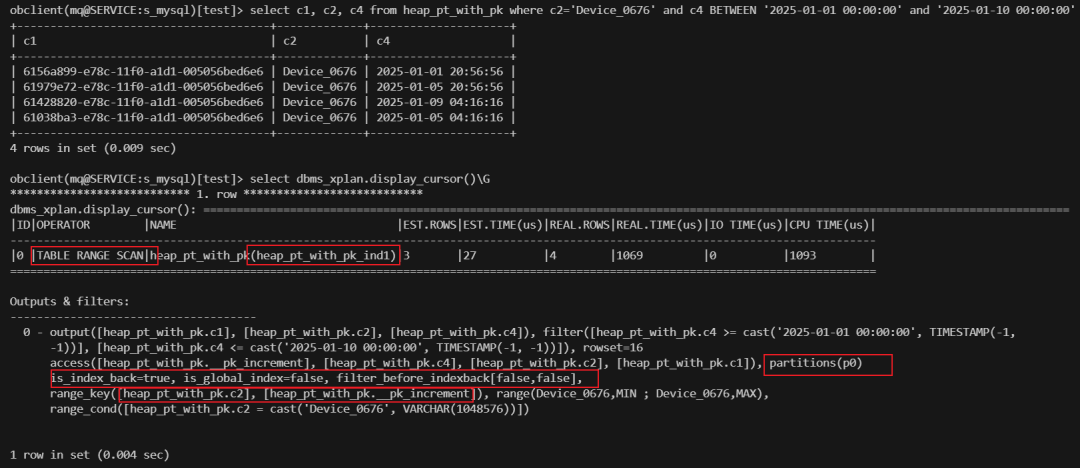
结论:
HEAP 分区表有主键时,普通本地索引里包含的是隐藏列 __pk_increment
而不是主键列。HEAP 分区表普通本地索引跟分区数据在一起,所以执行计划算子是 TABLE RANGE SCAN
而不是DISTRIBUTED TABLE RANGE SCAN
。
全局索引测试
create index iot_pt_ind2_global on iot_pt(c4) parallel4global;
createindex iot_pt_with_pk_ind2_global on iot_pt_with_pk(c4) parallel4global;
createindex heap_pt_ind2_global on heap_pt(c4) parallel4global;
createindex heap_pt_with_pk_ind2_global on heap_pt_with_pk(c4) parallel4global;
select c1, c2, c4 from iot_pt where c4='2025-11-02 05:05:05' limit 2;
select dbms_xplan.display_cursor()\G

select c1, c2, c4 from iot_pt_with_pk where c4='2025-11-02 05:05:05' limit 2;
select dbms_xplan.display_cursor()\G
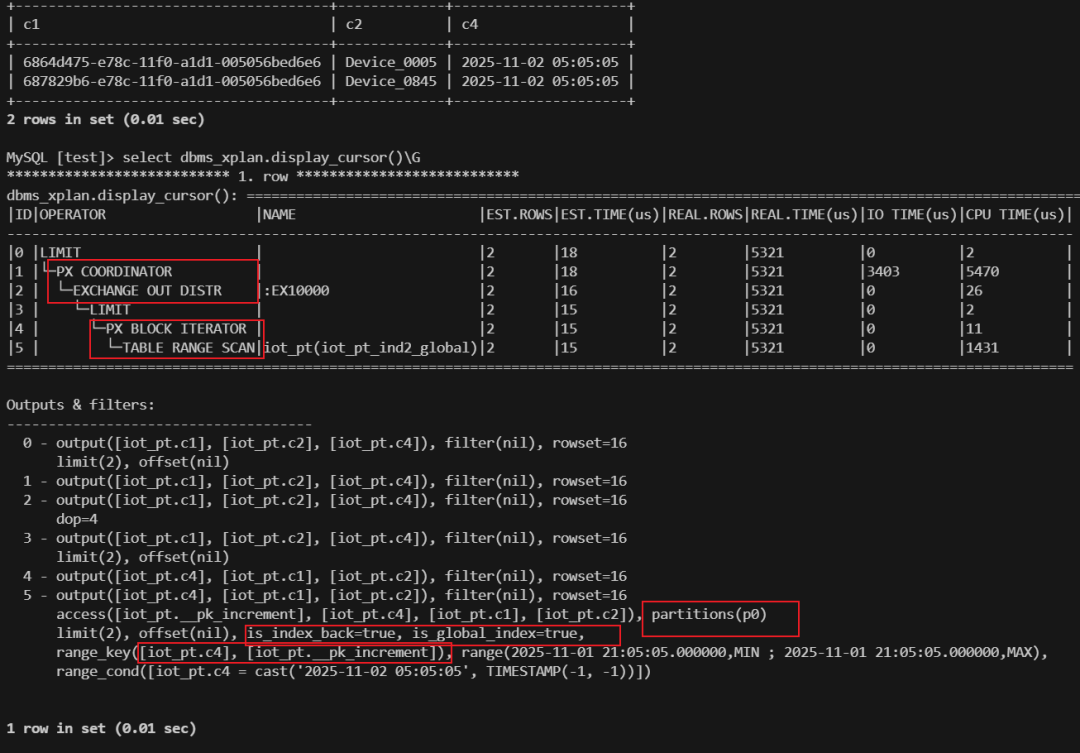
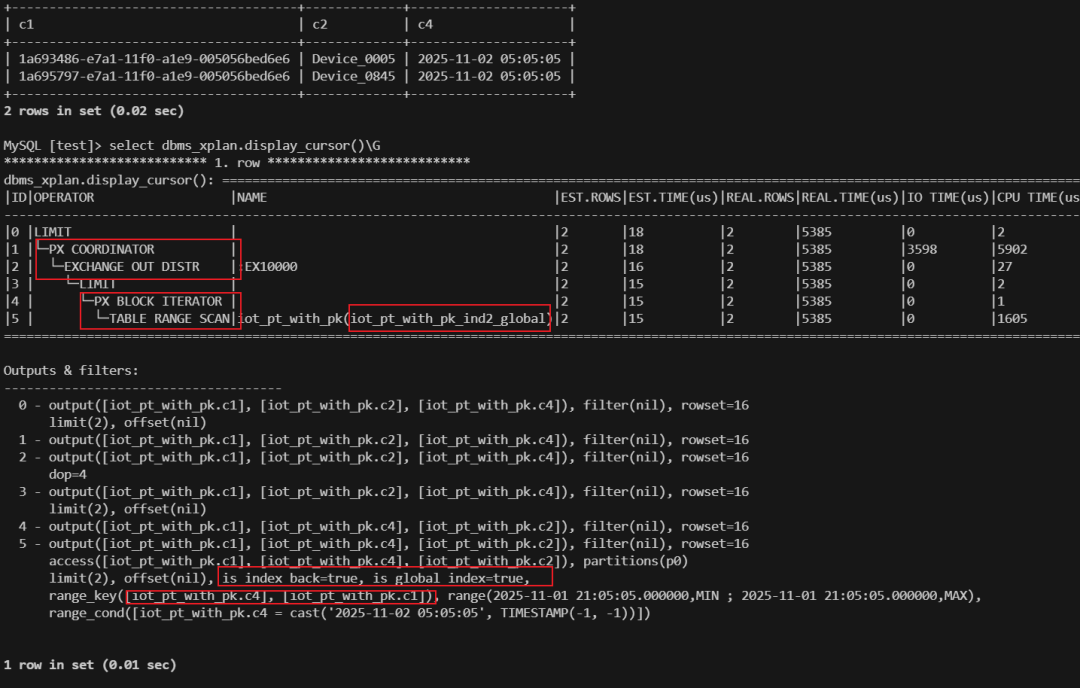
结论:
IOT 分区表无主键时,普通全局索引包含隐藏列 __pk_increment
;IOT 分区表有主键时,普通全局索引包含主键列。索引创建时开启了并行,所以全局普通索引扫描是索引块内并行扫描。 普通全局索引扫描有回表。
select c1, c2, c4 from heap_pt where c4='2025-11-02 05:05:05' limit 2;
select dbms_xplan.display_cursor()\G

select c1, c2, c4 from heap_pt_with_pk where c4='2025-11-02 05:05:05' limit 2;
select dbms_xplan.display_cursor()\G
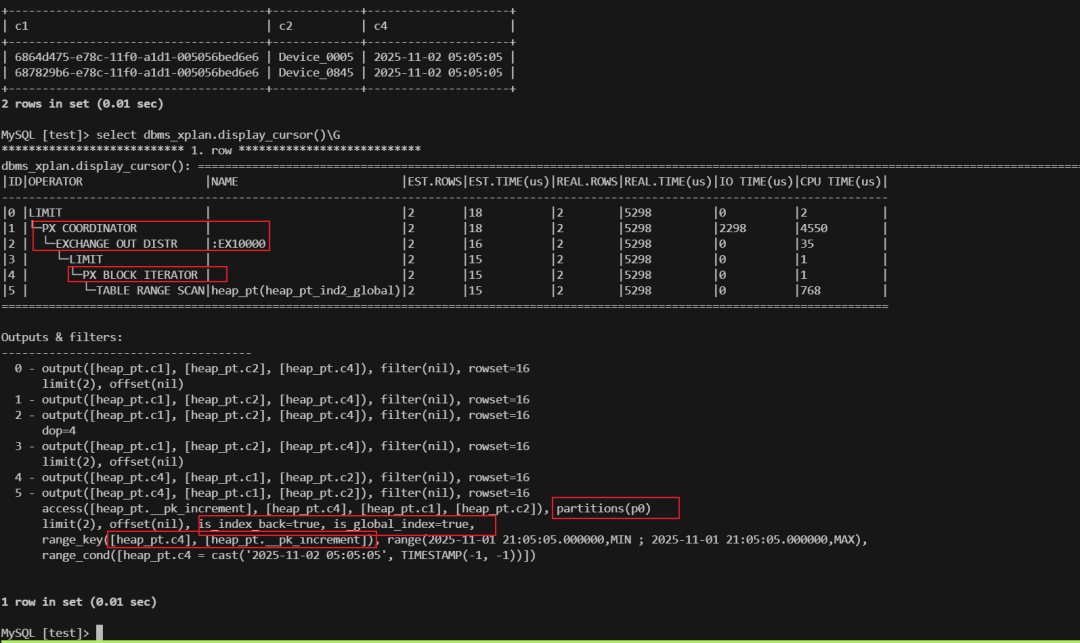
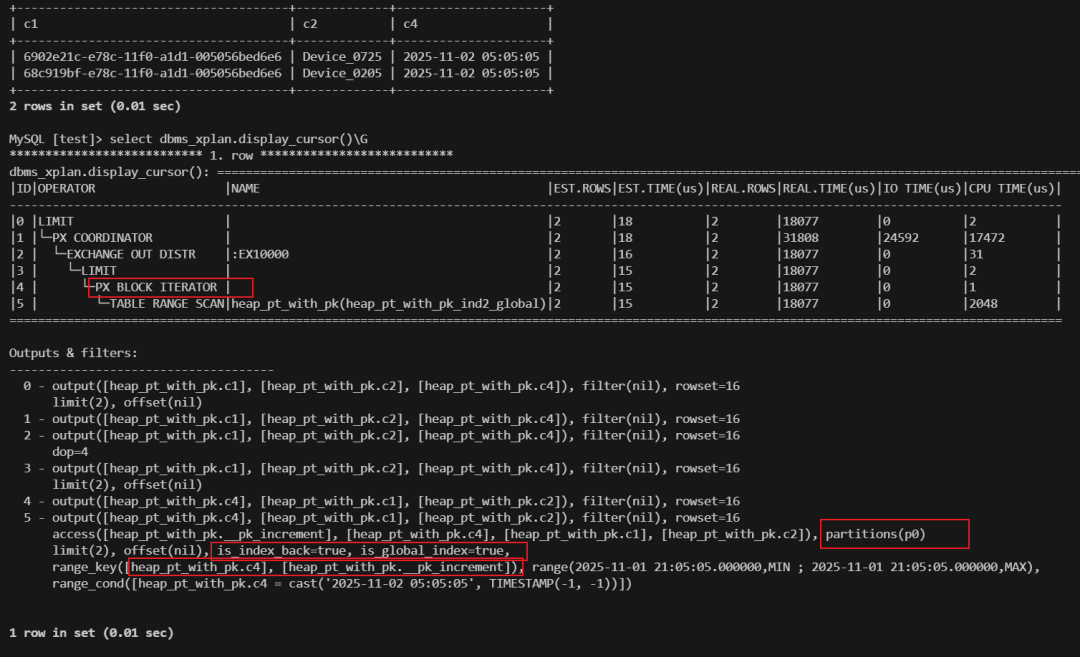
结论:
HEAP 分区表不管有无主键,普通全局索引包含隐藏列 __pk_increment
。由于索引创建时开了并行,所以执行计划是索引块级别并行扫描。
数据空间对比测试
将 4 各表索引只保留主键索引、本地普通索引、全局唯一索引、全局普通索引。然后数据量都增大到 100 万以上
alter table heap_pt dropkey heap_pt_uk_local;
altertable iot_pt dropkey`iot_pt_uk_local`;
createtable iot_pt_with_pk like iot_pt;
insert/*+ append enable_parallel_dml parallel(4) */into iot_pt_with_pk select * from iot_pt;


insert/*+ append enable_parallel_dml parallel(4) */into iot_pt selectuuid(),c2,c3,c4 from iot_pt;
insert/*+ append enable_parallel_dml parallel(4) */into iot_pt_with_pk selectuuid(),c2,c3,c4 from iot_pt_with_pk;
insert/*+ append enable_parallel_dml parallel(4) */into heap_pt selectuuid(),c2,c3,c4 from heap_pt;
insert/*+ append enable_parallel_dml parallel(4) */into heap_pt_with_pk selectuuid(),c2,c3,c4 from heap_pt_with_pk;
查看各个表和索引的存储空间大小。
WITH table_locs AS (
SELECT
 t.tenant_id,
 t.database_name,
 t.table_id,
 t.table_name,
 t.table_type tablet_type,
 t.tablet_id,
REPLACE(concat(t.table_name,':',t.partition_name,':',t.subpartition_name),':NULL','') tablet_name,
 t.tablegroup_name,
 t.ls_id,
 t.ZONE,
 t.ROLE,
 t.svr_ip
FROM
 oceanbase.CDB_OB_TABLE_LOCATIONS t
WHERE
 t.data_table_id ISNULL
UNION
SELECT
 i.tenant_id,
 i.database_name,
 i.table_id,
 t.table_name,
 i.table_type tablet_type,
 i.tablet_id,
REPLACE(
REPLACE(concat(i.table_name,':',i.partition_name,':',i.subpartition_name) ,concat('__idx_', i.data_table_id, '_'),'')
  ,':NULL',''
 ) tablet_name,
 i.tablegroup_name,
 i.ls_id,
 i.ZONE,
 i.ROLE,
 i.svr_ip
FROM
 oceanbase.CDB_OB_TABLE_LOCATIONS i
INNERJOIN oceanbase.__all_virtual_table t ON
 ( i.tenant_id = t.tenant_id
AND i.data_table_id = t.table_id  )
WHERE i.data_table_id ISNOTNULL
)
SELECT
 t.database_name,
 t.ls_id,
 t.ROLE,
 t.svr_ip,
 t.table_name,
concat(t.table_id, ':', t.tablet_id) ids,
 substring_index(t.tablet_name, ':', 1) tablet_name,
-- group_concat(s.table_type,',') tablet_types,
round(sum(s.size)/1024/1024/1024,2) size_gb,
count(*) tablet_cnt
FROM
 table_locs t JOIN oceanbase.GV$OB_SSTABLES s
ON (t.tenant_id=s.tenant_id AND t.ls_id=s.ls_id AND t.svr_ip=s.svr_ip AND t.tablet_id=s.tablet_id)
WHERE
 t.tenant_id = 1002
AND t.database_name IN ('test')
AND s.table_type NOTIN ('MEMTABLE')
-- AND t.ROLE IN ('LEADER')
GROUPBY
 t.database_name,
 t.ls_id,
 t.ROLE,
 t.svr_ip,
 t.table_name,
 substring_index(t.tablet_name, ':', 1)
ORDERBY
 t.database_name,
 t.ls_id,
 t.ROLE,
 t.svr_ip,
 t.table_name,
 t.tablet_name
;
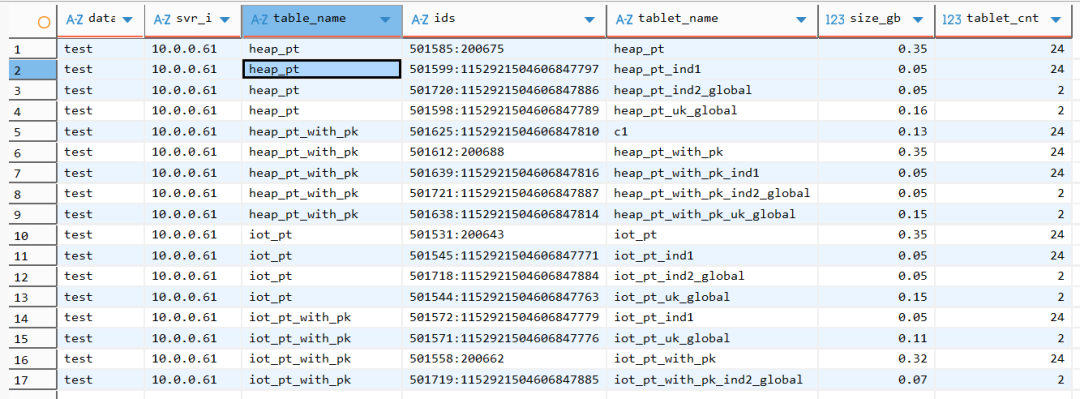
结论:
IOT 表无主键时有隐藏列 __pk_increment
;有主键时没有隐藏列,主键即数据(同一个 TABLET )。HEAP 表不管有没有主键,都有隐藏列 __pk_increment
,有主键时,主键数据是独立的 TABLET (额外的存储空间),但是跟表分区是在一起的,所以主键索引回表操作都不是分布式执行计划算子。IOT 表无主键时数据大小跟堆表的数据大小一样,IOT 表有主键时数据大小反而要小一点点。
总体结论
综上所述,总结索引组织表(IOT)和堆表(HEAP)特点如下:
堆表的实现原理看起来跟无主键的索引组织表一样,都是使用了内部隐藏列 __pk_increment
,不同之处是有主键的时候,堆表的主键跟表数据是分开独立的存储(TABLET
)。但是,依然是在同一个节点上。堆表的主键索引看起来跟本地分区索引特性是一样的。所以,堆表形式的分区表的主键依然要求主键列包含所有的分区列。堆表形式的分区表的本地唯一约束/索引也是同类要求。索引组织表的在有主键的时候,普通的索引列会包含主键列信息,并在回表的时候再次扫描主键索引(也就是表数据),无主键的时候则没有这个问题。堆表不管有没有主键,普通索引都是包含隐藏列 __pk_increment 。 OB 的表的唯一索引列都会包含至少一个隐藏列 shaodow_pk_0
,分区表的本地唯一索引也会包含一个隐藏列shadow_pk_0
,分区表的全局索引包含至少两个隐藏列(shadow_pk_0
和shadow_pk_1
)。关于这个列的存在说法是因为 OB 的索引允许存储 NULL 值,所以需要借助这个字段来确保有 NULL 值时的唯一性。分区表的唯一索引里两个隐藏列,跟隐藏列__pk_increment
和分区列有什么关系这个目前文档里没有信息。索引组织表形式的分区表的无主键表以及堆表形式的分区表(不管有无主键)中的隐藏列 __pk_increment
特性跟本地唯一索引很向,是分区内部自增数字,不同分区间独立自增,一定有重复数据。这种特性对性能的影响如何在小数据量下看不出来,等以后再用大批量数据做测试看看。OB 分区表的主键和唯一约束要求包含所有分区列,这个跟原生 ORACLE 不一样,实际使用比较别扭。所以个人觉得在有些场景下分区表可以不要主键,将原有主键改为全局唯一索引。不管是索引组织表还是堆表,都可以这么做。不过分区表的全局索引很可能会导致分区表的事务变成分布式事务(还依赖于租户主副本的分布策略 PRIMARY_ZONE 和资源单元数量 UNIT_NUM 的设置)。除此之外是否还有其他问题,欢迎用过的朋友留言讨论。
更多阅读
文章转载自数据库技术闲谈,如果涉嫌侵权,请发送邮件至:contact@modb.pro进行举报,并提供相关证据,一经查实,墨天轮将立刻删除相关内容。
