



DTCC(中国数据库技术大会)已经走过了15个年头,今年(2025)已是第16届DTCC。
做为国内最大的数据库技术盛会,DTCC很大程度上就像一个风向标。从传统数据库开始,大数据、NoSQL、分布式、开源、自主可控、国产化……,这一路走来,DTCC的主题,一定程度上成为不同时代的印记。
早在2012年,中国数据库先驱王珊老师在接受DTCC采访时:
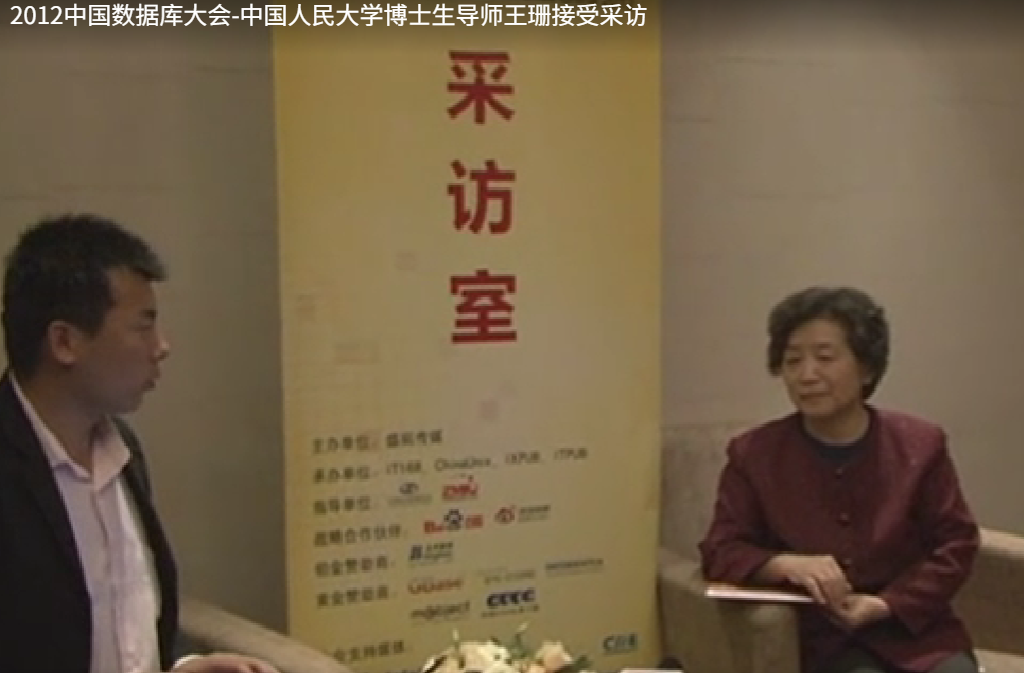
(采访视频已上传IT知识刺客公众号)
谈到数据库的发展,就借DTCC平台,谆谆教导我们,要关注硬件,CPU、多核等新技术,鼓励我们自主创新。
王珊老师说的关注硬件,可不是把一堆硬件组装在一起,调用API去用一用而已。
硬件,现在已经形成了一个专业领域:体系结构。专门研究CPU、内存等硬件原理。
数据库始祖、关系型数据库创始大神科德(Codd),本来的专业是数学。在年近40岁时,到密歇根大学系统的学习了几年硬件,补全了知识短版,才完成了龙场悟道,之后不久就提出了关系模型。
数据库是基础软件,不系统的了解底层体系结构,终究是浮沙之上筑高楼。
基础软件,要担的起“基础”这两个字。
王珊老师的教导,即使穿越十几年光阴,仍有极大的意义。
在采访王珊老师时,DTCC记者朋友提了一个很好的问题,国产数据库能否在找到一个切入点,比如更好的服务啊、或大数据、NoSQL、甚至分布式等,实现对国外数据库的反超。
听到这个问题,王珊老师意味深长的笑了:
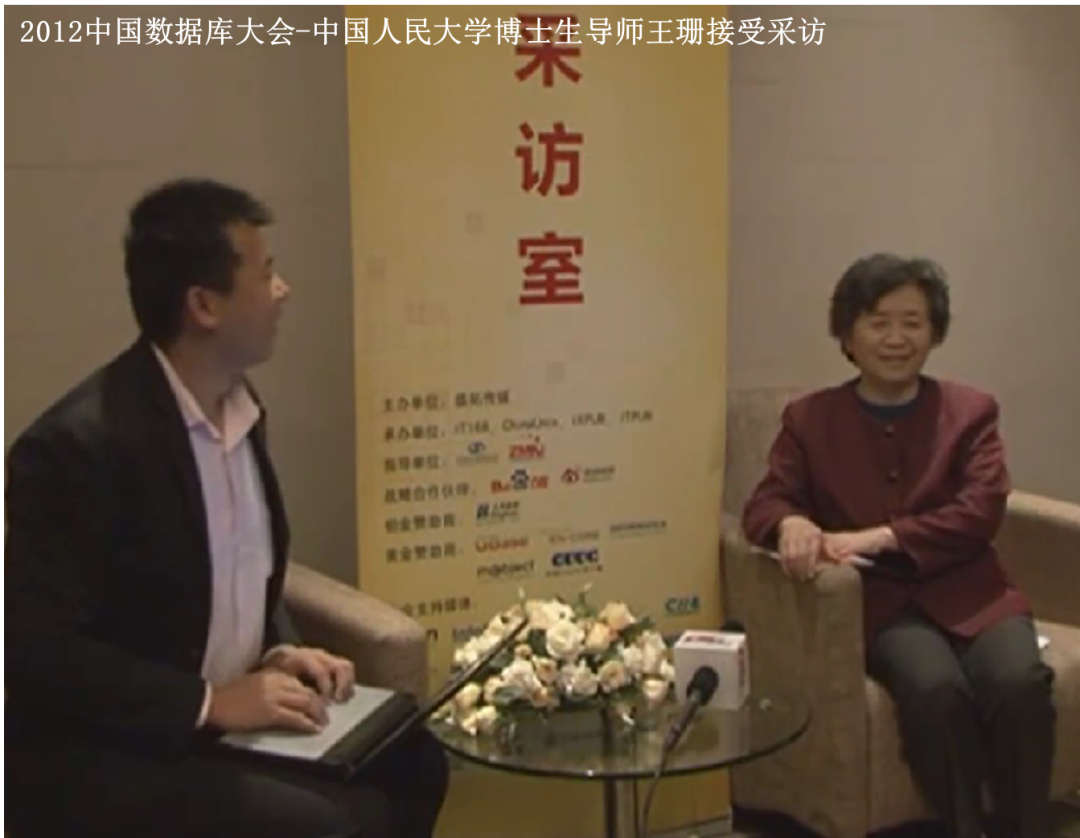
她回答了什么,算了,我不在这里总结了,有兴趣的读者朋友自行查看吧。
时光荏苒,岁月如梭。DTCC已经是第16届。从12年算起,13年过去了,苍海,已经变成桑田。或许现在可以回答记者朋友的问题了:国产数据库能否在找到一个切入点,实现中国数据库的崛起?
这个答案,是肯定的。
那个切入点,还真的出现了。但不是大数据库,也不是NoSQL、分布式等等,也不是如火如荼的AI。这些技术点都没有成为中国数据库掘起的切入点。
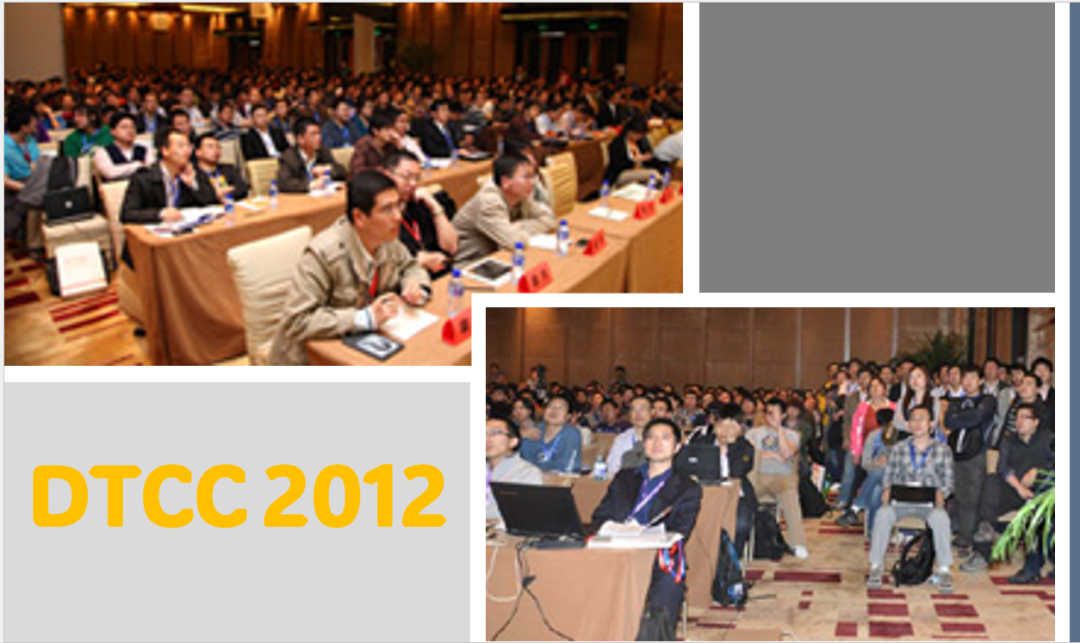
2012年DTCC,人是满满登登,会场还略显紧凑。13年过去了,今年DTCC,我提前到了一天,傍晚时溜达到会场看了看。基本已经布置停当,只剩几名酒店服务员,还在摆放椅子,相比2012年,会场恢宏大气:
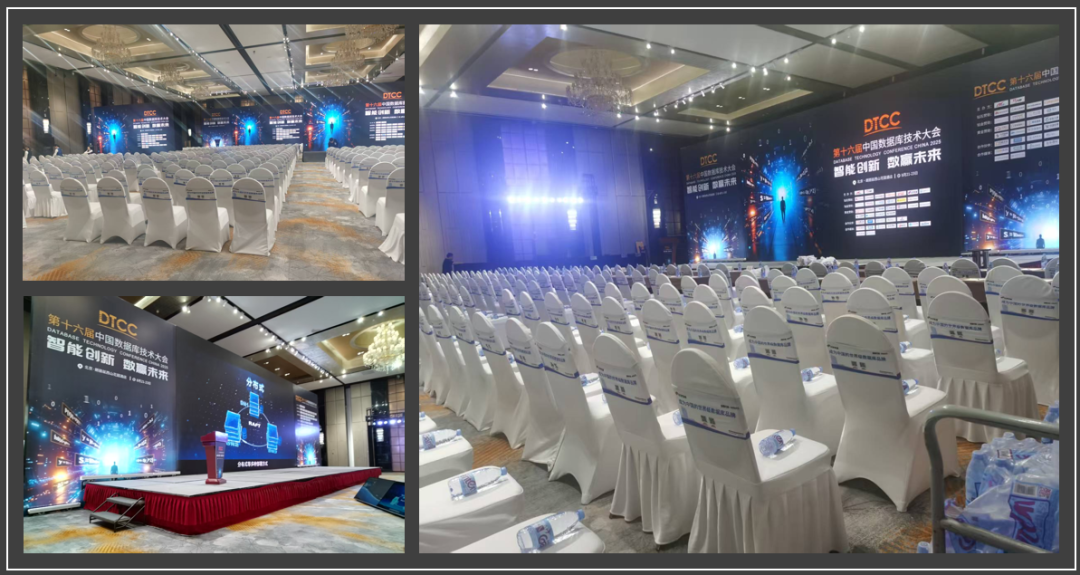
13年,很多事情发生了改变。不变的是,会场中熙熙攘攘的人流,以及,DTCC依然像风向标,反应着数据库的发展。
今年DTCC,AI彻底火出圈,以至于有4个场次和AI直接相关:
专场4:AI For DB(上)
专场8:Data + AI(上)
专场9:AI For DB(下)
专场17:Data + AI(下)
AI场次,基本都是当天人最多的场次。
放几张AI场次的火爆画面,大家感受下:
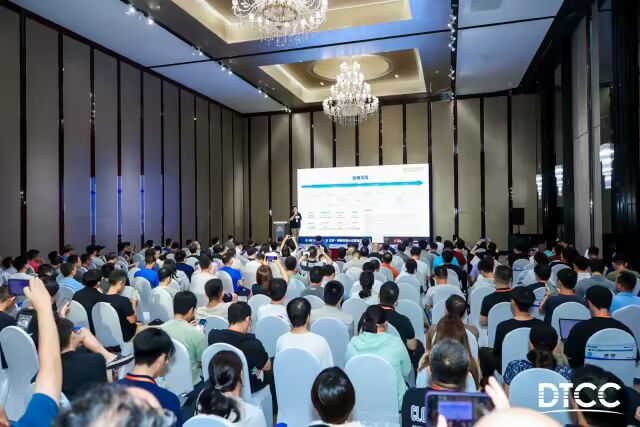
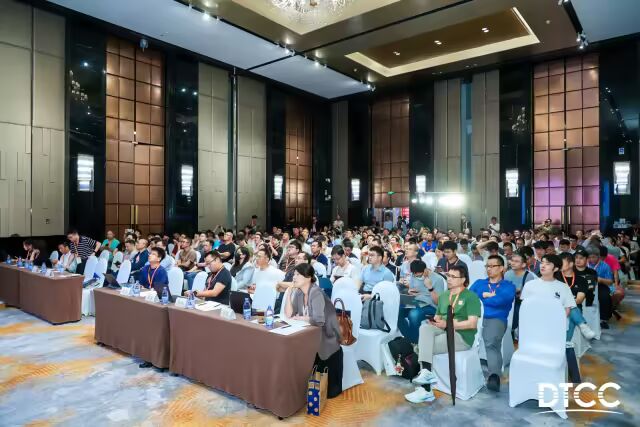
甚至连传统的热门场次:内核、分布式、云,都被AI分走不少人流。
而且就算是其他场次,也能时不时听到AI。
其实我的内容,也跟AI相关。我今年的内容《数据库内核未来技术展望》,本身是一个庞大的话题,我原计划围绕两个字好好聊聊:算力。
但担心时长超标,只保留了GPU和CPU向量计算的比较、分析。
说到算力,GPU的算力千、百倍于CPU,这几乎是共识:
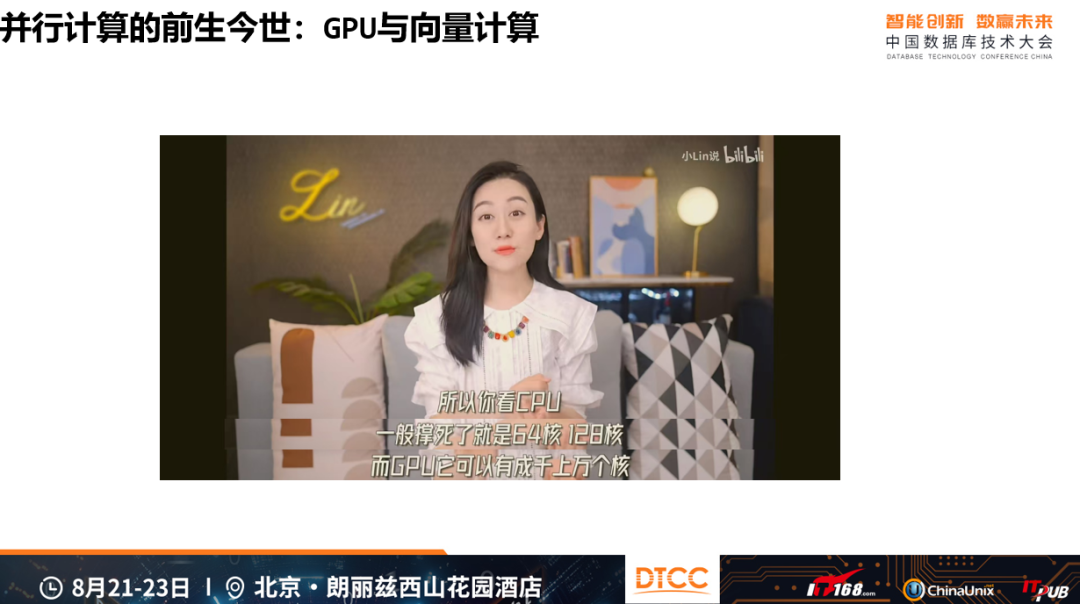
这是B站很火的一个财经类UP主讲英伟达公司的视频,连和IT关系不大的人都知道,CPU最多几十核、上百核(只说物理核),但GPU动辄上万核。
但,真的是如此吗?
传统观念上,GPU长于计算,CPU长于逻辑。
但CPU中有一个东东被我们忽视了,就是下图中的:向量计算单元:
CPU的硅片面积中,有大量的向量计算单元。
这些概念就是名词唬人,其实都很简单。大会中,我为大家介绍了这些“不说人话”的概念:
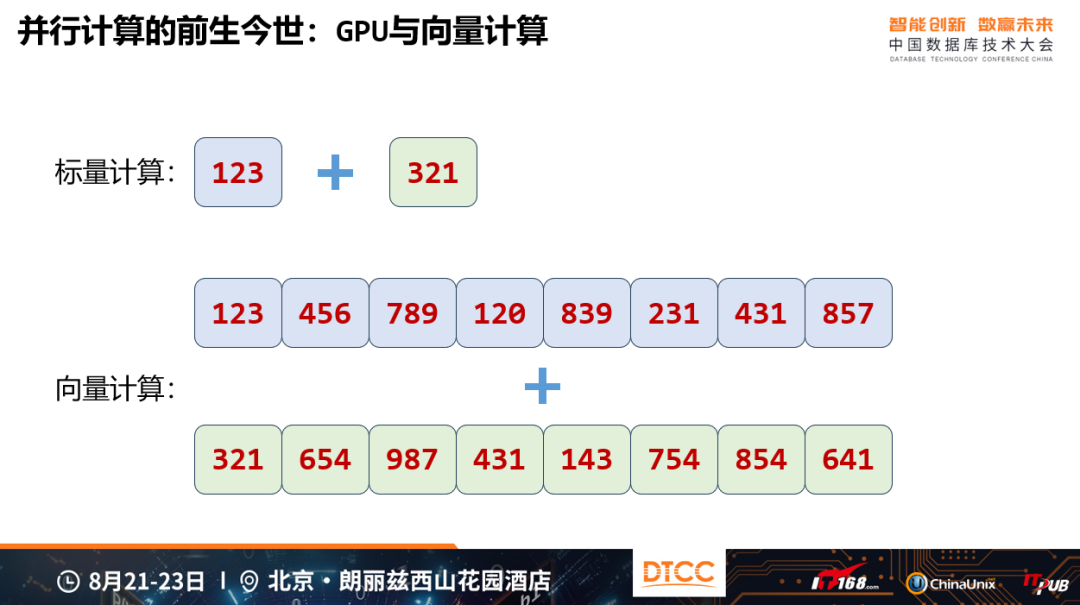
l标量就是一个数,向量就是一组数。
l标量计算就是一个数和另一个数做计算。这是传统的、通常我们所说的“计算”。
l向量计算就是一组数和另一组数做计算。
就这么简单。
简而言之,向量计算单元相当于组合多个普通的标量计算单元。
在现场,我举了一个例子,向量计算单元,相当于把“十个一块钱,组合成一个十块钱”。
但是,组合成十块钱后,这十块钱还在一个核、一个CPU中。
而GPU的的十块钱,分别对应十个核。
那么现在,GPU说:“我有十张钱,但你只有一张钱,我的算力是你的十倍”。
你看出问题了吧,详细的我就不放在这儿了,关注DTCC,等放出PPT后,我再为大伙详细解读。
从并行计算上讲,CPU并不差,算上成本,甚至可能会好于GPU。
但为什么不能用CPU进行AI的训练?
现场我着重介绍了这个问题,首先,GPU的张量计算单元,强于CPU。
张量计算就是矩阵计算,这可是AI的基础。
CPU中也有能做张量计算的,比如Intel在4代至强时就推出AMX张量指令集和张量计算单元。
说到这儿,我额外的插了一段反常识的题外话:“指令集并不重要,重要的是背后的计算单元。”
指令集相当于“面子”,后面的“里子”是计算单元。
AMX的里子是标准的鸡肋。
你不能放弃,AI代表未来,你放弃了AMX就代表放弃了未来。所以不能放弃,但是吧,AMX又实在无法做到比GPU更强。
AMX无法比GPU更强,但实际也并不弱。
真正让CPU在AI算力大战中输的底裤都不剩的,是老黄打造的“体系“。
GPU有整套为AI而生的体系。CPU这边却是在修修补补。
比如多块GPU的互联,老黄有NVLink,点对点带宽达900GB/s,多链路合计带宽达1.8TB/s。
CPU多核互联,比如Intel UPI、AMD Infinity Fabric,点对点带宽只能在50GB/s以内,多链路合计带宽也只能做到百GB/s量级。
为了让GPU能更大规模的互联,老黄更是打造了NVLink Switch,它能跨服务器组合多台服务器中的GPU。CPU这边到现在为止没有对标的产品。
虽然NVLink Switch距离有限,通常只在一个机架内,但也算是突破了。
CPU除了带宽还要低延迟,UPI/ Infinity Fabric的延迟都是很低的。跨服务器互联无法做到低延迟,对CPU来说意义有限。
总的来说,CPU的体系并不是为AI而生的。
NVLink 和NVLink Switch还有对应的软件,NCCL库,再加上CUDA,老黄为AI打造了一个完整的体系。
体系化后可以有多强?
前一阵子印巴空战已经给我们上了生动的一课。巴方的战机、导弹、预警机、通信系统、导航系统,等等是一个完整的体系。印方阵风虽然先进,但还没有先进到以一己之边对抗一个体系。
回过来继续说CPU的张量计算单元(AMX计算单元),它并不差,但像印方的阵风战机一样,也没有领先到以一己之边对抗一个体系的地步。
GPU强在AI计算体系,这一块上,CPU在硬件上短板明显,所有AI还是只能靠GPU。
如果刨除AI,只说并行计算,比如排序、HASH、Group by、Filter等通用计算,甚至pre-AI/post-AI计算(如数据的向量化、AI推理等),CPU是否可以一战呢?
这其实是我主要要讲的内容:潜力巨大的向量计算。
CPU通过向量计算方式,提供了不弱于GPU的并行计算能力,只是因为缺乏体系化,没有发挥出来。
我举了一个例子佐证这一观点:
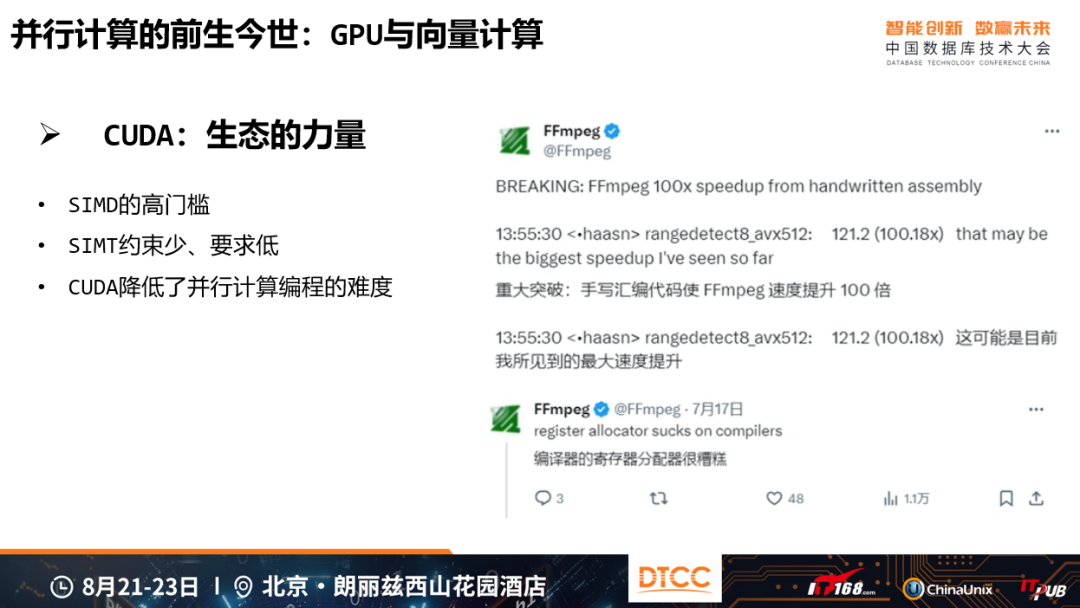
FFmpeg是和PG同一量级的世界知名开源基础软件。
这个例子生动的说明了一个问题,向量虽好,但得一流的开发者,才能释放它的潜力。而且一下子就能释放出百倍的性能潜力。
为什么会这样?
CPU的向量计算没有体系化,这导致它的使用难度大大增加。向量计算虽好,不会用也白搭。
这段就不展开了,大家等着看PPT吧。
总的来说,这一次我的分享内容,是历年来难度最低的,我只是做了大量的名词解释,标量、向量、张量、SIMD、SIMT、……。
最后,还用DTCC 2012王珊老师访谈做个结尾:
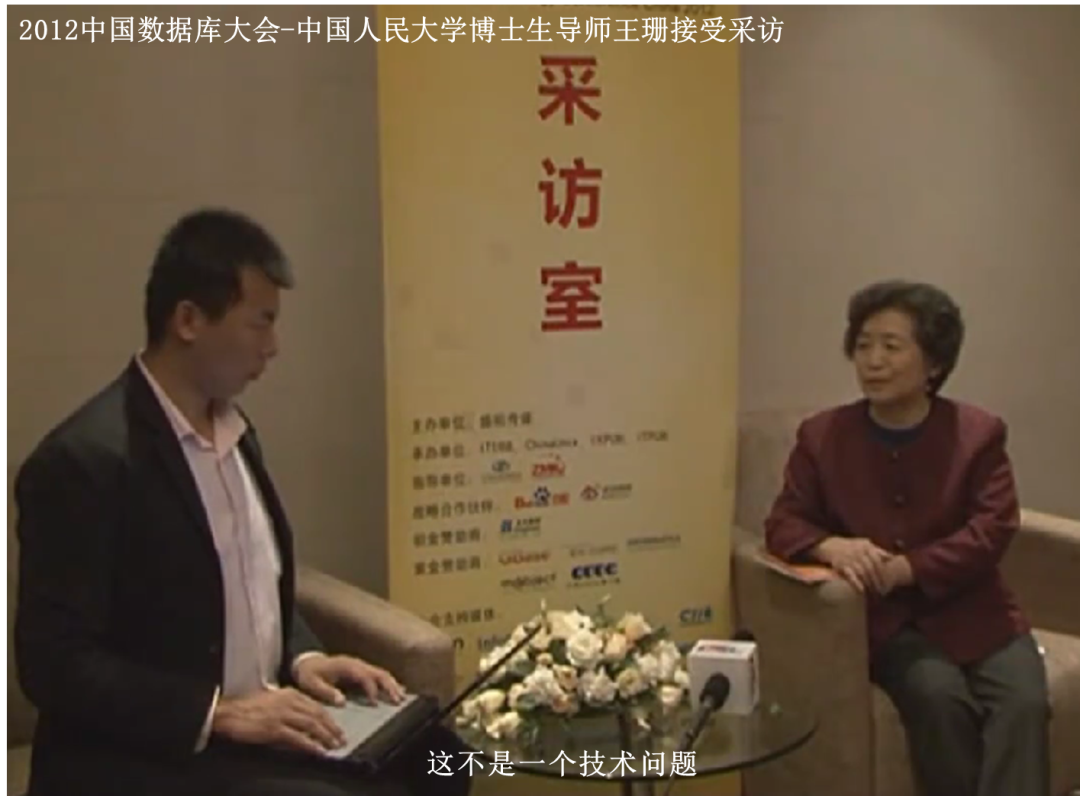 当DTCC记者朋友问到国产数据库有无可能跨越式发展时,王珊老师回答说我们的数据库已经很好了,但这不是一个一个技术问题,……。
当年听到这话时,我无甚感知。在技术之路上又狂奔了十三年。
再听到这话时,我不禁感慨万千。对啊,这不是一个技术问题。初闻不知话中意,再听已是话中人。
