



一、架构演进背景与业务挑战
1.1 业务场景特征
字节跳动实时数仓支撑着抖音、今日头条等核心产品的实时数据分析需求,每日处理数据量超2.5万亿条,峰值QPS达到8000万/秒。典型场景包括:
实时用户行为分析(播放、点赞、评论、分享) A/B测试指标实时计算 广告效果实时监控 内容推荐质量实时评估
1.2 技术挑战矩阵
大厂案例: 数据中台 爱奇艺 菜鸟 滴滴 蘑菇街 数据底座(文末加入星球下载↓)
二、核心架构设计
2.1 整体架构图
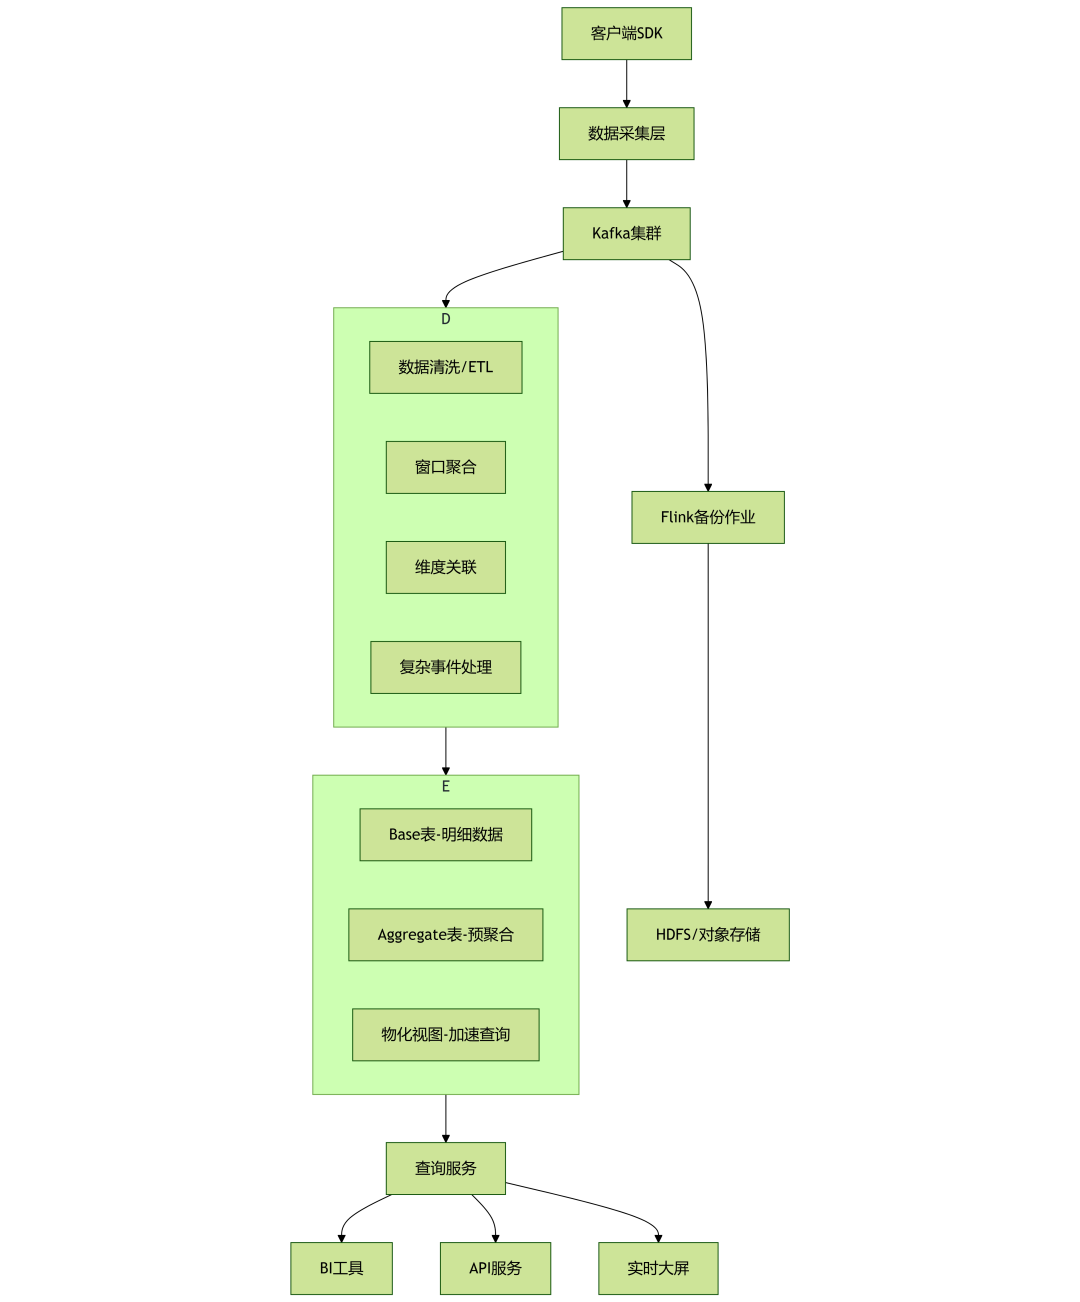
2.2 分层架构详解
2.2.1 接入层:Kafka集群优化
# Kafka生产端配置优化
producer_configs:
acks:"all"                    # 确保数据不丢失
compression.type:"lz4"        # 平衡压缩率与CPU消耗
batch.size:524288            # 512KB批量大小
linger.ms:5                  # 适当延迟提升吞吐

# 集群拓扑设计
cluster_topology:
brokers_per_zone:12          # 每个可用区12节点
replication_factor:3         # 3副本保障可用性
partition_strategy:"key-hash"# 按业务键分区
retention_policy:"24h_hot + 7d_warm"# 热数据24h,温数据7天
真实案例:跨地域数据同步优化
// 使用MirrorMaker 2.0的改进配置
properties.put("replication.factor", "3");
properties.put("offset-syncs.topic.replication.factor", "3");
properties.put("sync.topic.acls.enabled", "false");
properties.put("emit.checkpoints.enabled", "true");
properties.put("refresh.topics.enabled", "true");

// 关键调优参数
properties.put("consumer.fetch.min.bytes", "1048576");  // 1MB最小抓取
properties.put("consumer.max.poll.records", "5000");    // 单次最大记录数
添加v,备注Kafka,领取资料
2.2.2 计算层:Flink作业架构
作业拓扑设计图:
Flink Job Topology | ||||
Source(Kafka) | Map(ETL) | KeyBy(UserId) | Window(10s) | |
并行度: 256 | 并行度: 256 | Hash分区 | 滑动窗口聚合 | 并行度:128 |
核心代码实现:
public class UserBehaviorAggregation {
    public static void main(String[] args) {
        StreamExecutionEnvironment env = StreamExecutionEnvironment
            .getExecutionEnvironment();

        // 精确一次语义配置
        env.enableCheckpointing(60000);
        env.getCheckpointConfig().setCheckpointingMode(CheckpointingMode.EXACTLY_ONCE);
        env.getCheckpointConfig().setMinPauseBetweenCheckpoints(30000);
        env.getCheckpointConfig().setCheckpointTimeout(120000);
        env.getCheckpointConfig().setMaxConcurrentCheckpoints(1);

        // 状态后端配置
        StateBackend stateBackend = new RocksDBStateBackend(
            "hdfs://namenode:9000/flink/checkpoints",
            true
        );
        env.setStateBackend(stateBackend);

        // 实时聚合逻辑
        DataStream<UserEvent> stream = env
            .addSource(new FlinkKafkaConsumer<>(
                "user_events",
                new JSONKeyValueDeserializationSchema(),
                properties
            ))
            .assignTimestampsAndWatermarks(
                WatermarkStrategy.<UserEvent>forBoundedOutOfOrderness(Duration.ofSeconds(5))
                    .withTimestampAssigner((event, timestamp) -> event.getTimestamp())
            );

        // 窗口聚合
        DataStream<UserBehaviorAgg> aggregated = stream
            .filter(event -> event.getEventType().equals("play"))
            .keyBy(UserEvent::getUserId)
            .window(SlidingEventTimeWindows.of(Time.minutes(10), Time.seconds(30)))
            .aggregate(new UserBehaviorAggregator());

        // Doris Sink
        aggregated.addSink(new DorisSinkFunction());
    }
}
添加v,备注Flink,领取资料
2.2.3 存储层:Doris表设计
分层存储策略:
-- 基础明细表(按天分区)
CREATE TABLE dwd_user_events (
    event_time DATETIME,
    user_id BIGINT,
    event_type VARCHAR(32),
    video_id BIGINT,
    duration INT,
    device_info JSON
) ENGINE=OLAP
DUPLICATE KEY(event_time, user_id)
PARTITION BY RANGE(event_time) ()
DISTRIBUTED BY HASH(user_id) BUCKETS 128
PROPERTIES (
    "replication_num" = "3",
    "storage_medium" = "SSD",
    "storage_cooldown_time" = "9999-12-31 23:59:59"
);

-- 聚合表(小时级预聚合)
CREATE TABLE dws_user_hourly (
    event_hour DATETIME,
    user_id BIGINT,
    play_count BIGINT SUMDEFAULT "0",
    total_duration BIGINT SUMDEFAULT "0",
    like_count BIGINT SUMDEFAULT "0"
) ENGINE=OLAP
AGGREGATE KEY(event_hour, user_id)
PARTITION BY RANGE(event_hour) ()
DISTRIBUTEDB YH ASH(user_id) BUCKETS 64
PROPERTIES (
    "replication_num" = "2",
    "storage_medium" = "SSD"
);

-- 物化视图(分钟级热数据)
CREATE MATERIALIZED VIEW mv_user_realtime
AS
SELECT
    user_id,
    COUNT(*) as event_count,
    SUM(duration) as total_duration
FROM dwd_user_events
WHERE event_time >= DATE_SUB(NOW(), INTERVAL 1 HOUR)
GROUP BY user_id;
添加v,备注doris,领取资料
三、性能调优实战
3.1 Flink作业调优
3.1.1 资源配置优化矩阵
askManager内存 | 8-16G | 根据状态大小调整 |
TaskManager Slot数 | CPU核数×0.8 | |
网络缓冲 | 64KB-1MB | 高吞吐时增大 |
RocksDB状态后端 | 本地SSD | 避免与HDFS竞争 |
Checkpoint间隔 | 1-5分钟 | 失败恢复权衡 |
3.1.2 反压处理策略
// 监控反压
env.getExecutionEnvironment().getConfig().setLatencyTrackingInterval(5000);

// 动态扩缩容策略
public class DynamicScalingStrategy {
    // 基于Kafka Lag的扩缩容
    public int calculateDesiredParallelism(
        long currentLag,
        long processingRate,
        int currentParallelism
    ) {
        double lagInSeconds = currentLag  (double) processingRate;

        if (lagInSeconds > 300) { // 超过5分钟延迟
            return Math.min(currentParallelism * 2, maxParallelism);
        } elseif (lagInSeconds < 30) { // 延迟小于30秒
            return Math.max(currentParallelism  2, minParallelism);
        }
        return currentParallelism;
    }
}
3.2 Doris查询优化
3.2.1 查询性能对比
-- 优化前:全表扫描
SELECT user_id, COUNT(*)
FROM dwd_user_events
WHERE event_type = 'play'
AND event_time BETWEEN '2024-01-01' AND '2024-01-02'
GROUP BY user_id
HAVING COUNT(*) > 100;

-- 优化后:利用预聚合表
SELECT user_id, play_count
FROM dws_user_hourly
WHERE event_hour BETWEEN'2024-01-01 00:00:00'
AND'2024-01-01 23:59:59'
AND play_count > 100;

-- 性能对比结果:
-- 查询时间: 从12.3秒 → 0.8秒
-- CPU消耗: 从78% → 12%
-- 扫描数据量: 从1.2TB → 45GB
3.2.2 索引优化策略
-- 复合索引设计
ALTER TABLE dwd_user_events
ADD INDEX idx_user_event (user_id, event_type, event_time)
USING BITMAP;

-- 布隆过滤索引
ALTERTABLE dwd_user_events
SET ("bloom_filter_columns" = "user_id,video_id");

-- 分区分桶优化
CREATE TABLE optimized_table (
    ...
)
PARTITION BY RANGE(event_time) (
    PARTITION p202401 VALUES [('2024-01-01'), ('2024-02-01'))
)
DISTRIBUTED BY HASH(user_id) BUCKETS 128
PROPERTIES (
    "colocate_with" = "user_group",
    "dynamic_partition.enable" = "true",
    "dynamic_partition.time_unit" = "DAY",
    "dynamic_partition.end" = "3",
    "dynamic_partition.prefix" = "p"
);
四、真实案例:抖音实时观看指标计算
4.1 业务需求
实时计算每个视频的观看次数、时长、完播率 指标延迟<5秒,准确性99.99% 支持100万QPS写入,5000QPS复杂查询
4.2 技术实现
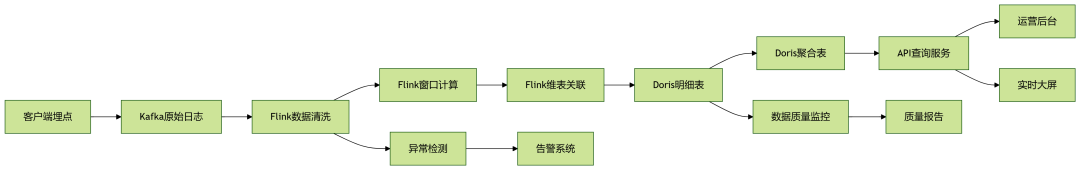
4.3 性能指标
performance_metrics:
  data_throughput:"1.2M events/sec"
end_to_end_latency:
    p50:"1.8s"
    p95:"3.2s"
    p99:"4.7s"
resource_utilization:
    flink_cpu:"68%"
    doris_cpu:"42%"
    kafka_network:"3.2Gbps"
cost_efficiency:
    cost_per_million_events:"$0.47"
    storage_cost_pb_per_month:"$12,500"
参考方案资料:智慧城市 数据中台 数据治理 建设方案 解决方案PPT(文末加入星球下载↓)
五、踩坑经验与反思
5.1 重大故障复盘
故障一:Kafka集群脑裂
时间:2023年3月15日
现象:数据重复率突增到15%,部分分区不可用
根因:跨地域网络抖动导致ZooKeeper会话超时
解决:
引入KRaft模式替换ZooKeeper 优化网络拓扑,增加专线冗余 实施分区自动迁移策略
# 监控脚本示例
#!/bin/bash
# Kafka集群健康检查
CHECK_INTERVAL=60
MAX_LAG=100000

while true; do
    # 检查分区Leader分布
    ./kafka-topics.sh --describe | grep -E "Leader: -1|Isr:.*-1"

    # 检查Consumer Lag
    LAG=$(./kafka-consumer-groups.sh --group realtime_etl --describe | awk '{sum+=$5} END {print sum}')
    if [ $LAG -gt $MAX_LAG ]; then
        send_alert "High consumer lag detected: $LAG"
    fi

    sleep $CHECK_INTERVAL
done
故障二:Flink状态后端溢出
时间:2023年7月22日
现象:Checkpoint持续失败,作业自动重启
根因:RocksDB状态增长超过本地SSD容量
解决:
实施状态TTL自动清理 引入分层状态存储(热数据SSD,冷数据HDD) 开发状态大小预测模型
// 状态TTL配置
StateTtlConfig ttlConfig = StateTtlConfig
    .newBuilder(Time.days(3))
    .setUpdateType(StateTtlConfig.UpdateType.OnCreateAndWrite)
    .setStateVisibility(StateTtlConfig.StateVisibility.NeverReturnExpired)
    .cleanupInBackground()
    .build();

ValueStateDescriptor<String> stateDescriptor =
    new ValueStateDescriptor<>("user_session", String.class);
stateDescriptor.enableTimeToLive(ttlConfig);
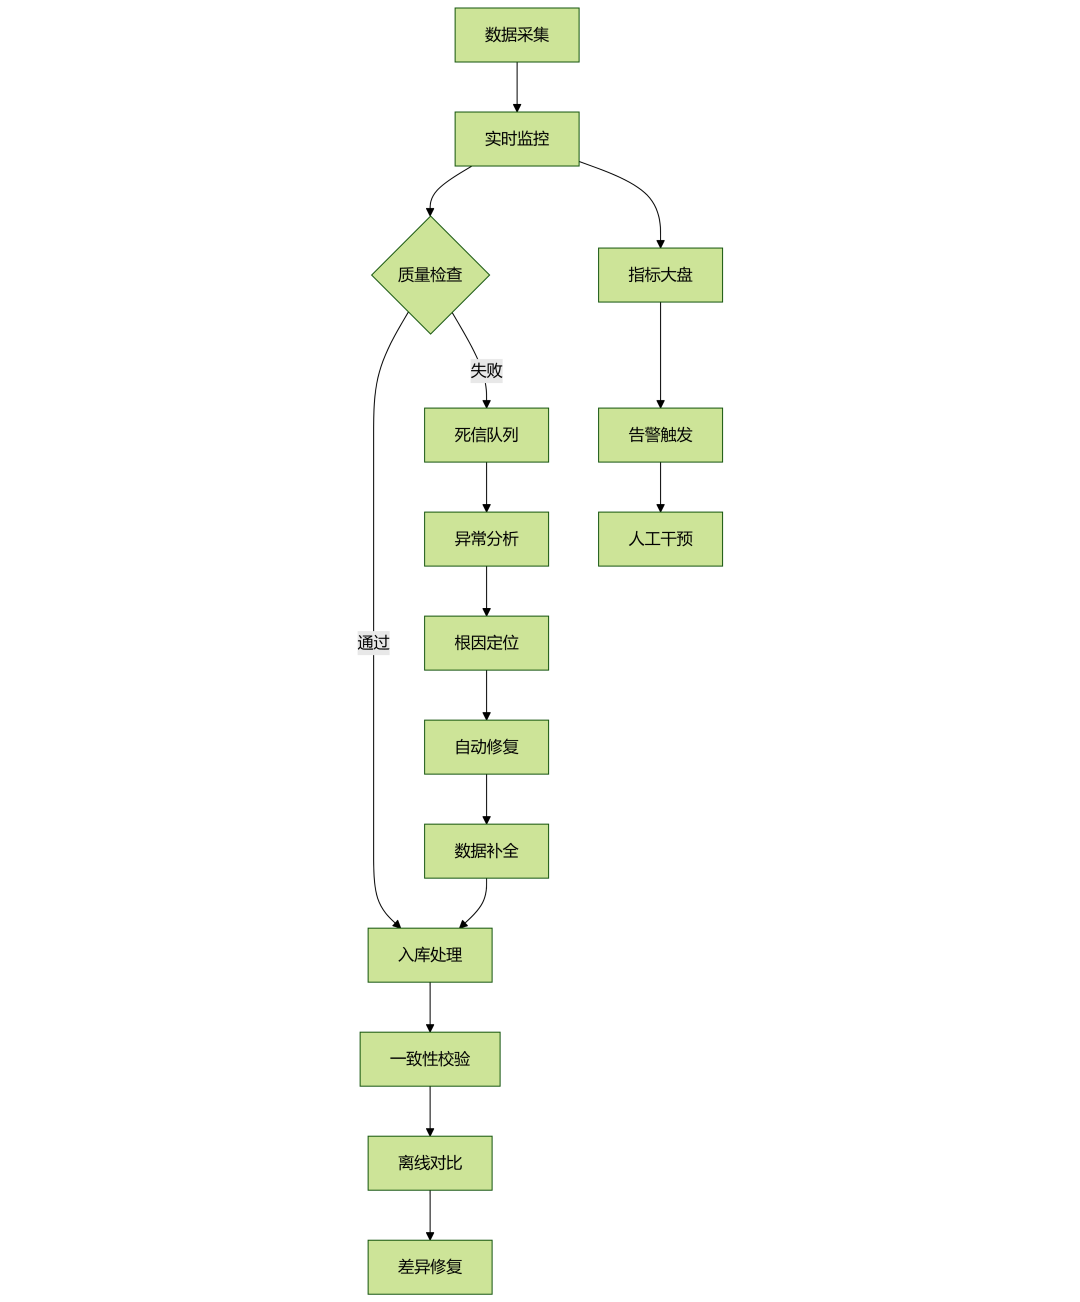
5.2 数据质量保障体系
六、成本优化实践
6.1 资源利用率提升
-- 冷热数据分离策略
-- 热数据(3天内):SSD,3副本
-- 温数据(30天内):SSD,2副本
-- 冷数据(90天内):HDD,2副本
-- 历史数据(90天+):对象存储,1副本

-- 自动降级脚本
CREATE POLICY cold_data_policy
ON dwd_user_events
TO S3
WHERE event_time < CURRENT_DATE - INTERVAL 90 DAY;
6.2 计算资源动态调整
# 基于预测的弹性伸缩
class PredictiveScaling:
    def predict_workload(self, historical_patterns, current_trend):
        # 使用时间序列预测未来负载
        model = ARIMA(historical_patterns, order=(1,1,1))
        model_fit = model.fit()
        forecast = model_fit.forecast(steps=12)  # 预测未来12小时

        # 结合节假日、活动等因素调整
        adjusted = self.apply_business_rules(forecast)

        return adjusted

    def calculate_optimal_resources(self, predicted_load):
        # 基于预测结果计算最优资源配置
        instances = max(10, predicted_load * 0.8 / 100000)
        memory_gb = instances * 8# 每实例8GB
        return {"instances": instances, "memory_gb": memory_gb}
七、未来演进方向
7.1 架构演进路线图
2024 Q2: ██████████ 湖仓一体架构落地
2024 Q4: ████████░░ 向量化计算引擎引入
2025 Q2: ██████░░░░ AI驱动的自动调优
2025 Q4: ████░░░░░░ 多云多活架构实现
7.2 关键技术预研
Flink批流一体化:统一计算框架,降低运维复杂度 Doris向量化执行引擎:提升复杂查询性能3-5倍 智能数据分层:基于访问模式的自动存储优化 Serverless化:更细粒度的资源计费和弹性
八、实施建议清单
8.1 对于中小规模团队
起步阶段:先聚焦核心链路,避免过度设计 技术选型:使用托管服务降低运维成本(如云厂商的Flink、Kafka服务) 监控先行:在业务上线前建立完善的监控体系 成本控制:设置预算告警,避免资源浪费
8.2 对于大规模团队
治理体系:建立数据标准、质量规范、SLA体系 平台建设:开发统一的数据开发平台、运维平台 多租户隔离:资源隔离、权限控制、配额管理 容灾演练:定期进行故障演练,确保系统韧性
8.3 通用最佳实践
✅ 优先考虑数据准确性,再优化性能
✅ 监控指标要业务可解释(如影响收入、用户体验)
✅ 文档与代码同步更新,特别是数据血缘和SLA
✅ 建立跨团队的数据质量共责机制
✅ 预留20%资源应对突发流量
总结
字节跳动的实时数仓架构经过多年演进,已形成以Flink+Kafka+Doris为核心的稳定体系。关键成功因素包括:分层架构设计、精细化的调优实践、完善的数据治理以及持续的成本优化。尽管面临海量数据和极致时效性的挑战,通过不断的技术迭代和经验积累,该架构已支撑起公司核心业务的实时数据分析需求。
架构没有银弹,最合适的方案往往来自对业务场景的深刻理解和对技术组件的熟练运用。
下方扫码进【数据与模型之美】知识星球即可领取数据仓库+数据中台+数据湖+数据治理体系+元数据管理+数据质量+主数据管理···等相关资料
PS:搜索关键词,如“数据中台”,即可下载全部资料文档,300+,日更!
广告人士勿入,切勿轻信私聊,防止被骗
点下方的“❤”支持我们,非常感谢!
