

 最近在 Milvus 社区里,我们帮一位用户处理了个比较棘手的问题。
1. 社区紧急求助:ETCD 损坏后,collection 消失了
cd /home/zilliz/mnt/lcl/260milvusdocker compose ps
NAME IMAGE SERVICE STATUSmilvus-etcd quay.io/coreos/etcd:v3.5.18 etcd Upmilvus-minio minio/minio:RELEASE.2024-12-18T13-15-44Z minio Upmilvus-standalone milvusdb/milvus:v2.6.17 standalone Up
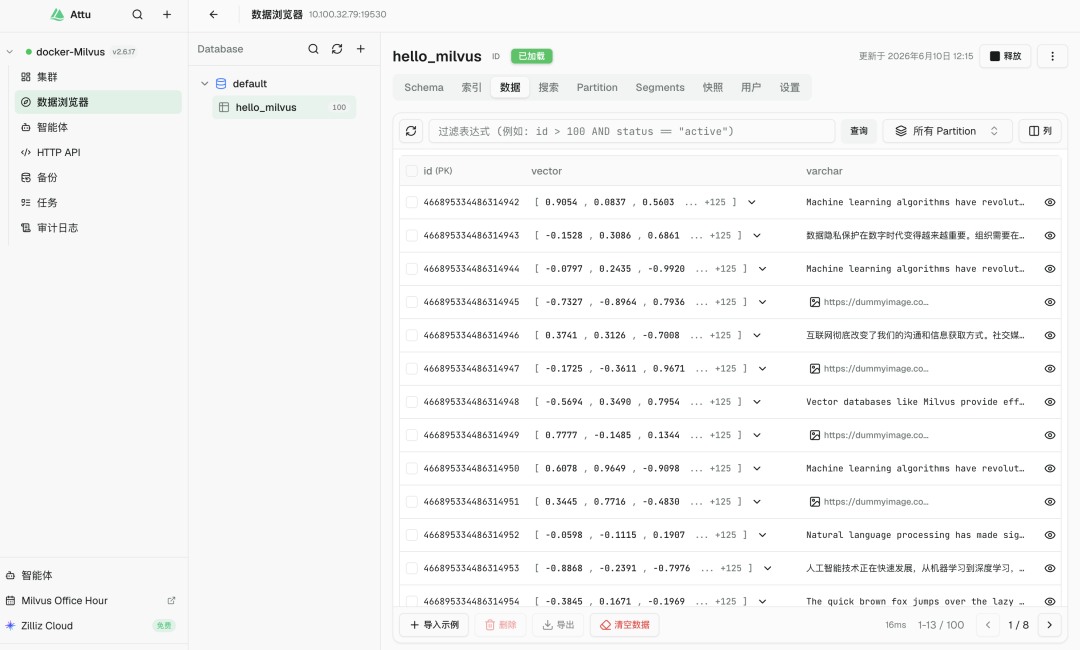
etcd/milvus/minio/
cd /home/zilliz/mnt/lcl/260milvus/volumesmv etcd ../etcd_old
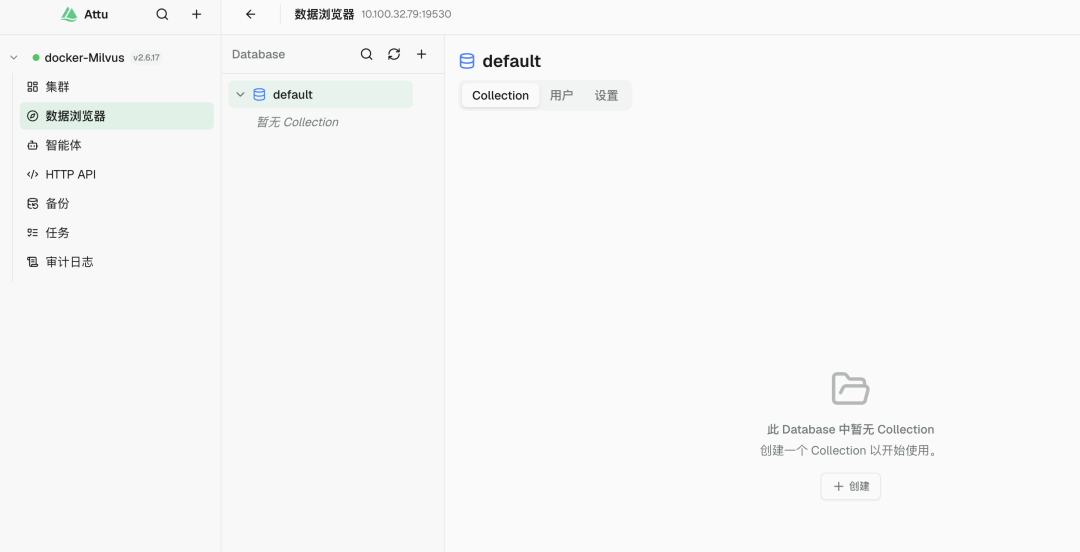
2. 为什么 MinIO 还在,Milvus 却不能自动恢复?
database 信息 collection 信息 partition 信息 schema segment id segment 状态 索引元数据 compaction 后的新旧 segment 关系
insert_log stats_log delta_log index 文件 WAL 相关文件
这个 collection id 对应哪个业务 collection? 这个 segment 是 live 还是 dropped? 这个 segment 是否已经被 compaction 替代? 这个 segment 是否来自旧实验或历史残留? field id 和业务字段的映射是否仍然可信?
3. 恢复思路:不修旧实例,而是新建 Milvus 再导入旧 binlog
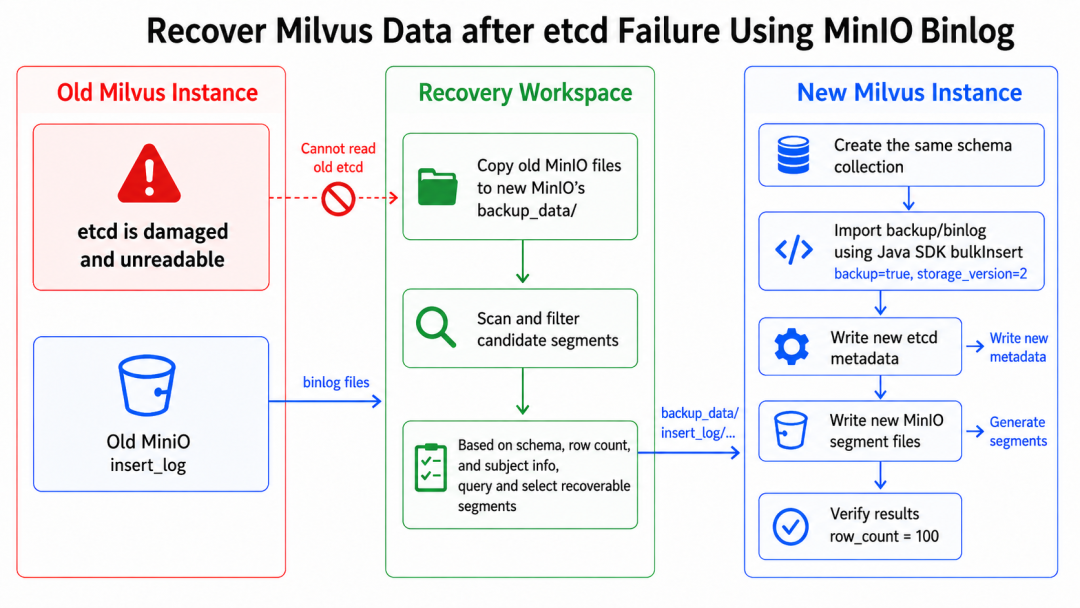
保留旧 MinIO 数据目录。 不读取旧 ETCD。 在新路径启动一套空的 Milvus Standalone。 根据已有信息创建相同 schema 的新 collection。 将旧 MinIO 中的 insert_log 和 stats_log 复制到新 MinIO 的 backup_data/ 前缀下。 扫描候选 segment。 使用 Java SDK bulkInsert 导入候选 segment。 校验 row count、主键范围、抽样数据和向量检索结果。 只把确认后的 segment 导入正式恢复 collection。
cd /home/zilliz/mnt/lcl/260milvus/newdocker compose up -d
[+] Running 3/3✔ Container milvus-etcd Started✔ Container milvus-minio Started✔ Container milvus-standalone Started
OLD_BUCKET=/home/zilliz/mnt/lcl/260milvus/volumes/minio/a-bucket/filesNEW_BUCKET=/home/zilliz/mnt/lcl/260milvus/new/volumes/minio/a-bucket/files
mkdir -p "$NEW_BUCKET/backup_data"rsync -a "$OLD_BUCKET/insert_log" "$NEW_BUCKET/backup_data/"rsync -a "$OLD_BUCKET/stats_log" "$NEW_BUCKET/backup_data/"
backup_data/insert_log///backup_data/stats_log///
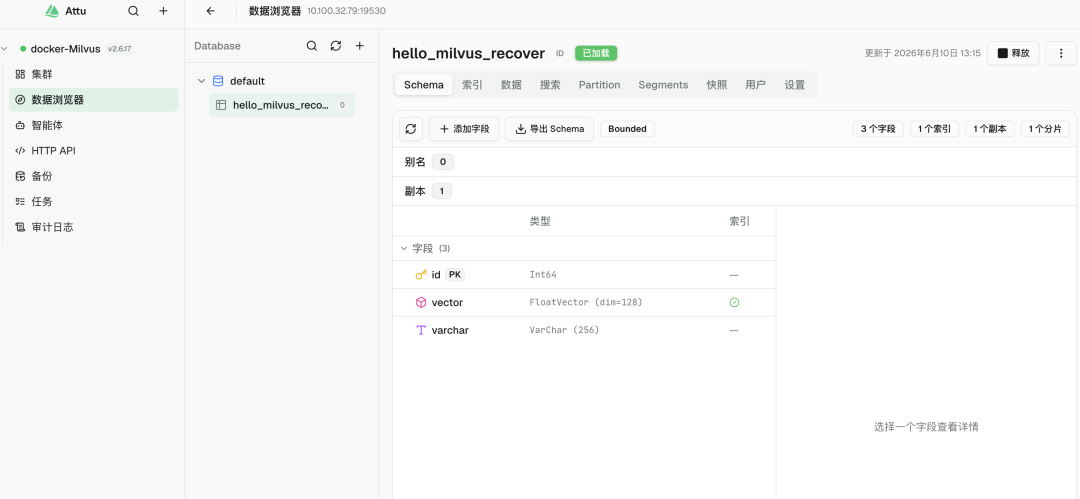
4. 创建相同 schema 的新 collection
{"collection_name": "hello_milvus","fields": [{"name": "id","data_type": 5,"is_primary_key": true,"autoID": true},{"name": "vector","data_type": 101,"dim": 128,"indexes": [{"index_name": "vector","index_type": "AUTOINDEX","metric_type": "COSINE"}]},{"name": "varchar","data_type": 21,"max_length": 256}],"enable_dynamic_field": false,"consistency_level": "Bounded","shards_num": 1}
from pymilvus import MilvusClient, DataTypeclient = MilvusClient(uri="http://localhost:19530", db_name="default")collection_name = "hello_milvus_recover"if client.has_collection(collection_name):client.drop_collection(collection_name)schema = MilvusClient.create_schema(auto_id=True,enable_dynamic_field=False,)schema.add_field("id", DataType.INT64, is_primary=True, auto_id=True)schema.add_field("vector", DataType.FLOAT_VECTOR, dim=128)schema.add_field("varchar", DataType.VARCHAR, max_length=256)index_params = MilvusClient.prepare_index_params()index_params.add_index(field_name="vector",index_type="AUTOINDEX",metric_type="COSINE",)client.create_collection(collection_name=collection_name,schema=schema,index_params=index_params,)
5. 扫描旧 MinIO 中的候选 segment
NEW_BUCKET=/home/zilliz/mnt/lcl/260milvus/new/volumes/minio/a-bucket/filesfind "$NEW_BUCKET/backup_data/insert_log" \-mindepth 3 -maxdepth 3 -type d \| sed "s#${NEW_BUCKET}/##" \| sort
backup_data/insert_log/466895334486314780/466895334486314781/466895334486514943backup_data/insert_log/466895334486314780/466895334486314781/466895334486515954
backup_data/insert_log///
old collection id: 466895334486314780old partition id: 466895334486314781candidate segment 1: 466895334486514943candidate segment 2: 466895334486515954
6. 使用 Java SDK bulkInsert 导入旧 segment
backup=truestorage_version=2 #2.6 以后的版本使用的 storage v2,之前的版本是 v1files=["backup_data/insert_log/.../<segment_id>"] #files 传的是 insert_log segment 路径
R<ImportResponse> importResp = client.bulkInsert(BulkInsertParam.newBuilder().withDatabaseName(dbName).withCollectionName(collectionName).withPartitionName("_default").withOption("backup", "true").withOption("storage_version", storageVersion).withFiles(Collections.singletonList(segmentPath)).build());
while (true) {R<GetImportStateResponse> stateResp = client.getBulkInsertState(GetBulkInsertStateParam.newBuilder().withTask(taskID).build());ImportState state = stateResp.getData().getState();System.out.println("Import state: " + state);if (state == ImportState.ImportCompleted) {break;}if (state == ImportState.ImportFailed ||state == ImportState.ImportFailedAndCleaned) {throw new RuntimeException("import failed: " + stateResp.getData());}Thread.sleep(1000);}
<dependency><groupId>io.milvus</groupId><artifactId>milvus-sdk-java</artifactId><version>3.0.1</version></dependency>
cat > /tmp/import_paths.txt <<'EOF'backup_data/insert_log/466895334486314780/466895334486314781/466895334486514943EOF
cd /home/zilliz/mnt/lcl/260milvus/etcd_recovery/restore-javaDB_NAME=default \COLLECTION_NAME="hello_milvus_recover" \IMPORT_PATHS_FILE=/tmp/import_paths.txt \STORAGE_VERSION=2 \mvn -q exec:java \-Dexec.mainClass=io.milvus.recovery.ImportIntoExistingCollection
Target collection: default.hello_milvus_recoverSegment paths: 1Importing segment: backup_data/insert_log/466895334486314780/466895334486314781/466895334486514943Import task ID: 466896649728034340Import state: ImportPendingImport state: ImportStartedImport state: ImportStartedImport state: ImportStartedImport state: ImportCompletedcollection statistics: [key: "row_count"value: "100"]
cat > /tmp/import_paths.txt <<'EOF'backup_data/insert_log/466895334486314780/466895334486314781/466895334486515954EOF
DB_NAME=default \COLLECTION_NAME="hello_milvus_recover" \IMPORT_PATHS_FILE=/tmp/import_paths.txt \STORAGE_VERSION=2 \mvn -q exec:java \-Dexec.mainClass=io.milvus.recovery.ImportIntoExistingCollection
Target collection: default.hello_milvus_recoverSegment paths: 1Importing segment: backup_data/insert_log/466895334486314780/466895334486314781/466895334486515954Import task ID: 466896649728083097Import state: ImportPendingImport state: ImportStartedImport state: ImportStartedImport state: ImportCompletedcollection statistics: [key: "row_count"value: "200"]
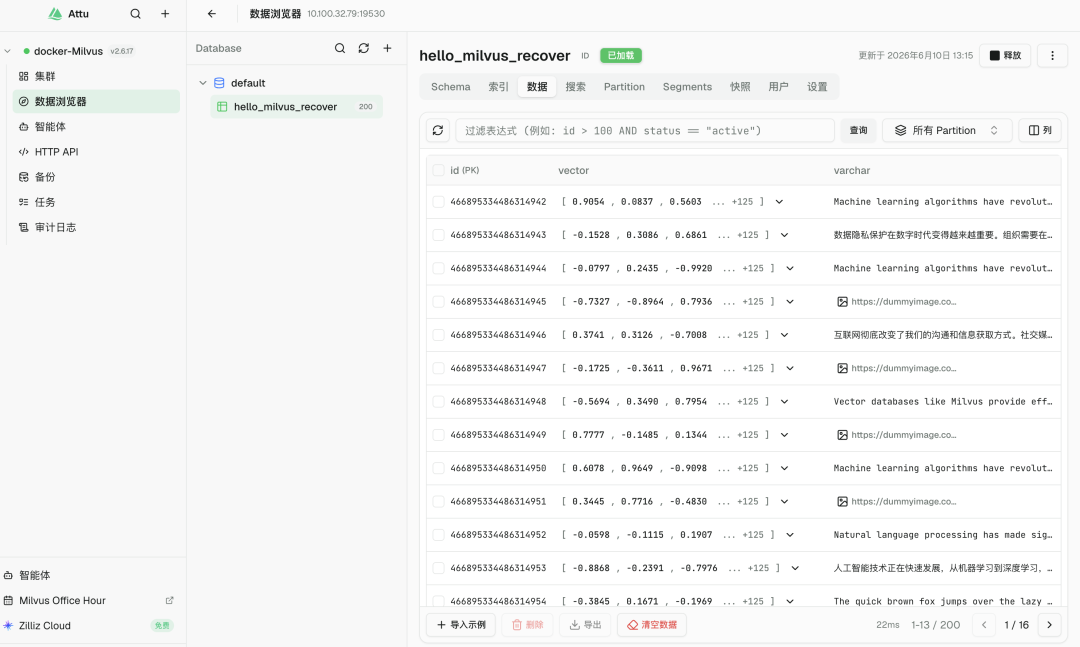
7. 第一次踩坑:可读 segment 不等于 live segment
for s in 466895334486514943 466895334486515954; doecho "SEGMENT=$s"find /home/zilliz/mnt/lcl/260milvus/volumes/minio/a-bucket/files/insert_log/466895334486314780/466895334486314781/$s \-type f -printf '%TY-%Tm-%Td %TH:%TM:%TS %s %p\n' | sortdone
SEGMENT=4668953344865149432026-06-10 12:15:36 1621 .../514943/0/.../part.12026-06-10 12:15:36 2960 .../514943/1/.../part.12026-06-10 12:15:36 47724 .../514943/101/.../part.1SEGMENT=4668953344865159542026-06-10 12:15:39 1621 .../515954/0/.../part.12026-06-10 12:15:39 2960 .../515954/1/.../part.12026-06-10 12:15:39 47724 .../515954/101/.../part.1
字段目录一致:0、1、101 文件大小一致:1621、2960、47724 写入时间只差约 3 秒
8. 如何校验:把候选 segment 分别导入不同 collection
hello_milvus_recover_candidate_1hello_milvus_recover_candidate_2
row count 是否一致 distinct primary key 数量是否一致 主键最小值和最大值是否一致 抽样字段是否一致 向量检索结果是否一致 是否存在重复主键 是否和业务侧记录一致
from pymilvus import MilvusClientclient = MilvusClient(uri="http://localhost:19530", db_name="default")for name in ["hello_milvus_recover", "hello_milvus_recover2"]:print(name, client.get_collection_stats(name))rows = client.query(collection_name=name,filter="id >= 0",output_fields=["id", "varchar"],limit=10000,)ids = [r["id"] for r in rows]print("query_rows", len(rows),"distinct_ids", len(set(ids)),"min", min(ids),"max", max(ids))
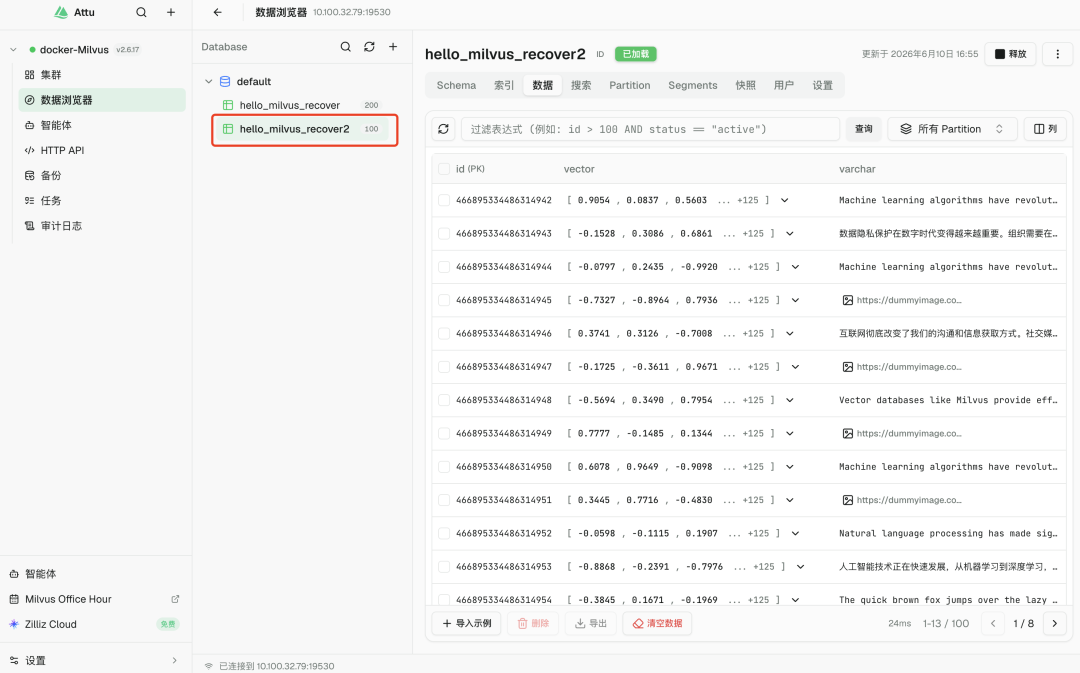
hello_milvus_recover {'row_count': 200}query_rows 100 distinct_ids 100 min 466895334486314942 max 466895334486315041hello_milvus_recover2 {'row_count': 100}query_rows 100 distinct_ids 100 min 466895334486314942 max 466895334486315041
9. 正确恢复:只导入确认后的 segment
backup_data/insert_log/466895334486314780/466895334486314781/466895334486515954
hello_milvus_recover2
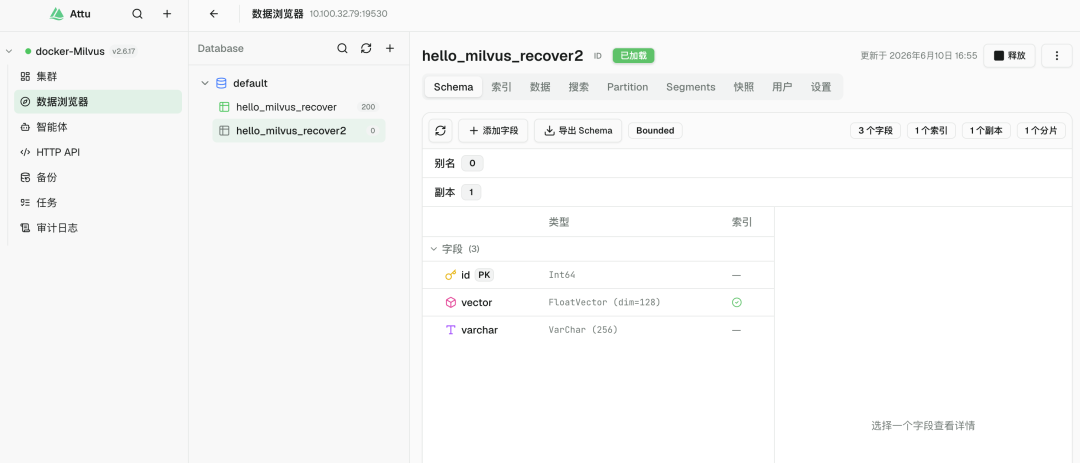
cat > /tmp/import_paths.txt <<'EOF'backup_data/insert_log/466895334486314780/466895334486314781/466895334486515954EOFcd /home/zilliz/mnt/lcl/260milvus/etcd_recovery/restore-javaDB_NAME=default \COLLECTION_NAME="hello_milvus_recover2" \IMPORT_PATHS_FILE=/tmp/import_paths.txt \STORAGE_VERSION=2 \mvn -q exec:java \-Dexec.mainClass=io.milvus.recovery.ImportIntoExistingCollection
Target collection: default.hello_milvus_recover2Segment paths: 1Importing segment: backup_data/insert_log/466895334486314780/466895334486314781/466895334486515954Import task ID: 466896649729193732Import state: ImportPendingImport state: ImportStartedImport state: ImportStartedImport state: ImportCompletedcollection statistics: [key: "row_count"value: "100"]
10. 这种方法有哪些局限?
11. 经验总结:备份永远比抢救便宜
volumes/├── etcd/├── milvus/└── minio/
作者介绍
李成龙
Zilliz 资深开源布道师
阅读推荐 如何通过修改Segment 形态,让你的 Milvus 性能原地翻倍 Agent时代,静态容量规划注定失败!聊聊 Zilliz Cloud 的AutoScale设计 官宣:Zilliz Vector Lakebase正式发布,作为向量数据库开创者,我们为何推出Vector Lakebase
文章转载自ZILLIZ,如果涉嫌侵权,请发送邮件至:contact@modb.pro进行举报,并提供相关证据,一经查实,墨天轮将立刻删除相关内容。