

装完 DM9 别急着建表:我把它的 387 个动态视图翻了一遍
四条只读 SQL,读出 DM9 的能力边界。 9 月 20 日 16:13,dminit 报出
create dm database success。我没有建业务表,先跑了四条只读查询——387 个动态视图、46 个并行与向量相关参数、1 张授权表,以及一条把执行码身份说清楚的ID_CODE。这篇文章不是安装教程,是我从这四条查询里读出来的技术判断。全文没有一个性能数字,因为压测还没跑;编数字这事我不干。
作者:马顺华(江湖人称"数据库界华少")| shunwah 星辰数智社
实验环境:
| 项目 | 实测值 |
|---|---|
| 操作系统 | CentOS Linux 7.9.2009(kernel 3.10.0-693.el7.x86_64) |
| CPU | 8 核 · Intel Xeon Gold 6126 @ 2.60GHz(VMware 虚机) |
| 内存 | 27G(available 22G),Swap 8G 全空 |
| 数据库 | DM9 单机集中式实例(DM9TEST / DMSERVER / 端口 5236) |
| 内核参数 | PAGE_SIZE=32768(32K) / EXTENT_SIZE=32 / CASE_SENSITIVE=Y / UTF-8 |
| 授权 | 试用授权,EXPIRED_DATE = 2027-04-17 |
| 构建版本 | DM Database Server 64 V9 · DB Version: 0x7000d · 03151060506-20260417-322930-20218 |
目录
- 为什么要翻数据字典
- 探针翻车现场:WAIT 里含 AI
- 第一条 SQL:387 个视图,数字本身不是重点
- 第一条的另一半:分布式随包给,多租户要解锁
- 第二条 SQL:向量能力,藏在两个参数名里
- 第二条的另一半:装完默认不开并行
- 第三条 SQL:一张授权表,写着能力的边界
- 第四条 SQL:版本号不是一个数,是一个坐标
- 快问快答
- 我的四条判断
- 使用须知(三条边界)
- 总结与下一步实验计划
一、为什么要翻数据字典
装库这事有个通病:装完立刻 CREATE TABLE,能跑通就收工。我干这行久了,越来越不信"能跑通"这三个字——能跑通只说明它的语法认了,不说明它的能力在。
数据库的数据字典,是它身上唯一不会说谎的地方。宣传材料会说"全面支持",参数表会说"已预留",而只有 v$ 开头的那些视图和 para_name 那些参数,是它运行时真实的自我描述。
我给自己定了个规矩:新库落地,先跑四条只读 SQL。
- 一条问它有多少视图 ——
select count(*) from v$dynamic_tables; - 一条问它有哪些参数 ——
select para_name, para_value from v$dm_ini where ...; - 一条问它给了我什么授权 ——
select * from v$license; - 一条问它是谁 ——
SELECT ... FROM (SELECT REGEXP_SUBSTR(ID_CODE,'[^-]+',1,1) AS VER));
四条查完,这台库能干什么、不能干什么、能不能用、是谁给的,心里就有谱了。而且这几条在任何库上都能跑,你现在就可以打开自己的库试一下。
这篇就按这四条的顺序走。跑完你会发现一件挺有意思的事:同一台库,四种问法,四个不一样的答案——而且每一个都对。
二、探针翻车现场:WAIT 里含 AI
我想知道"AI 能力在不在",于是我写了一句:
select name from v$dynamic_tables where name like '%AI%';
结果挺唬人,跳出来一串:
V$TRXWAIT
V$WAIT_CLASS
V$WAIT_HISTORY
V$SESSION_WAIT_HISTORY
我第一反应还挺高兴:你看,DM9 的 AI 能力果然有视图暴露出来。高兴了大概十秒钟。
然后我盯着 V$TRXWAIT 看了半天,反应过来——这是 WAIT 里含 AI。事务等待、等待事件分类、会话等待历史,全是锁和等待相关的东西,跟 AI 一个字的关系都没有。
这就是模糊匹配的经典翻车:你搜的不是"AI 能力",你搜的是"字符串里恰好有 A 和 I"。造这行的证据,先怀疑是不是巧合,再怀疑是不是自己筛错了。
我的解法很笨:不看关键词命中,看命名体系。 V$ 视图的命名是有规矩的——前缀决定领域,后缀决定粒度。关键词会骗你,命名体系不会。
三、第一条 SQL:387 个视图,数字本身不是重点
第一条问总数:
SQL> select count(*) as view_cnt from v$dynamic_tables;
真实输出:
行号       VIEW_CNT
---------- --------------------
1          387

已用时间: 3.267(毫秒). 执行号:68705.
SQL>
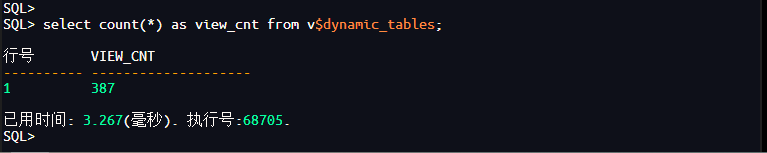
图 01 · select count(*) from v$dynamic_tables 输出
387 这个数大不大?不知道,我没跟任何一个版本对标过。 没有实测过的对比数字,我不写进文章里。
真正的重点在这 387 个视图的分布。我把名字里带 VEC / AI / TENANT / DPC / RAG 的全部拉出来,一共 51 行:
SQL> select name from v$dynamic_tables
  2   where name like '%VEC%' or name like '%AI%' or name like '%TENANT%'
  3      or name like '%DPC%' or name like '%RAG%';
真实输出(51 行,节选关键分组):
行号       NAME
---------- ------------------------------
1          V$TRXWAIT
2          V$WAIT_CLASS
3          V$WAIT_HISTORY
14         V$DPC_TENANT_INI_SUPPORT
16         V$DPC_ENET
17         V$DPC_ESITE
34         V$DPC_EDCT_RAFT
39         V$DPC_TS_MOVE
40         V$ASM_FAIL_AU
45         V$REPAIRED_PAGE
51         V$DPC_NSITE

51 rows got

已用时间: 4.421(毫秒). 执行号:68706.
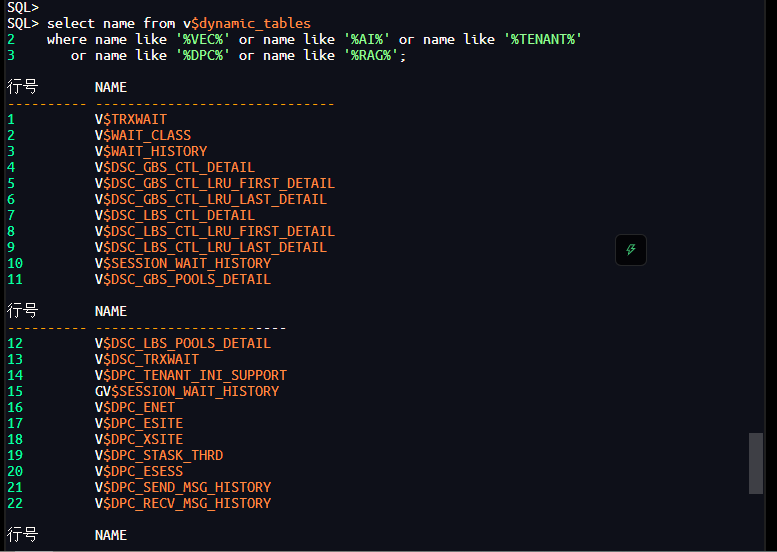
图 02 · 那 51 条命中,一半是假阳性
按前缀分下来,格局很清楚:
| 前缀 / 视图 | 数量 | 说明 |
|---|---|---|
V$DPC_* |
30+ | 分布式并行计算。ENET(网络)、ESITE / XSITE / NSITE(站点)、STASK_THRD(调度线程)、EDCT_RAFT(Raft 一致性)、TS_MOVE(表空间在线迁移)、EDCT_FAULT_DOMAIN(故障域)。整套都在。 |
V$DSC_* |
若干 | 集群共享存储相关(GBS_CTL、LBS_CTL 这些控制块与缓冲池明细) |
V$REPAIRED_PAGE / V$ASM_FAIL_AU |
2 | 坏页修复、AU(分配单元)故障。它在准备"你的盘会坏"这件事,而且是当成常态来准备的。 |
V$TRXWAIT / V$WAIT_CLASS / V$WAIT_HISTORY |
3 | 等待事件体系,DBA 的老朋友 |
我的判断就一句:
视图命名体系,是数据库愿意被运维的程度。
一个只有几十个 v$ 视图的库,不是说它不行,是你出了事只能靠猜。387 个视图意味着你能看见的东西多——能看见才能定位,能定位才谈得上自治。
四、第一条的另一半:分布式随包给,多租户要解锁
还是那 51 条命中。带 TENANT 的只有三个,而且全都带 DPC 前缀:
14         V$DPC_TENANT_INI_SUPPORT
47         V$DPC_EDCT_TENANT_USER
48         V$DPC_TENANT_PARA
图 03 · 30 多个 DPC 视图,3 个带 DPC 前缀的 TENANT(可与图 02 复用同一张截图,或框选放大)
三个,全都是 DPC 前缀。这个细节很关键。
如果多租户是"单机上切几个互相看不见的库",那视图名应该叫 V$TENANT_* 或者 V$CONTAINER_*,不该挂在 DPC(分布式并行计算)底下。挂在 DPC 底下,说明 DM9 里的租户是分布式形态下的租户——为了多租户共享一套集群资源而设计的隔离,不是让你在单机上假装同时运维十个库。
这两个诉求长得像,实际完全是两件事。想清楚你要哪种再评估,不然容易买椟还珠。
DPC 那 30 多个视图还告诉我另一件事:
分布式内核是随安装包一起装上的。
ENET、ESITE、STASK_THRD、EDCT_RAFT、TS_MOVE 全在,不需要你另装一个"分布式版本"。名字里那个 RAFT 也值得记一笔——一致性协议走的是 Raft,这至少说明它不是"共享存储伪分布式"那一路。
⚠️ 一句我必须说清楚的话:视图在,不等于能跑。 单机实例里这些视图是不是空的、分布式语法是不是直接报错,我还没验。这是我下一步第一件要做的事,做完了再下结论。今天我只能说到"随包安装"这一层。
五、第二条 SQL:向量能力,藏在两个参数名里
视图层我先查了:VEC 命中 0 个,RAG 命中 0 个。 按我上面那套标准,看着像"没做向量"。
如果我就此收手,结论会错得离谱。换个地方问——参数层:
SQL> select para_name, para_value from v$dm_ini
  2   where para_name like '%VEC%' or para_name like '%AI%'
  3      or para_name like '%TENANT%' or para_name like '%HTAP%'
  4      or para_name like '%PARALLEL%';
真实输出(46 行,节选与向量、并行相关的三行):
行号       PARA_NAME                          PARA_VALUE
---------- ---------------------------------- ----------
44         HNSW_SHARD_SEARCH_PARALLEL_DEGREE  1
45         PARALLEL_DML                       0
46         VECTOR_INDEX_BUILD_PARALLEL_DEGREE 4

46 rows got

已用时间: 12.582(毫秒). 执行号:68707.
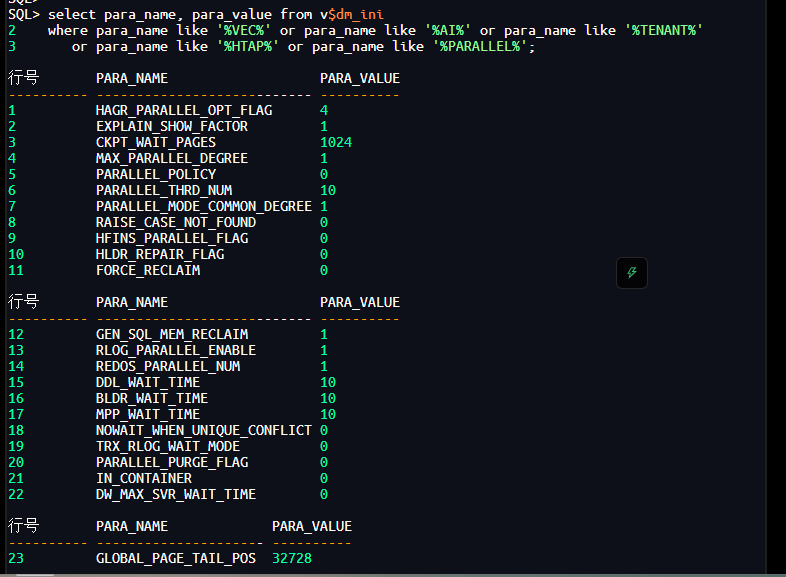
图 04 · 向量和并行能力的证据都在这一屏里
关键不是值,是名字。HNSW 出现在参数名里。
HNSW 是一种近似最近邻的图索引算法(Hierarchical Navigable Small World)。它出现在数据库内核参数里,说明向量索引是在内核里实现的一套索引结构——不是一个外挂组件、一张专门表、一个插件。
“装在口袋里"和"长在骨头里”,差别不在今天,在明天。
装在口袋里的东西,优化器不认识它、执行计划看不见它、事务和权限不管它;长在骨头里的东西,才能真正参与查询优化。
顺便解释为什么视图层查不到:因为它是索引,不是特性。 索引是引擎内部的事,没有理由给你一个 V$VECTOR 视图。视图不露脸,恰恰是它埋得深的证据。
打个比方:装修里有个概念叫"预留专线"。你家电表箱里有没有给空调留的那路线,从电表箱外面是看不出来的——墙上没插座,不代表线没走。等你真要装空调,一个是从电表箱里接线,一个是从客厅砸墙。
六、第二条的另一半:装完默认不开并行
还是那 46 行参数。其中四行让我盯着屏幕坐了一会儿:
行号       PARA_NAME                   PARA_VALUE
---------- --------------------------- ----------
4          MAX_PARALLEL_DEGREE         1
5          PARALLEL_POLICY             0
6          PARALLEL_THRD_NUM           10
7          PARALLEL_MODE_COMMON_DEGREE 1
...
45         PARALLEL_DML                0
图 05 · POLICY=0 / DEGREE=1 / DML=0,8 核在跑单线程(可与图 04 复用同一张截图,框选放大那几行)
翻译一下:并行策略关闭、最大并行度 1、并行 DML 关闭,但它给你准备了 10 个并行线程。
这意味着我这台 8 核的机器,装完之后所有查询都是单线程跑的。8 个核闲着 7 个——不是它不能并行,是它默认不并行。
我第一反应是"太保守了"。但坐下来想了想,改了主意:
对小型 OLTP 来说,默认关闭并行是对的。
一条走索引的十毫秒点查,你要是给它拿去并行调度,调度开销比省下来的时间还多。数据库默认值要照顾的是"大多数人的大多数查询",不是我的压测场景。
所以我不打算把它写成"达梦有个坑",我写成**“达梦很克制”**。
但克制有个前提:你得知道开关在哪。 默认关闭并行这件事,如果没人把它标注成"上车第一件事",新手就会带着"这库怎么这么慢"的印象用下去,然后得出一个完全错误的结论。
这一篇我不展开它——这个开关到底值多少,我另开一篇实测,把执行计划、加速比,连同代价一起摆出来。这里的任务只是:把它指出来,告诉你它是默认关的。
这里还藏着一个容易混淆的点:DM 的并行参数分两套。一套给 SQL 执行用(PARALLEL_POLICY / MAX_PARALLEL_DEGREE),一套给内部任务用(DPRTSK_PARALLEL_NUM = 32、RLOG_PARALLEL_NUM = 16、REDOS_PARALLEL_NUM = 1)。内部并行度开着,不代表你的查询会并行——这两套别混着看。
七、第三条 SQL:一张授权表,写着能力的边界
第三条 SQL 是问它给了我什么授权。这张表信息密度极高:
SQL> select * from v$license;
真实输出:
行号       LIC_VERSION SERIES_NO SERVER_SERIES SERVER_TYPE SERVER_VER EXPIRED_DATE
---------- ----------- --------- ------------- ----------- ---------- ------------
           AUTHORIZED_CUSTOMER AUTHORIZED_USER_NUMBER CONCURRENCY_USER_NUMBER MAX_CPU_NUM
           ------------------- ---------------------- ----------------------- -----------
           NOACTIVE_DEADLINE HARDWARE_ID CHECK_CODE PRODUCT_TYPE PROJECT_NAME CPU_TYPE
           ----------------- ----------- ---------- ------------ ------------ --------
           OS_TYPE MAX_CORE_NUM HARDWARE_TYPE CLUSTER_TYPE DATE_GEN   SERVER_SERIES_NAME
           ------- ------------ ------------- ------------ ---------- ------------------
1          3.00        dm66n367  D             3           X.X.x.x    2027-04-17
           DEVELOP USER        1                      NULL
           NULL                                     DM V9                     Others
           Others 1111                1900-01-01

已用时间: 2.303(毫秒). 执行号:68708.
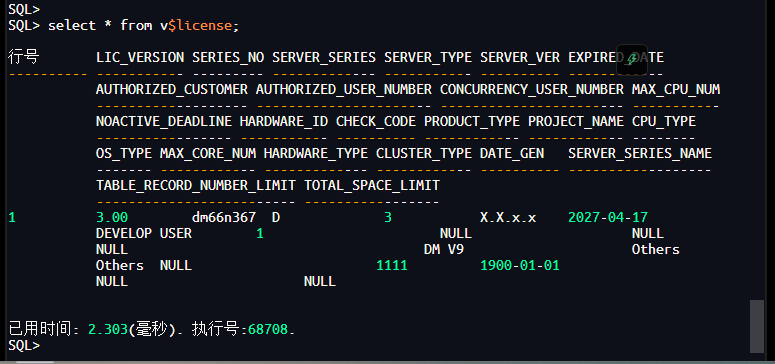
图 06 · 那一行 CLUSTER_TYPE = NULL,值不少钱
我从这一行里读出来三件事:
1|身份 EXPIRED_DATE = 2027-04-17、PRODUCT_TYPE = DM V9、AUTHORIZED_CUSTOMER = DEVELOP USER。试用授权身份坐实,有效期到明年 4 月。
2|边界 AUTHORIZED_USER_NUMBER = 1、CLUSTER_TYPE = NULL。一个授权用户,集群类型空。这解释了为什么 DPC 视图在、租户视图在,但你可能用不了。
3|硬件 HARDWARE_TYPE = Others、CPU_TYPE = Others。试用授权不识别你的硬件类型。
第 2 条是这轮探针里最有价值的一条:
不是版本阉割,是授权形态。
这两者的区别很大:版本阉割你只能换版本,授权形态你可以谈。
很多人评估一个库,看的是"它有没有这个功能";而实际决定你能不能用的,往往是授权文件里那一行 CLUSTER_TYPE。所以——"功能存在"和"能力可用"之间,隔着一张纸。这张纸就是授权。
顺带把字符集也确认了,和安装时 CHARSET=1 对得上:
SQL> select sf_get_unicode_flag() as unicode_flag;
行号       UNICODE_FLAG
---------- ------------
1          1

已用时间: 2.058(毫秒). 执行号:68709.
八、第四条 SQL:版本号不是一个数,是一个坐标
第四条最容易被跳过,也最有意思。先说个前提——上一篇里我写过一句:真正的版本号,要等连库后查 v$version 才拿得到。这话我说得太满。 连库之后我老老实实查了一遍:
SQL> select * from v$version;
真实输出:
行号       BANNER
---------- ---------------------------------
1          DM Database Server 64 V9
2          DB Version: 0x7000d
3          03151060506-20260417-322930-20218
4          Msg Version: 3
5          Gsu level(5) cnt: 102

已用时间: 0.447(毫秒). 执行号:69002.
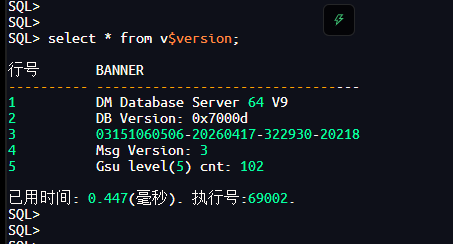
图 07 · 第 3 行就是 ID_CODE,它只是不告诉你
五行。它给了我大版本 DM9、内核编码 0x7000d,然后——第 3 行那串数字:03151060506-20260417-322930-20218。
这不是随机码,它就是 ID_CODE。v$version 其实把它交出来了,只是它不告诉你"这就是版本号"。
真正把版本号解出来的,是把它拿去过一遍。DM 内置了 ID_CODE,一条 SQL 就能拆开:
SQL> SELECT
  2    ID_CODE ,
  3    BUILD_TYPE ,
  4     TO_NUMBER(SUBSTR(VER,1,2),'XX')||'.'||
  5     TO_NUMBER(SUBSTR(VER,3,2),'XX')||'.'||
  6     TO_NUMBER(SUBSTR(VER,5,2),'XX')||'.'||
  7     TO_NUMBER(SUBSTR(VER,7,2),'XX') AS INNER_VISION
  8   FROM (SELECT
  9                 DECODE(SUBSTR(VER,1,2),'03','企业版','05','安全版','02','标准版','其他') AS BUILD_TYPE,
 10                       RAWTOHEX(CAST(SUBSTR(VER,3) AS INT)) AS VER
 11            FROM (SELECT REGEXP_SUBSTR(ID_CODE,'[^-]+',1,1) AS VER));
真实输出:
行号       ID_CODE                             BUILD_TYPE INNER_VISION
---------- ----------------------------------- ---------- ------------
1          --03151060506-20260417-322930-20218 企业版     9.1.0.26

已用时间: 5.247(毫秒). 执行号:69003.
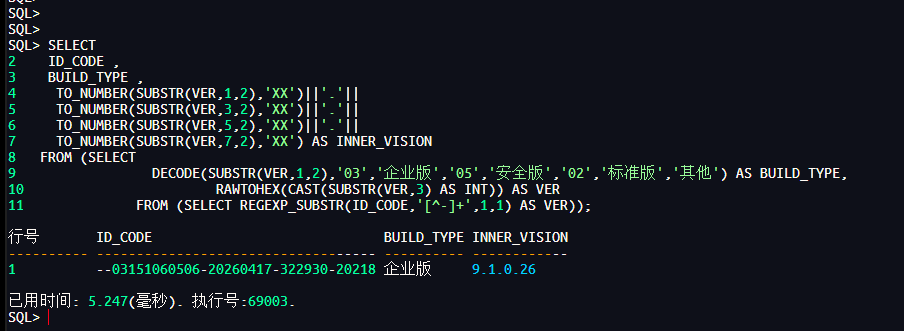
图 08 · 一行输出把"我是谁"说完了
一行出结果:企业版 · 9.1.0.26 · 构建于 2026-04-17。串里还压着两个通常没人提的字段:SVN 代码号 322930、分支号 20218。
那四个数字不是玄学,是十六进制:
'03151060506' → 取第 3 位起 '151060506'
              → 十进制转十六进制 '0901001A'
              → 09 / 01 / 00 / 1A → 9 . 1 . 0 . 26
末字节 1A 是十六进制,等于 26。这一步不用信我,自己拿计算器按两下就行;也可以让数据库替你按:
select rawtohex(cast(substr('03151060506',3) as int)); -- 得到 0901001A
把三把尺子摆在一起,事情就清楚了:
| 你问谁 | 它答什么 | 本次实测 |
|---|---|---|
v$version |
内核是哪一代 | DM9 · DB Version 0x7000d |
ID_CODE 解码 |
执行码是哪个构建 | 企业版 · 9.1.0.26 |
v$license |
这张纸允许你用多久 | 试用 · 到 2027-04-17 |
版本号不是一个数,是一个坐标。
所以"企业版"和"试用版"不打架:前者说的是这套执行码,后者说的是那张授权。同一套企业版的安装包,换一张授权文件,就是另一种身份。这也把上一节那句"不是版本阉割,是授权形态"补全了 —— 你手里不是阉割包,是原装包加一把临时钥匙。
一个坑:ID_CODE 串前面有两个横杠(--)。谁要是用硬切前两位的办法去拿构建类型,会正正切到横杠上,判断落进兜底分支显示成"其他",然后得出结论:试用版连版本号都是空的。取"第一个非横杠片段"([^-]+)那一步,就是为了跳过它。
所以开头那条"装完先跑三条只读 SQL",现在得改成四条:视图、参数、授权,再加一条 ID_CODE。 前三条看它有什么,第四条看它是谁。
九、快问快答
Q:DM9 有向量能力吗?
A:参数名里有 HNSW,视图里没有 VEC。我的判断是有,而且在内核里。但索引能不能建、检索时权限怎么走,我还没跑,不吹。
Q:387 个视图算多吗?
A:不知道,我没跟别的版本对齐过。我只知道它把"盘会坏""页会坏"都做成了视图。
Q:为什么不直接建表压测?
A:因为我想先知道它有什么,再决定压什么。顺序错了,压出来的数字也没意义。
Q:装完最该改的一个参数是什么?
A:看你场景。小 OLTP 别动并行,大 AP 第一件事就是把并行开起来。
Q:多租户能用在单机上吗?
A:视图命名告诉我这是分布式形态的能力,我下一步就验它,不猜。
Q:这篇为什么一个性能数字都没有?
A:因为我一个都没跑。编一个数字换来的阅读量,还不起。
十、我的四条判断
| 编号 | 判断 | 依据 |
|---|---|---|
| J01 | 功能存在 ≠ 能力可用。中间隔着一张授权文件。 | CLUSTER_TYPE = NULL + AUTHORIZED_USER_NUMBER = 1 |
| J02 | 向量能力别问它有没有视图,问它有没有参数。视图是给人看的,参数是给内核用的。 | HNSW_SHARD_SEARCH_PARALLEL_DEGREE 出现在 v$dm_ini 里 |
| J03 | 数据库的默认值是一种产品态度。默认关并行不是懒,是知道大部分人不该开。 | PARALLEL_POLICY = 0 / MAX_PARALLEL_DEGREE = 1 |
| J04 | 评估一个新库,先跑四条只读 SQL:视图、参数、授权,再加一条 ID_CODE。比看十页宣传材料有用。 |
本文全部内容 |
十一、使用须知(三条边界)
① 这篇没验分布式。 DPC 视图在,是否可用我没测。单机上的结论不能外推到集群。
② 这条授权只能一个人用(AUTHORIZED_USER_NUMBER = 1)。拿它测并发,你测的是试用授权的限制,不是 DM9 的能力。
③ 全文没有一个性能数字。 不是不想给,是还没跑——跑完会另开一篇。
这三条不是缺点,是前提。
总结与下一步实验计划
- 装完新库,先跑四条 SQL:视图、参数、授权、ID_CODE。
- 关键词命中不是证据,命名体系才是。
- 视图里查不到的,去参数里找。
接下来我要跑四组实验,数字难看也照发:
| # | 实验 | 为什么这组值钱 |
|---|---|---|
| 一 | 单机实例里那 30 多个 DPC 视图到底是不是空的,租户语法能不能过 |
把"随包安装"推进到"能不能用",给第四章的结论收口 |
| 二 | 同一条聚合,默认串行 vs 会话级开并行(不重启、不改全局)的对比 + 执行计划 | 验证 PARALLEL_POLICY 的真实影响面 |
| 三 | 行存 vs 列存跑同一份聚合;大查询跑着的时候交易侧点查抖多少 | 公开材料里最少有人测的就是"TP/AP 互相拖死"这一组 |
| 四 | 向量检索里,关系过滤和向量排序谁先谁后;低权限用户会不会捞到越权结果 | 这一格决定向量能不能上生产 |
数据好,我写;数据不好,我也写。先把现场看清楚,再下结论——这个习惯,不管面对的是 DM9 还是我天天在查的那把锁,都一样。
本文为「达梦同行者」DM9 技术征文投稿。所有终端输出均为 worker3 实机真实记录,未做删改;文中不含任何未实测的性能数字。