

#达梦数据库 #达梦同行者征文
摘要
手上有一份以前整理的《达梦 8 故障分析方法》,分 SQL 类故障、实例故障、人为操作三块,写了每种现象查哪个视图、看哪份日志、怎么止损。新项目要上 DM9,我拿这份手册到测试机上逐条跑了一遍,看哪些能照用。
大部分能照用。要改的有两处,都和 DDL 等待有关:DDL 等 DML 的时候,V$TRXWAIT 里查得到;DDL_WAIT_TIME 设的是 10 秒,ALTER 实际卡了 44 到 51 秒才报错。翻系统日志时还碰上测试机 9 月 21 日的一次 halt 和 core dump,实例故障那一章就拿它对照。
测试环境是 Oracle Linux 8.10,数据库版本串 DM Database Server 64 V9 03151060506-20260417-322930-20218,单实例。实验对象都建在 LOCK_LAB 模式下,跑完就删。闪回开关只在内存里临时打开,做完改回 0。
一、SQL 类故障
1. 用 V$SQL_HISTORY 找语句
结果集不对也好,执行慢也好,第一步都是拿到确切的语句。DM9 默认 ENABLE_MONITOR=1,V$SQL_HISTORY 直接能查。我在一个会话里执行了一条带标记的查询,在管理会话里按文本检索:
SELECT SQL_ID, SESS_ID, TRX_ID, START_TIME, TIME_USED, TOP_SQL_TEXT
FROM V$SQL_HISTORY
WHERE TOP_SQL_TEXT LIKE '%FAULT_0924_Q1%'
  AND TOP_SQL_TEXT NOT LIKE '%V$SQL_HISTORY%';
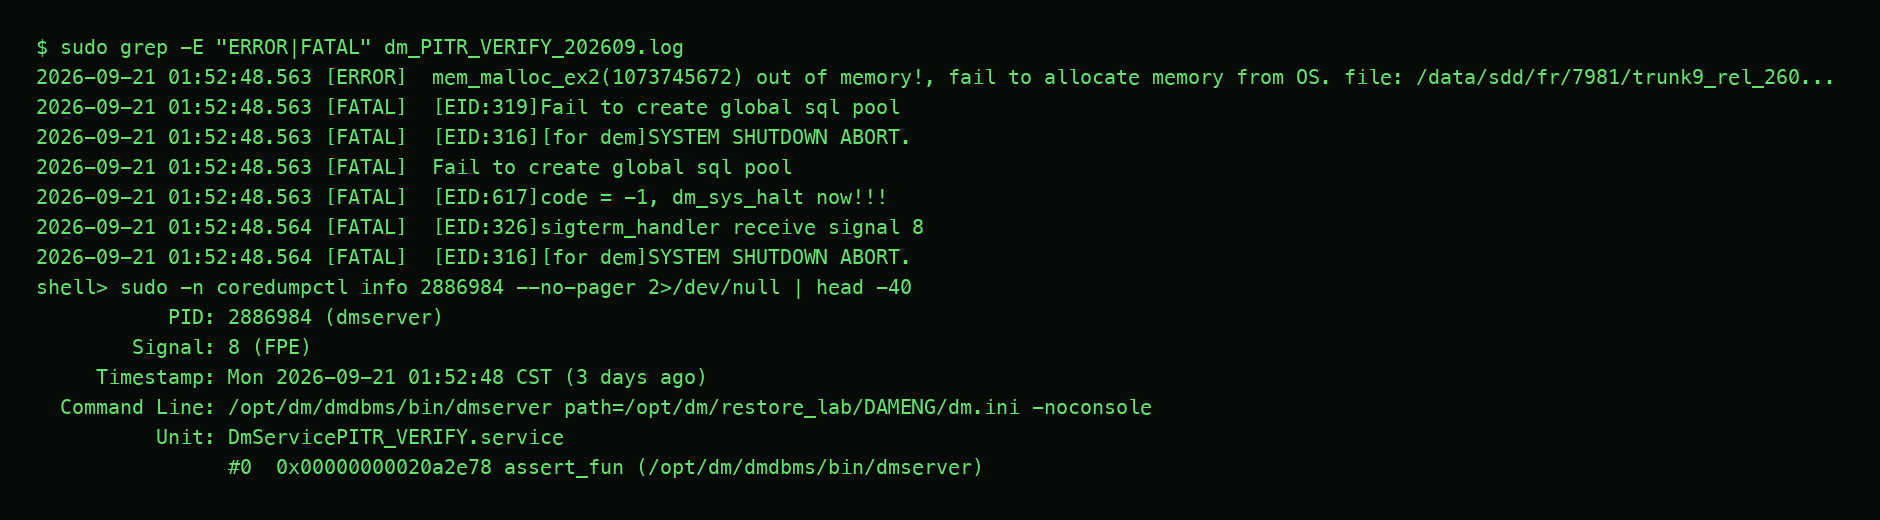
图 1 三轮实验的同一条语句,SQL_ID 都是 350
这条语句我前后跑了三轮,查出来三行。SQL_ID 都是 350,SESS_ID 和 TRX_ID 各不相同,同样的文本归在同一个 SQL_ID 下,执行次数可以按它统计。三轮之间表删过又重建,历史记录还在。现场拿 SESS_ID 和 START_TIME 去对应用日志,能对上哪一次请求。
复现的时候,语句文本、绑定参数、数据库参数都要和生产一致,手册里这句话我原样保留。拿一条差不多的语句去看执行计划,看到的可能是另一个问题。
2. 语句不返回,先看它在跑还是在等
手册的做法分两步:先在 VTRXWAIT 里查。
我让会话 A 更新 ID=1,不提交,也不再发任何语句。会话 B 接着更新同一行,被挡住。管理会话里依次执行:
-- 1. 找到正在执行的那条语句
SELECT SESS_ID, TRX_ID, STATE,
       DBMS_LOB.SUBSTR(SF_GET_SESSION_SQL(SESS_ID)) AS CUR_SQL
FROM V$SESSIONS
WHERE STATE = 'ACTIVE'
  AND DBMS_LOB.SUBSTR(SF_GET_SESSION_SQL(SESS_ID)) LIKE '%AMOUNT+2%';

-- 2. 看它有没有在等
SELECT ID AS WAIT_TRX, WAIT_FOR_ID, WAIT_TIME FROM V$TRXWAIT;

-- 3. 顺着 WAIT_FOR_ID 找阻塞源头
SELECT SESS_ID, TRX_ID, STATE, CLNT_IP, LAST_RECV_TIME, SQL_TEXT
FROM V$SESSIONS
WHERE TRX_ID IN (SELECT WAIT_FOR_ID FROM V$TRXWAIT);
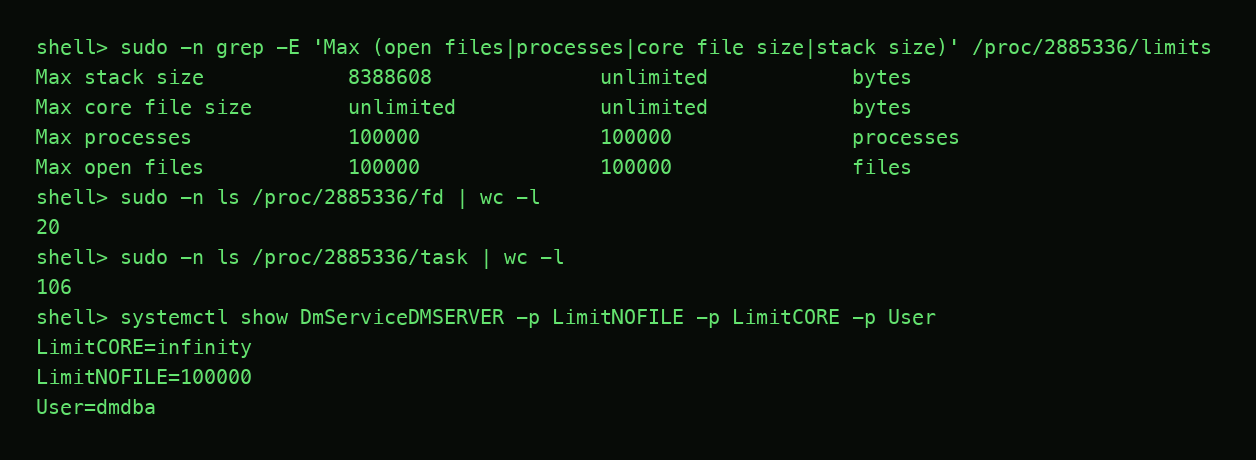
图 2 B(事务 26763)在等 A(事务 26762),A 的状态是 IDLE
B 的事务 26763 在等 26762,已经等了 3277 毫秒。26762 那个会话是 IDLE,SQL_TEXT 还停在没提交的那条 UPDATE 上,LAST_RECV_TIME 之后没有新请求。客户端改完数据忘了提交,后面的事务全排在它后面,就是这个样子。A 回滚后 B 马上返回,UPDATE 总耗时 3.958 秒。
第 2 步要是查不到记录,语句又一直 ACTIVE,那就是语句本身慢,去看执行计划。
3. DDL 等待:和手册不一样的两处
手册写的是:DDL 相关的等待在 VLOCK WHERE BLOCKED=1;DDL_WAIT_TIME 默认 10 秒,超时报锁超时。我让 A 更新一行不提交,B 对同一张表执行 ALTER TABLE … ADD`。
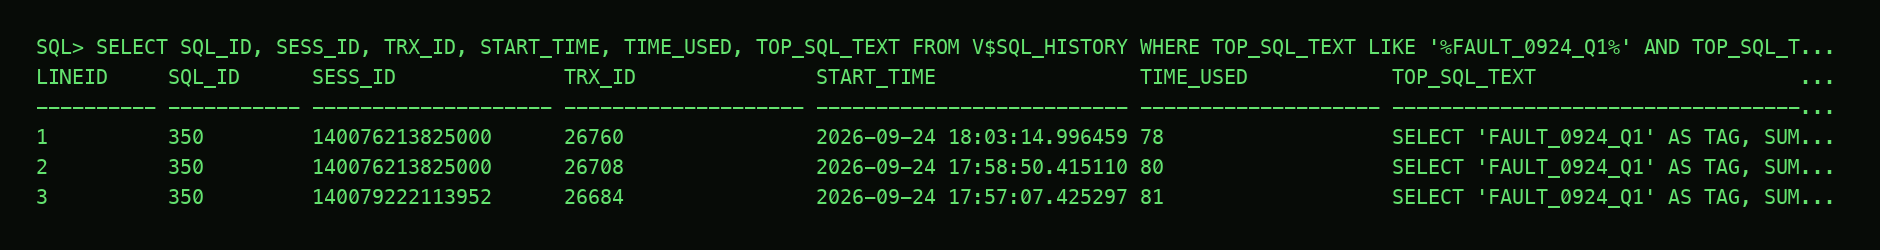
图 3 V$LOCK 中 BLOCKED=1 的表锁请求,以及复测时每 5 秒采样一次的 V$TRXWAIT
VTRXWAIT 里也有一行,就是 DDL 事务在等 DML 事务。手册写的是另一头:DDL 已经在执行,别的查询在等字典对象。这种我这次没复现出来。手册里我改成两个视图都查,空着的那个不能当成没有阻塞。
超时时间差得更多。disql 最后报 [-6407]:Lock timeout.,used time 12.466 秒,看着和参数对得上。可我在客户端从发出 ALTER 开始计时,三次实验分别是 44.0、48.8、50.8 秒。
我单独复测了一次,每 5 秒采一次 V$TRXWAIT。等待方的事务号先后是 26741、26744、26746、26748,每个在 WAIT_TIME 快到 10 秒时消失,换一个新事务号从头等。这条 DDL 在服务端至少执行了四次,每次等满 DDL_WAIT_TIME,disql 显示的只是最后一次的耗时。是服务端的重试机制,还是跟客户端有关,我没找到官方说明,这里只记录看到的现象。
生产上高峰期给表加字段,碰上一个没提交的事务,按参数估是 10 秒,实际可能 40 多秒,变更窗口和应用端超时都得按这个算。做变更之前,先查目标表上有没有 IDLE、却还持着锁的事务。
二、实例故障
1. 一次真实的 halt:内存没申请到
这一章我原本只打算照着手册核对命令,翻系统日志时查到了这么一条:
grep -iE 'dmserver|oom-kill|segfault' /var/log/messages
# ... systemd-coredump: Process 2886984 (dmserver) of user 1012 dumped core.
进程是 9 月 21 日做时间点恢复验证时拉起的 PITR_VERIFY 实例。按 PID 去数据库日志里找 ERROR 和 FATAL:
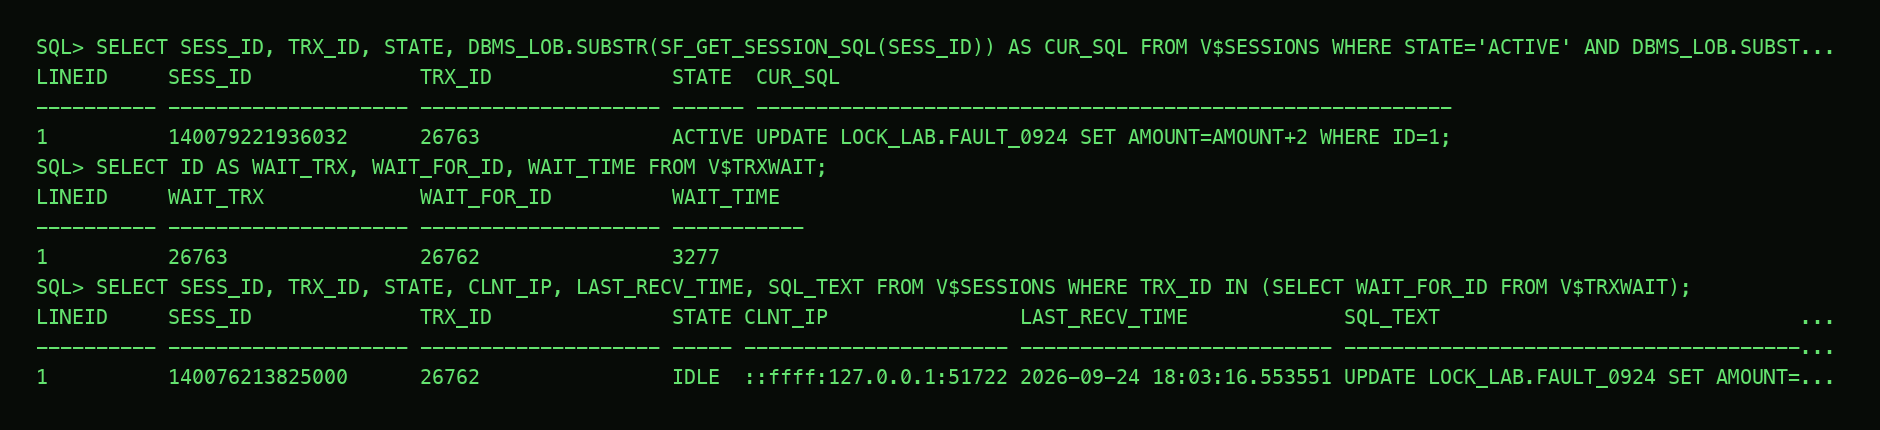
图 4 申请全局 SQL 缓冲池失败,触发 dm_sys_halt,随后收到信号 8 并生成 core
这几行打在同一毫秒里。mem_malloc_ex2(1073745672) out of memory,启动时向操作系统要约 1 GB,没要到。接着 Fail to create global sql pool,全局 SQL 缓冲池没建成。然后 dm_sys_halt now!!!,实例主动 halt。再下一行 sigterm_handler receive signal 8。coredumpctl info 里 Signal 是 8 (FPE),栈顶是 assert_fun。
手册里说有一种段错误是 halt 时主动做除 0 引发的,这次对上了。服务脚本在系统日志里留的是一句 Floating point exception(core dumped),只看这一行,很容易当成数据库 BUG 往上报。往数据库日志前面翻几行,才知道是内存没申请到。
再往下查。验证实例的 dm.ini 里 CACHE_POOL_SIZE=1024,和那次约 1 GB 的申请对得上。机器有 23 GB 内存,但 vm.overcommit_memory=2,严格模式下能申请多少看 CommitLimit,不看 free 里还剩多少。当时主实例、验证实例加上其他服务一共提交了多少内存,已经查不回来了。45 秒后同一个实例又启动成功。DM 启动时会回写 dm.ini,文件修改时间正好是第二次启动那一秒,两次启动之间参数改没改过,我也确认不了。能确定的只有直接原因:那 1 GB 没申请到。在严格 overcommit 的机器上同时拉多个实例,每个实例的内存池参数都要算进 CommitLimit。
看到 dmserver 出了 core,我的顺序是先在数据库日志里搜 halt,看它前面几行写了什么;搜不到 halt,再去系统日志里找 segfault、page fault、OOM、tainted。
2. 进程资源限制看 /proc
连接异常那部分,手册重点提了 Open files。DM 每个会话一个线程,句柄不够,线程就建不出来。limits 在进程启动时就定了,要看运行中进程的实际值,当前 shell 里的 ulimit 说明不了问题:
P=$(pgrep -u dmdba -f "^/opt/dm/dmdbms/bin/dmserver path=")
grep -E 'Max (open files|processes|core file size)' /proc/$P/limits
ls /proc/$P/fd | wc -l
systemctl show DmServiceDMSERVER -p LimitNOFILE -p LimitCORE
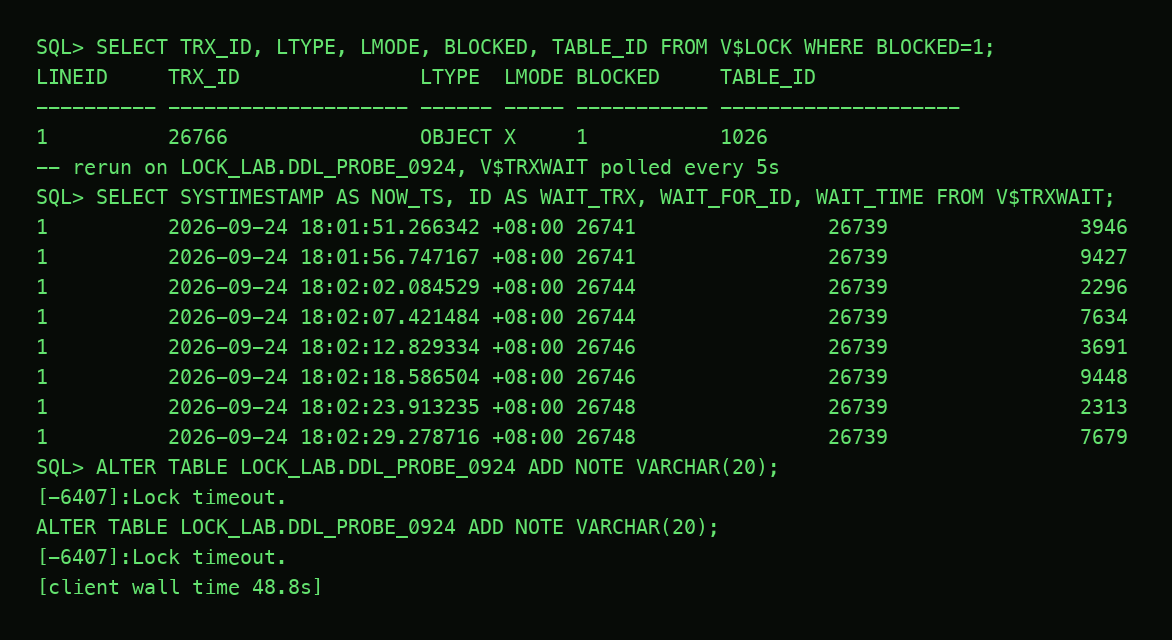
图 5 dmserver 实际生效的 limits 与 systemd 服务配置一致
取 PID 这步我踩了个坑。一开始写的是 pgrep -f "dmserver path=...",通过 ssh 执行时,把 ssh 拉起的那条 bash 命令也匹配上了,拿到两个 PID。后来加了 -u dmdba,再用 ^ 锚定可执行文件的完整路径。
测试机的实例由 systemd 管理,LimitNOFILE=100000,LimitCORE=infinity,和 /proc 里一致。要是用 dmdba 用户手工在前台起的实例,limits 继承的是登录会话的配置,两边就可能对不上。MAX_SESSIONS 在 V$DM_INI 里是 IN FILE 类型,改完要重启才生效,得提前规划,等连不上了再改就要停机。
三、人为操作
1. 误插入:按 TRXID 找同一批数据
DM 每一行都有 TRXID 伪列,记的是插入这一行的事务号。批量误插入一般是同一个事务写进来的。我先模拟误插入 3 行,再正常插 1 行:
SELECT TRXID, COUNT(*) AS N, MIN(ID) AS MIN_ID, MAX(ID) AS MAX_ID
FROM LOCK_LAB.FAULT_0924 GROUP BY TRXID ORDER BY TRXID;
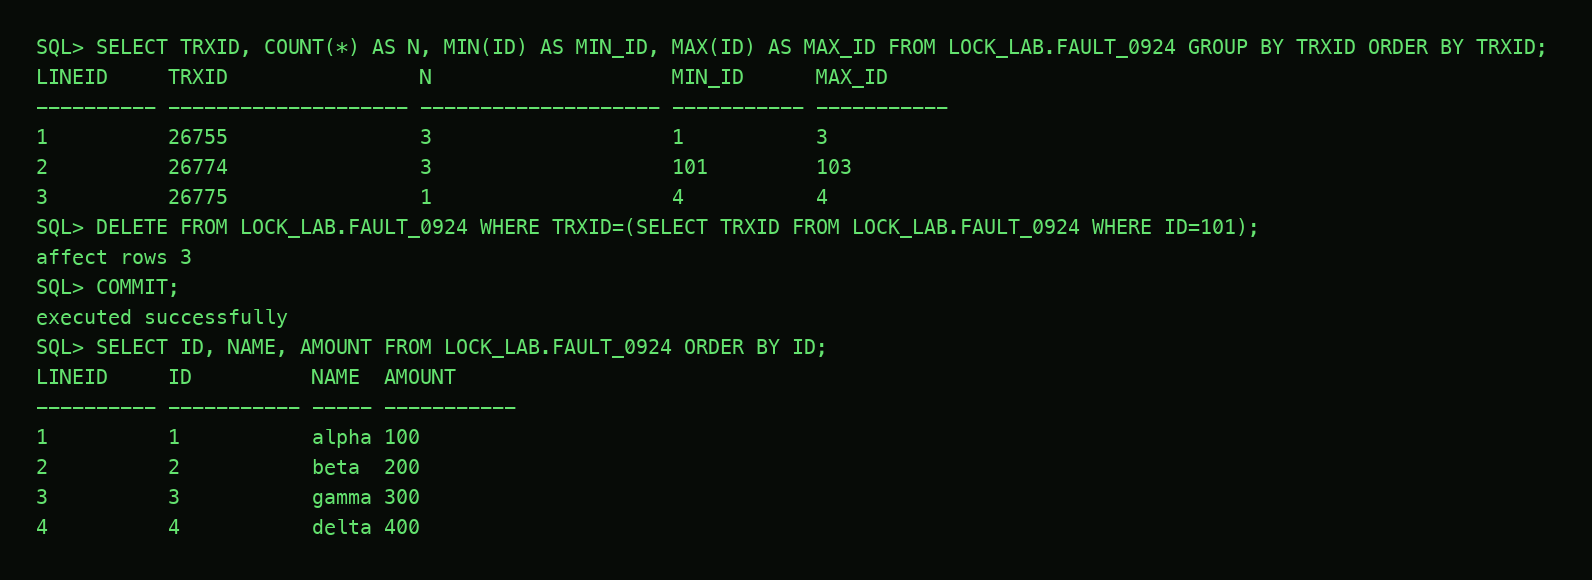
图 6 误插入的 101~103 属于同一个事务 26774,按事务号清理后恢复原状
初始化的 3 行是事务 26755,误插入的 101~103 是 26774,后插的 ID=4 是 26775。按 26774 删掉,表里剩下的都是对的。
生产上这么删之前,先把要删的数据导出来留底,核对条数和业务键。还要确认这个事务里没夹着正确的数据,有些应用会把多笔业务攒成一个大事务提交。
2. 误删除已提交:闪回查询
测试机默认 ENABLE_FLASHBACK=0,它在 V$DM_INI 里是 SYS 类型,可以在线改。我用 SP_SET_PARA_VALUE(1, ...) 只改内存,第一个参数 1 表示不写 dm.ini。打开后记下时间点,删两行并提交:
SP_SET_PARA_VALUE(1, 'ENABLE_FLASHBACK', 1);
SELECT SYSTIMESTAMP;                      -- 记下删除前的时间点
DELETE FROM LOCK_LAB.FAULT_0924 WHERE ID IN (2,3);
COMMIT;

SELECT * FROM LOCK_LAB.FAULT_0924
  AS OF TIMESTAMP '2026-09-24 18:04:22.628973' ORDER BY ID;

INSERT INTO LOCK_LAB.FAULT_0924
SELECT * FROM LOCK_LAB.FAULT_0924
  AS OF TIMESTAMP '2026-09-24 18:04:22.628973' WHERE ID IN (2,3);
COMMIT;
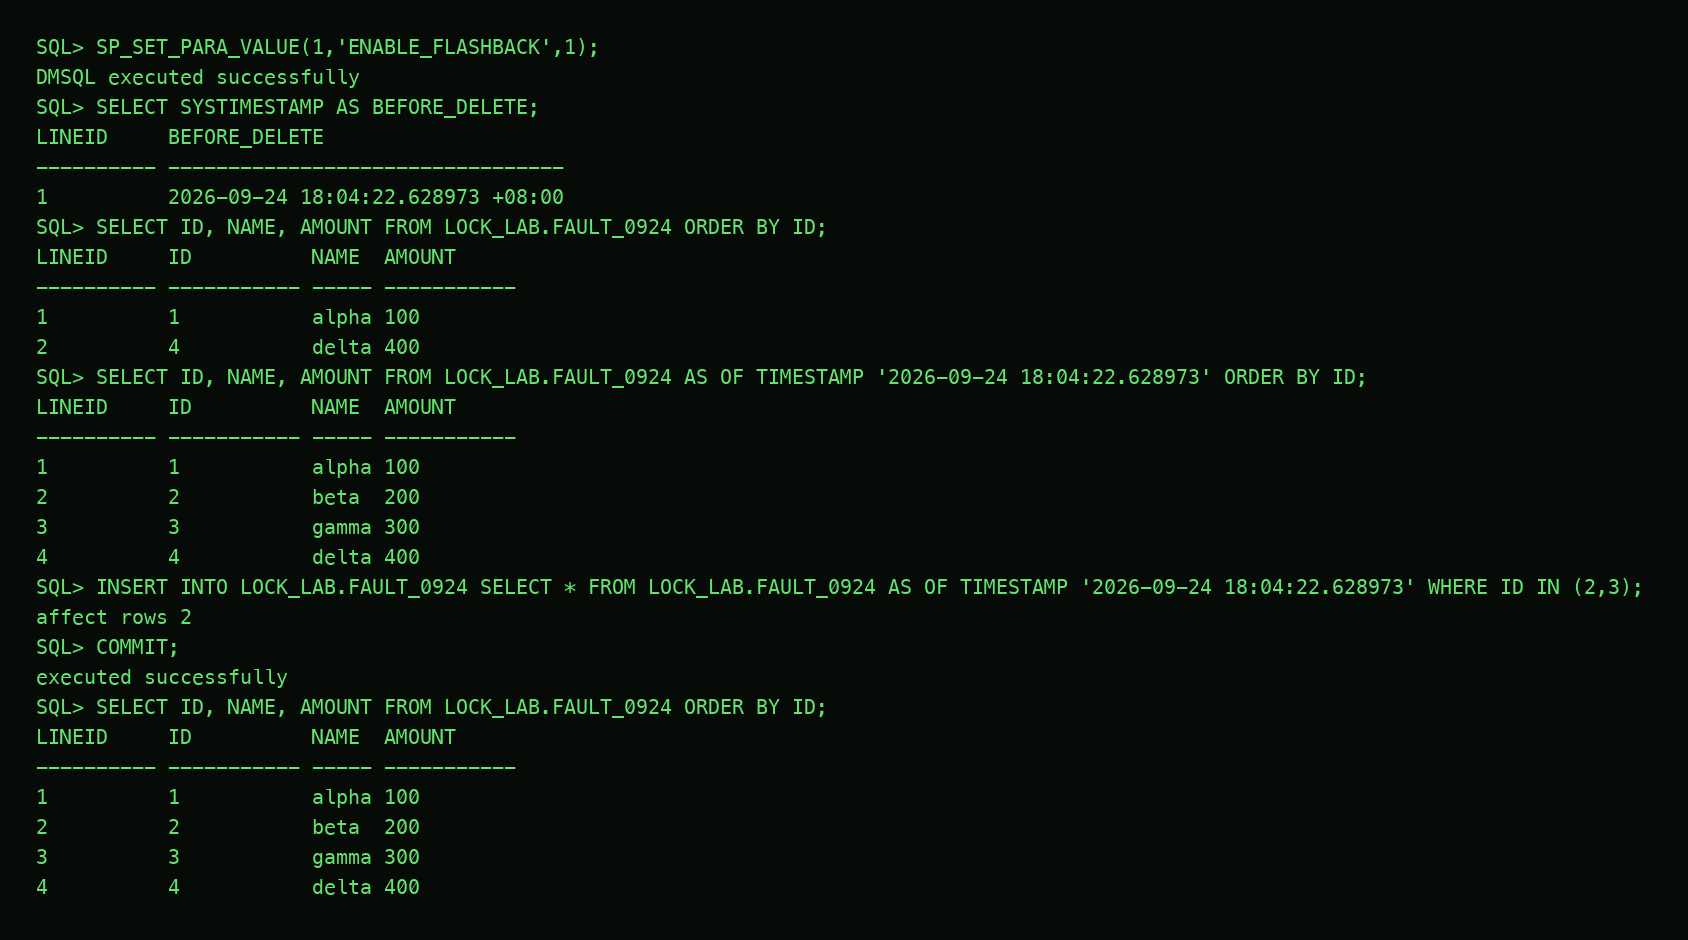
图 7 当前数据只剩 2 行,闪回到删除前能看到 4 行,回填后恢复
这次的顺序是先开开关、再删数据。按达梦文档,闪回查询靠的是开启之后记下的闪回信息。误删之后才去开,别指望能救回来,这条我没有单独测。这台机器 UNDO_RETENTION 是 90 秒,超过保留时间的旧版本随时会被清掉。闪回常开还是不开、UNDO 留多久,上线前连磁盘一起定。
实验做完,ENABLE_FLASHBACK 已经改回 0。
3. 运行中数据文件被删:从 /proc 拷回来
手册里提到,Linux 下文件删了,只要进程还开着句柄,就能从 /proc 里拷出来。我建了一个 128 MB 的表空间 FAULT_TS_0924,写 1000 行,做一次检查点,然后直接 rm 掉数据文件:
rm -f /opt/dm/data/DAMENG/FAULT_TS_0924.DBF
ls -l /proc/$P/fd | grep FAULT_TS        # 看到 (deleted)
cp /proc/$P/fd/23 /opt/dm/data/DAMENG/FAULT_TS_0924.DBF
chown dmdba:dinstall /opt/dm/data/DAMENG/FAULT_TS_0924.DBF
md5sum /proc/$P/fd/23 /opt/dm/data/DAMENG/FAULT_TS_0924.DBF
ALTER TABLESPACE FAULT_TS_0924 OFFLINE;
ALTER TABLESPACE FAULT_TS_0924 ONLINE;
SELECT COUNT(*) FROM LOCK_LAB.FAULT_TS_T;
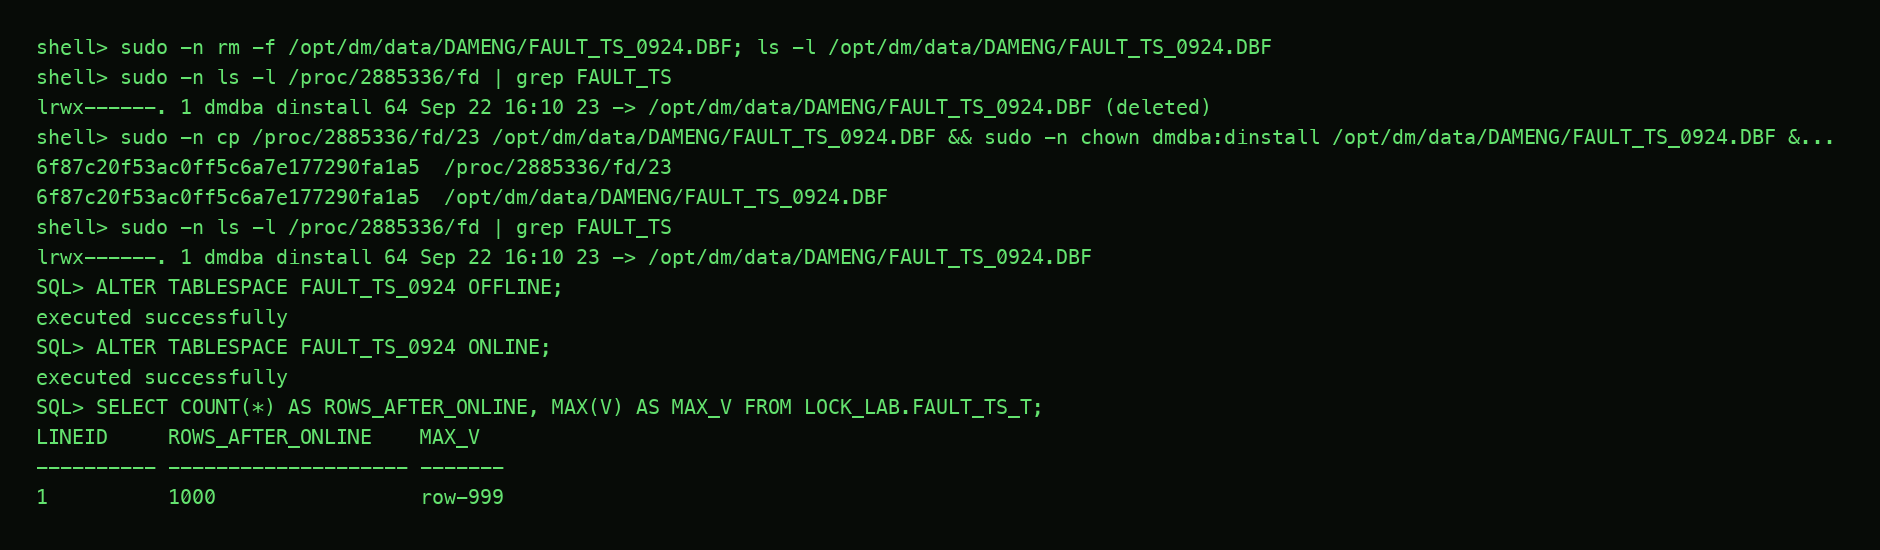
图 8 句柄显示 (deleted),拷回后 md5 一致,表空间脱机再联机后数据完整
文件删了,表照样能查,1000 行都在,dmserver 手里还握着那个 inode。拷回来两边 md5 一致。表空间 OFFLINE 再 ONLINE 一次,实例关掉旧句柄,重新打开路径上的新文件,/proc 里的 (deleted) 没了,查出来还是 1000 行。
这招有两个前提。一是拷之前先停写、做检查点,拷完以后再写到旧 inode 上的内容都会丢。二是拷完之前不能重启实例,也不能 OFFLINE 表空间,句柄一关,inode 就真释放了,/proc 里再也找不到。
SYSTEM、ROLL 这类系统文件,或者写得很频繁的业务表空间,这招只能用来争取时间,最后还是要靠备份加归档做时间点恢复。
总结
照旧手册估 DDL 的影响时间,会少算四到五倍。参数是 10 秒,客户端实际等了 44 到 51 秒。版本升级以后,手册里带具体数字的地方,我会先在测试机上跑一遍再用。
语句先定位,再分清是在跑还是在等。实例先翻数据库日志里的 halt。误操作先走能回滚、能核对的路。这三条这次都对得上。
参考:达梦官方文档《管理事务》《一致性和并发性》《闪回查询》。