

数据库管理470期 2026-09-25
胖头鱼的技术专栏-470 那条跑了半年的 SQL,怎么说慢就慢了(20260925)
作者:胖头鱼的鱼缸(尹海文)
Oracle ACE Pro: Database
PostgreSQL ACE

10年+数据库行业经验
拥有OCM 11g/12c/19c、MySQL 8.0 OCP、Exadata、CDP等认证
墨天轮MVP,ITPUB认证专家
圈内拥有“总监”称号,非著名社恐(社交恐怖分子)

全网同名:胖头鱼的鱼缸
ITPUB:yhw1809
除授权转载并标明出处外,均为“非法”抄袭
一条跑了半年都好好的 SQL,代码没动、索引没删、数据量也没爆——突然有一天慢了十倍。
摊上这种事,很多 DBA 第一反应多半是查锁、查 IO、查执行计划是不是变了。如果是计划确实变了,可它凭什么变?
原因大概率是优化器手里那张"地图",是上个月的。
最近翻金仓 KES V9 新版说明书(V009R002C016),在性能那一节扫到这么一句:
新增对表的增、删、改操作支持设置触发阈值,当相应操作达到阈值时,系统自动触发统计信息的即时更新功能,保证业务在高并发、大数据量读写场景下,优化器能够依据最新统计信息生成高效的执行计划。
两行字,很容易一扫而过。我盯着看了半天——这行字背后,是数据库跟"统计信息滞后"这件事较劲的另一种解法。
一、优化器其实一直在"猜"
众所周知,优化器不执行 SQL,它只是估算——估算走索引能筛掉多少行、走全表扫描要读多少页、两个表谁当驱动表更划算,然后挑一个它认为最便宜的方案。
估算的依据是什么?统计信息。
表有多少行、某一列有多少个不同值、最常见的值是哪几个、数据分布偏不偏——这些不是每次执行时现算的(那代价谁也付不起),而是提前采样存好,放在系统表里等着被查。
问题就出在这儿:它是提前存好的,那就一定会过期。
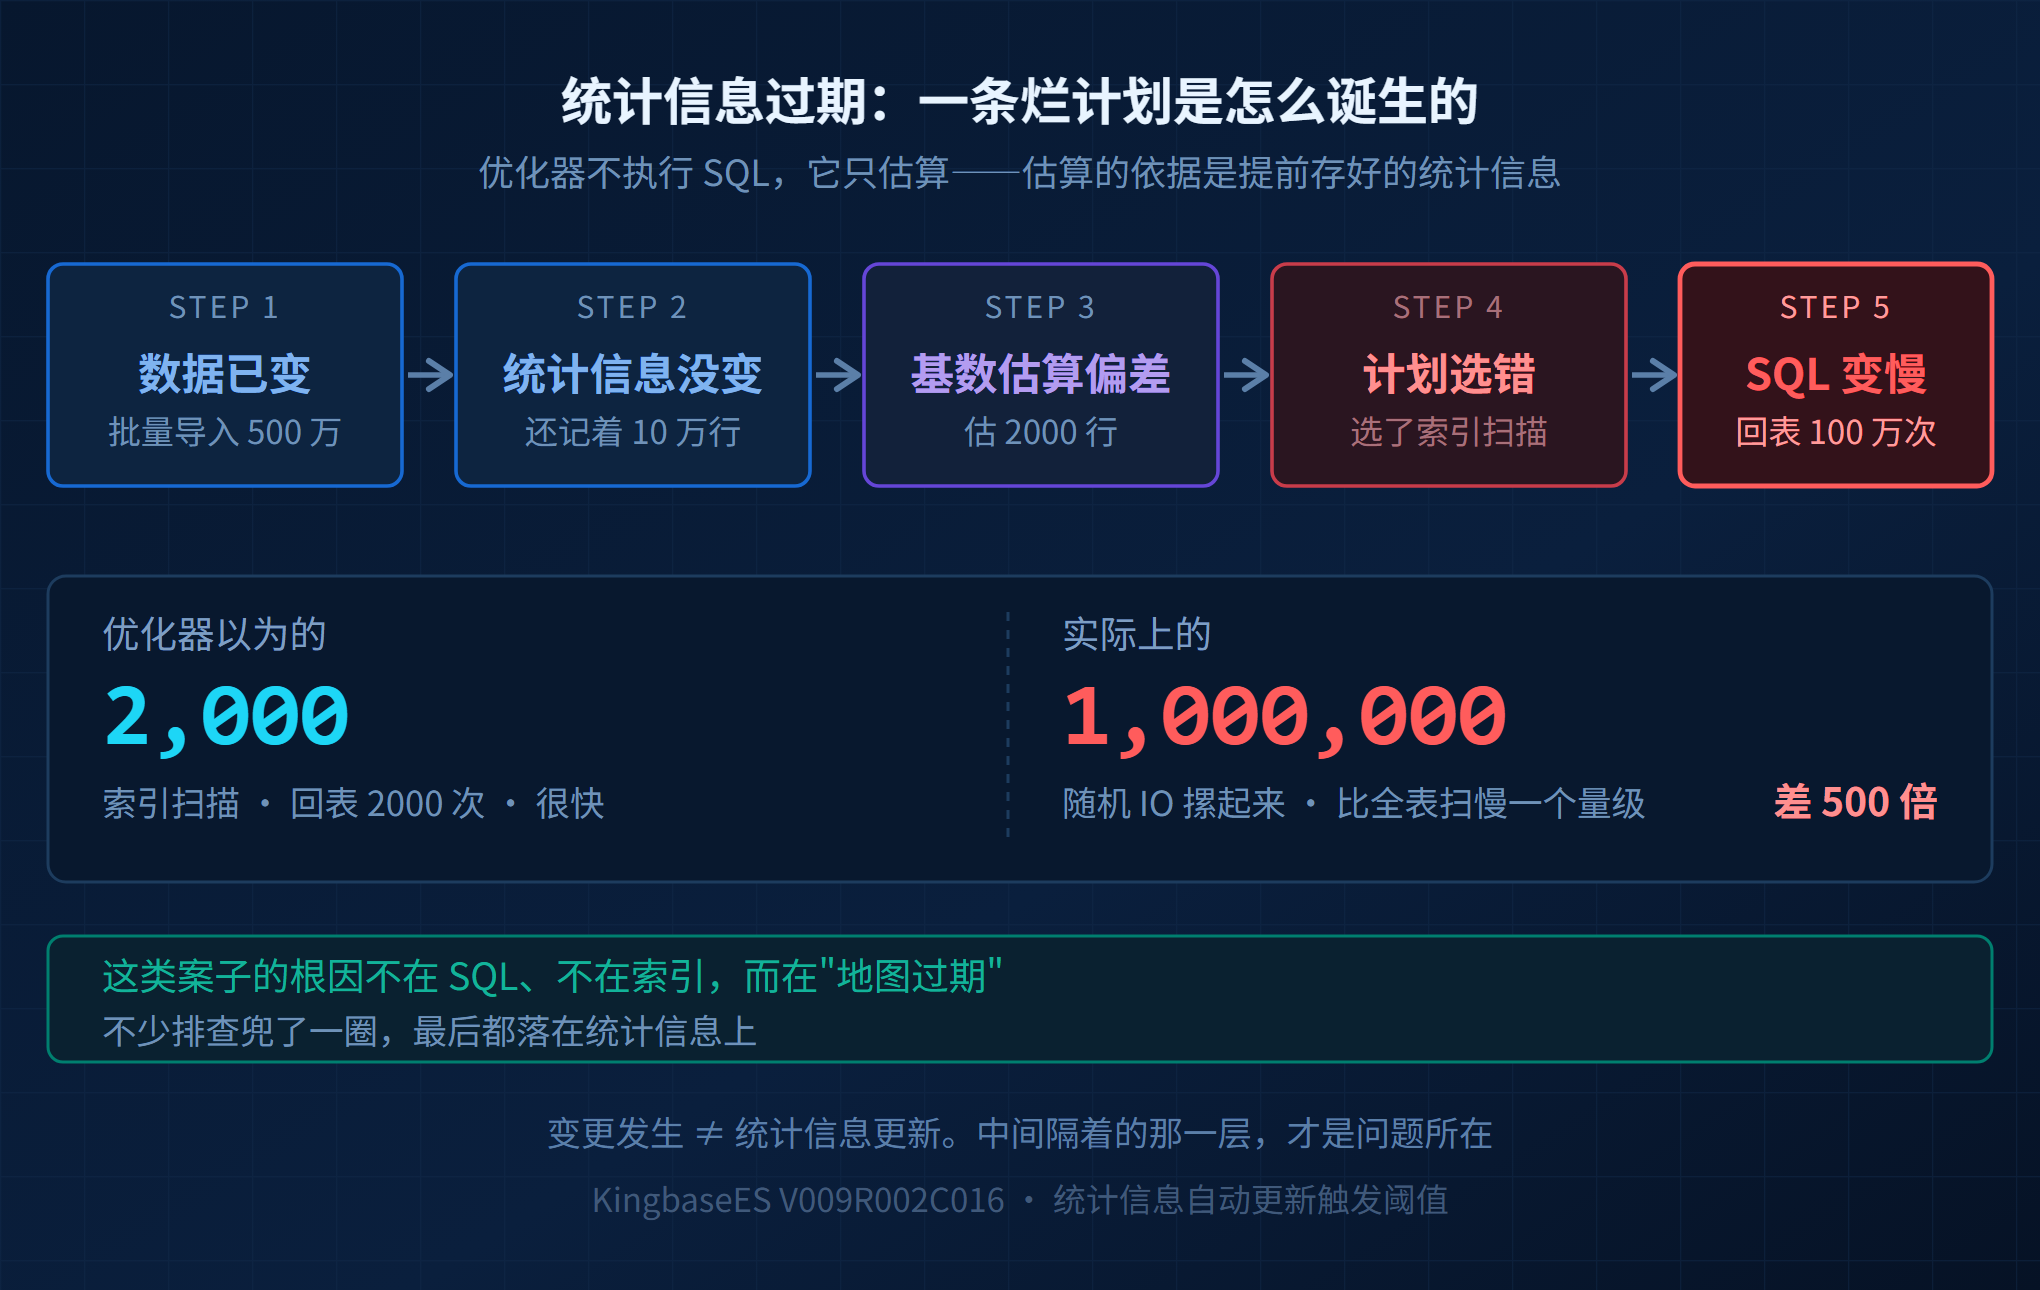
统计信息为什么没更新?
二、那 10% 到底有多离谱
自动收集一直是后台进程在干,规则一句话就能说完:默认是 50 + reltuples × 0.1——累计改动超过表的 10%,才考虑去更新统计信息。
听着还行?把数算出来看。
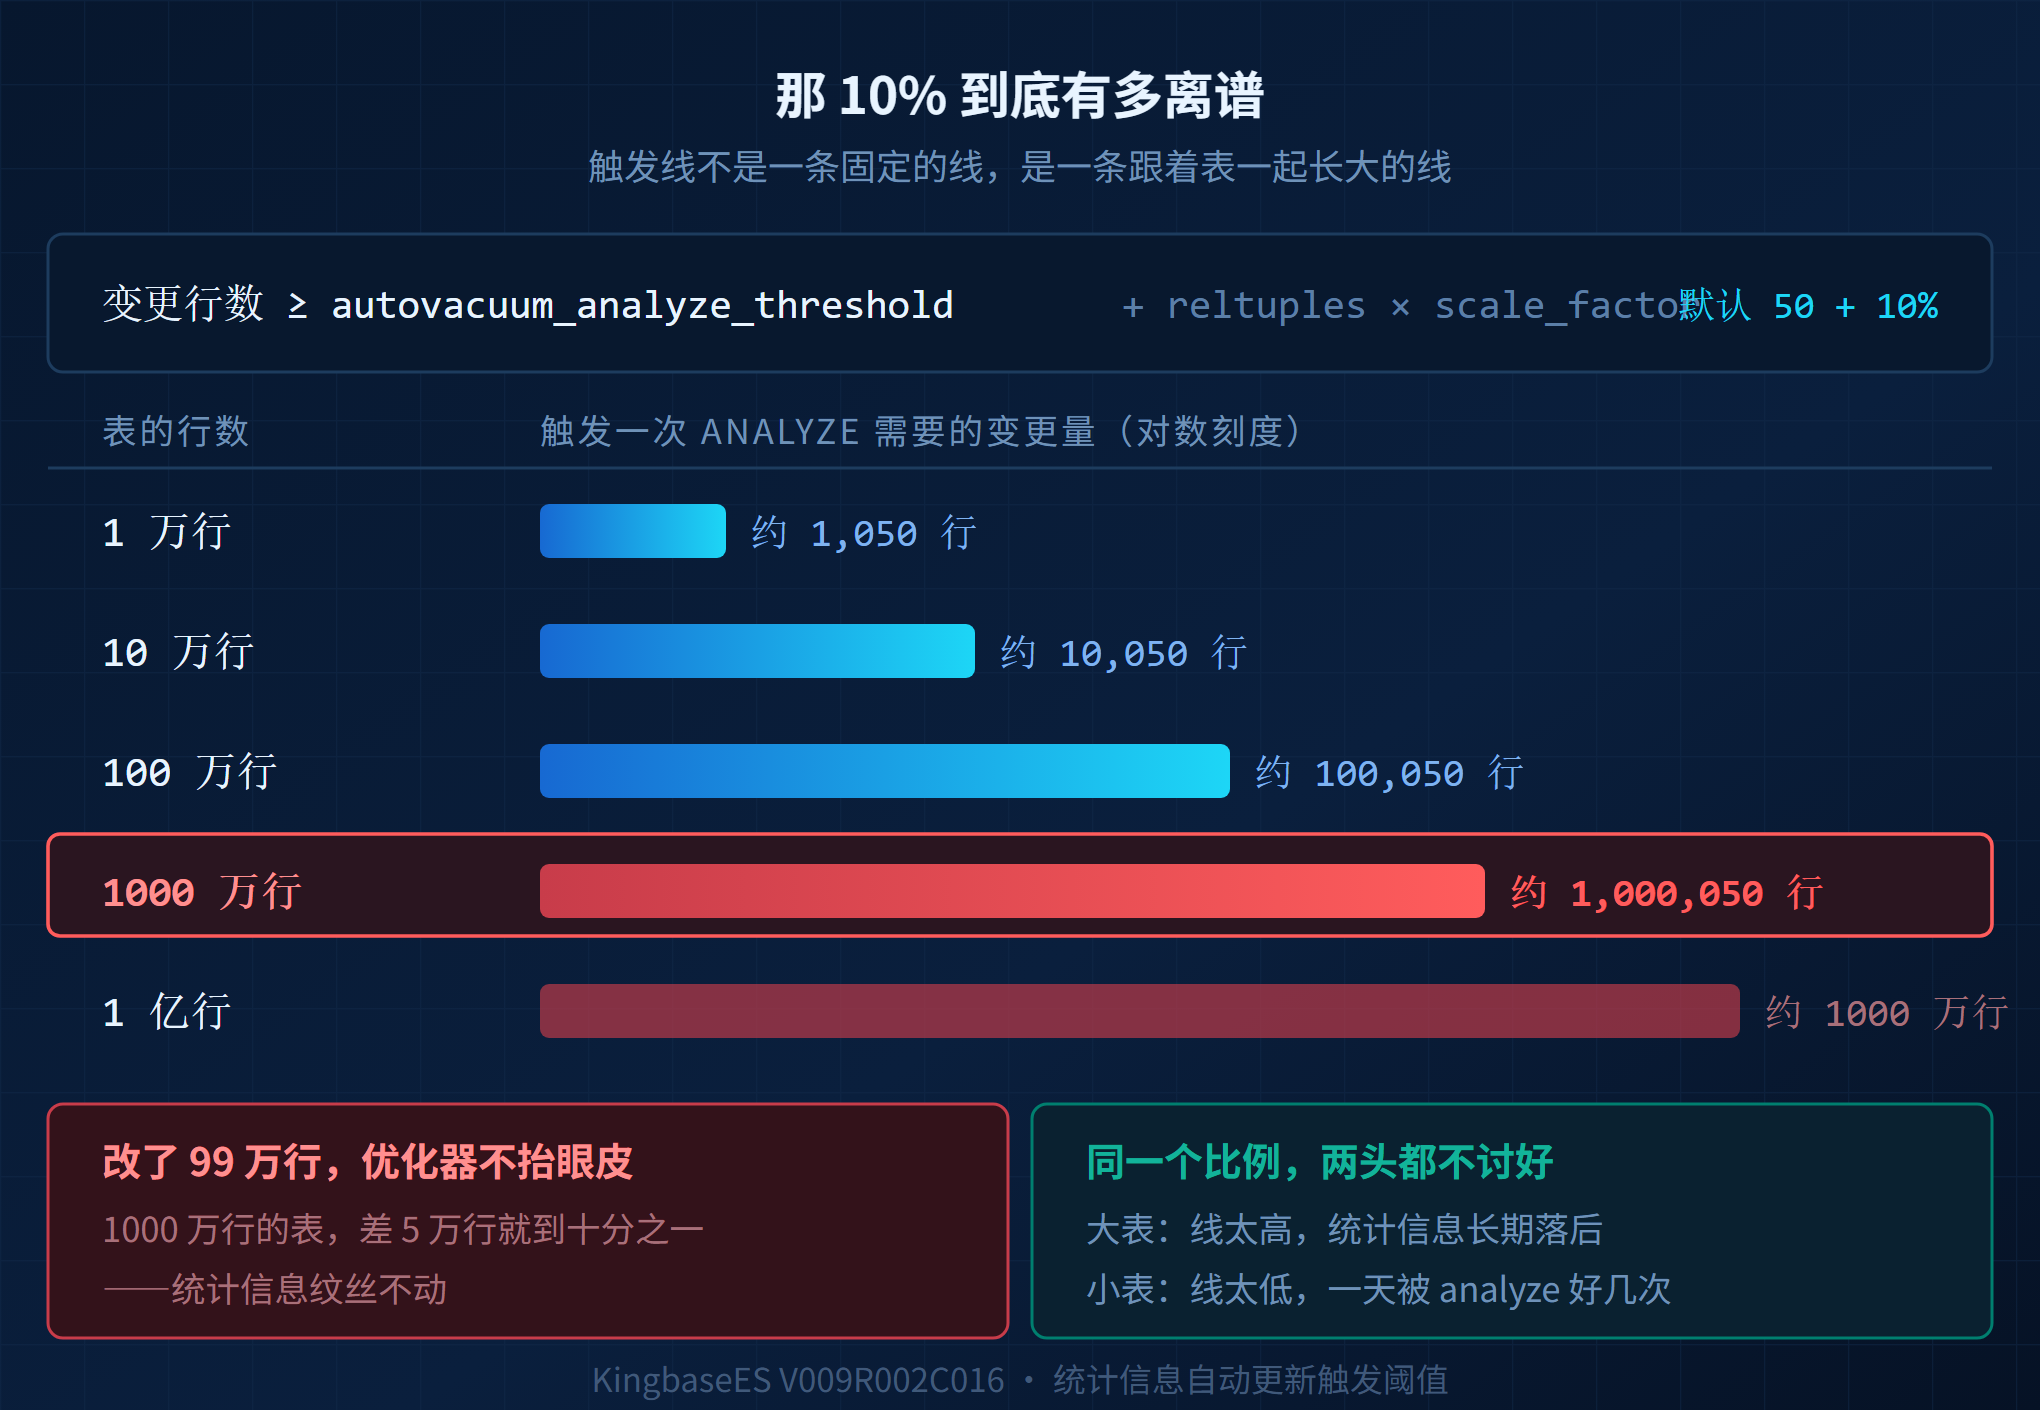
改 99 万行,优化器眼皮都不抬;改 150 行,它一天给你 analyze 好几回。偏偏大表又是最经不起烂计划的——小表走错计划顶多多花几十毫秒,大表走错就是几百秒。
还有第二个坑,跟比例无关,跟时机有关。
后台进程是轮询的,默认一分钟醒一次看看有没有活儿。醒了之后还不立马干——能同时干活的进程就那么几个,一堆表排着队等。遇到批量导入、月末结算这种场景,几十上百张表同时超线,排队能排到几十分钟之后。图上那条 35 分钟的滞后窗口,就是这么攒出来的。
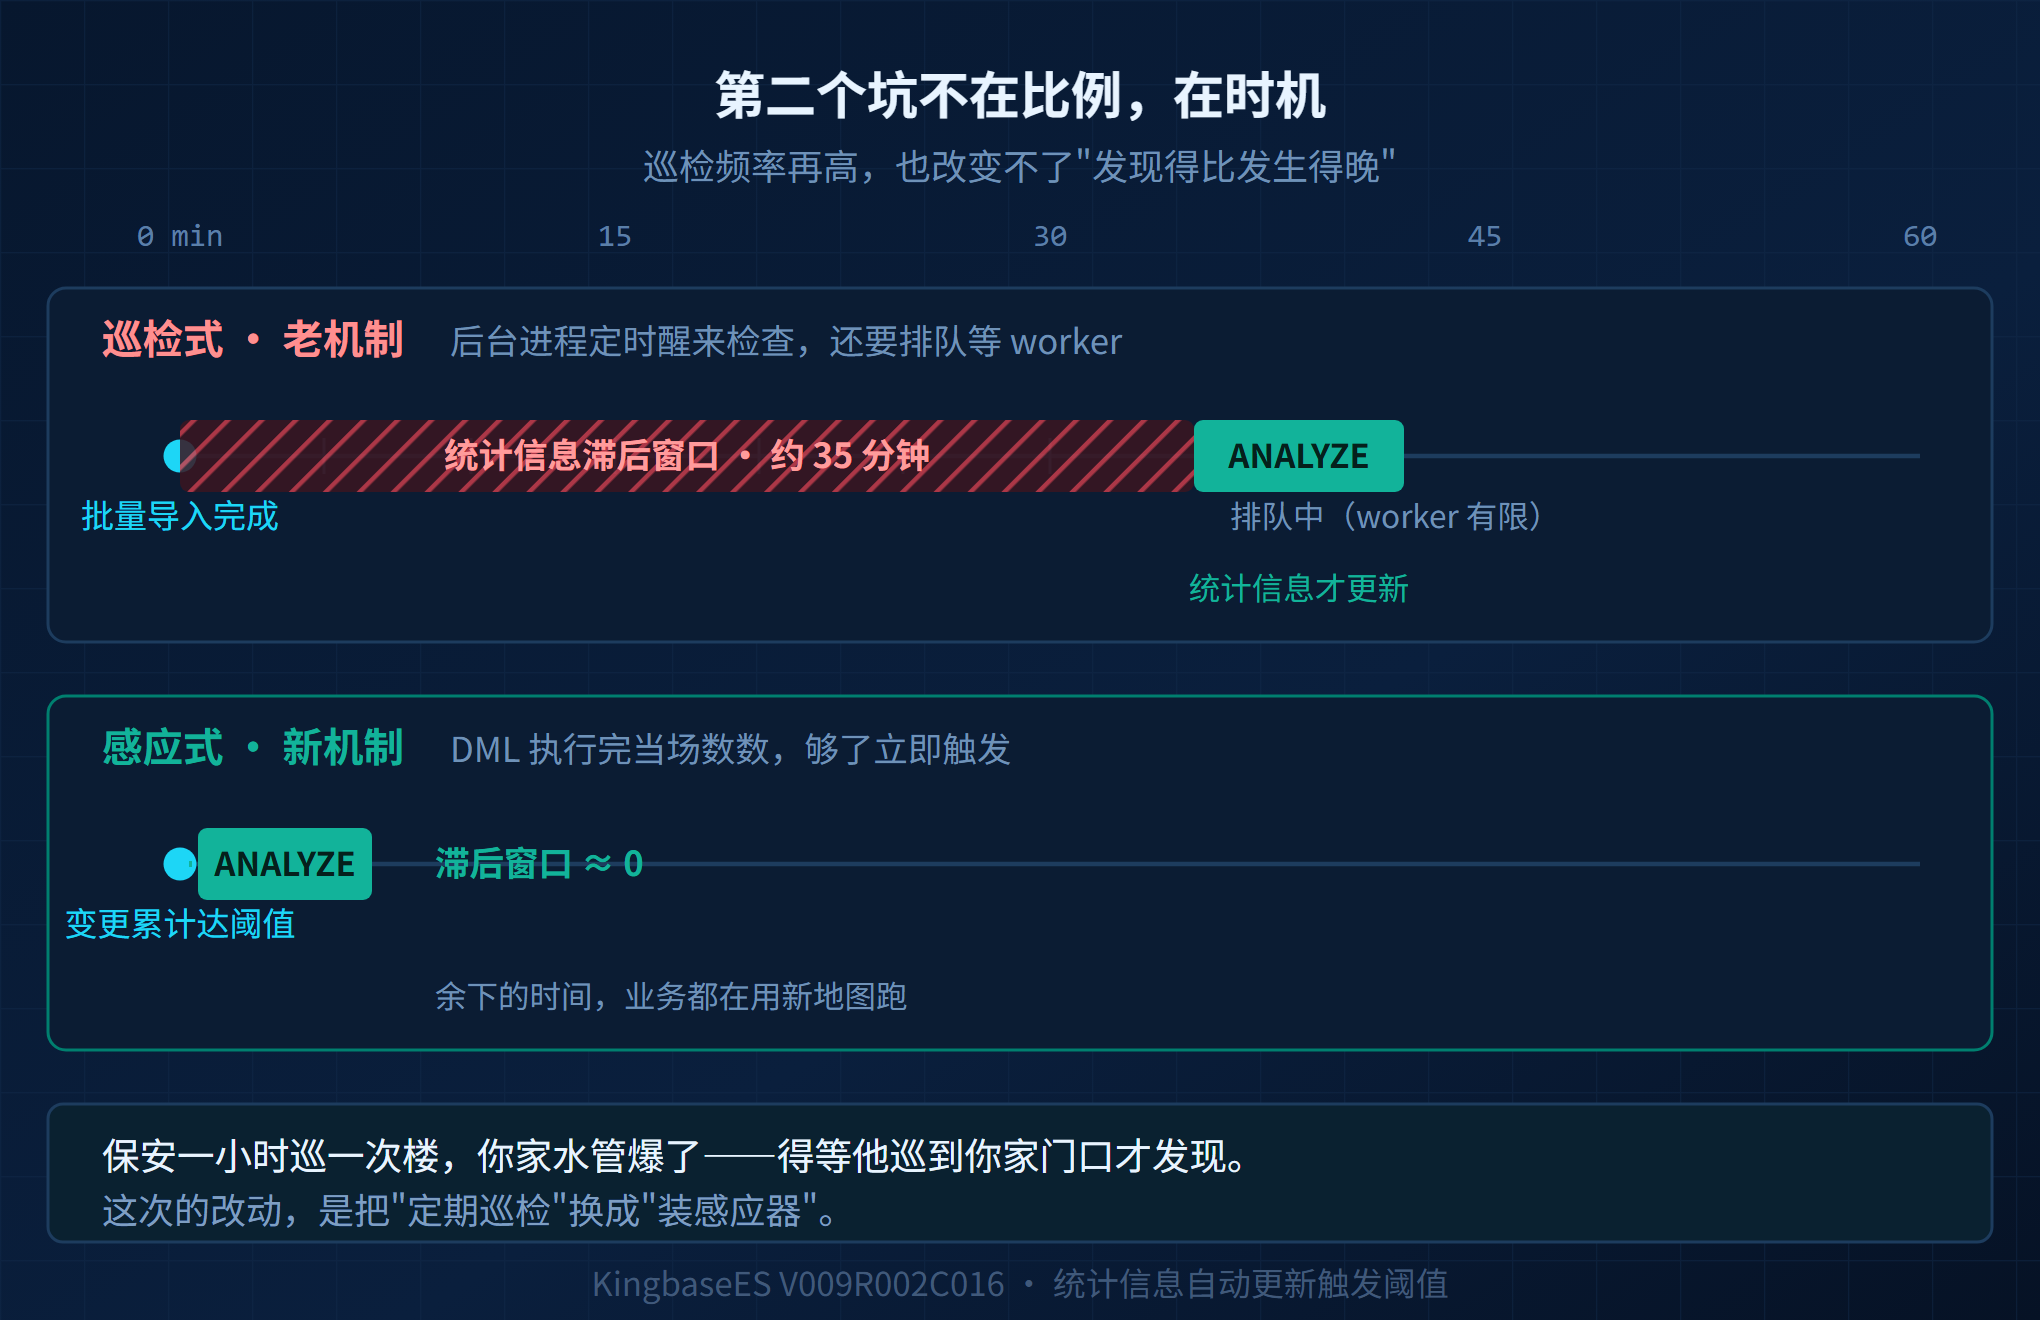
三、那些年,我们都是怎么熬的
道理不复杂,真干起来是另一回事。这些年老办法攒了三条,一条比一条有味道。
第一条:手工补一刀。 批量导入脚本的最后加一句 ANALYZE 表名;——简单粗暴,确实管用,毛病是靠人记,换个人写脚本就忘了。
第二条:挂定时任务。 cron 里半夜跑一轮,核心表过一遍。"忘"的问题解决了,但它是无差别的——昨天一行没变的表也照跑,白扔 IO。
第三条:把比例调小。 触发线从 10% 降到 1%,大表好受点了,小表更疯了,而且该等轮询还是得等轮询。
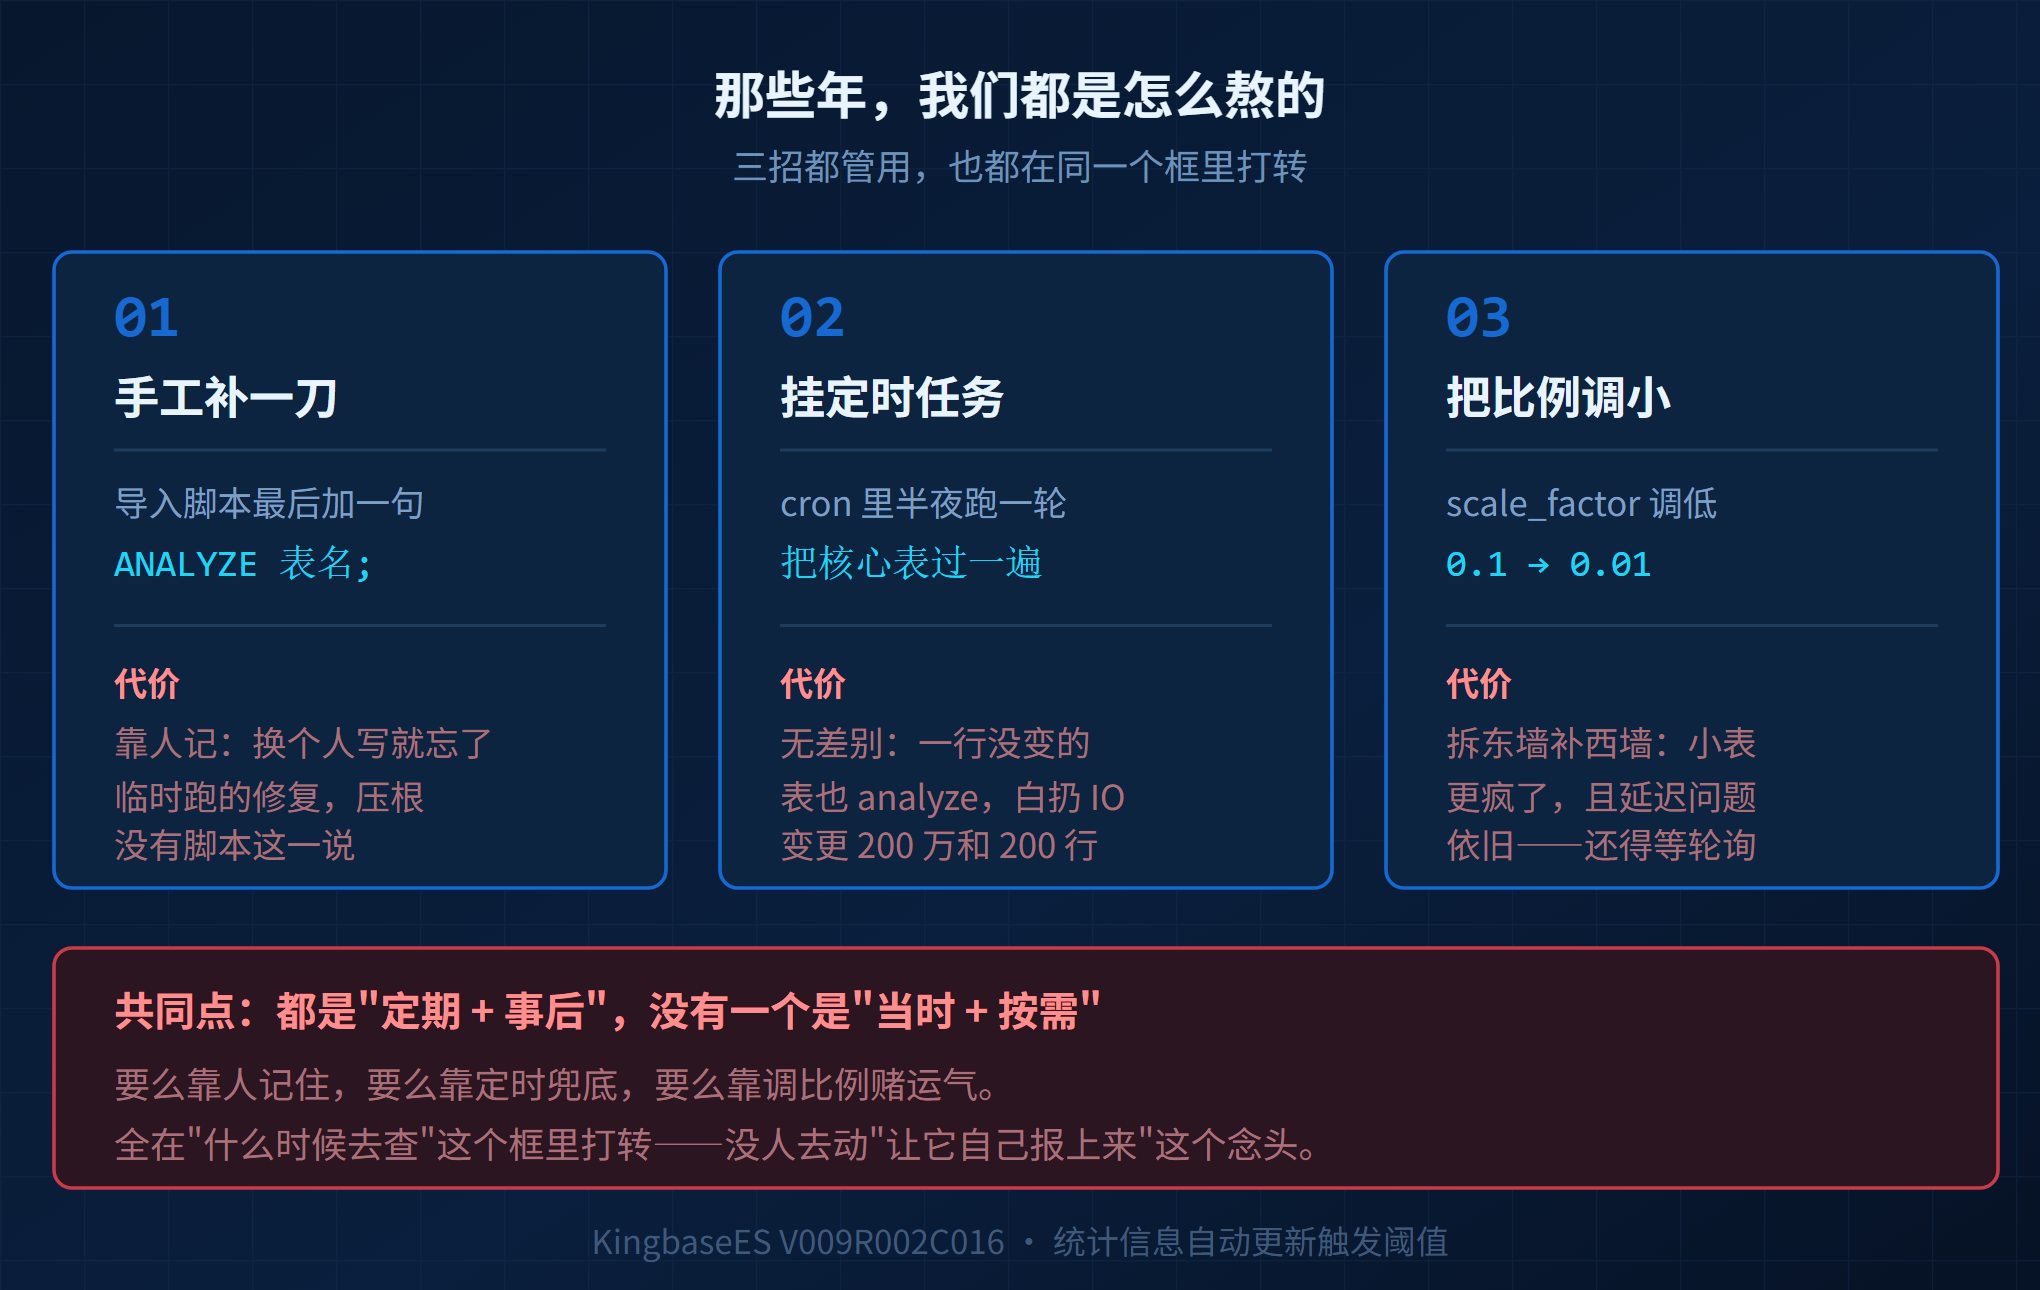
四、从巡检改成感应
V009R002C016 给的这个能力,跟上面三条路子都不一样——它不在"什么时候去查"上做文章,而是让变更自己报上来。
说白了:你在表上装个计数器,说好"累计变动够 N 行就吱一声",DML 一执行完当场数数,够了就立即触发 ANALYZE。
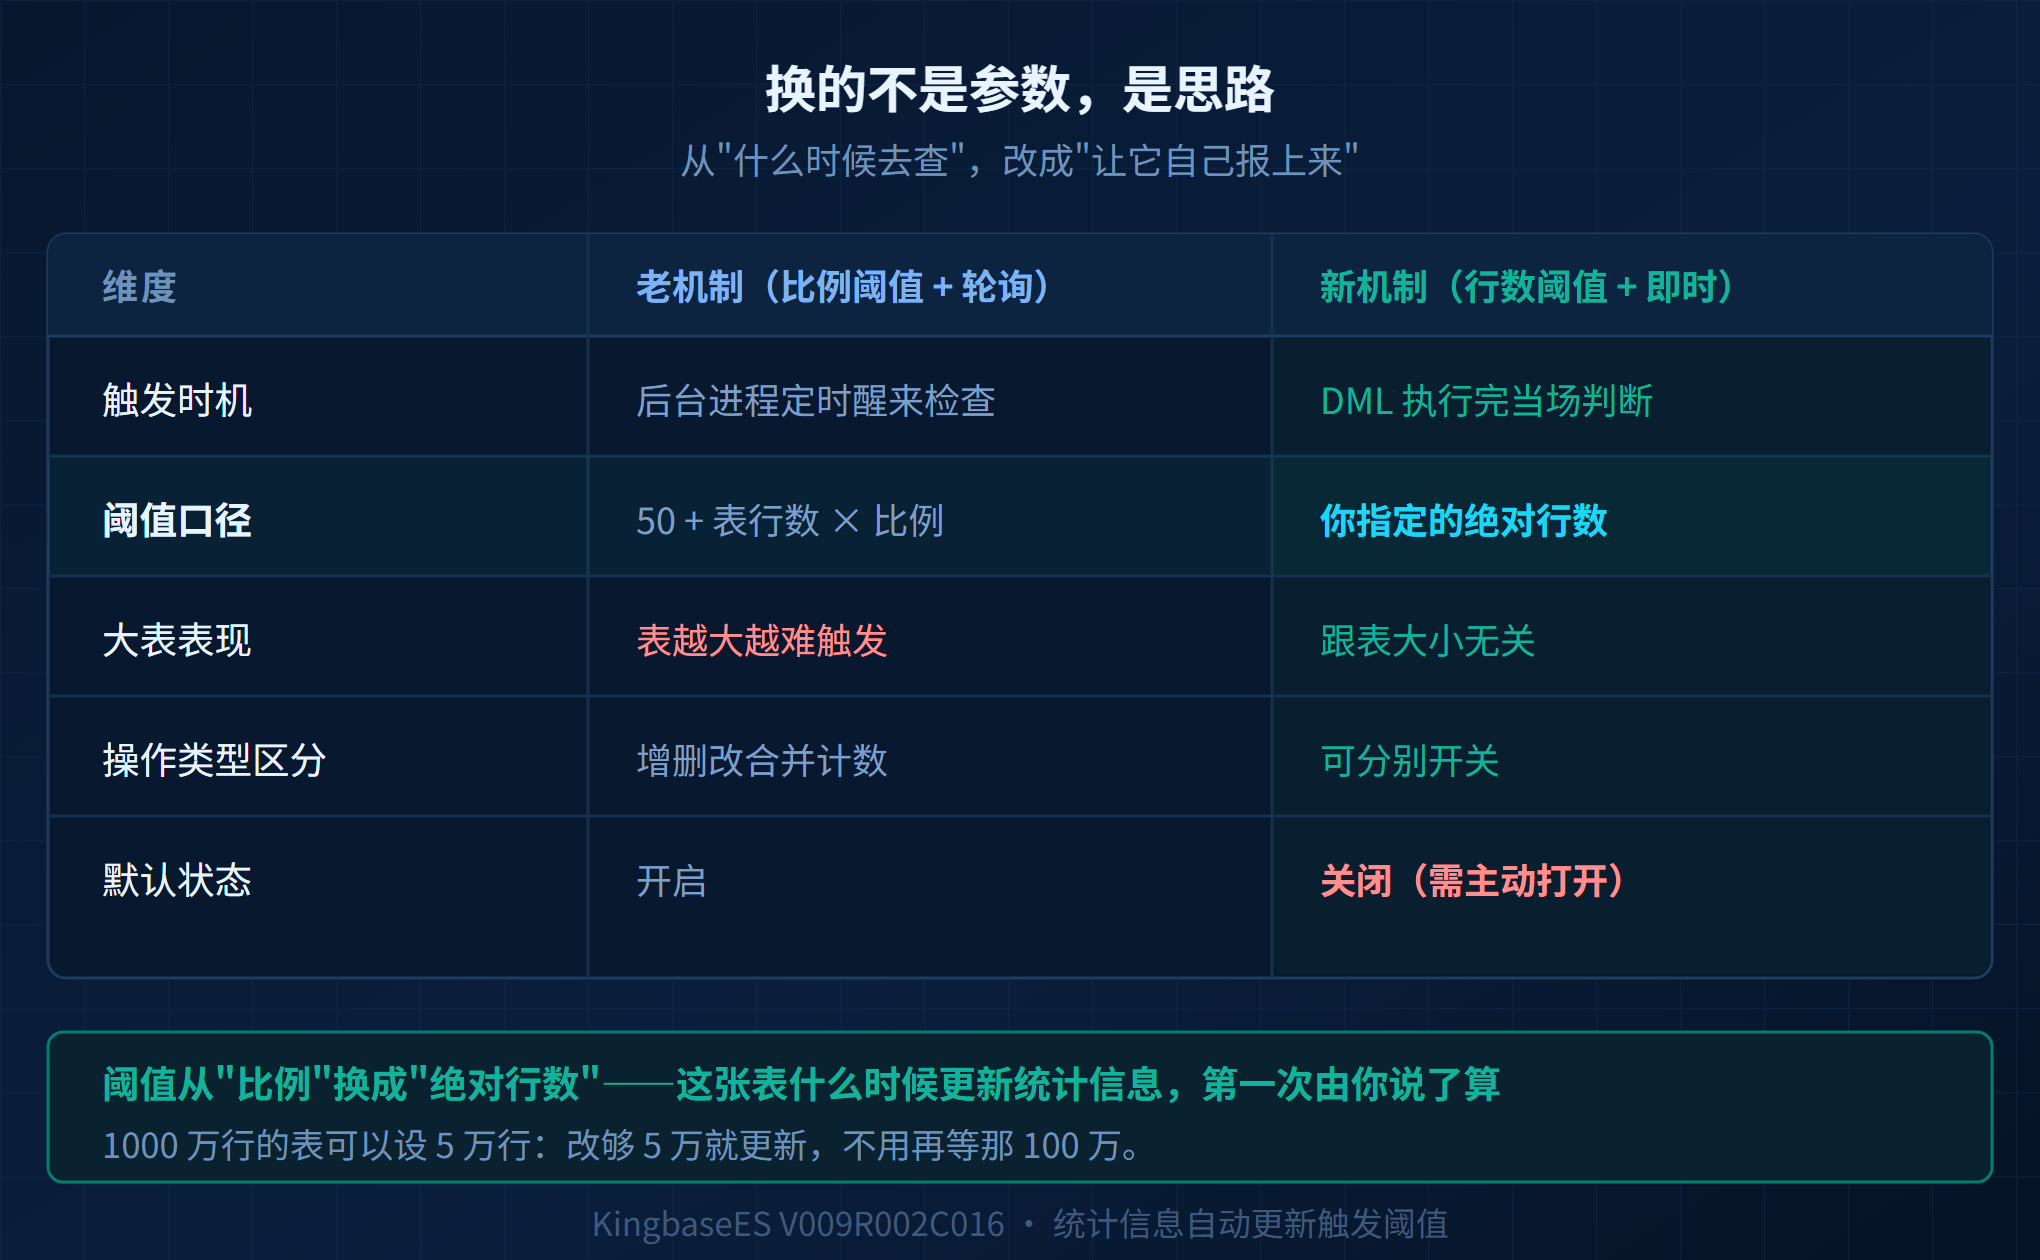
老机制是一锅烩,新机制能把增、删、改分开对待:只增不改的流水表,只管 INSERT 就行;每天批量清过期数据的表,DELETE 才是主角。
还有一点别忘了——这套东西默认是关的,装上不生效。为什么不给默认开着,往下看。
五、两个参数
这两个参数是配合干活的——光开一个没用,这点特别容易踩。
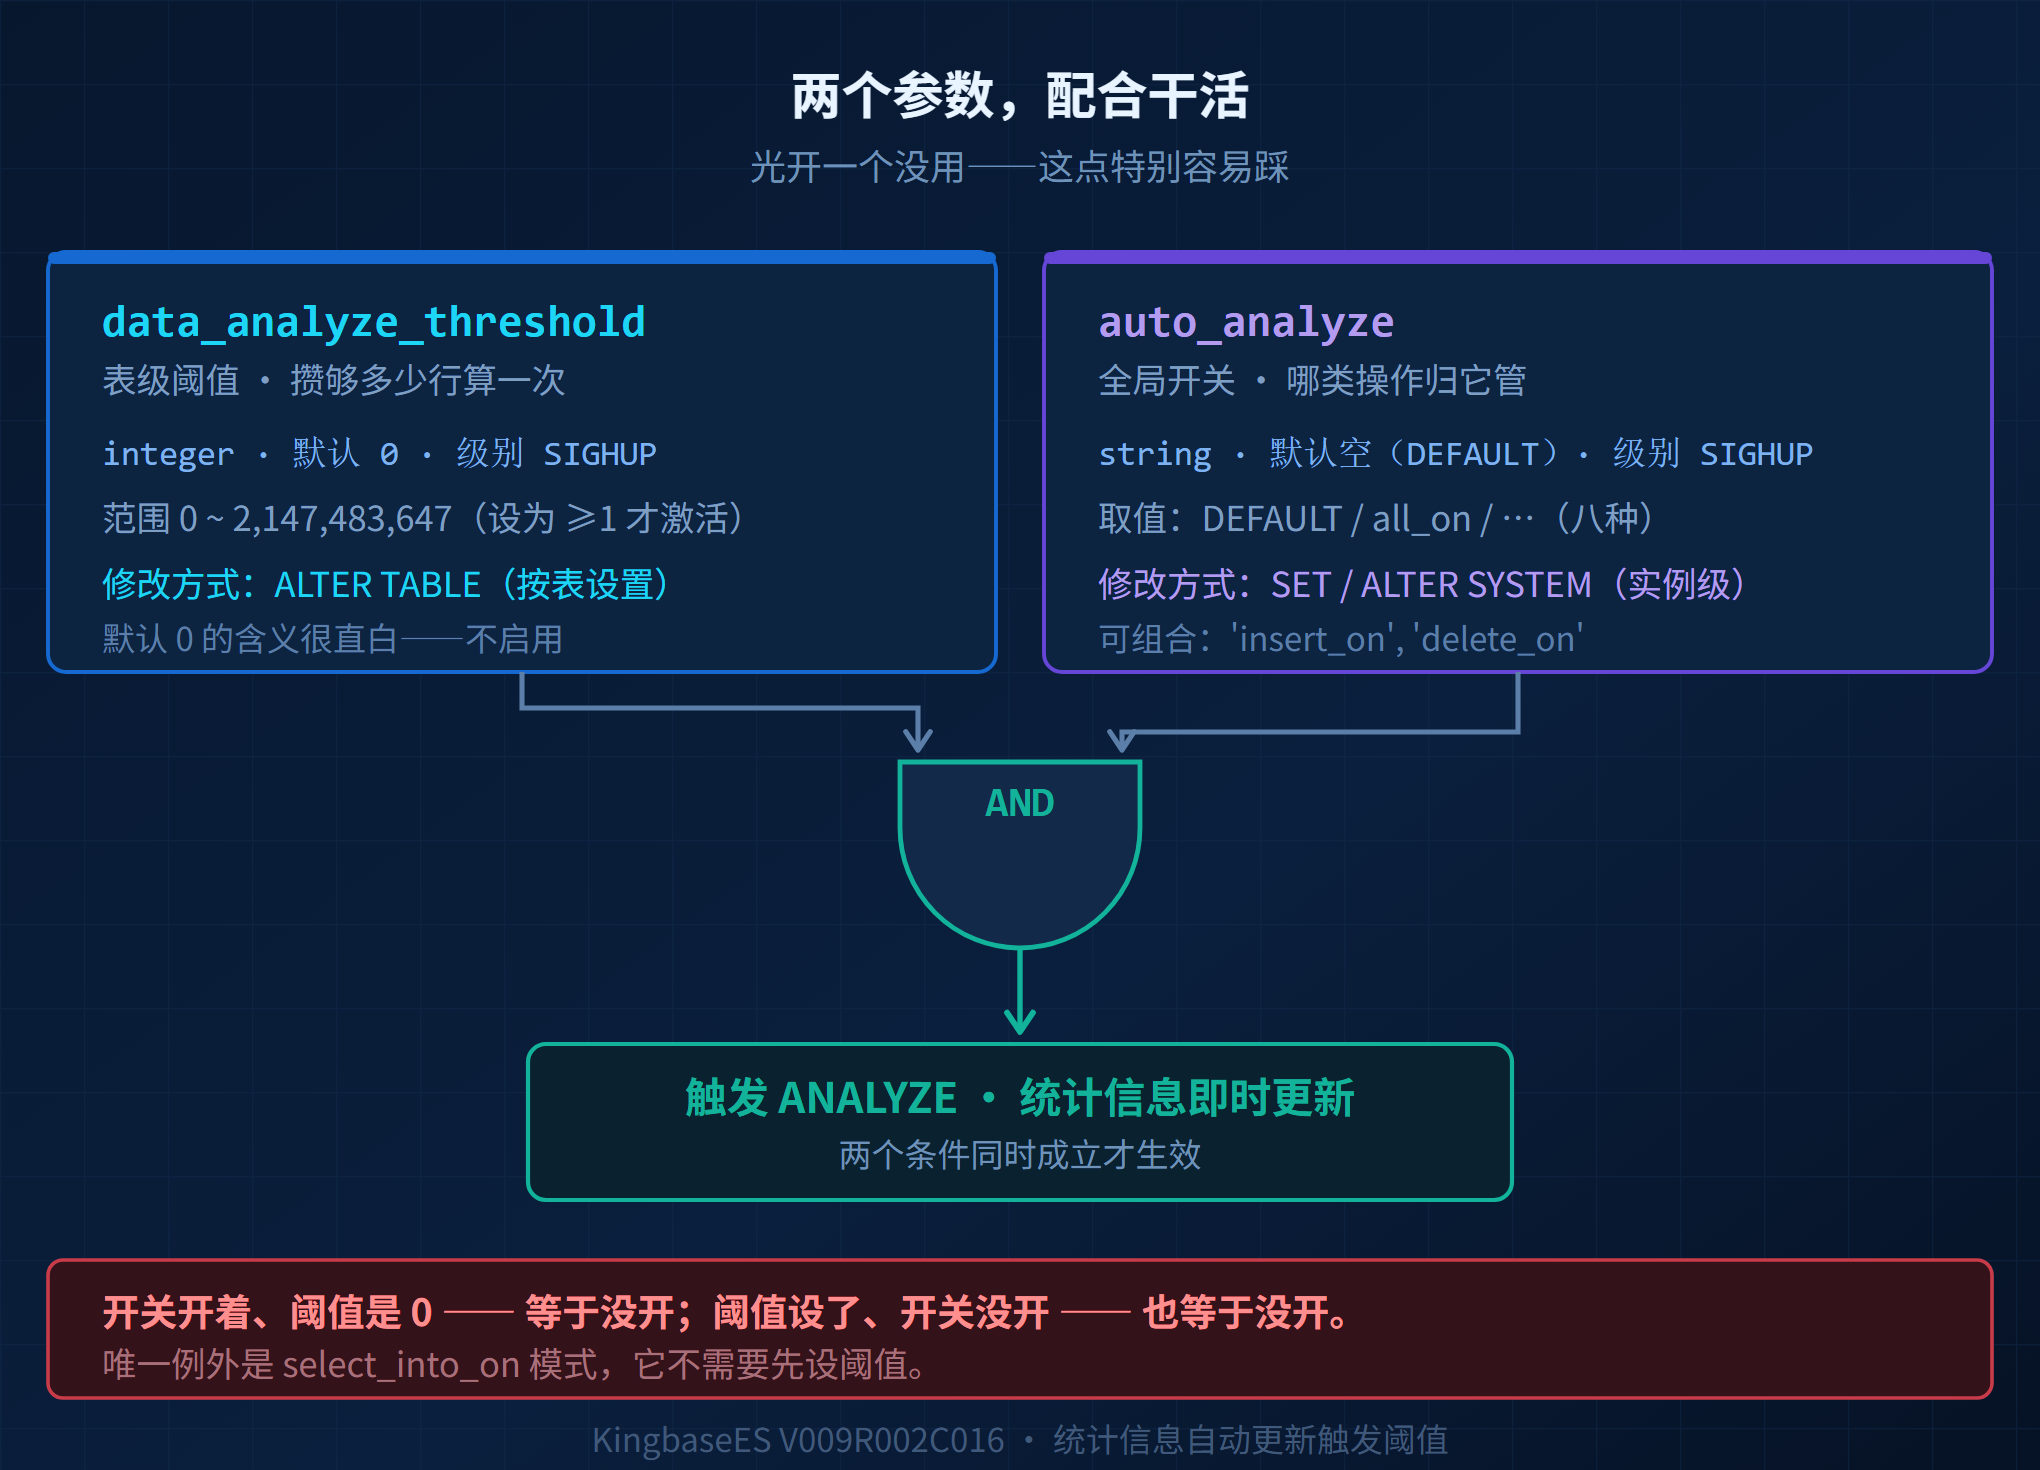
参数一:data_analyze_threshold(表级阈值)
给指定的表设一个行数门槛:对该表的 DML 累计超过这个数,且对应类型的开关开着,就立即触发统计信息更新。支持的类型有 INSERT、DELETE、UPDATE、COPY、sysbulkload 五种,用 ALTER TABLE 按表设置。默认 0 就是不启用——这个值不设,后面一切免谈。
参数二:auto_analyze(全局开关)
决定哪一类操作会触发统计信息更新,实例级设置,八种模式见下图,可以组合着写。
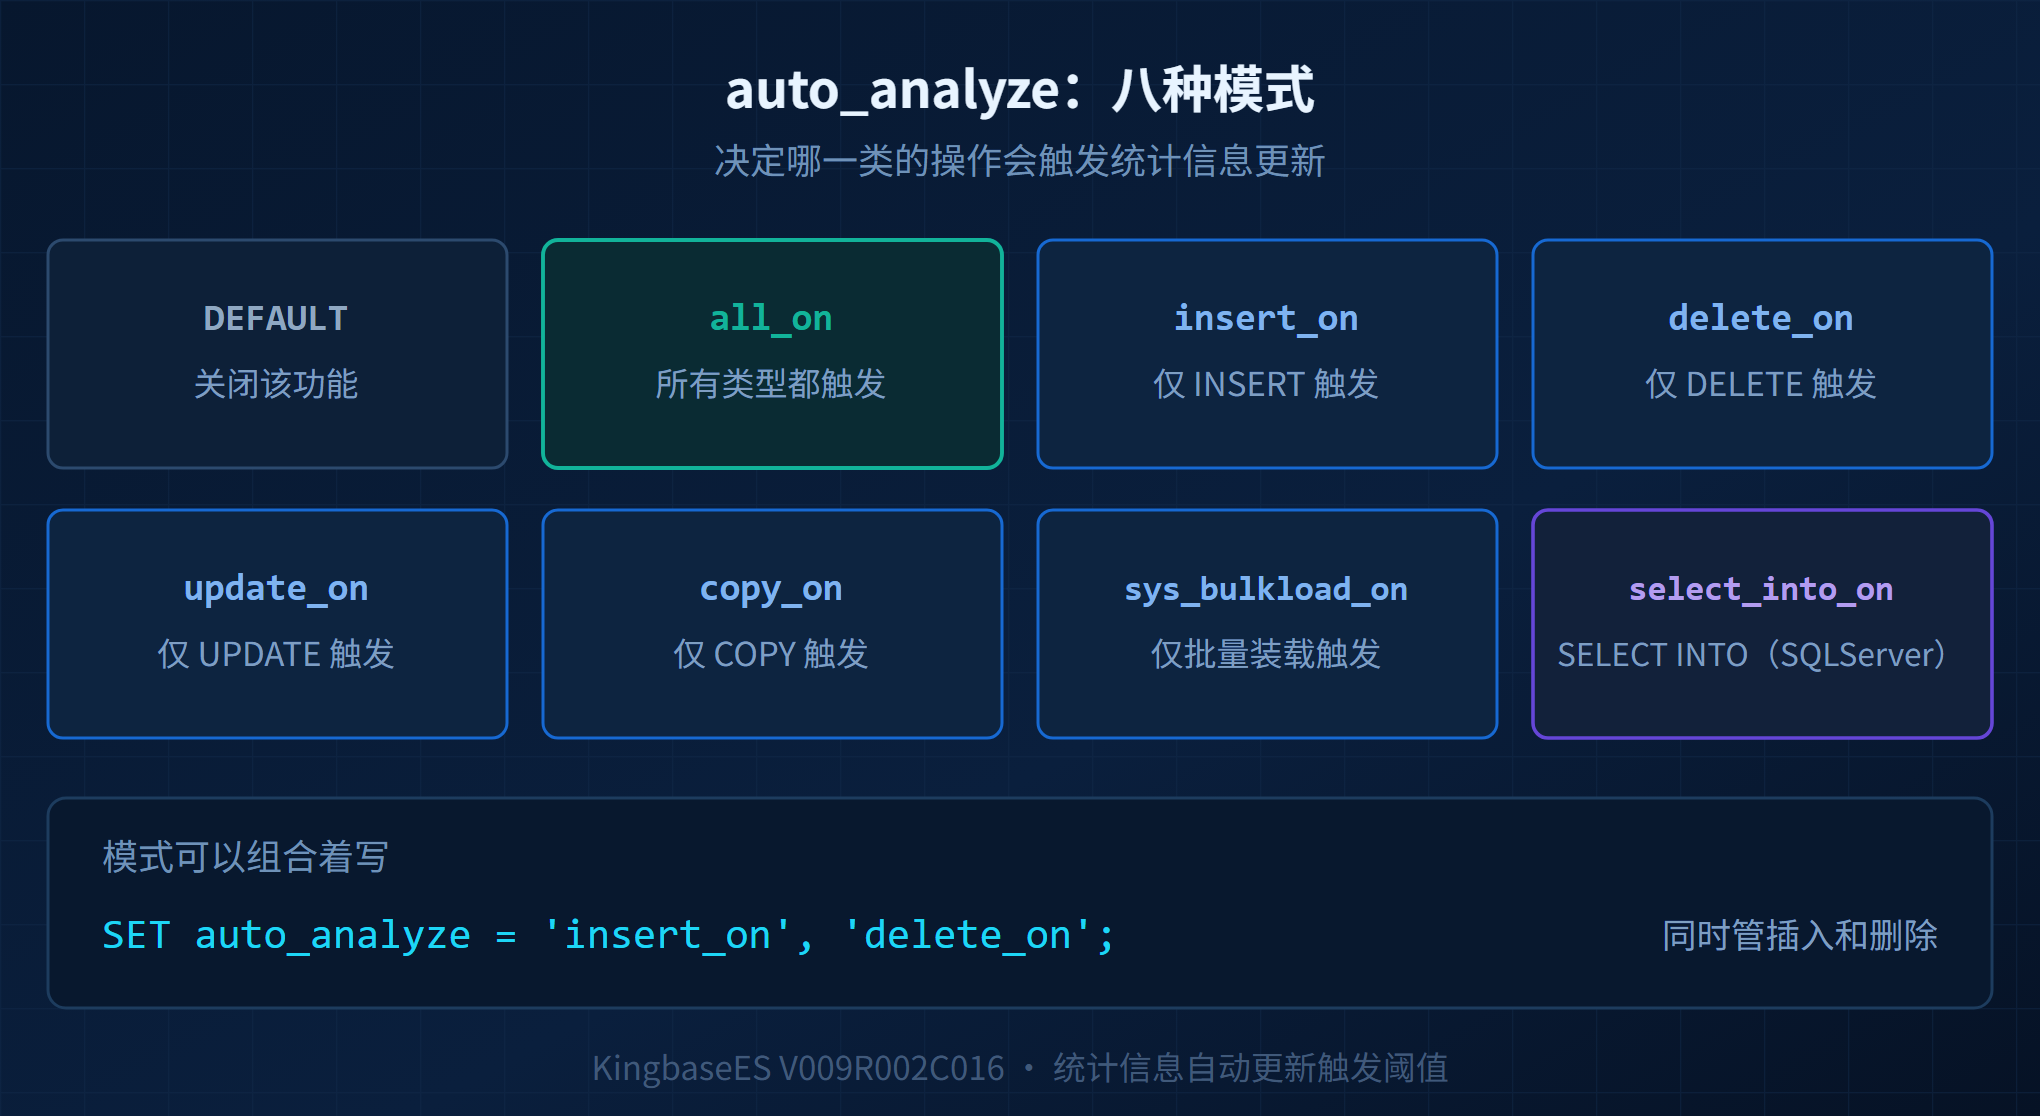
还有一层结构上的事:阈值是表级的,开关是实例级的。 开关决定"这个库管不管 INSERT",阈值决定"这张表攒够多少行算一次"。同一套开关下,核心交易表可以设 5 万,日志表可以设 50 万,配置表干脆不设——粒度是分开的,这正是它比调全局比例精细的地方。
六、ANALYZE 不是免费的
这么好用的能力,为什么默认不给开着?
因为每次触发都是一次 ANALYZE,而 ANALYZE 是要花钱的——它得真刀真枪去采样,吃 CPU 也吃 IO。设小了是风暴,设大了白开,这个度怎么把握,看下图。
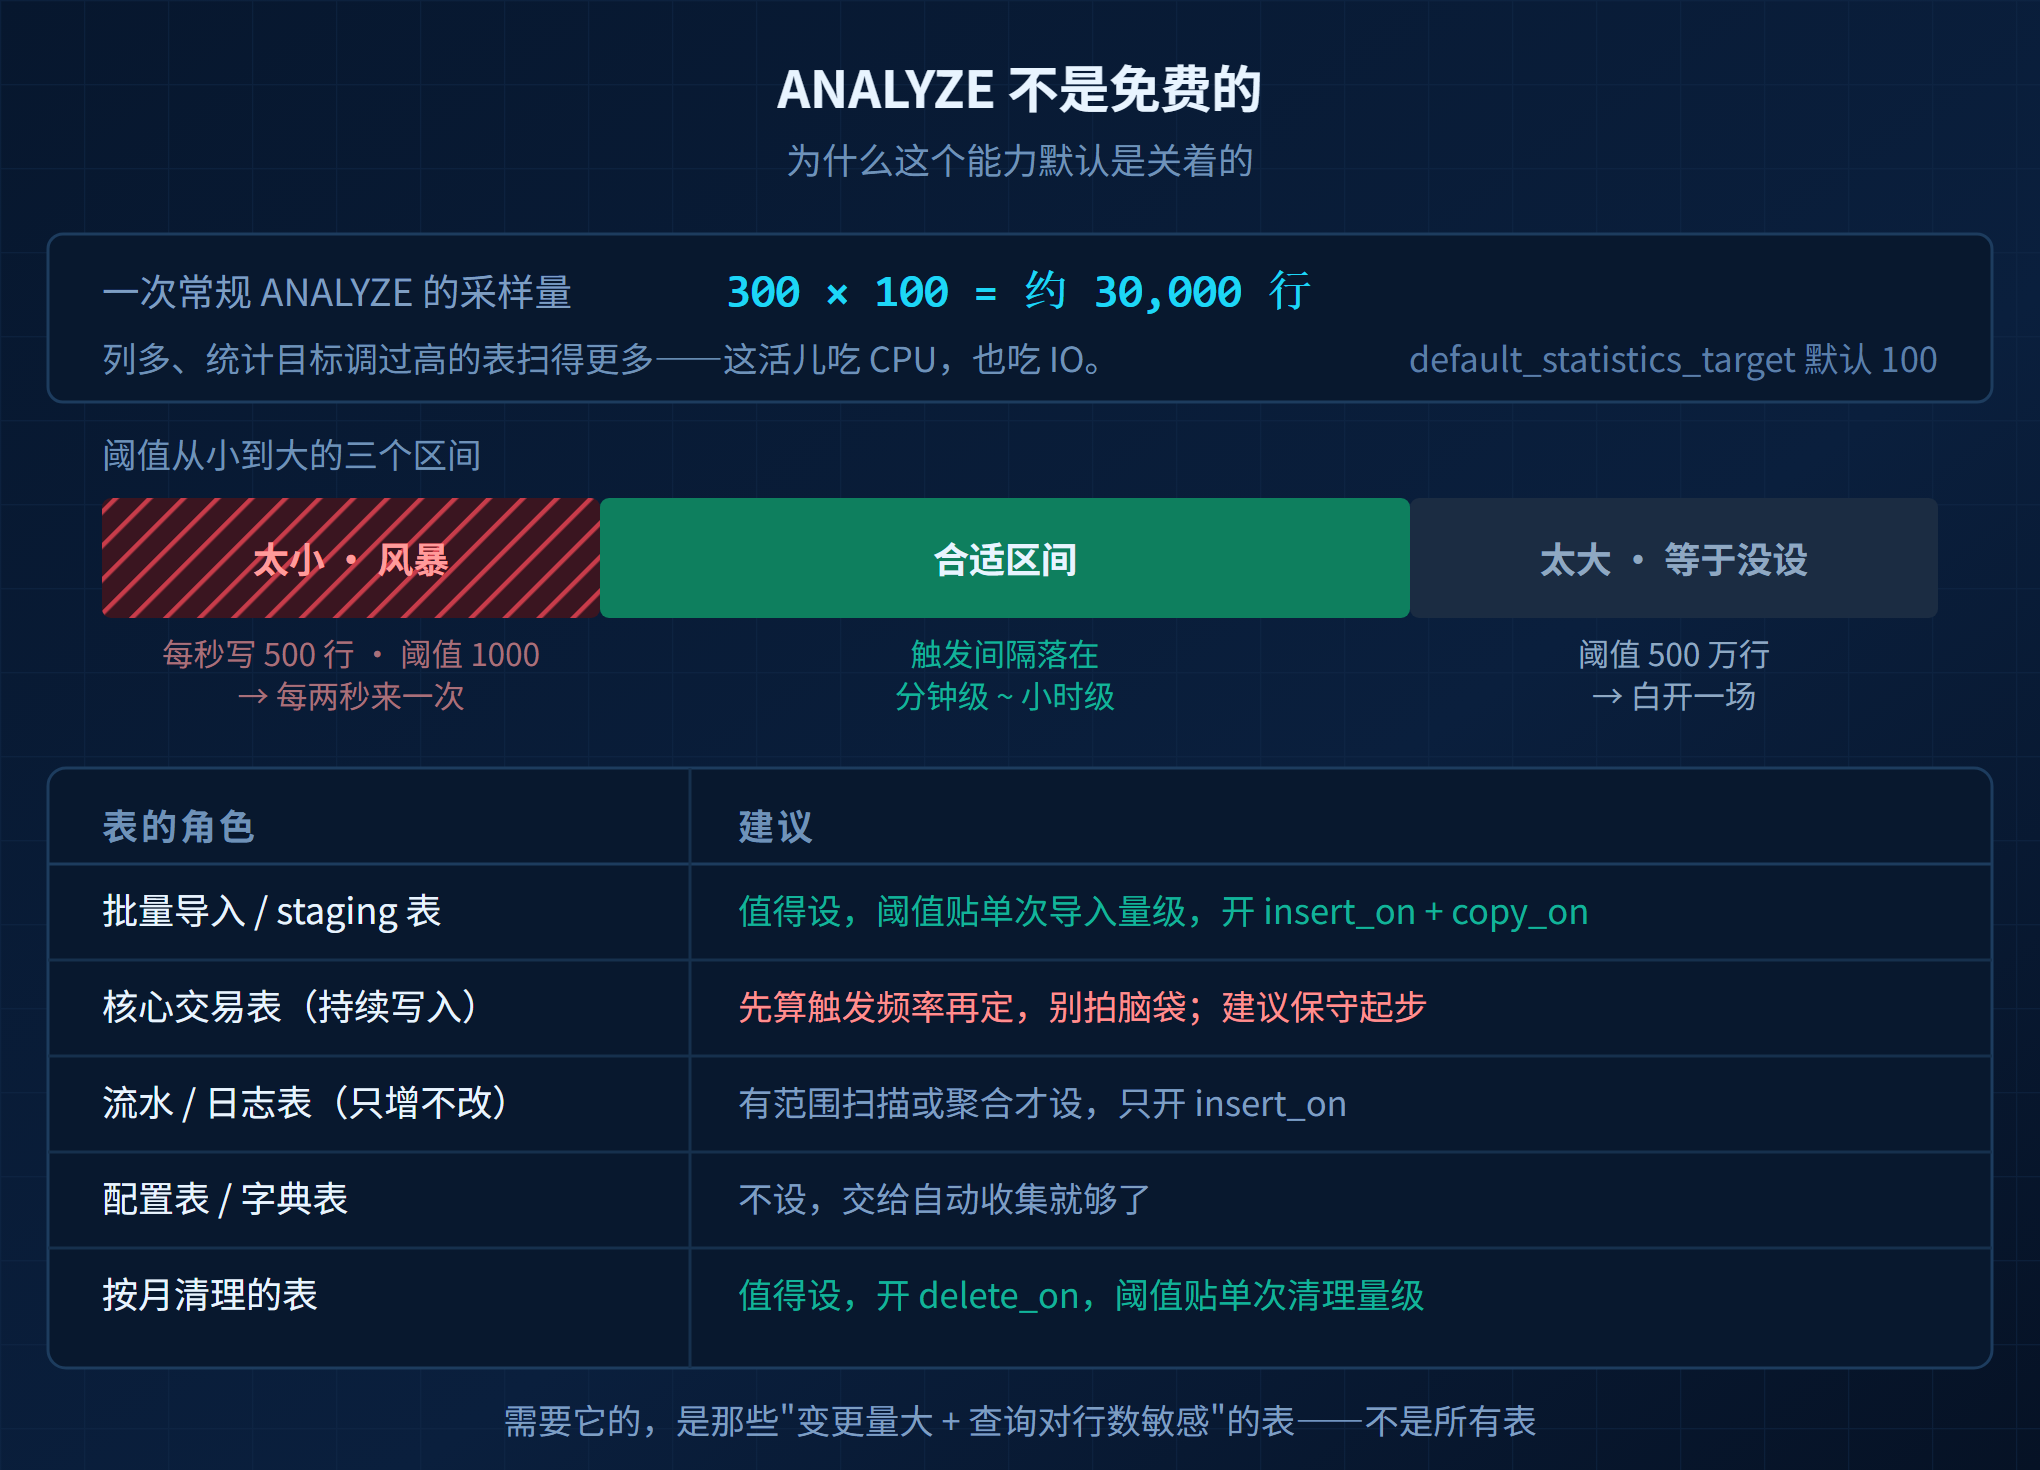
具体到一张表,可以先问三个问题:
- 这张表一天变多少行?(查
sys_stat_user_tables里的n_mod_since_analyze就能估出来) - 这些变更集中还是分散?批量导入的,阈值就贴着单次批量量级设;匀速写入的,按"期望几小时更新一次"倒推;
- 这张表的查询对行数敏不敏感?大表关联、范围扫描、聚合——敏感,值得设;按主键点查的,统计信息差一点无所谓,不用凑热闹。
分区表要多想一步:阈值是表级的,主表和子表得分别想清楚。
七、实操清单
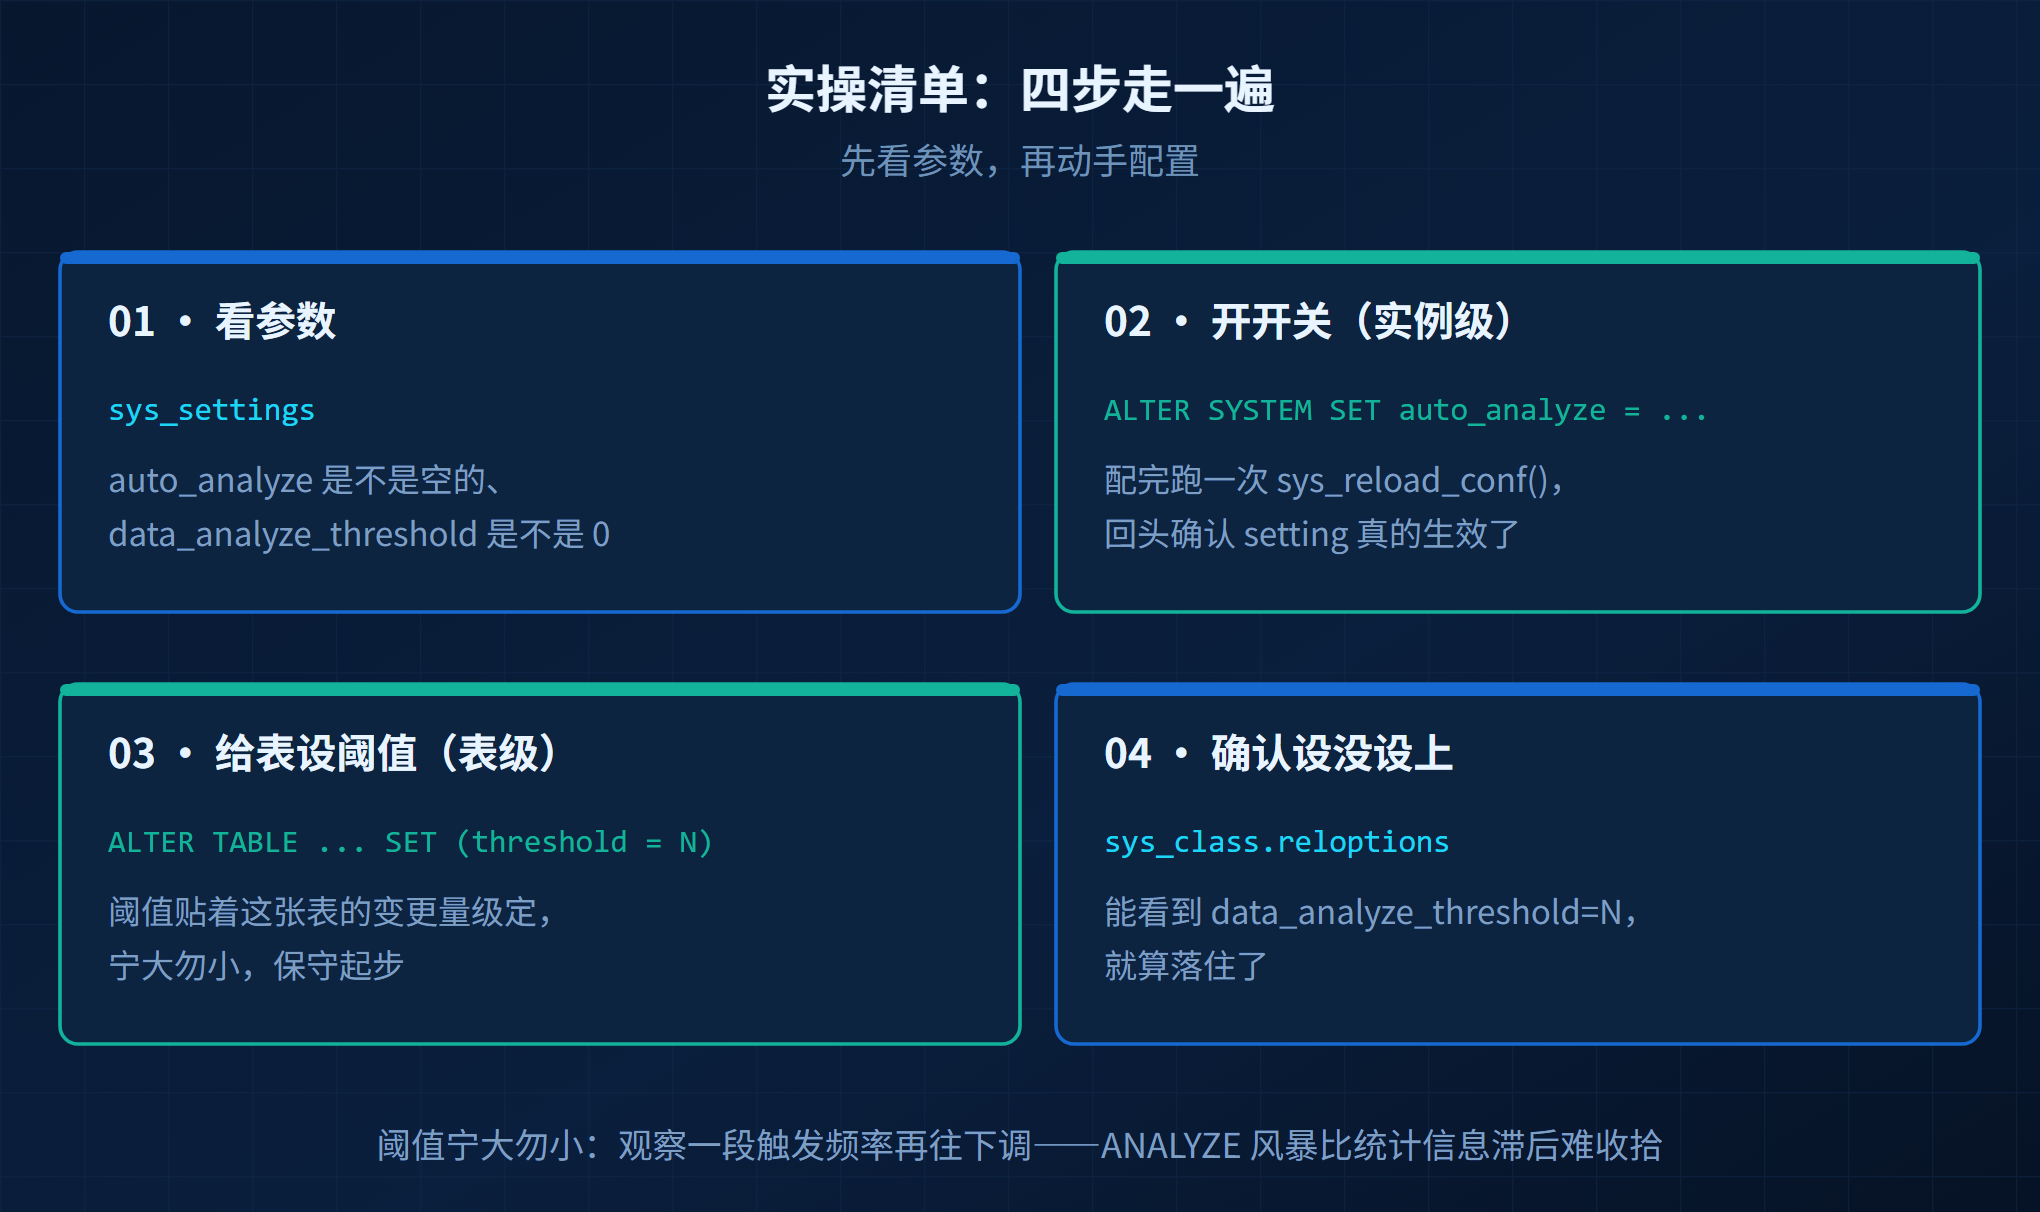
本期跟随总监,把要用的 SQL 摆出来。这套环境我还没装,先把清单放这儿——等装好跑一遍,再补实测回显。你着急的话,直接拿去用也行。
1. 看参数:现在都是什么值
SELECT name, setting, unit, boot_val, reset_val, min_val, max_val, context
FROM sys_settings
WHERE name IN (
  'auto_analyze',
  'data_analyze_threshold',
  'autovacuum_analyze_threshold',
  'autovacuum_analyze_scale_factor',
  'default_statistics_target'
)
ORDER BY name;
重点看 auto_analyze 是不是空的、data_analyze_threshold 是不是 0。
2. 开开关(实例级)
ALTER SYSTEM SET auto_analyze = 'insert_on', 'update_on';
SELECT sys_reload_conf();
3. 给具体的表设阈值(表级)
ALTER TABLE 订单表 SET (data_analyze_threshold = 50000);
4. 确认设没设上
SELECT relname, reloptions
FROM sys_class
WHERE relname = '订单表';
reloptions 里能看到 data_analyze_threshold=50000,就算落住了。
总结
统计信息自动更新触发阈值有个特别的地方:它把调参的主动权从"表有多大"手里,交回到了"你想要多新鲜"手里。
所以我的建议:
- 别一把全开。 默认关着是有道理的,先查
n_mod_since_analyze找出真正落后的那几张表,针对性设; - 阈值宁大勿小。 保守起步,观察一段时间触发频率再往下调。ANALYZE 风暴比统计信息滞后难收拾得多;
- 老机制别撤。 自动收集还在跑着,它管的是全库兜底和死元组回收,新机制是在它之上加的精准补充,不是替代品;
- 把
n_mod_since_analyze加进日常巡检。 这个指标以前只是参考值,现在它是你判断"哪张表该装计数器"的直接依据。
回到开头那条跑了半年突然变慢的 SQL。
它慢,不是因为优化器变笨了——优化器一直那么聪明,也一直那么相信它手里的地图。问题从来都是:地图是上一版的,路已经修过了。
这次的更新,做的是一件挺朴素的事:给表装个计数器,路一修完就通知画图的人。
老规矩,知道写了些啥。