

在基于 NVIDIA Grace Blackwell GB10 的 Mopheus 一体机上搭双机分布式推理,最先被问到的问题往往不是模型怎么部署,而是两台机器之间那根高速线到底插几根。
如果只看 NVIDIA 官方针对 DGX Spark / GB10 双机直连的推荐,答案很干脆:一根 QSFP 就够,单根即可跑满官方定义的完整带宽。
既然一根就够快,Mopheus 为什么在生产环境里坚持两根?
最常见的回答是"一根 200G,两根 400G"。这个说法不对。它把一个可靠性问题包装成了带宽问题,而 Mopheus 双线的重点压根不在吞吐:第一根 QSFP 解决的是"两台 GB10 之间怎么高速通信",第二根 QSFP 解决的是"第一根线断了之后怎么办"。
NVIDIA 的单线方案回答的是最简部署与完整高速互联能力;Mopheus 的双线方案在它之上补上了物理链路冗余、故障恢复、双端配置一致性和服务级高可用。两者面向的问题层次不同,不存在谁替代谁。
一、先把 GB10 的 QSFP 网络结构弄清楚
理解一根线和两根线的差别之前,得先解释 GB10 / ConnectX-7 上一个最容易让人犯糊涂的现象:明明只插了一根 QSFP 线,Linux 里为什么能看到两个逻辑网口?
这不是系统识别错了,也不是虚拟出来的假接口,而是 GB10 SoC 与 ConnectX-7 的连接方式决定的。GB10 SoC 和 ConnectX-7 之间走两条独立的 PCIe Gen5 x4 路径;ConnectX-7 对外则提供两个 QSFP 高速物理端口。
单机硬件结构可以抽象成下面这样:
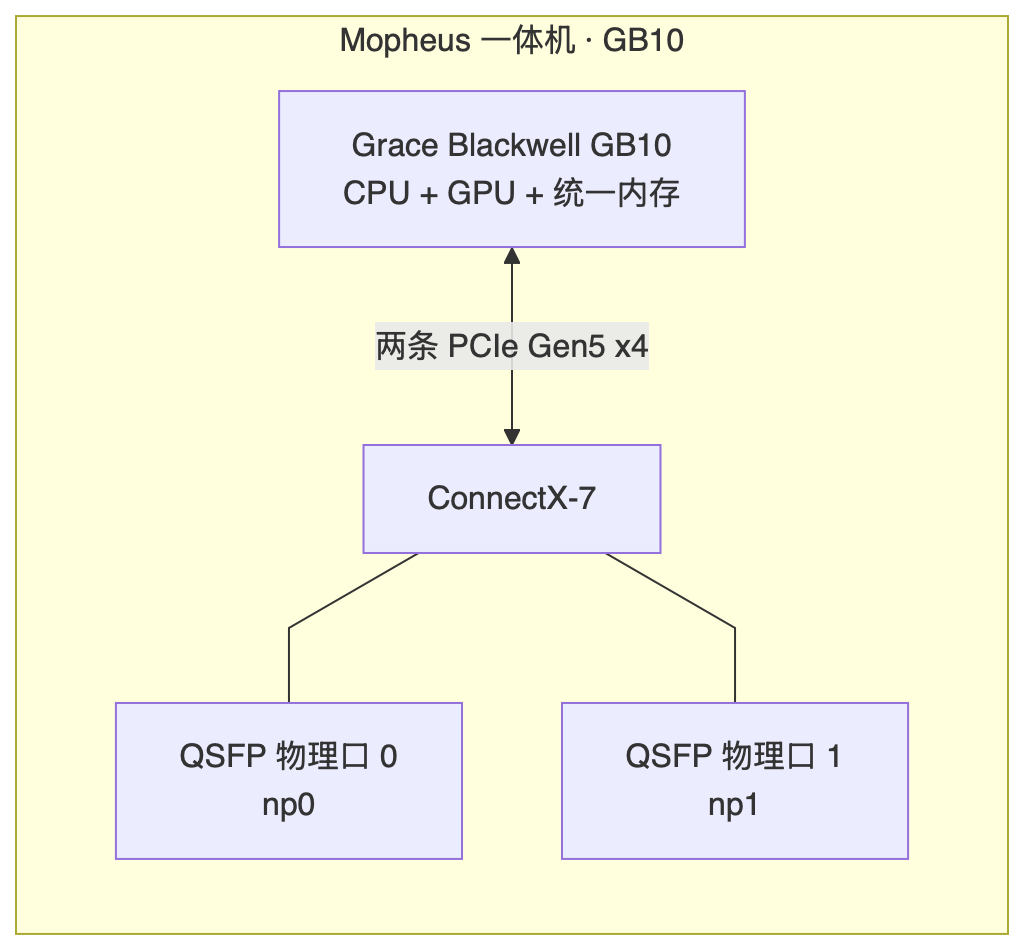
这张图交代了两个事实。一是 ConnectX-7 到 GB10 SoC 的 Host Side 是两条 PCIe Gen5 x4;二是机箱外面有两个 QSFP 口,但外面插几根线,不会让 Host Side 变成四条 PCIe Gen5 x4。
后面很多"单线 200G、双线 400G"的误解,都是从第二点上开始跑偏的。
在 Linux 中执行:
ibdev2netdev
典型输出是:
rocep1s0f0 port 1 ==> enp1s0f0np0
roceP2p1s0f0 port 1 ==> enP2p1s0f0np0
rocep1s0f1 port 1 ==> enp1s0f1np1
roceP2p1s0f1 port 1 ==> enP2p1s0f1np1
表面上是四个逻辑网口,真实对应关系是:
物理 QSFP | Linux Ethernet Interface | RoCE Device |
|---|---|---|
QSFP Port 0 | enp1s0f0np0 | rocep1s0f0 |
QSFP Port 0 | enP2p1s0f0np0 | roceP2p1s0f0 |
QSFP Port 1 | enp1s0f1np1 | rocep1s0f1 |
QSFP Port 1 | enP2p1s0f1np1 | roceP2p1s0f1 |
再往下拆一层:
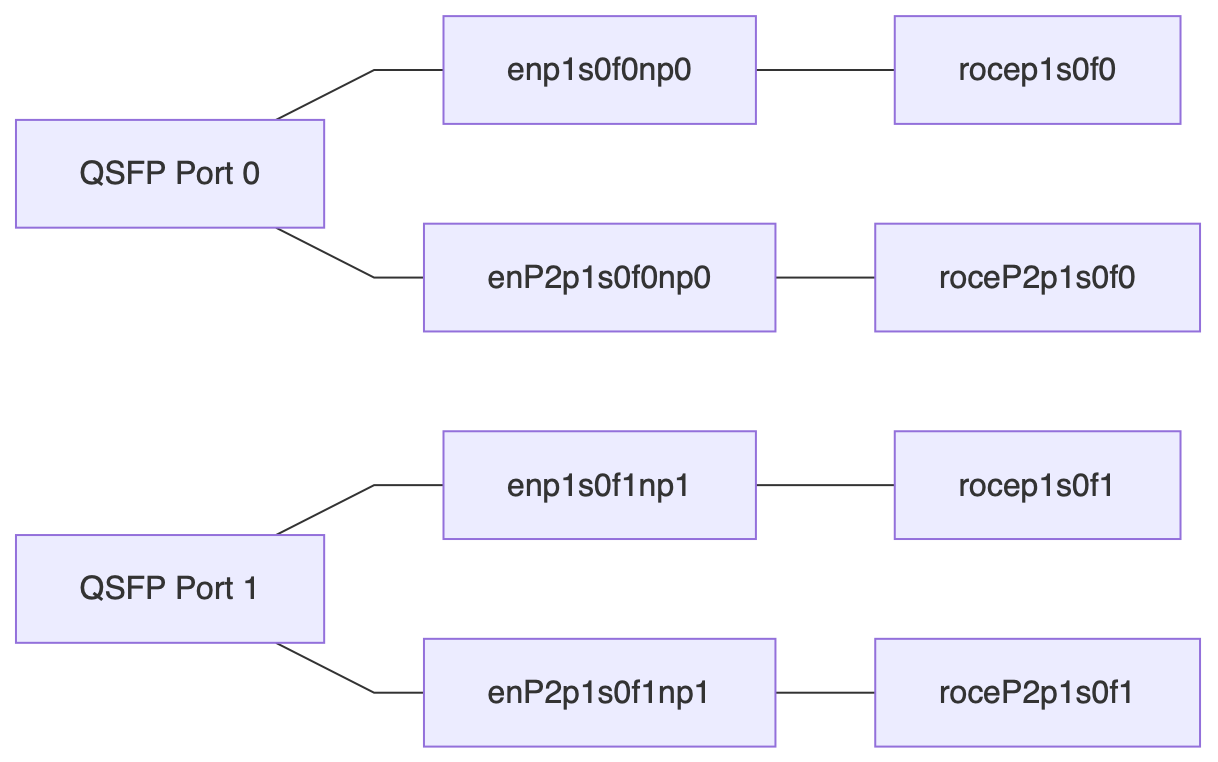
所以最基础的一条常识是:一个物理 QSFP 端口,对应操作系统里的两个逻辑以太网口,同时对应两个 RoCE 设备。
于是:
- 1 根物理 QSFP = 2 个逻辑接口 = 2 个 RoCE 设备
- 2 根物理 QSFP = 4 个逻辑接口 = 4 个 RoCE 设备
单根 QSFP 的实际架构
假设两台 Mopheus 一体机统一使用 QSFP Port 1,那么物理层看起来只有一根线:

但操作系统与 RDMA 软件栈看到的并不是"一个接口",而是这根物理线对应的两条逻辑 Path。这就是单线不能简单理解成"只有一条通信路径"的原因。
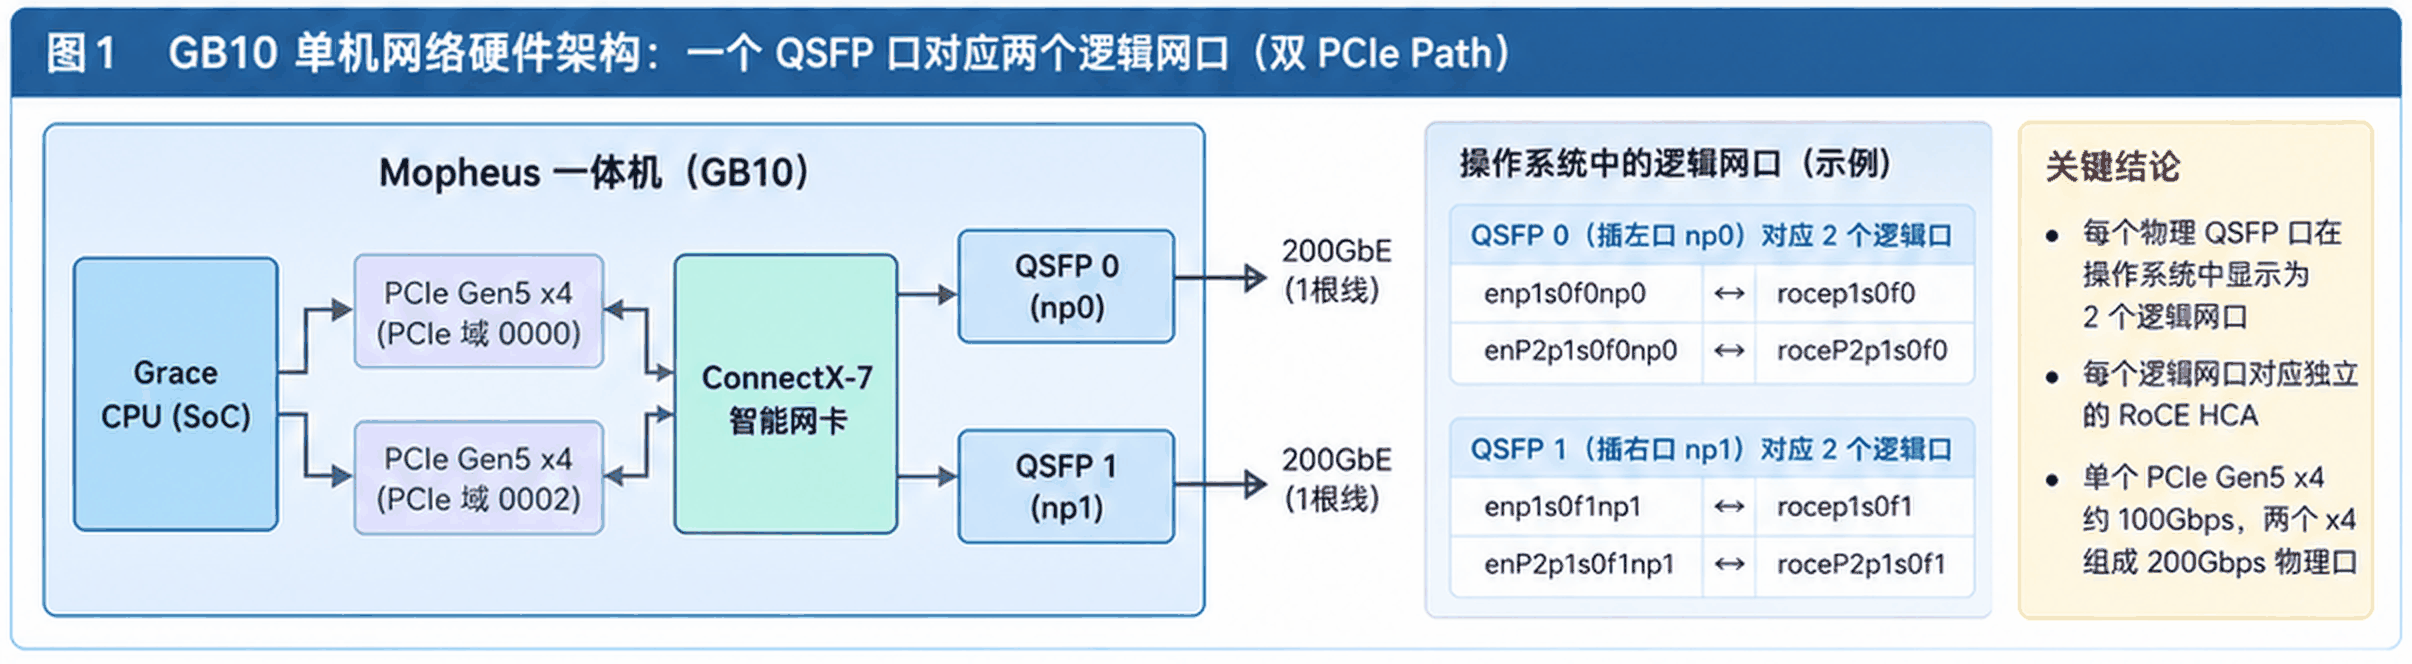
图 1 单机侧的全貌:两条 PCIe Gen5 x4 进 ConnectX-7,两个 QSFP 物理口各对应两个逻辑网口、两个 RoCE HCA。
二、一根线应该怎么配?为什么两台机器总共需要 4 个 IP
一个物理 QSFP 对应两个逻辑接口,工程上就应该把这两个接口都纳入规划。以 QSFP Port 1 为例,两台机器上都会出现这么两组接口:
enp1s0f1np1 enP2p1s0f1np1
rocep1s0f1 roceP2p1s0f1
给两组逻辑 Path 分别配 IP:
- Mopheus A:10.10.1.25、10.10.2.25
- Mopheus B:10.10.1.27、10.10.2.27
双机合计 4 个 IP。架构关系如下:
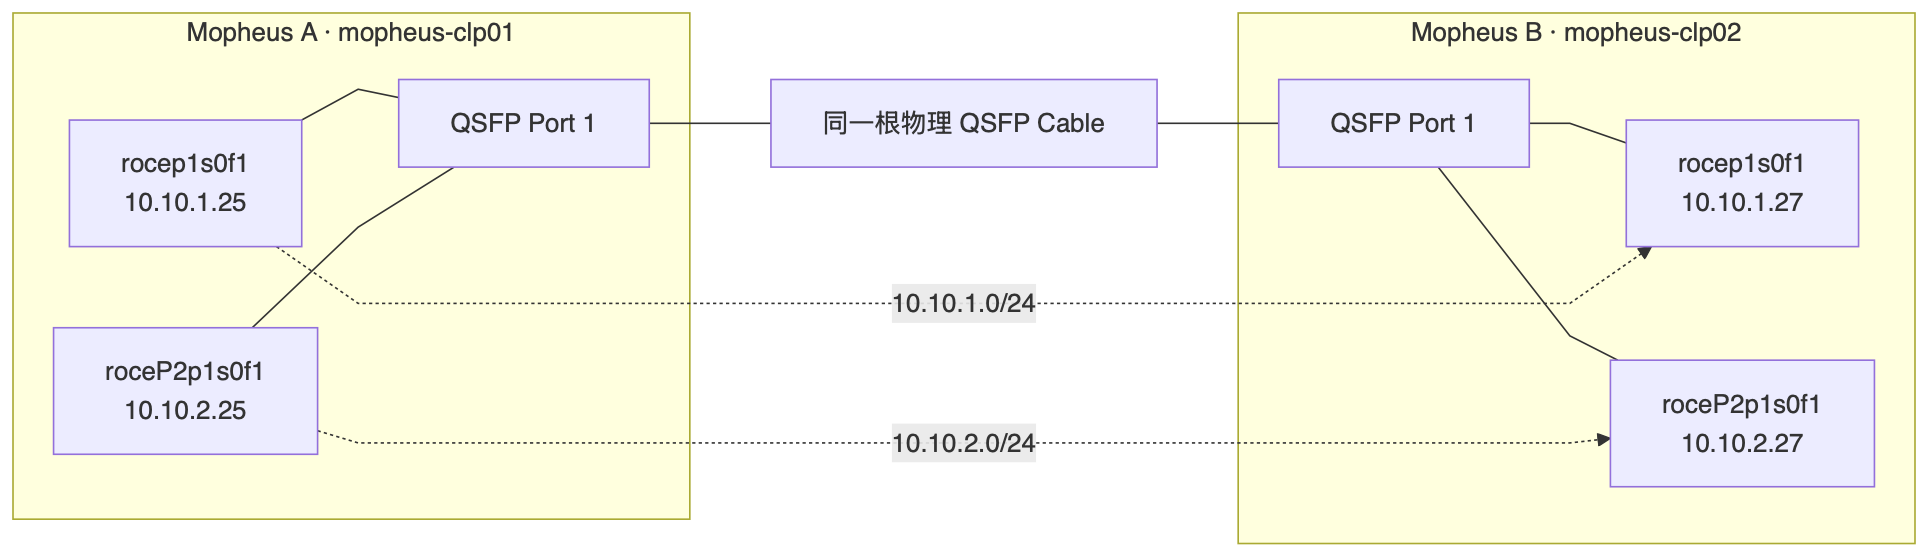
单线模式的账很好算:一根物理 QSFP,Head 侧两个逻辑接口、两个 RoCE 设备、两个 IP,Worker 侧同样两个,双机合计 4 个 IP。
两个接口为什么建议分属不同子网
推荐 10.10.1.0/24 与 10.10.2.0/24 两条独立子网,而不是把所有接口都塞进同一个三层网络。
理由不是"同子网一定会产生广播风暴或网络死锁"——这种说法过于绝对。真正的工程理由是:每个逻辑接口的路由关系更清楚、IP 与 HCA 一一对应、ping -I 排障直观、RDMA 测试容易区分、故障时能立刻判断是哪一条逻辑 Path 出了问题,同时避免多接口处于同一 Layer 3 子网时的源地址选择歧义,也少一些 ARP Flux 和非预期回包路径带来的复杂度。
对于这种双机点对点高速互联,一个逻辑 Path 对应一个独立子网,是最清晰、也最容易运维和排障的划分方式。
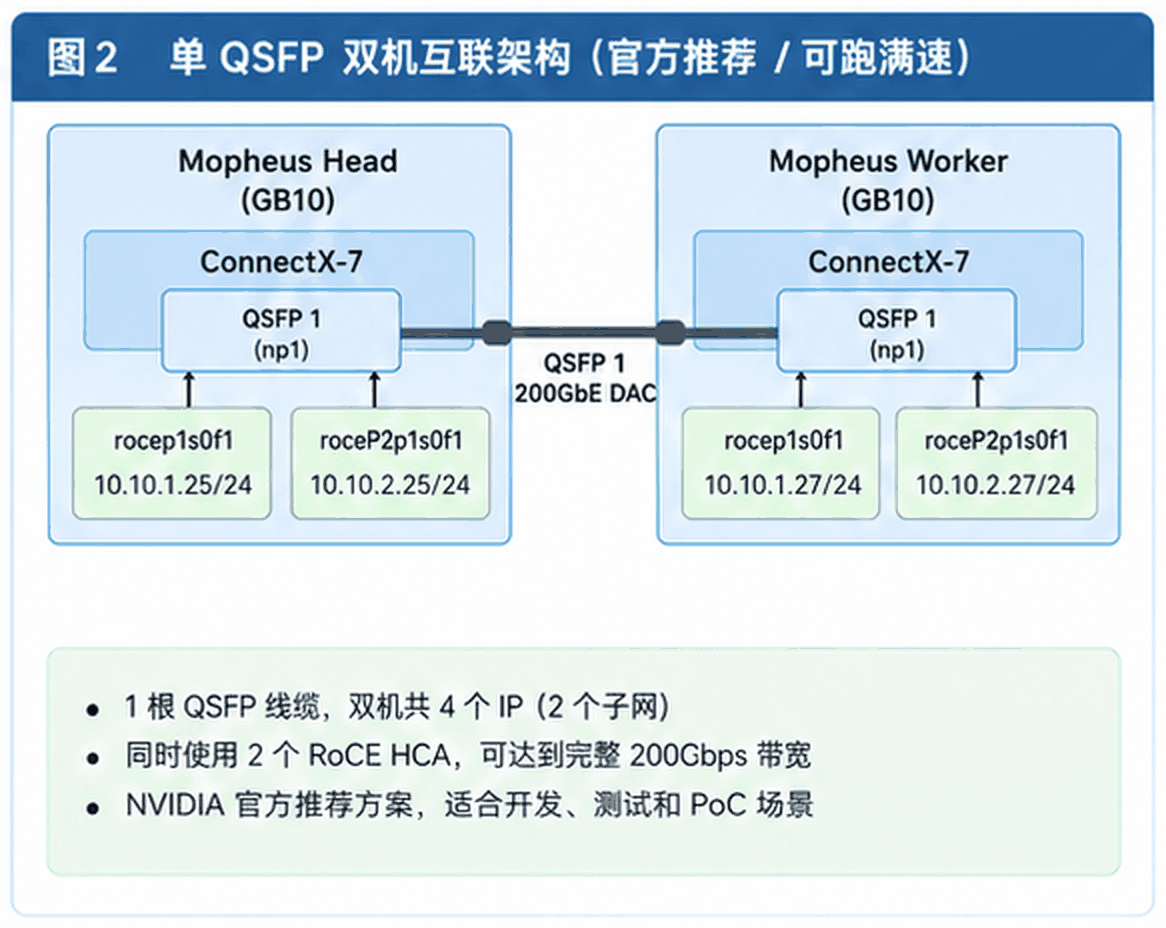
图 2 单线双机互联(以 QSFP Port 1 为例):一根线、两个子网、双机共 4 个 IP,同一物理口上的两个 RoCE HCA 并行工作,即可跑满 200GbE。
三、插两根线之后为什么会看到 4 个接口
两台 Mopheus 之间同时接上 QSFP Port 0 和 QSFP Port 1 之后,每台机器会看到四个逻辑接口:
Port 0:enp1s0f0np0、enP2p1s0f0np0
Port 1:enp1s0f1np1、enP2p1s0f1np1
对应四个 RoCE 设备:
rocep1s0f0、roceP2p1s0f0、rocep1s0f1、roceP2p1s0f1
也就是 2 根物理 QSFP = 4 个逻辑以太网口 = 4 个 RoCE 设备。如果四个逻辑接口都纳入 IP 规划,Head 四个、Worker 四个,双机合计 8 个 IP。一种清晰的规划方式如下:
Cable | RoCE HCA | Head | Worker |
|---|---|---|---|
Cable 0 | rocep1s0f0 | 10.10.1.25 | 10.10.1.27 |
Cable 0 | roceP2p1s0f0 | 10.10.2.25 | 10.10.2.27 |
Cable 1 | rocep1s0f1 | 10.10.3.25 | 10.10.3.27 |
Cable 1 | roceP2p1s0f1 | 10.10.4.25 | 10.10.4.27 |
完整双线拓扑可以表示为:
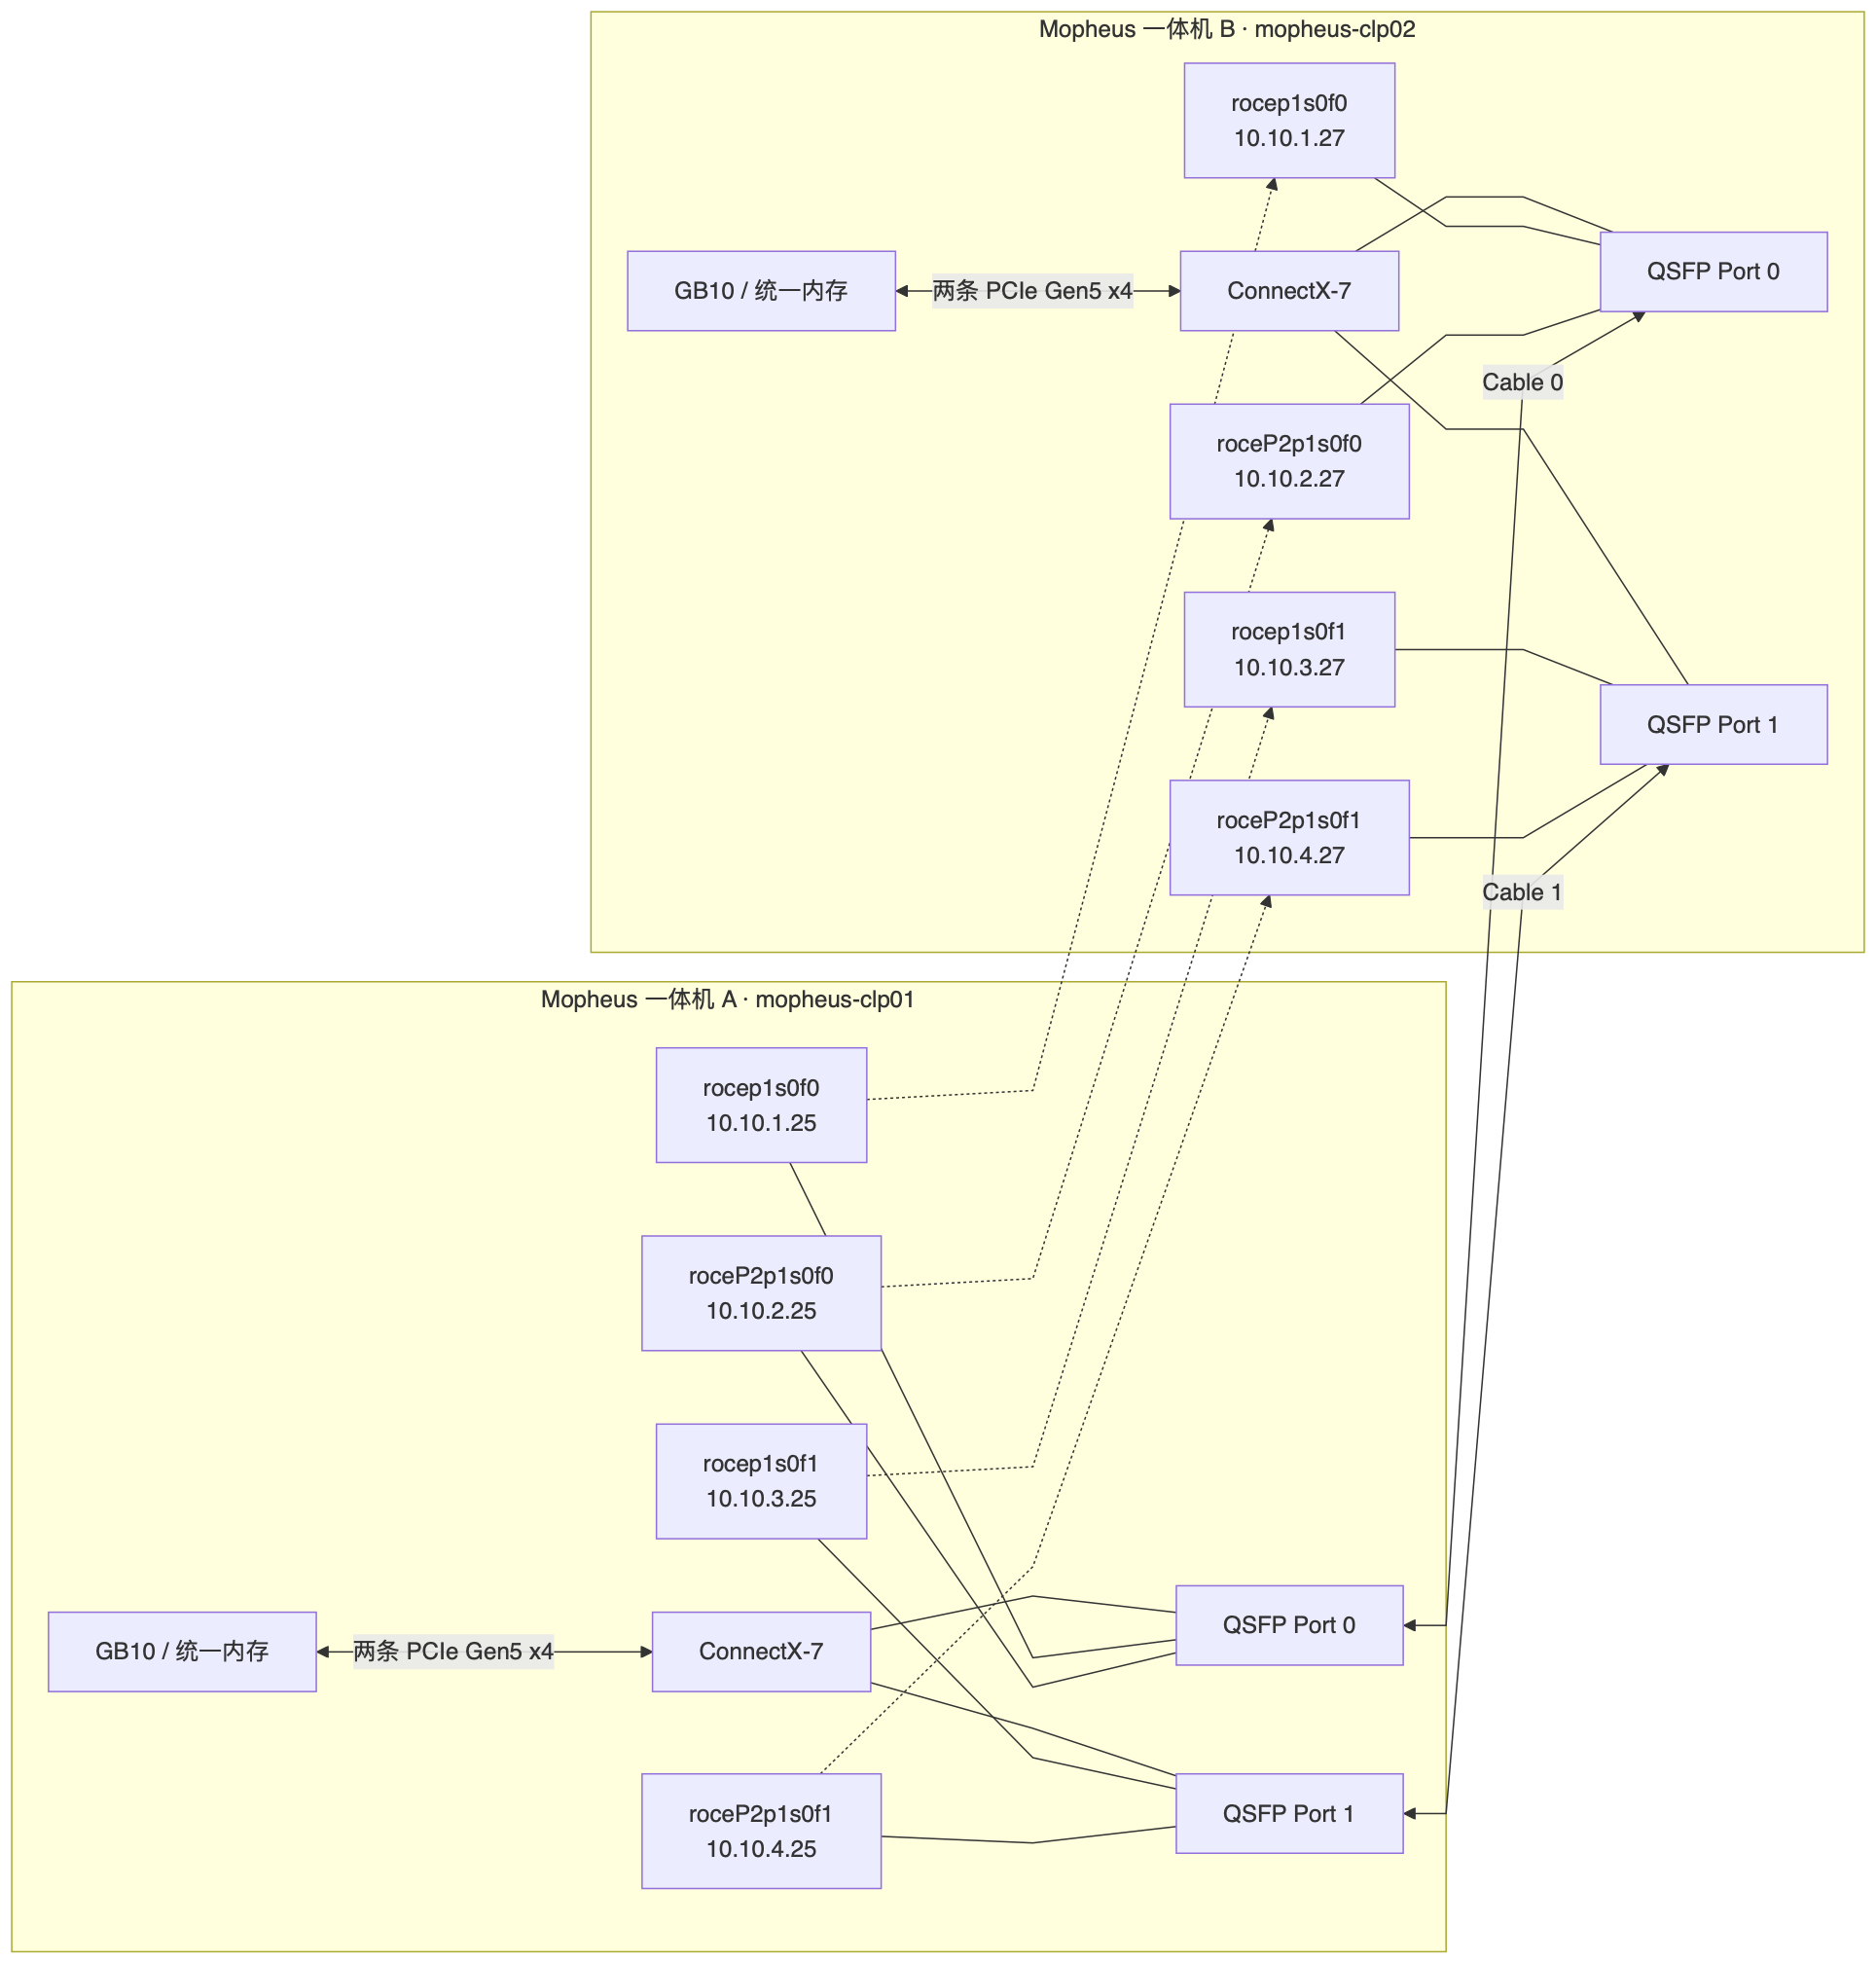
这里有一个必须分清的界限:4 个 RoCE 设备不等于 4 条完全独立的 PCIe Host Rail。 ConnectX-7 到 GB10 SoC 的 Host Side 依旧是两条 PCIe Gen5 x4。插上第二根外部 QSFP,不会把 Host Side 从 2 × PCIe Gen5 x4 变成 4 × PCIe Gen5 x4。
这也是双线不能简单描述成 200G + 200G = 400G Host Bandwidth 的原因。两根线与一根线的真正差别,得往下看。
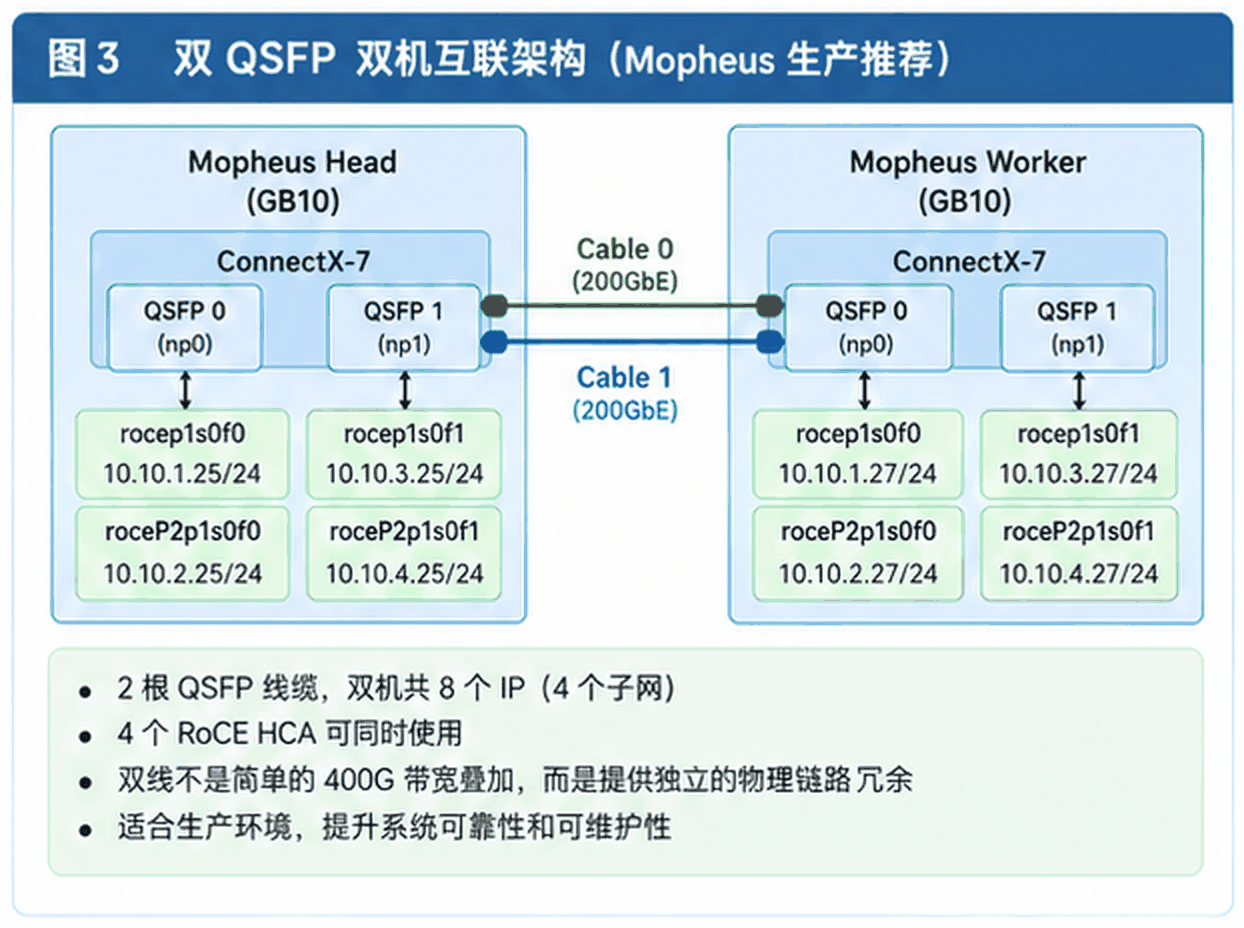
图 3 双线双机互联:两根独立线缆、四个子网、双机共 8 个 IP。增加的是一条独立物理链路,而不是 400G 的简单带宽叠加。
四、既然 NVIDIA 官方说一根线就够,为什么
NVIDIA 官方针对双 Spark / GB10 直连的 Playbook 明确说明:单根 QSFP 即可达到完整带宽。
这个结论的底气,就是前面那条架构事实——一个物理 QSFP 对应两个逻辑以太网口、两个 RoCE 设备。也就是说,单线模式本身并不是"半速配置"。
一根 QSFP 为什么能够跑满
NVIDIA 官方的 RDMA 性能测试会同时使用同一个物理 QSFP 对应的两个 RoCE 设备,例如并行启动两个进程:
ib_write_bw -d rocep1s0f0 ...
ib_write_bw -d roceP2p1s0f0 ...
核心思路是同一根 QSFP 上的两条 RoCE Path 同时参与。
Mopheus 的单线模式遵循同样的思路。port1 模式下的 NCCL_IB_HCA 不是只写 rocep1s0f1,而是写成 rocep1s0f1,roceP2p1s0f1;port0 模式则对应 rocep1s0f0,roceP2p1s0f0。
所以准确的术语是 Single-QSFP / Dual-RoCE-Path,而不是 Single-QSFP / Single-Path。单线丢掉的不是一半能力,它保留了这根物理 QSFP 完整的双 RoCE Path。
五、那么第二根线是不是没有意义
不是,只是它的意义得换个角度理解。
如果环境是开发、测试、PoC、Demo、实验室模型验证这一类,一根 QSFP 已经非常合理:线缆少、IP 少、配置简单、排障简单、有官方支持,配对正确后就能达到平台设计的完整高速互联能力。NVIDIA 推荐单线完全站得住脚。
生产环境问的问题不一样。它不只要问"正常情况下快不快",还要问"这根唯一的高速线坏了以后怎么办"。
单线架构有一个很实在的物理单点:
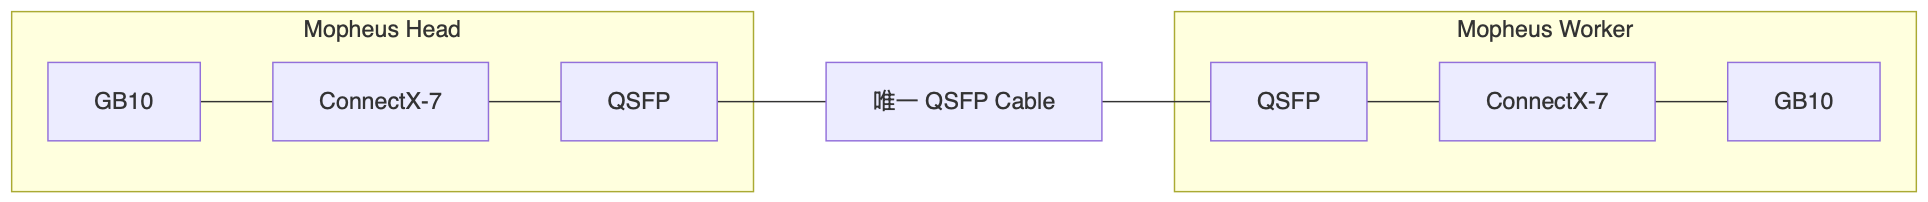
唯一那根物理 Cable 可能遇到的情况太多了:DAC 线缆损坏、接头松动、QSFP Cage 异常、PHY / Carrier 异常、维护时误拔、搬机器清灰理线时被碰松、外部端口硬件故障。这根线一断,两台机器之间就不存在第二条高速物理路径。
这跟 NCCL 配得好不好没有任何关系——因为根本没有第二条路可以走。
六、Mopheus 双线设计的关键在哪里
Mopheus 的双线不是对 NVIDIA 单线方案的否定,恰恰相反,它建立在一个前提上:NVIDIA 已经证明一根线足够快。
既然第一根线的性能职责已经完成,第二根线就不必再补性能,价值可以集中到生产冗余与恢复上。两边要解决的问题可以并列写清楚:
- NVIDIA 单线思路解决的是"如何用最少硬件在两个 GB10 节点之间建立完整的高速互联",答案是 1 根 QSFP + 2 个逻辑接口 + 2 个 RoCE 设备;
- Mopheus 双线思路追加的是"如果唯一这根 QSFP 出现物理故障,双机生产服务怎么办",答案是增加第 2 根独立 QSFP,并建立 dual / port0 / port1 的受控拓扑切换能力。
一句话概括:第一根 QSFP 解决性能问题,第二根 QSFP 解决生产风险问题。
七、Mopheus 双线正常运行架构
正常生产状态下 Cable 0 与 Cable 1 都是 UP,Mopheus 跑在 dual 模式,允许 NCCL 使用四个 HCA:
rocep1s0f0、rocep1s0f1、roceP2p1s0f0、roceP2p1s0f1
整体结构如下:
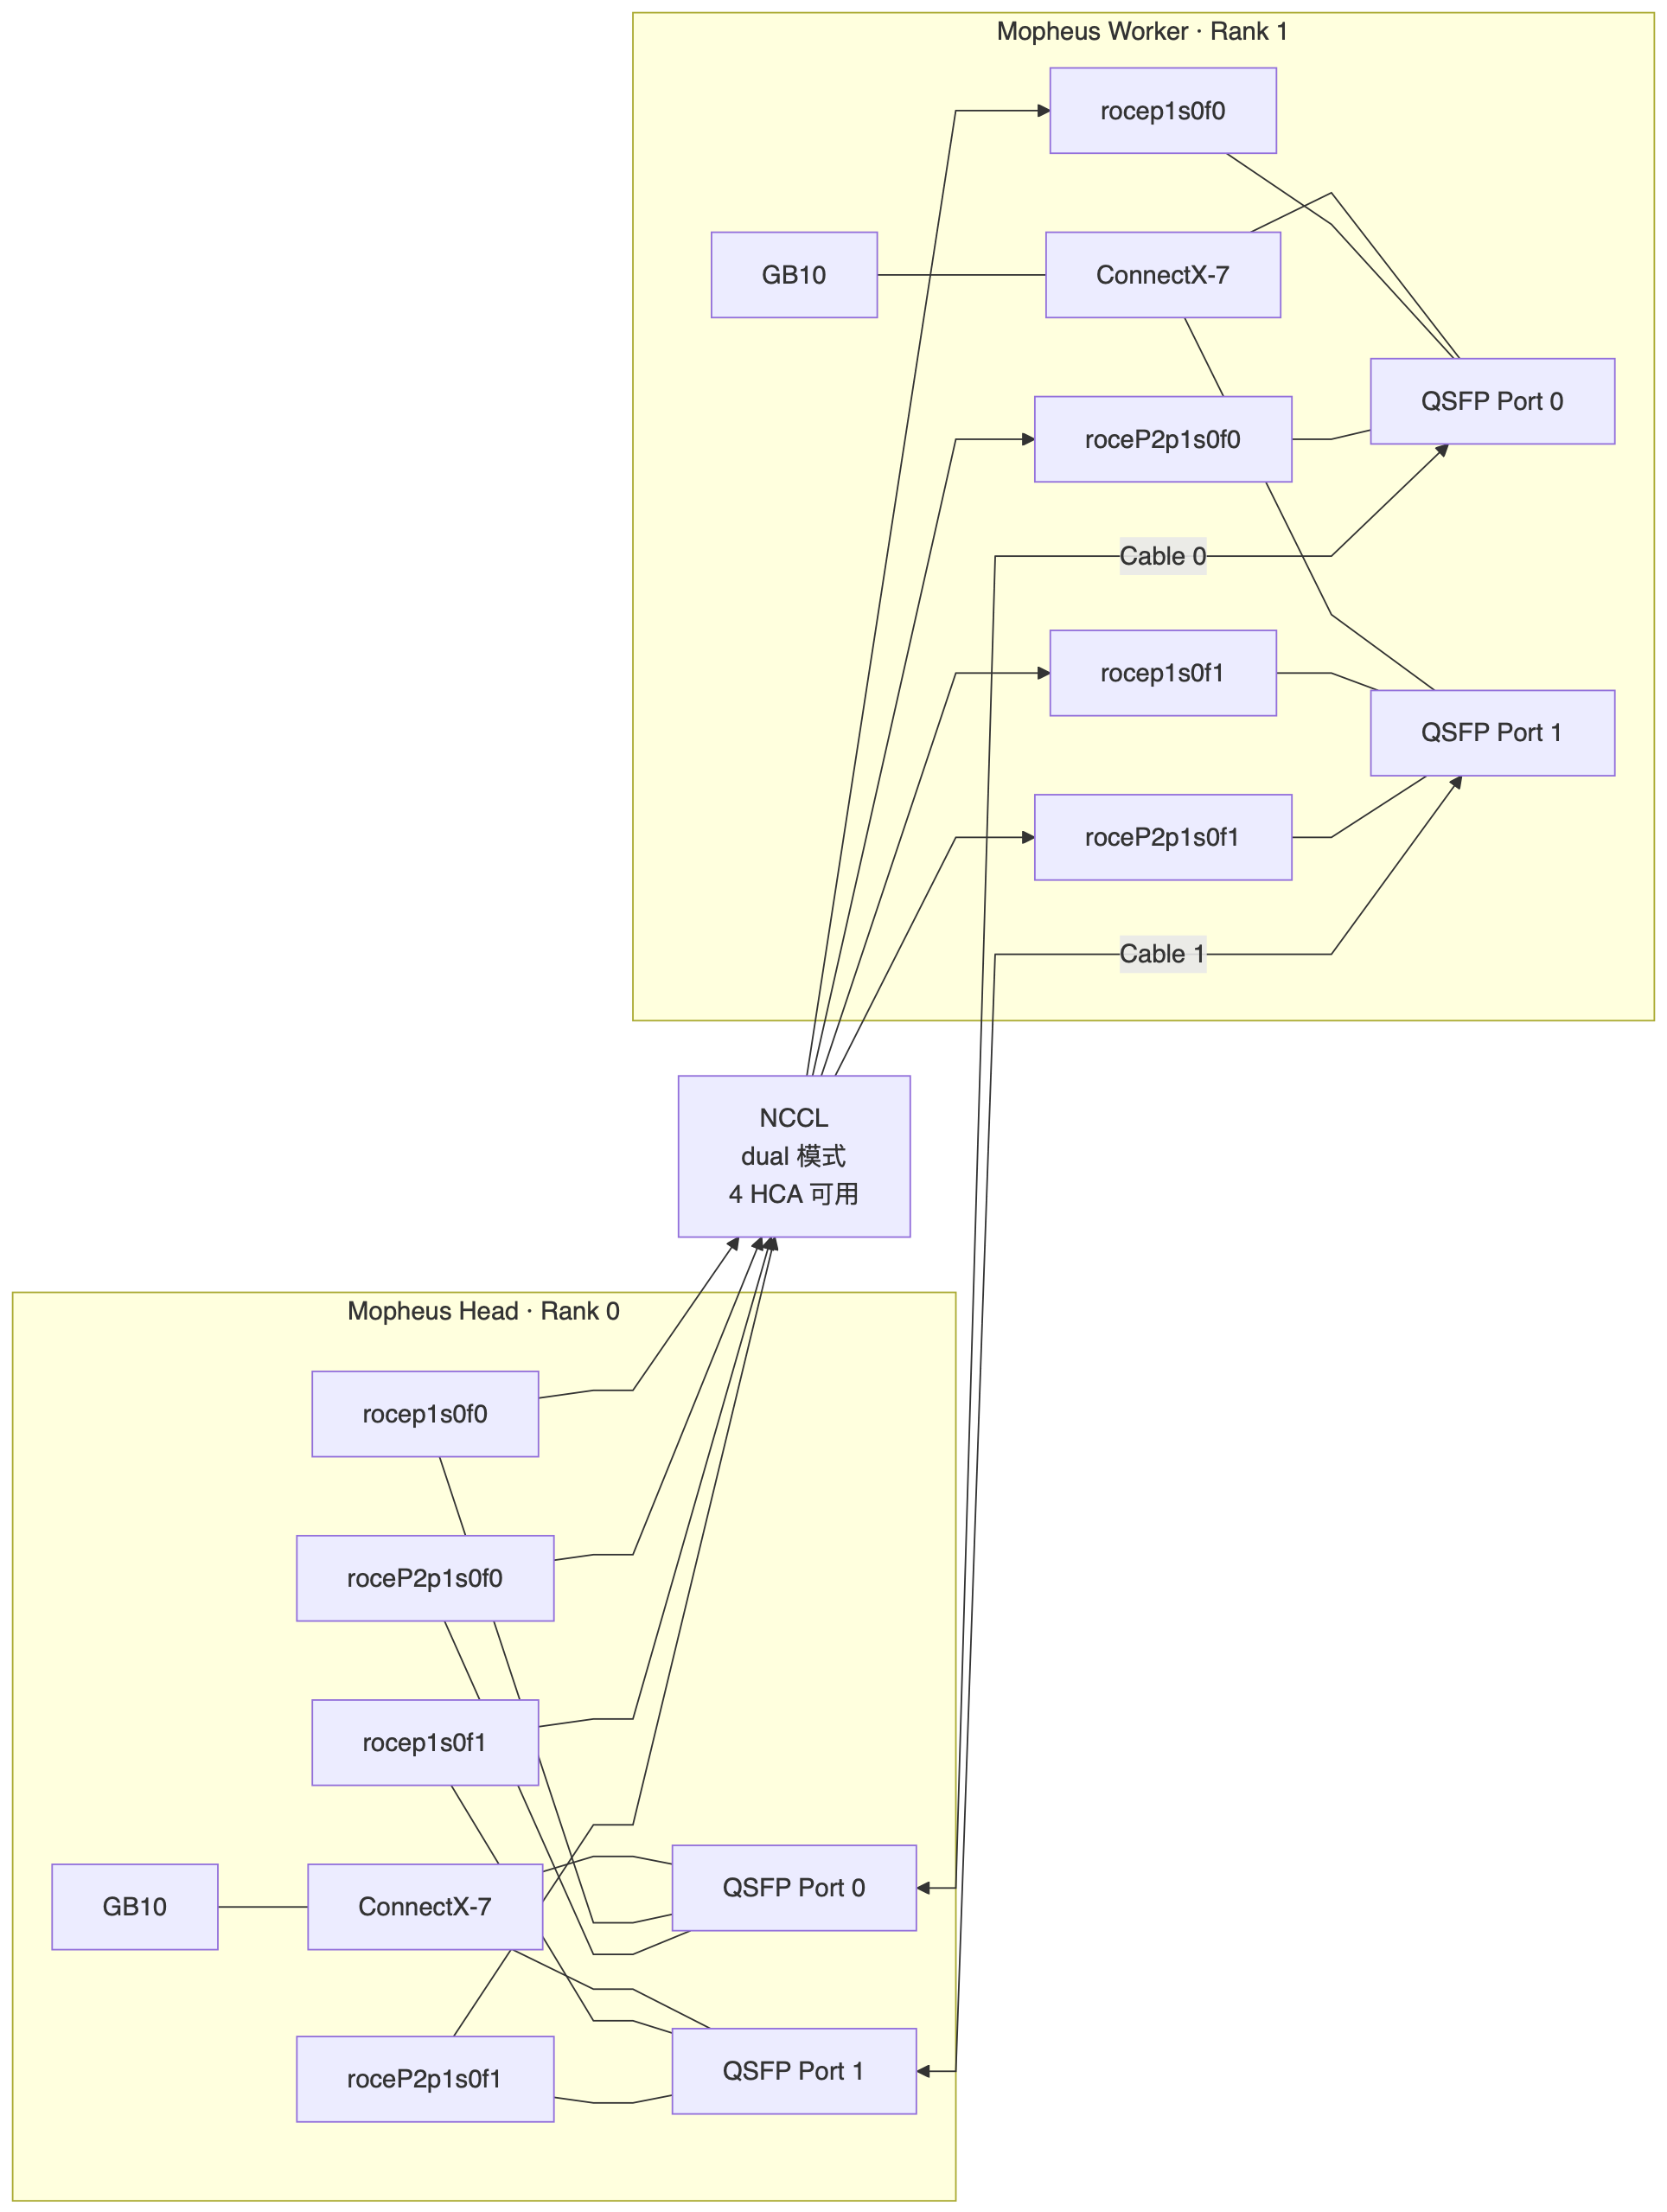
这里真正值得关注的不是"4 HCA"这个数字,而是两个外部物理 Cable 同时存在。其中一条物理路径出故障时,另一条还在,这才是双线真正的生产价值。
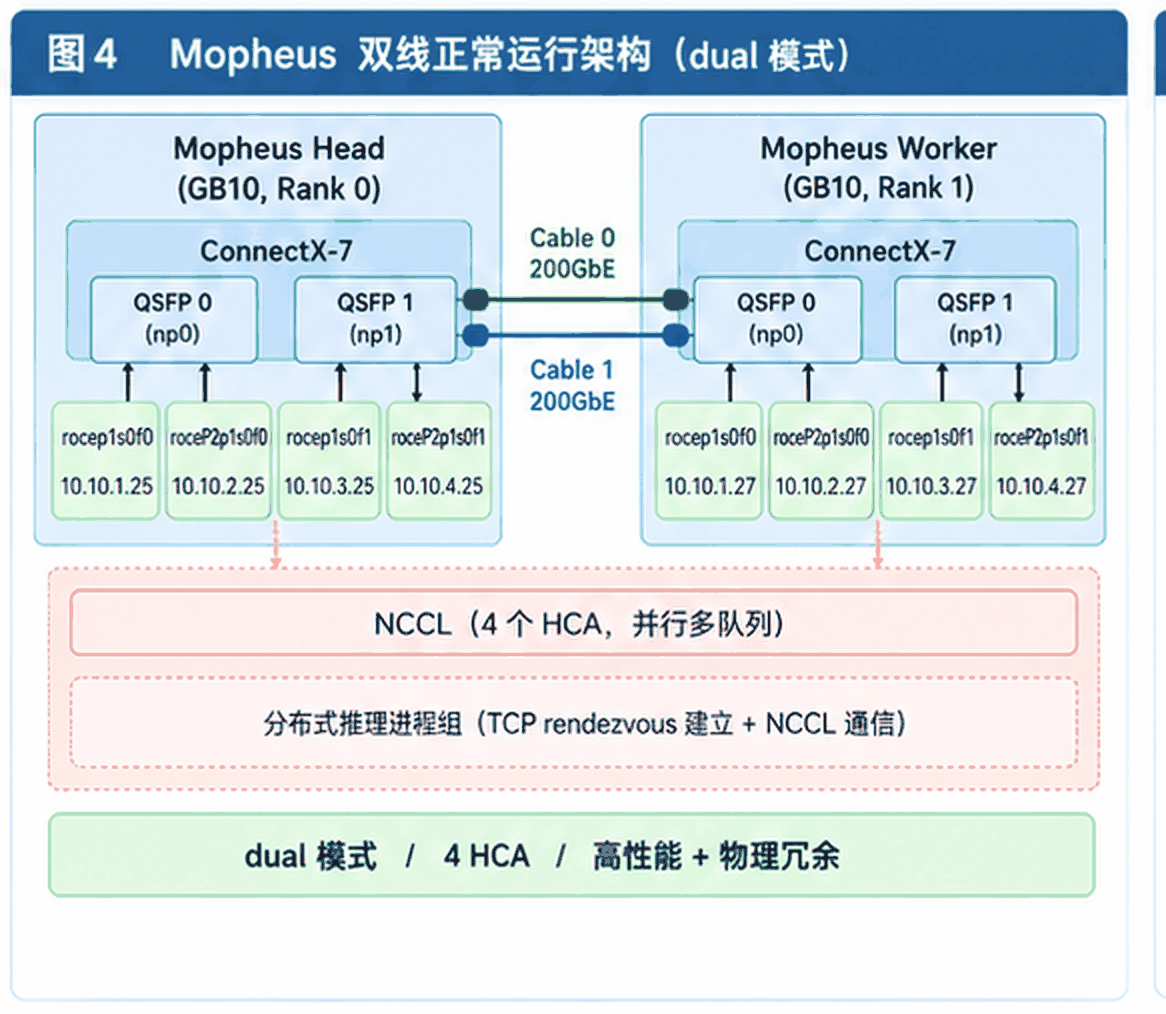
图 4 正常运行时跑 dual 模式:4 个 HCA 并行参与 NCCL,两根物理线缆同时在位。
八、真正的价值:任何一根物理线都能独立承担降级运行
双线最有价值的地方不是正常时多了一根线,而是故障时仍然有路可走。
Cable 0 故障
状态变成 Cable 0 DOWN、Cable 1 UP。此时 Cable 1 仍对应 rocep1s0f1 与 roceP2p1s0f1 两个 RoCE 设备,执行:
./switch_roce_link.sh port1
切换后的架构:
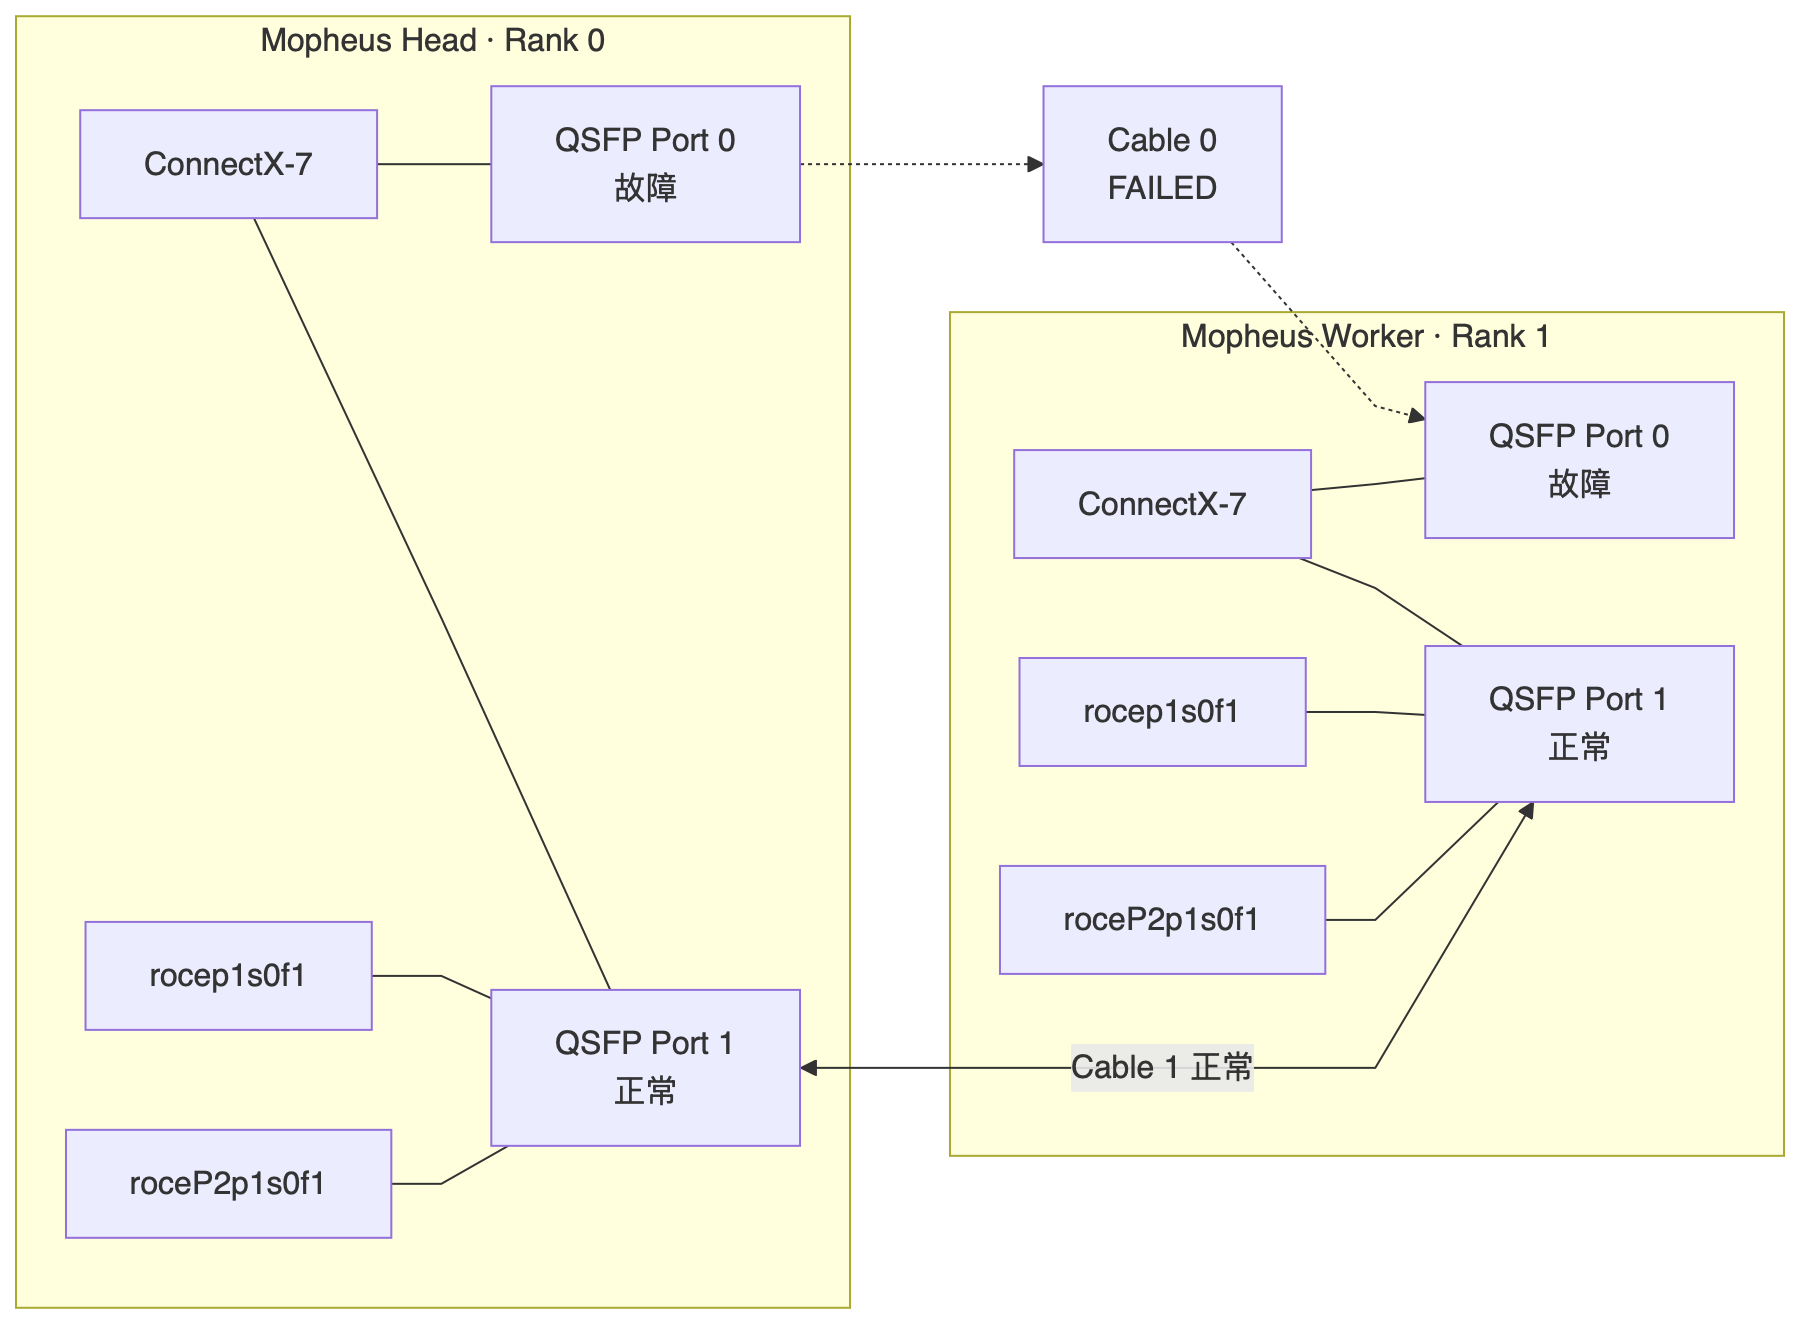
进入 port1 模式后,物理 QSFP 剩一根、RoCE HCA 剩两个,但它仍然是完整的 Single-QSFP / Dual-RoCE-Path,而不是只剩一个光杆 HCA。
Cable 1 故障同理
如果 Cable 0 UP、Cable 1 DOWN,则执行:
./switch_roce_link.sh port0
使用 rocep1s0f0 与 roceP2p1s0f0:
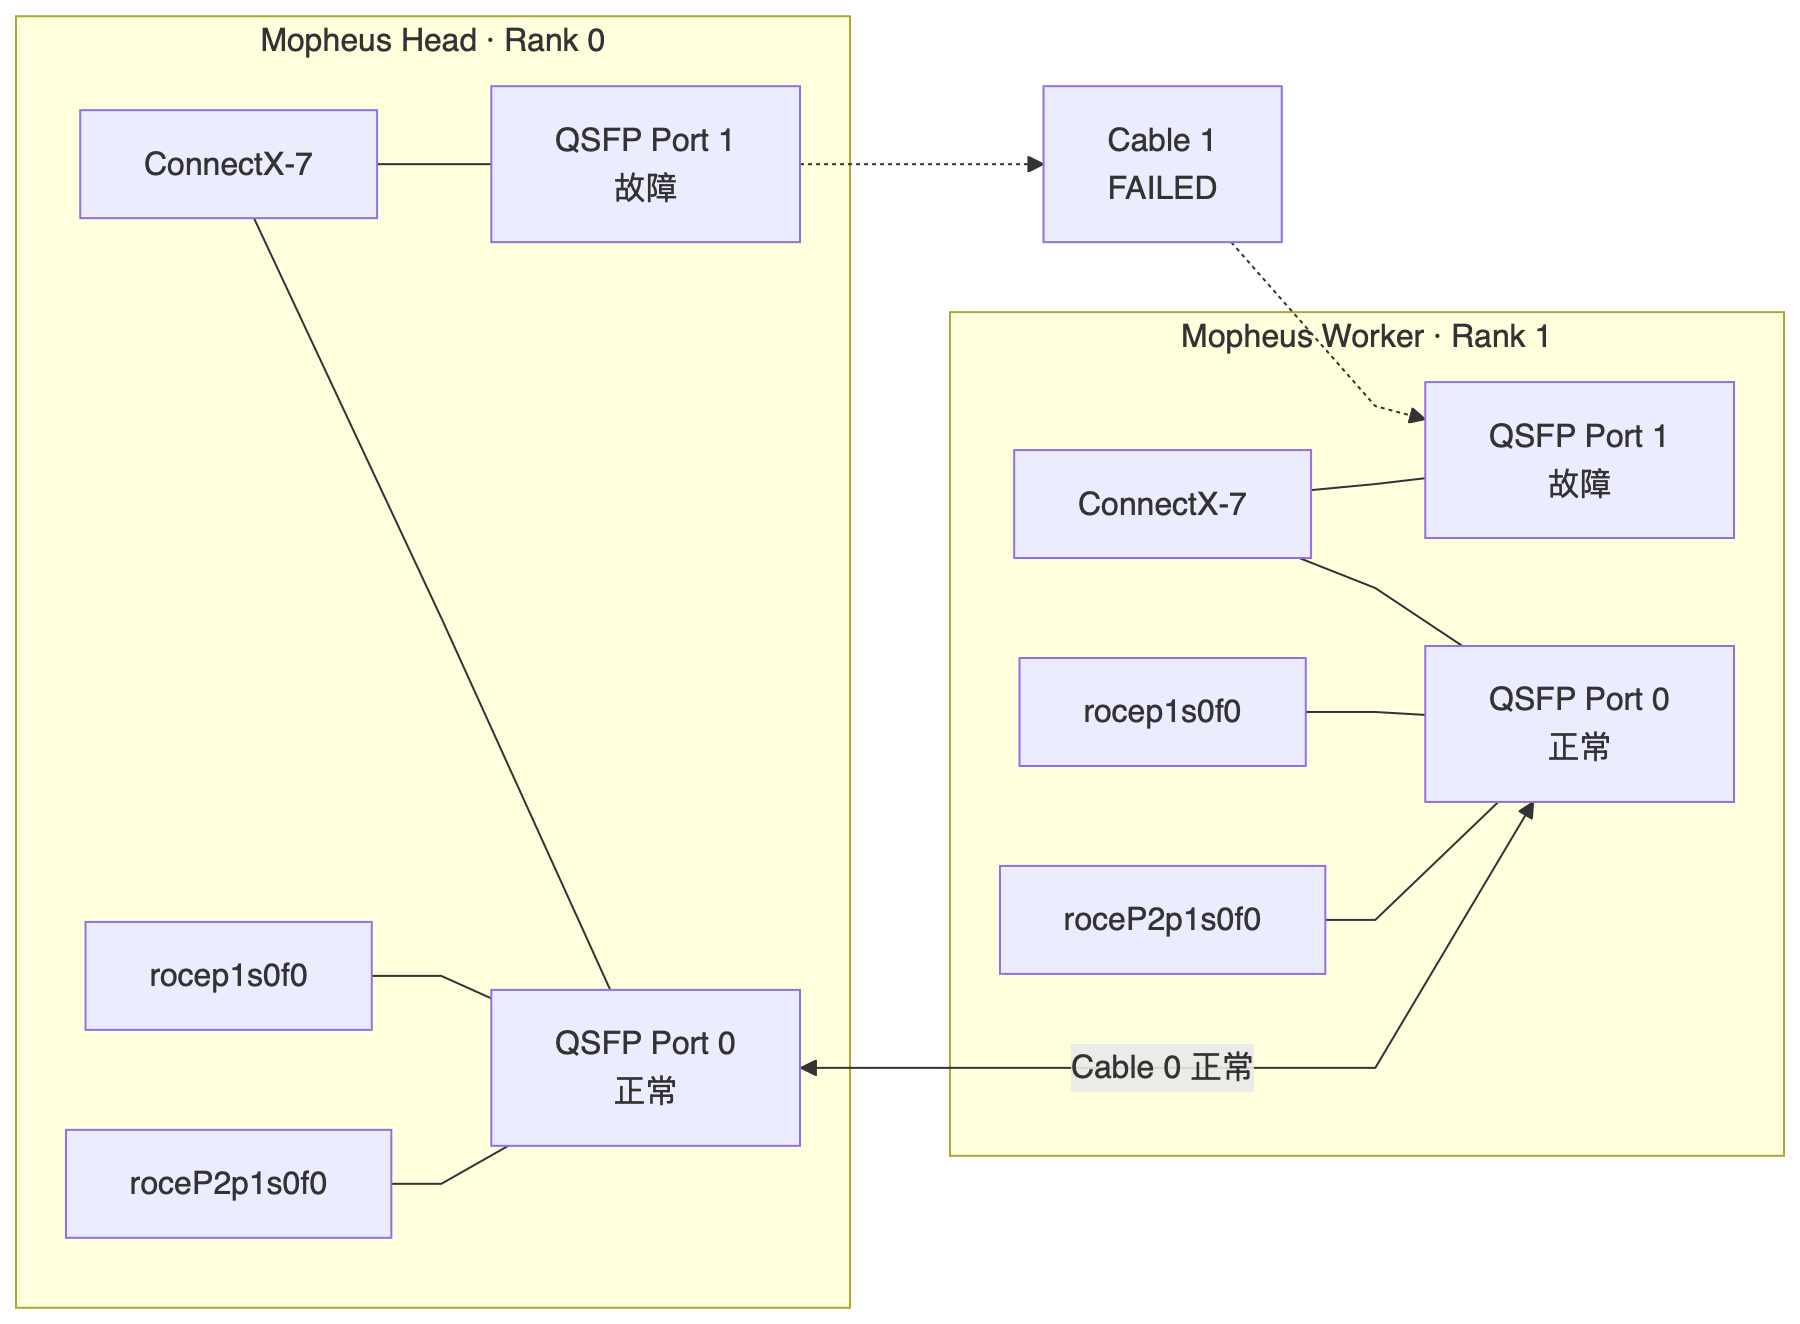
于是 Mopheus 最终形成三个清晰的工作状态:
模式 | Cable 0 | Cable 1 | HCA |
|---|---|---|---|
dual | UP | UP | 4 |
port0 | UP | 不参与 | 2 |
port1 | 不参与 | UP | 2 |
对应关系很简单:正常跑 dual,Cable 0 故障切 port1,Cable 1 故障切 port0,链路修复后再切回 dual。
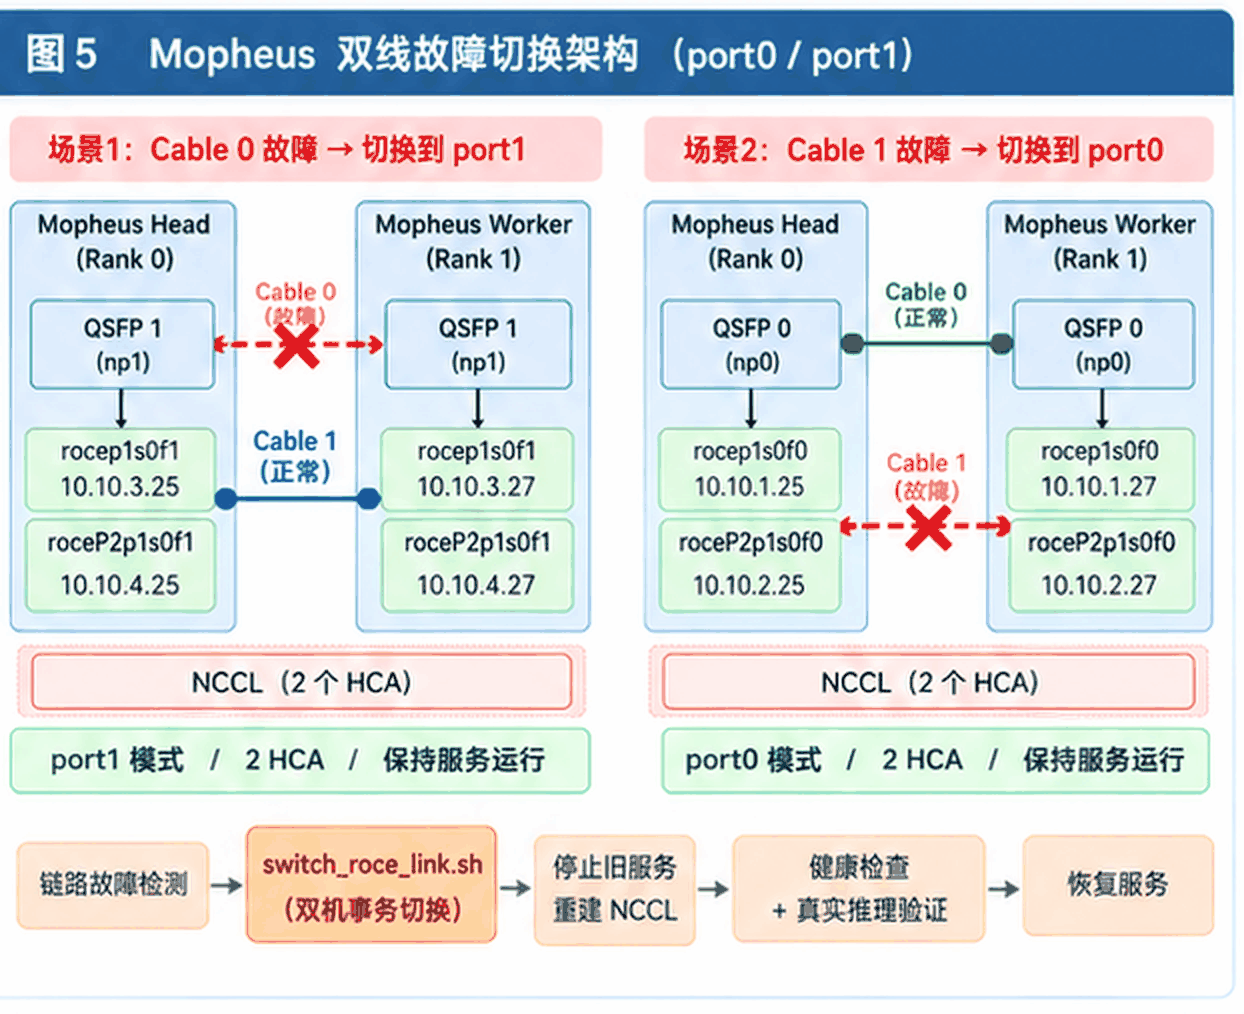
图 5 两种切换场景:Cable 0 故障切 port1,Cable 1 故障切 port0,各自保留 2 个 HCA、服务保持可运行,切换后需重建 NCCL 并做真实推理验证。
九、Mopheus 的巧妙之处不只是"多插了一根线"
如果只是机箱后面多插一根 QSFP,而没有配套的软件机制,第二根线的价值其实非常有限。
因为故障真发生之后,管理员还得自己走一遍:判断哪根物理线异常、判断哪个 HCA 仍然可用、改 NCCL_IB_HCA、改 NCCL_SOCKET_IFNAME、改控制接口、改通信 IP、同步 Head 配置、同步 Worker 配置、停原服务、重建分布式进程组、重建 NCCL、检查模型服务、做真实推理验证。
这些步骤全靠人工完成的话,双线就只是提供了一条备用物理路径,并没有形成生产级的故障恢复体系。
Mopheus 真正有价值的设计是 Dual Cable + Controlled Failover,也就是双物理链路加受控切换,把这根第二物理链路真正纳入了软件控制逻辑。
十、Mopheus 切换脚本做了什么
switch_roce_link.sh 的价值在于,它不是简单修改一个环境变量。它定义了 dual、port0、port1、status 几个明确状态,执行切换时会同步调整一整套通信参数:
NCCL_IB_HCA
NCCL_SOCKET_IFNAME
CONTROL_IF
MASTER_ADDR
HEAD_ROCE_IP
WORKER_ROCE_IP
WORKER_SSH_TARGET
所以它做的并不是"切一张网卡",而是迁移整个双机分布式通信拓扑。整体流程如下:
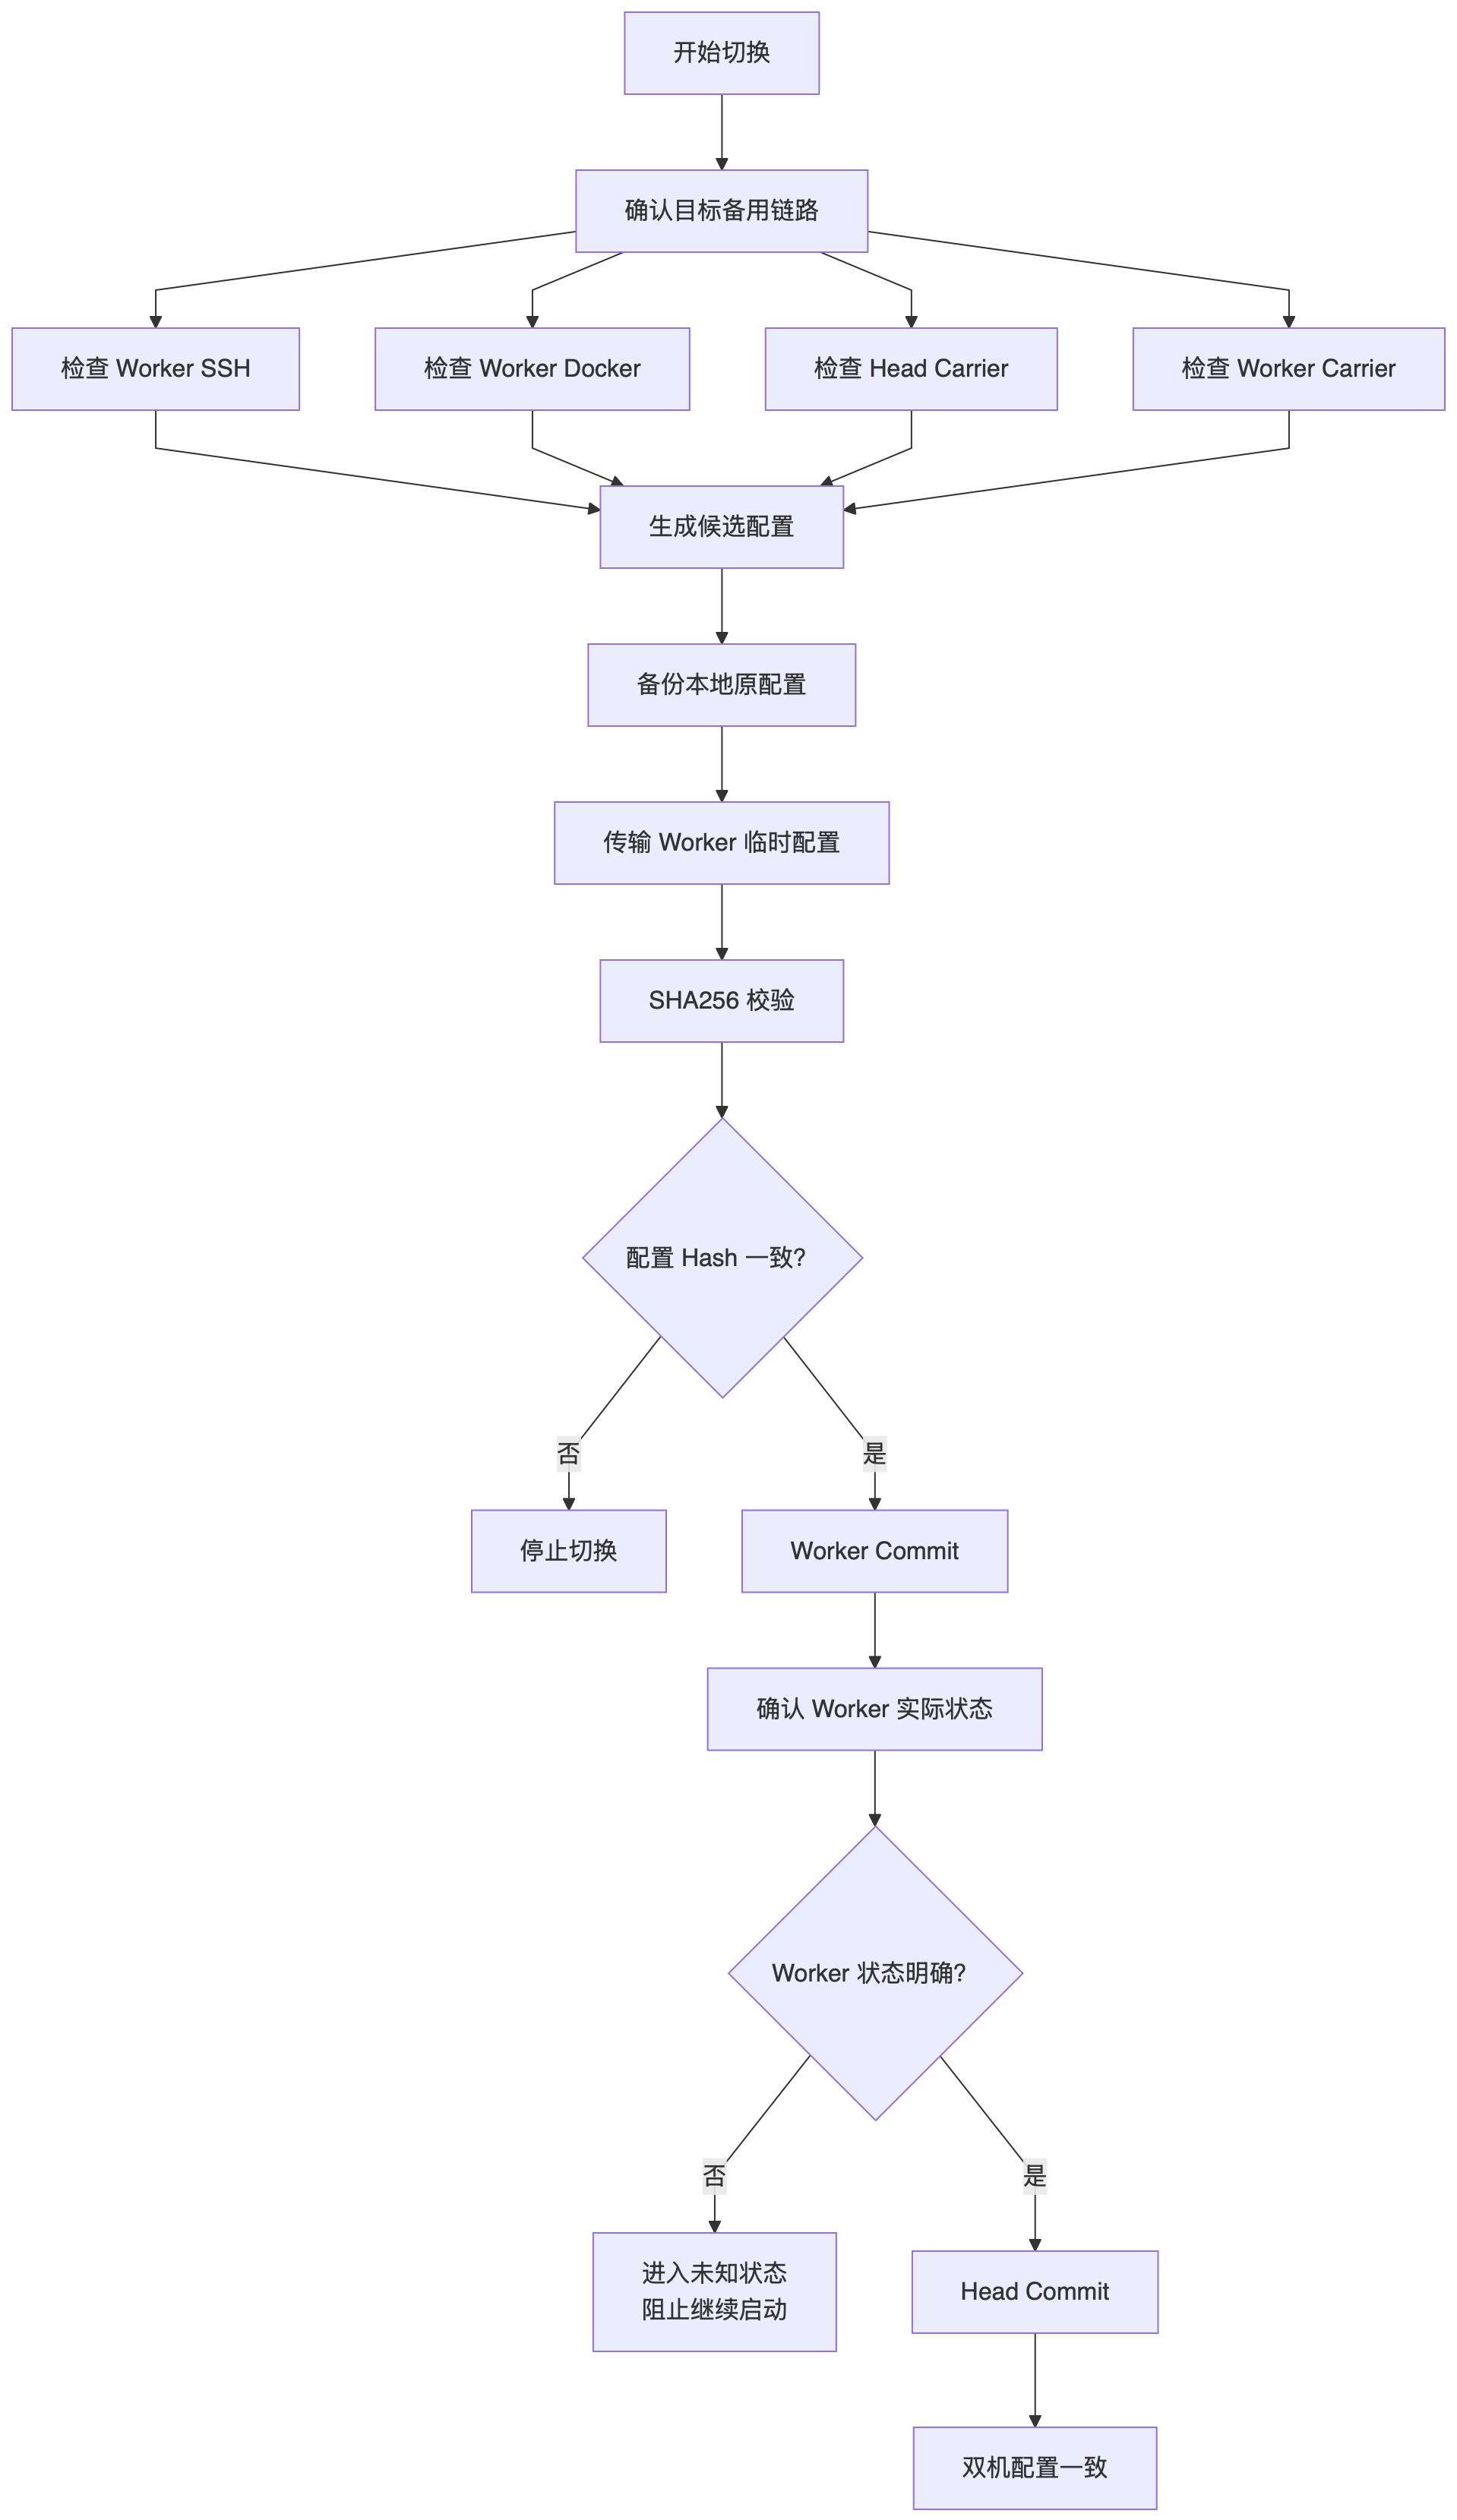
其中几个设计点值得留意。
先验备用链路,再切换。 脚本会检查 SSH 是否可达、Worker Docker 是否正常、Head 与 Worker 对应接口的 Carrier 是否为 1。主链路坏了并不等于备用链路一定健康,切之前先证明备用链路本身是好的,而不是盲目往第二条路上切。
用候选配置,不直接覆盖。 先生成临时配置再校验,降低配置写入失败或中途异常导致状态不一致的风险。
做 SHA256 校验。 本地候选配置与 Worker 临时配置的 Hash 必须一致,借此挡住传输不完整、配置文件损坏、双端文件不一致这几类问题。
Worker commit 之后再确认实际状态。 SSH 返回异常时,脚本不会直接假设 Worker 没有提交,而是重新检查 Worker 当前 .env 的 Hash,判断 Worker 是已经提交、仍是原配置,还是状态无法确认。这比单纯依赖一次 SSH 返回码可靠得多。
十一、为什么这一点对于生产环境特别重要
双机 TP 推理最危险的状态并不是"两边都失败",而是 Head 和 Worker 对通信拓扑的理解不一致。比如 Head 认为跑在 port1、Worker 认为跑在 port0,或者一端 dual、另一端 port1。
这种状态下会出现一系列连锁反应:NCCL bootstrap 失败、RDMA Connection 无法建立、communicator 初始化超时、Rank 之间互相等待、服务反复启动失败、一端认为链路存在而另一端认为不存在,最终整个双机集群卡在一个难以判断的中间状态。
这类故障本质上属于 Configuration Split Brain,也就是配置脑裂。
所以生产级切换不能只是"Head 改配置、Worker 改配置、然后重启"这样的操作序列,而必须保证双端配置形成一个一致的提交结果。
Mopheus 脚本在无法确认 Worker 实际状态时会进入高风险状态并停止后续操作,而不是贸然启动。这是典型的 Fail Closed——状态不明确时宁可停止,也不带着未知配置继续运行。对生产分布式系统来说,这比"先跑起来再说"安全得多。
十二、切换为什么需要重启推理服务
既然 Cable 1 还活着,为什么不能直接把 NCCL 从 Cable 0 切过去、业务完全不停?
因为双机大模型的通信不是普通 TCP 长连接。Rank 0 和 Rank 1 之间持续进行 AllReduce、AllGather、ReduceScatter、Tensor Parallel 同步这类分布式 collective,NCCL communicator 在建立时就已经按照当时的可用 HCA、网络拓扑、接口可达性、Bootstrap 信息和 Rank 信息完成了通信资源初始化。底层 RDMA Path 在 collective 过程中断掉,原 communicator 很可能已经进入异常状态。
这时候可靠的做法是确定新的健康拓扑、停止旧服务、重新启动 Rank、重新进行 TCP rendezvous、重新建立 NCCL communicator。所以 Mopheus 脚本会执行:
./stop.sh
./start.sh both
这么做是为了让切换后的通信状态重新回到一个确定、干净、可验证的起点。指望在 collective 跑到一半时把底层链路悄悄换掉、还假设 communicator 能接着用,风险远大于收益。
十三、为什么不强求网络层"零中断"
所谓 Cable 0 一挂、当前请求完全无感、Token 继续生成、NCCL 自动瞬间走 Cable 1,这种能力叫 Hitless Failover,无损瞬时切换。Mopheus 当前方案不应该按这个口径宣传,它更准确的定义是 Service-Level Controlled Failover,即服务级受控故障恢复。
完整过程是:物理链路异常 → 确认备用物理路径 → 同步新的双机通信配置 → 停止原 NCCL 集群 → 按新拓扑重新启动 → 重新建立 communicator → 检查服务 → 验证模型 → 恢复业务。
为什么不强求"零中断"?因为生产系统真正在意的不是"看起来完全无感",而是状态是否确定、切换结果是否可验证、双端是否一致、恢复过程是否可重复、故障后是否存在明确的恢复路径。
对于 TP=2 这种强依赖跨机 collective 的模型服务来说,可预测、可验证的恢复,比不确定的透明切换更重要。
因此更严谨的表述是:单根 QSFP 故障后,系统仍保留另一条完整高速物理链路,可以通过受控重建恢复双机推理服务,而不必等待故障物理链路维修完成后才能重新提供服务。
十四、恢复之后不仅检查网络,还验证模型真的能回答
Mopheus 切换脚本有一点值得单独说:它并没有把"网线通了"当成"系统恢复了"。
网络恢复其实要分几层看:
层级 | 检查项 | 能说明什么 |
|---|---|---|
物理层 | carrier = 1 | 物理链路是 Up 的 |
IP 层 | ping 通 | IP 网络可达 |
容器层 | docker ps | 进程存在 |
API 层 | /health 返回 HTTP 200 | API Server 已经对外响应 |
模型推理层 | 实际调用 POST /v1/chat/completions 并拿到输出 | Rank 0 / Rank 1、TCP rendezvous、NCCL communicator、模型权重、Tensor Parallel、推理框架、API 全部正常 |
前四层都只是必要条件。只有真正发一个推理请求、并且拿到模型返回,才能说明整套双机服务真的活了。
所以 Mopheus 脚本在 /health 之后继续发送真实推理请求并校验返回内容,是有价值的,这属于端到端大模型功能验证(End-to-End LLM Functional Verification)。它要回答的问题是:整套双机大模型服务真的恢复了吗?
十五、所以一根线和两根线到底该怎么理解
到这里可以把两种方案摆在一起看。
一根线
一根 QSFP 的本质是 1 × 物理 QSFP = 2 × 逻辑以太网口 = 2 × RoCE 设备,双机通常需要 4 个 IP。配置正确之后,它已经能够完成完整的高速双机互联。
优点是官方支持、配置简单、网络规划简单、线缆少、IP 少、排障容易,非常适合开发、测试、PoC。缺点也很直接:唯一的物理 QSFP 是明显的单点故障,一旦那根 Cable 出问题,双机之间就没有第二条高速恢复路径。
两根线
两根 QSFP 的本质是 2 × 物理 QSFP = 4 × 逻辑以太网口 = 4 × RoCE 设备,双机通常需要 8 个 IP。正常时跑 dual、4 个 HCA;单 Cable 故障后切到 port0 或 port1,继续保留一根完整 QSFP 加上两个 RoCE HCA。
它的价值落在双物理链路、可降级运行、可恢复的生产服务上,而不是"400G"这个数字。
最终对比:
项目 | 单 QSFP | Mopheus 双 QSFP |
|---|---|---|
物理 Cable | 1 | 2 |
Linux 逻辑接口 | 2 | 4 |
RoCE Device | 2 | 4 |
双机典型 IP 数 | 4 | 8 |
能否双机高速推理 | 可以 | 可以 |
单线能否达到官方完整高速能力 | 可以 | — |
双线是否天然等于 400G Host BW | 否 | 否 |
单 Cable SPOF | 存在 | 显著降低 |
单 Cable 故障后是否还有高速物理路径 | 没有 | 有 |
是否支持单线降级 | 不涉及 | 支持 |
是否有 dual / port0 / port1 | 不涉及 | 有 |
是否具备双机配置一致性机制 | 不涉及 | 有 |
是否支持 NCCL 重建 | 不涉及 | 有 |
是否进行健康检查 | 不涉及 | 有 |
是否进行真实模型推理验证 | 不涉及 | 有 |
配置复杂度 | 低 | 较高 |
最适合场景 | 开发 / 测试 / PoC | 正式生产 |
十六、最后回答最核心的问题
NVIDIA 为什么推荐一根
因为它要解决的是如何用最简单、最少的硬件,建立两个 GB10 节点之间的完整高速互联。一根 QSFP 加两个逻辑接口、两个 RoCE 设备,已经能够做到这一点。
从性能、成本、配置复杂度、部署效率几个维度看,一根 QSFP 都完全合理,尤其适合开发、测试、PoC、Demo 和实验室环境。NVIDIA 推荐单线没有任何问题。
Mopheus 为什么仍然推荐生产环境两根
因为生产环境不能只考虑"正常时能跑",还必须考虑"异常时怎么恢复"。
单线环境下,一个 Cable Failure 就等于唯一的高速互联路径消失;双线环境下,Cable 0 故障时 Cable 1 仍然存在,Cable 1 故障时 Cable 0 仍然存在。
再叠加软件层的 dual / port0 / port1 状态、备用链路健康检查、双机配置事务同步、Hash 校验、配置一致性保护、NCCL 重建、/health 检查和真实 LLM 推理验证,才形成完整的生产可恢复性(Production Recoverability)。
所以 NVIDIA 单线方案和 Mopheus 双线方案不是谁对谁错,只是目标不同:NVIDIA 求最简、完整、高速;Mopheus 在此基础上进一步提升生产可靠性。
结语:第一根线解决性能,第二根线解决生产风险
如果整篇只记一句话,那就是:
对于 GB10 双机而言,一根 QSFP 已经足够实现 NVIDIA 官方定义的完整高速互联能力;Mopheus 在生产环境增加第二根 QSFP,不是因为第一根线不够快,而是为了避免唯一高速物理链路成为单点故障。
再压缩一层:第一根 QSFP 解决"两台 GB10 怎么高速通信",第二根 QSFP 解决"第一根 QSFP 坏了以后怎么办"。
Mopheus 真正完整的形态不是"2 根线",而是这一整套能力:单线满速能力 + 双线物理冗余 + dual / port0 / port1 受控切换 + 双端配置一致性 + 可控的 NCCL 重建 + 健康检查 + 端到端大模型验证。
单线已经够快,双线让生产更可靠。Mopheus 的双线设计不追求那个容易误导人的"400G"数字,它的目标是把 GB10 双机互联从"正常状态能工作",提升到"出现单链路故障之后仍然有另一条高速物理路径,并且能够通过受控、可验证的方式恢复生产服务"。
参考资料
- NVIDIA DGX Spark / GB10 双机高速互联与 ConnectX-7 网络架构相关官方文档。
- NVIDIA Connect Two Sparks Playbook。
- NVIDIA 双 Spark RDMA Performance Benchmarking Guide。
- NVIDIA NCCL 官方文档。
- Mopheus switch_roce_link.sh 双机 RoCE 链路受控切换脚本。