

靴子落地,Amazon 收购 DuckLabs 后的第一个产品正式发布。
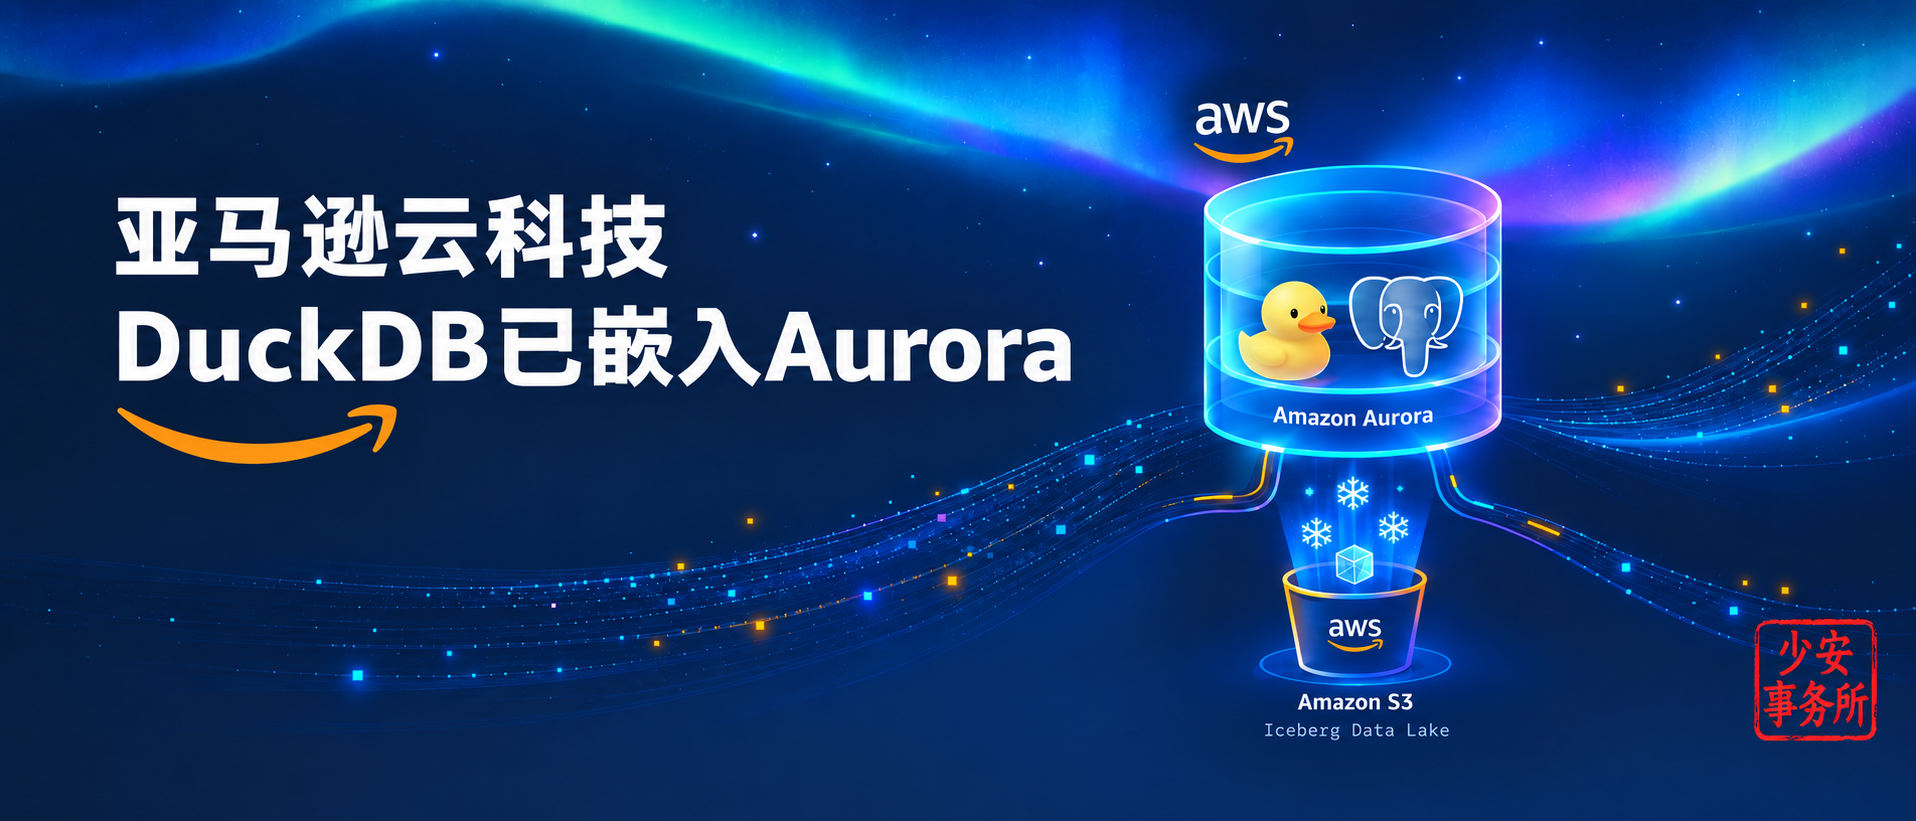
9 月 30 日,Aurora PostgreSQL 发布 aurora_analytics 扩展,正式支持直接查询 S3 和 S3 Tables 里的 Iceberg、Parquet 数据。
距离 8 月 26 日,AWS 宣布签署最终协议收购 DuckLabs。中间仅仅隔了 35 天。如果按团队实际加入 AWS 的 9 月 1 日算,只有 29 天。
其实,这不是 AWS 用 35 天开发出一个新的扩展,而是 AWS 把和 DuckLabs 从 2024 年就开始的技术合作,在收购完成后迅速产品化,并正式发布。
01. 几个容易搞混的名字
AWS 收购的不是 MotherDuck,也不是 DuckDB 项目本身。准确地说,AWS 收购了 DuckDB 背后的商业公司 DuckLabs。
DuckDB 官方的 FAQ 把关系说得很明白:
| 名字 | 性质 | 归属 |
|---|---|---|
| DuckDB | MIT 开源的分析型数据库 | 项目本身 |
| DuckDB Foundation | 非营利组织 | 持有 DuckDB 的 IP 和商标 |
| DuckLabs | 商业公司,阿姆斯特丹,约 30 人 | 雇佣了大量 DuckDB 核心贡献者 |
| MotherDuck | 另一家独立公司 | 做 DuckDB 云服务,与 DuckLabs 是合作关系 |
DuckDB、DuckLake、Quack 这些项目继续由独立的 DuckDB Foundation 管理,保持 MIT 开源。
DuckDB 两个创始人 Hannes Mühleisen 和 Mark Raasveldt 继续带领团队,人留在阿姆斯特丹。交易金额没有披露。另外 DuckLabs 还做了两个治理层面的承诺:基金会将增设技术顾问委员会,并且会开放扩展签名机制,让第三方签名的扩展也能在 DuckDB 里运行。
当时社区的第一反应普遍是 DuckDB 的云服务公司 MotherDuck 被买了。其实不是。MotherDuck 的 CEO Jordan Tigani 甚至还公开预测过 Amazon 会把 DuckDB 做成服务。两家一直是合作关系。
02. 35 天时间线:快,但不是从零开始
| 日期 | 事件 |
|---|---|
| 2026-08-26 | AWS 宣布签署协议收购 DuckLabs |
| 2026-08-31 | 交易完成 |
| 2026-09-01 | DuckLabs 团队正式加入 AWS |
| 2026-09-30 | Aurora PostgreSQL GA aurora_analytics,支持直接查询 Iceberg / Parquet |
来源:AWS 官方公告(aws.amazon.com,2026-08-26)、AWS News Blog(2026-09-30,作者 Esra Kayabali)、AWS 官方文档。
表面上这是 AWS 宣布收购后 35 天产品 GA。但 AWS 自己在收购公告里交代过背景:双方从 2024 年就开始合作,DuckDB 此前已经支持了 Amazon S3 Tables 和 SageMaker Lakehouse。
AWS 披露,Amazon Quick 的自定义查询引擎用 DuckDB 集成跑在 S3 Tables 上,自 2025 年 10 月上线以来已经处理超过 25 亿次查询,平均查询延迟降低约 30%。
所以说,Aurora Analytics 是多年合作积累的成果,在 DuckDB 团队融入 AWS 之后一个月完成产品化落地。
03. aurora_analytics:DuckDB 进了 Aurora 的肚子里
这次发布的核心就一个数据库的新扩展:
CREATE EXTENSION aurora_analytics;
支持产品包括:Aurora PostgreSQL 17.11 及以上、18.6 及以上,覆盖所有商业 Region 和 AWS GovCloud。Aurora Serverless v2 也支持。功能本身不额外收费,只付增量的 Aurora 计算和 S3 请求费用。
架构上,DuckDB 被嵌入 Aurora PostgreSQL Server 内部,查询数据湖时由 DuckDB 负责 Iceberg 和 Parquet 数据的分析扫描,Aurora PostgreSQL 继续负责操作事务型数据。
DuckDB 不再只是 Aurora 外部的一个分析工具,它成了 Aurora 内部的分析执行引擎。
一条 SQL 直接查询 S3 上的 Parquet 文件:
CREATE FOREIGN TABLE transaction_history ()
SERVER aurora_analytics_server
OPTIONS (
    location 's3://bucket/finance/transaction_history.parquet',
    format 'parquet'
);
注意那个空括号。Schema 不用手写,Aurora 直接从 Parquet 元数据推断。批量建表还有 IMPORT FOREIGN SCHEMA,可以把 Glue 数据库里的 Iceberg、Parquet 表一次全部映射过来。
04. 真正的价值:Aurora 表和数据湖表可以直接 JOIN
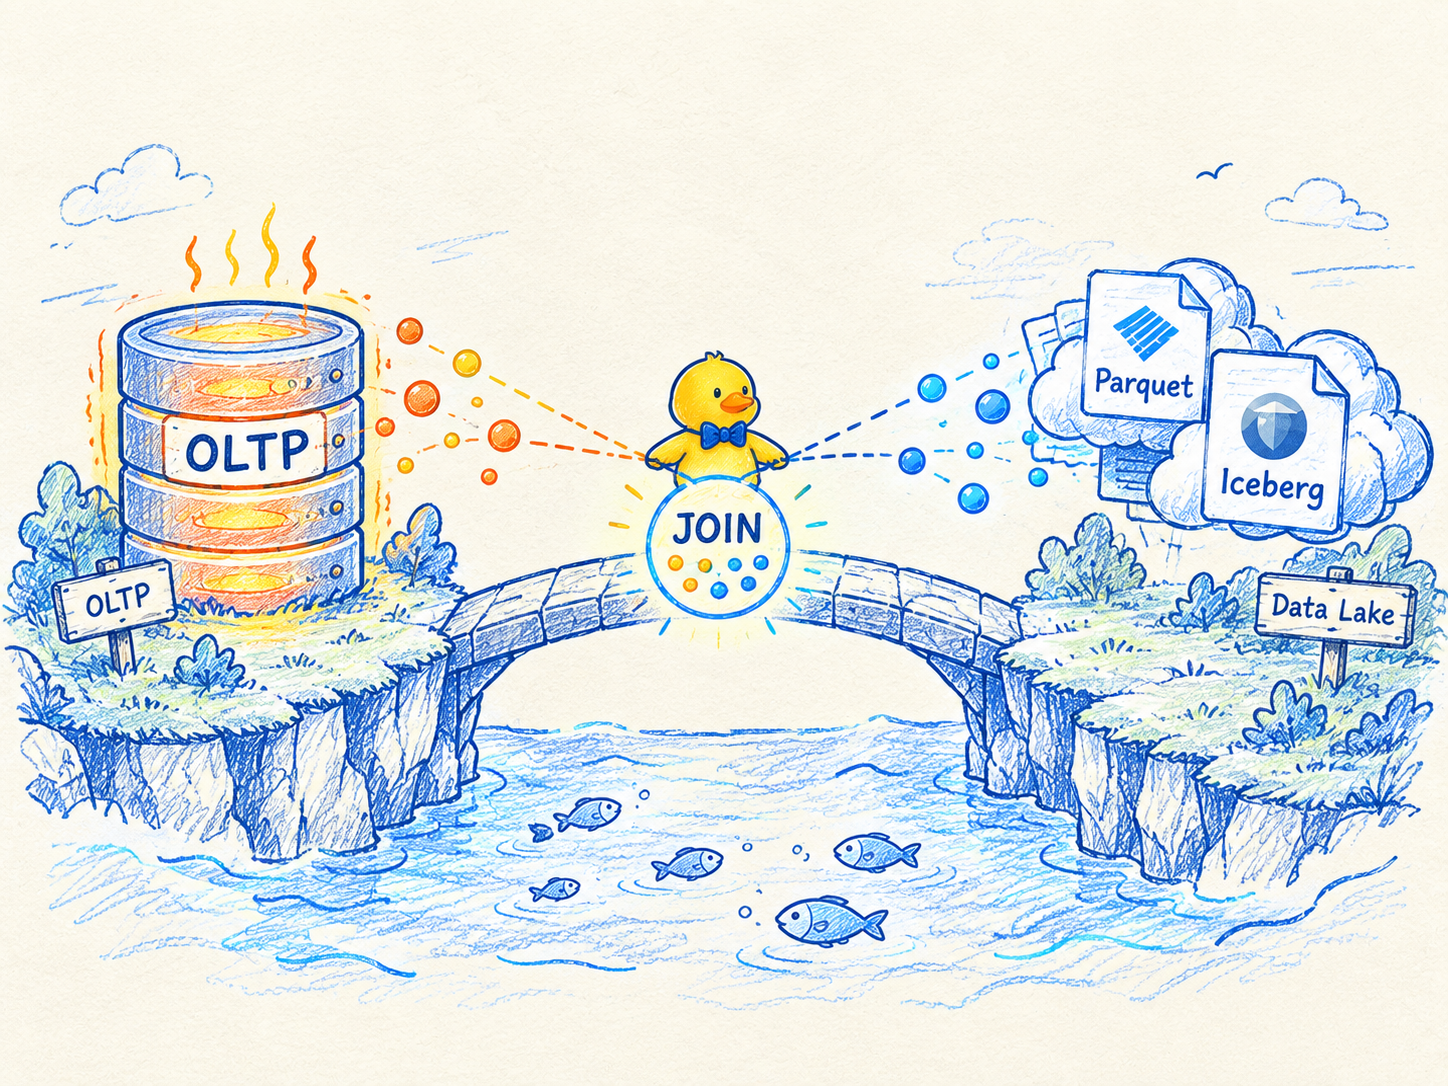
单个 foreign table 查询 S3,说实话不算什么新闻,以前的 fdw 思路也做过。这次真正有意思的是混查。
AWS 官方给的案例很典型:最近 7 天的交易数据放 Aurora 的 recent_transactions 表,5 年历史数据放 S3 上的 Parquet。然后一条 SQL:
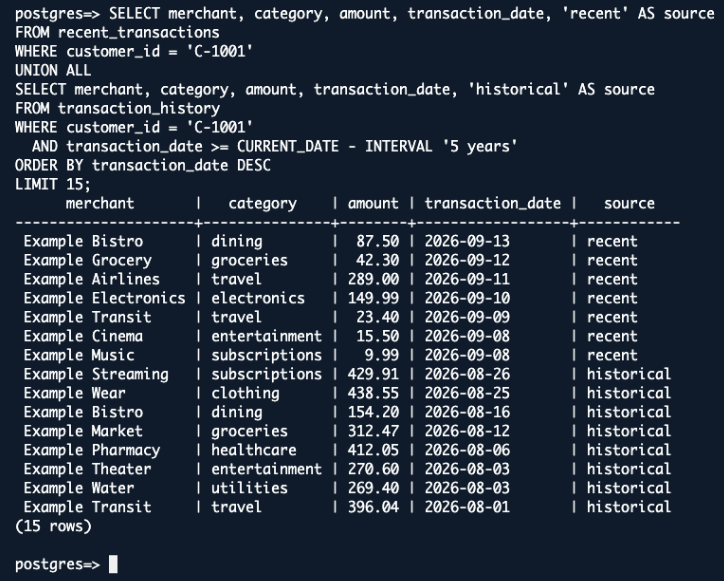
事务库里的热数据和数据湖里的冷历史,出现在同一条 PostgreSQL SQL 里。而且按官方说法,连 Aurora 里未提交的写都能和湖里的数据放在一条语句里查。
更细一点看执行侧:谓词下推、列裁剪、实例级本地缓存都有,aurora_analytics_stat_statements() 能直接看到扫描行数、从 S3 读了多少字节、缓存命中情况。湖数据的扫描还可以跑到读副本上,不占用写节点。
以前是 Aurora 经 ETL 或 CDC 把数据搬进数仓再分析。现在这个链路可以简化成:应用只管发 PostgreSQL SQL,底下谁存的数据、什么格式,应用不需要知道。
05. 访问 S3、S3 Tables、Glue、Iceberg REST Catalog
aurora_analytics 数据源清单,官方列了四个:Amazon S3、Amazon S3 Tables、AWS Glue Data Catalog,以及通过 Glue federation 接入的 Iceberg REST Catalog 兼容目录。
这几个名次的释义:
| 层次 | 产品 / 技术 | 作用 |
|---|---|---|
| 数据库 | Aurora PostgreSQL | OLTP,操作型数据 |
| 分析引擎 | DuckDB | 嵌入式 OLAP 执行 |
| 查询桥梁 | aurora_analytics | Aurora 与湖之间的 foreign table |
| 对象存储 | Amazon S3 | 数据落地 |
| 湖表形态 | S3 Tables | Iceberg 表的托管存储与管理 |
| 目录 | AWS Glue Catalog | 元数据与表目录 |
| 表格式 | Apache Iceberg | 开放表格式 |
S3 Tables 和 aurora_analytics 不是一回事。S3 Tables 是 AWS 针对 Iceberg 表优化的一种 S3 存储形态,aurora_analytics 是查询侧的扩展。一个管存,一个管查。
AWS 早在 2025 年 11 月 26 日就宣布了在 EMR 7.12、Glue、S3 Tables、Glue Data Catalog 上支持 Iceberg V3 的 deletion vectors 和 row lineage,Glue 5.1 同一天 GA;VARIANT 类型是 2026 年 7 月 28 日在 S3 Tables 落地的。V3 能力是一个逐步铺的过程。
06. 反向搬运:这套架构还能当冷热分层用
AWS 这次还给了 CTAS、INSERT INTO … SELECT 和 MERGE INTO。意思是湖里的数据可以物化回 Aurora 的原生表。
这个组合出来以后,一个非常典型的冷热分层架构就闭环了:热点运营数据放 Aurora,冷历史数据放 Iceberg 或 Parquet 数据湖,Aurora 通过 foreign table 随时查冷数据,需要低延迟访问的子集再物化回来。AWS 官方管这个叫 Data Tiering。
联邦查询不搬数据,物化查询搬数据,两条路都给你留好了。我觉得这个设计比单纯的「能查 S3」务实得多。
07. 能不能叫湖库一体?我的判断
能,但要加限定词。
从能力上看,Aurora PostgreSQL 加 DuckDB 加 S3 Tables 加 Iceberg,已经是一套很典型的湖库融合架构。它解决了湖库一体最核心的一件事:数据不搬,统一查询。
支持谓词下推、列裁剪、缓存、Glue Catalog、Iceberg REST Catalog、foreign table、CTAS、MERGE INTO,这些能力叠加起来,它早就不只是「数据库读文件」了。
但严谨一点说,现在这个阶段更准确的定位是湖库统一访问,或者叫湖库联邦查询,而不是湖库统一存储。因为 Aurora 的数据存在 Aurora 自己的存储里,湖数据存在 S3 里,两边物理上还是分开的。aurora_analytics 统一的是查询入口,不是存储。
把几种路线摆在一起看:
| 路线 | 核心思想 | 代表 |
|---|---|---|
| 传统数仓 | 数据搬进数仓再分析 | Redshift、Greenplum 系 |
| Lakehouse | 数据放湖里,计算引擎围绕湖 | Databricks、Snowflake Iceberg |
| HTAP | 一套库同时扛 TP 和 AP | TiDB、OceanBase |
| 湖库一体 | 库与湖统一数据、统一查询 | 国内几家数据库厂商的主推方向 |
| Aurora + DuckDB | OLTP 库内嵌 OLAP 引擎,直连 Iceberg/S3 | 本文主角 |
AWS 这条路线的特殊之处在于:它不是把 Aurora 改造成一个超级 OLAP 库,而是把 DuckDB 这个轻量分析引擎塞进 Aurora。OLTP 归 PostgreSQL,OLAP 归 DuckDB,各干各的,通过一个 SQL 接口对上应用。这其实很符合 DuckDB 的设计哲学,把分析能力尽量靠近数据和应用。
现阶段我把它定义为 Lake Federation 的第一阶段。如果后续补上 Iceberg 原生写入、UPDATE/DELETE、湖端事务、更深的查询优化,那才更接近真正意义上的湖库一体数据库。
08. 来自 AWS 的三个信号
第一,AWS 买的核心不是产品,是一支嵌入式分析引擎团队。DuckDB 的特性是小型、可嵌入、列式、向量化执行、直接读 Parquet、直接读 S3、直接读 Iceberg。这和 AWS 的 S3 数据战略天然咬合。AWS 数据副总裁在公告里甚至说了一句「DuckDB 天然适合 AI Agent 去用」。
第二,S3 正在从对象存储往数据库存储层演化。S3、Iceberg、S3 Tables、Glue Catalog、DuckDB 放在一起看,S3 已经越来越不像文件仓库了。S3 Tables 承担湖仓存储层,Aurora 承担操作型数据库层,DuckDB 卡在中间的执行层。
第三,AWS 正在把湖仓的复杂性藏到 PostgreSQL 接口后面。应用不需要知道数据在哪、什么格式、哪个 catalog,只发一条 JOIN。数据定位、权限、下推、执行、缓存,全在数据库内部解决。对上层 AI Agent 来说,这意味着一个统一的 SQL 入口能摸到所有数据。这第三步,我觉得才是 Snowflake、Databricks,以及国内做“湖库一体/LTAP”厂商真正该重视的地方。
09. 总结
2024 年开始合作,DuckDB 逐步接入 S3 Tables、SageMaker Lakehouse、Amazon Quick;2026 年 8 月 26 日宣布收购,9 月 1 日团队并入;9 月 30 日 aurora_analytics GA。亚马逊云科技 AWS 正在把 DuckDB 从一个独立的嵌入式 OLAP 引擎,变成自家数据基础设施里的分析连接层,上接 Aurora,下接 S3、S3 Tables、Iceberg 和 Glue。
这条「PostgreSQL + DuckDB + Iceberg + S3」的组合路线,和国内正在做的湖库一体数据库,在技术方向上是可以直接对照的。别人用收购加开源嵌入的方式把这件事落地了,我们的湖库一体接下来往何处去,还真是个值得考虑的问题。
最后,如果你在用 OLTP + ELT + 数仓的组合拳,或者 Redshift、Athena,会考虑迁移到 Amazon Aurora PostgreSQL 上么?
Have a nice day ~ ☕
公众号「 少安事务所 」,专注于数据 & AI 领域技术传播。
如果这篇文章为你带来了灵感或启发,请帮忙『点赞、转发、推荐』,感谢!ღ( ´・ᴗ・` )~