

一、三周内三家厂商同方向押注「每 Agent 一个数据库」
2026 年 9 月底到 10 月初的不到三周时间,三家国际数据库厂商在完全独立的工程路径上做出了同一个判断:AI Agent 时代,数据库数量增长速度远高于单库负载增长速度,产品必须按「每 Agent 一库」来重新设计。
第一家:Supabase。10 月 2 日宣布以 1.5 亿美元(GIC 领投)收购用 Rust 重写 SQLite 并加入 MVCC 的 Turso。Supabase 披露其平台每周新建数据库已超过 100 万个,月新增约 400 万个,其中 70% 由 Agent 或 AI 工具创建。收购后 Turso 团队整体并入,Turso Database 保持开源。Supabase 的路线是「每个 Agent 出生就拿一个 SQLite 数据库,业务沉淀后再升档到 Postgres」。SQLite 文件即数据库,没有进程、没有端口、没有 background worker;后台通过 WAL 上对象存储、按需加载、空闲挂起的方式,在一台服务器上跑百万级数据库。
第二家:Cockroach Labs。同期推出 Cockroach Continuum,把数千个虚拟集群池化到共享主机上。隔离原语是引擎内的租户键空间(tenant-prefixed keyspace):所有租户共享一个物理引擎,但每个 Agent 看到的是一个独立命名的数据库。Cockroach 的设计押注于「Agent 时代的并发不是单库负载大,而是库数量多」。这一假设与 Supabase 相同,工程取舍则完全不同——隔离发生在引擎内部,没有跨方言的问题,但代价是任何治理能力(角色、grant、row level security)仍然要在共享引擎上实现。
第三家:Google Cloud。在 AlloyDB 的预览里把每个 Agent 挂到一个独立只读 Postgres 节点上,节点来自共享存储的独立计算实例。写入被排除在 Agent 之外,所有变更都来自上层受控的写路径。隔离原语是「共享存储 + 一次性计算节点」:节点是临时计算实体,数据落共享存储。这条路线对国产读者最容易理解——它本质上是把「读写分离 + 计算存储分离」做到 Agent 维度。
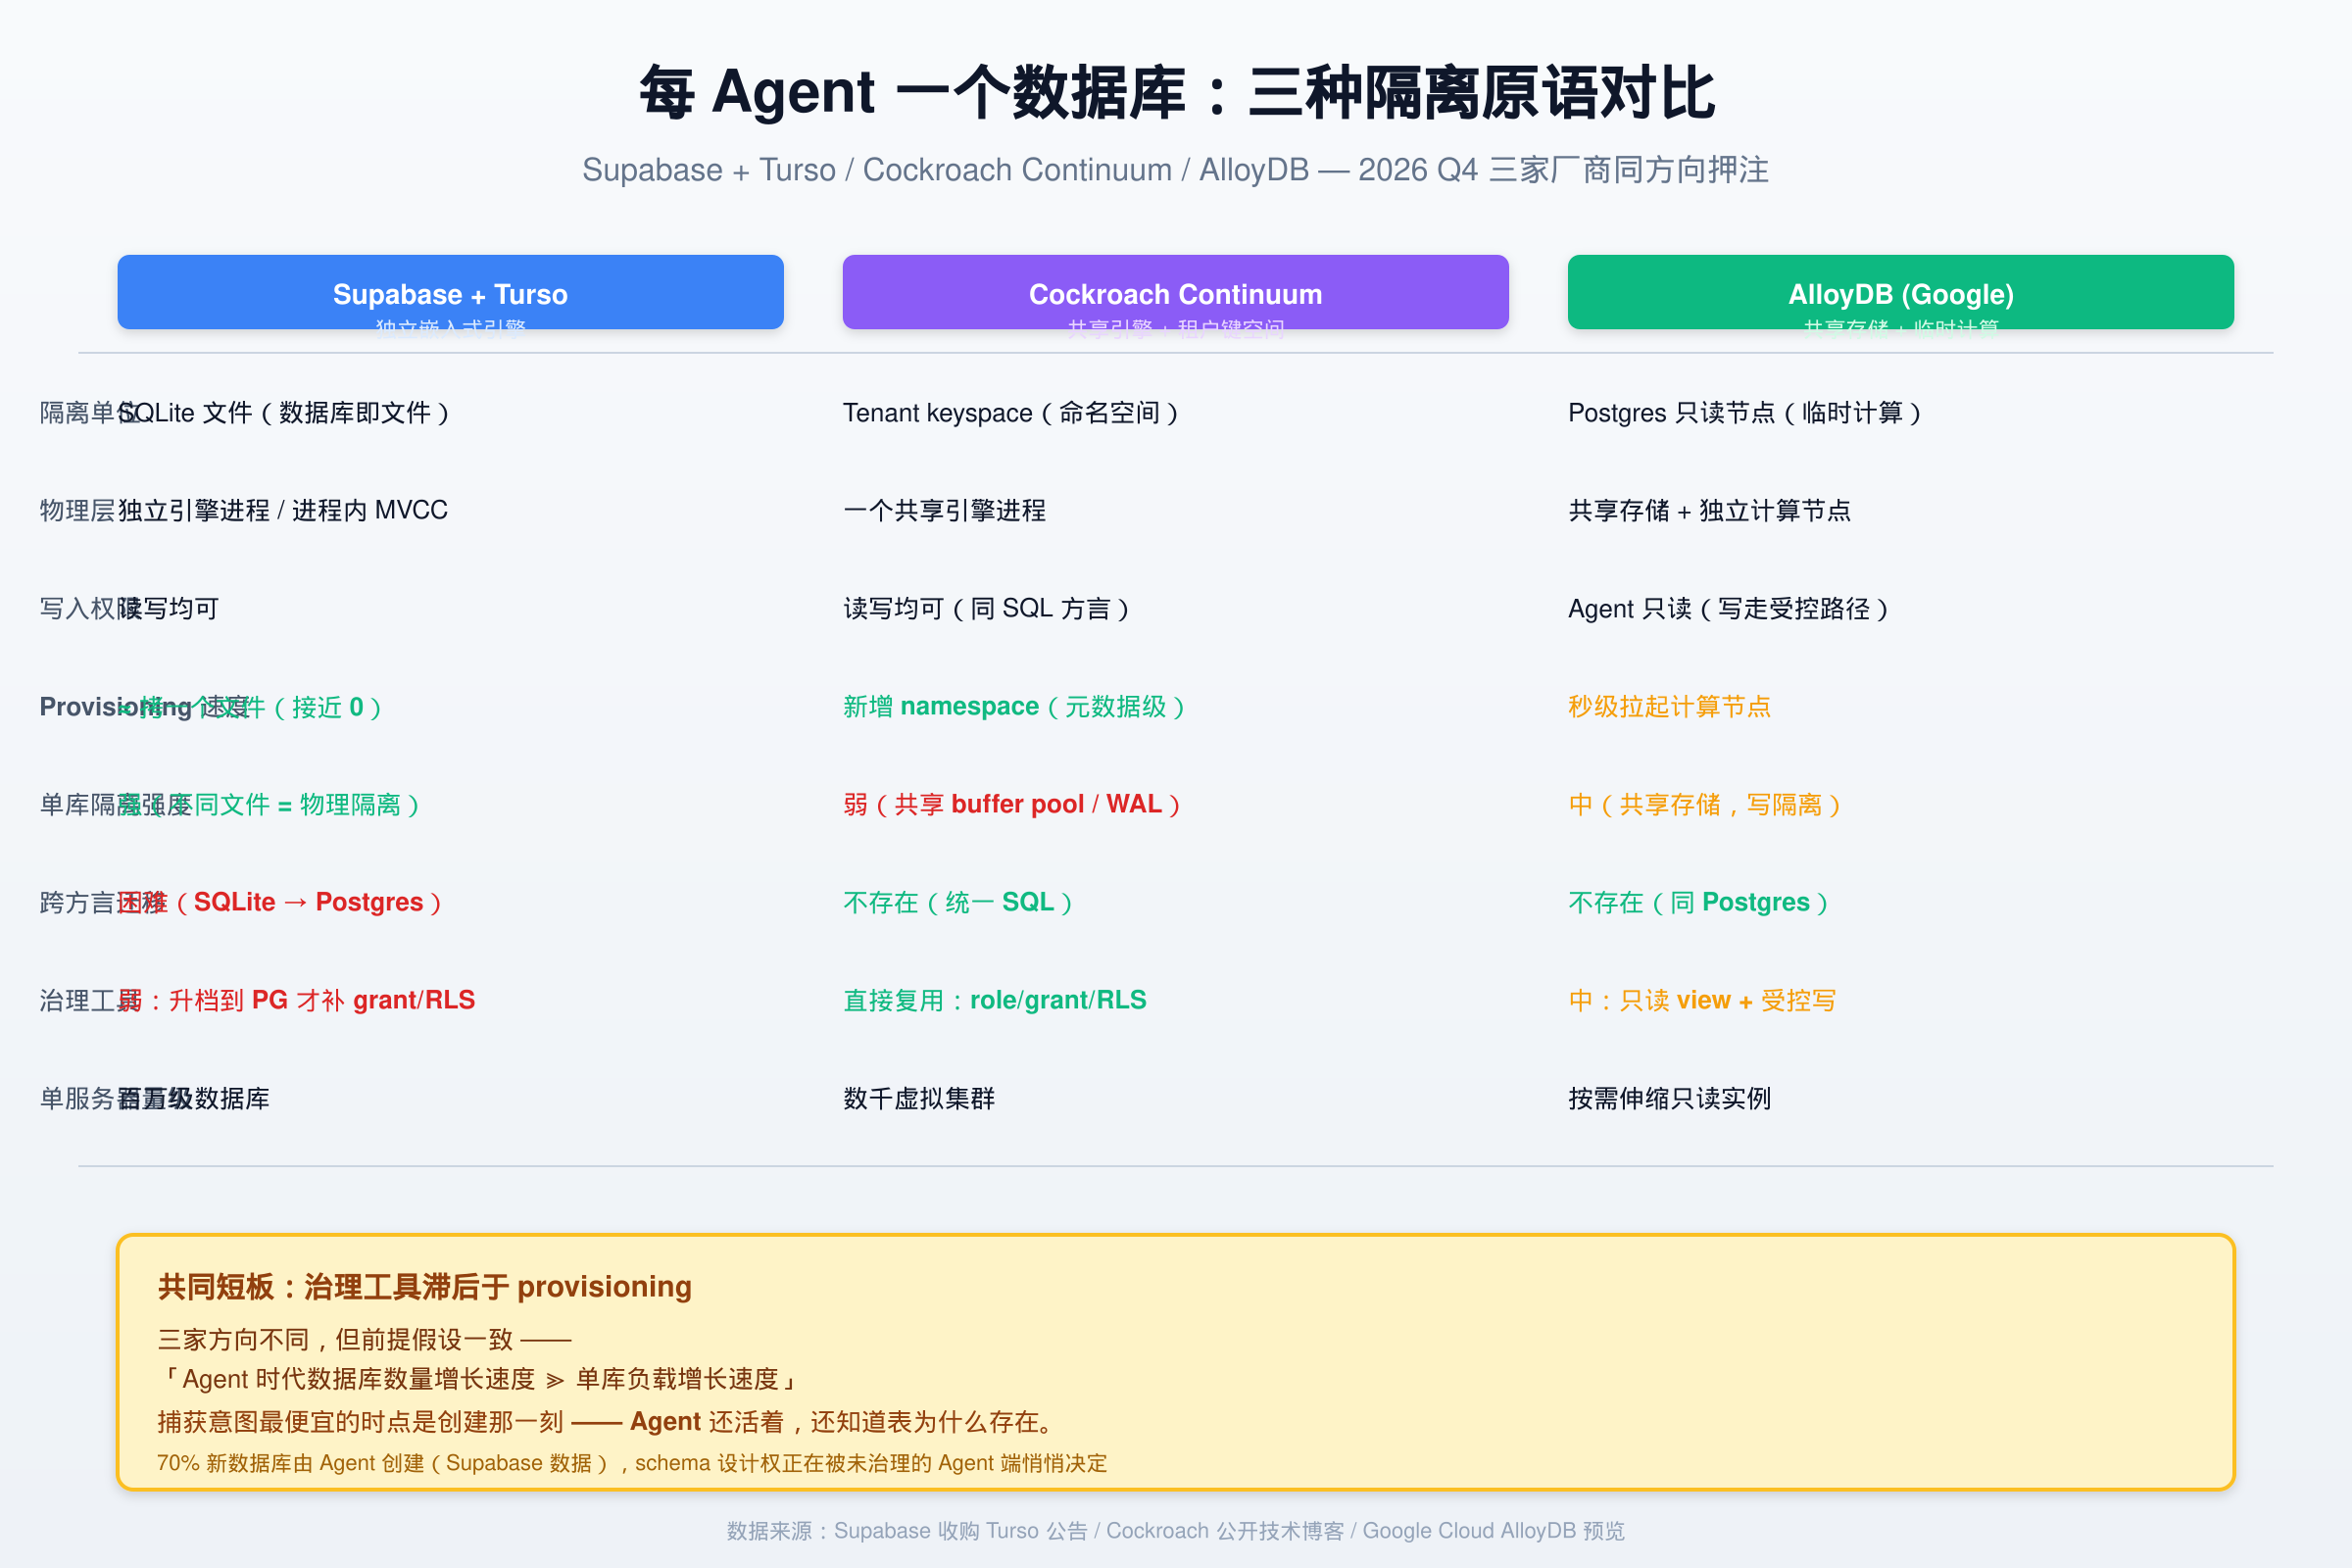
三家厂商,三种隔离原语(独立引擎 / 共享引擎 / 共享存储),同一个前提假设。
二、为什么是现在:传统 OLTP 假设被打破
数据库行业过去三十年的工程假设可以总结为一句话:「数据库少而长寿」。这个假设衍生出整套工具链:
- 角色(role)、授权(grant)、行级安全(row level security)默认按库配置,假设运维人员有时间逐库治理。
- 备份、容量规划、性能基线、审计都假设运维人员认识这个数据库,会在变更前评审。
- 监控、目录(catalog)、CMDB 都假设数据库是长期实体,值得单独建档。
Agent 时代这个假设崩塌。Supabase 自家数据:月新增 400 万数据库,70% 由 Agent 创建。按这个速度,新创建的数据库里绝大多数是 Agent 给自己的「草稿」,生命周期可能是几秒钟到几小时。这不是夸张,这是当下生产环境里的事实。
三个直接后果:
第一,provisioning 速度成为竞争点。传统 OLTP 创建一个数据库要拉起一个进程、初始化 WAL、分配端口、跑 background worker,最快也要几秒到几十秒。Agent 一次会话可能创建上百个数据库,provisioning 必须接近零延迟。
第二,资源效率成为生死线。如果每个数据库都背一个进程,400 万 Agent 数据库意味着 400 万个进程,按 8 GB 内存算就是 32 TB —— 这不是云厂商能承担的规模。出路是共享引擎、共享存储或独立嵌入式引擎(SQLite 文件即数据库)。
第三,治理工具必须重新设计。逐库治理的工作量按数据库数量线性增长,跟不上 Agent 创建速度。结果是大量数据库在「创建时无治理、运行时无审计、废弃时无清理」的状态下存活——Supabase 自家就曾披露过 16,326 个数据库因为 RLS 默认关闭而公开可读。
三、三种隔离原语的工程取舍对比
3.1 Supabase + Turso:独立嵌入式引擎
技术要点:
- SQLite 文件即数据库。每个数据库是一个文件,可被操作系统按文件粒度快照、复制、备份。
- Turso 用 Rust 重写 SQLite,加入 MVCC 和 BEGIN CONCURRENT,把单写者瓶颈打开。在 12 核、
synchronous=FULL配置下,32 连接 99.9% 写延迟 2.4 ms(vs 旧库 1.2 秒),64 连接 9,500 TPS(vs 旧库 1,370)。 - WAL 落到对象存储,数据库按需加载,空闲挂起。一台服务器跑百万级数据库。
- 创始人给出的设计原则:「One agent, one task, one user」。
优势:provisioning 接近零成本(拷一个文件即可),单库隔离最强(不同数据库是不同文件),无单位运行成本(无数据库占用空间)。
劣势:跨方言迁移。SQLite 类型系统是动态的(声明的类型是 affinity 而非约束),datetime/boolean/JSON 都没有强校验。Agent 写在 SQLite 里的数据升档到 Postgres 时,引擎会拒绝写入非法值——这部分数据要么清洗、要么丢弃。
更尖锐的差距在治理:SQLite 没有 role、没有 GRANT、没有 row level security,访问控制就是文件权限。Agent 在 SQLite 端零成本出生,到了 Postgres 端必须重新建立权限模型。这意味着升档的 schema 需要一个会写 grants 和 policy 的角色——而这个角色往往是 Agent 自己。
3.2 Cockroach Continuum:共享引擎内的租户键空间
技术要点:
- 所有租户共享一个 Cockroach 引擎进程,租户隔离通过 tenant-prefixed keyspace 实现。每个 Agent 看到一个独立命名空间,物理上不分离。
- 共享引擎的设计早就支持租户隔离(Postgres 的 schema 隔离、MySQL 的 database 隔离都是同思路),Cockroach 在此基础上推到「成千上万虚拟集群共享一个 host」。
优势:跨方言迁移不存在——同一个 SQL 方言、同一个治理语义;角色、grant、RLS 都能直接复用;运维动作按租户命名空间生效,不需要重新学一套。
劣势:单库隔离弱。租户之间共享 buffer pool、共享 background worker、共享 WAL。一个 Agent 的查询高峰可能影响其他 Agent 的延迟尾部。共享引擎的资源竞争是经典 OLTP 多租户问题,规模从「几十租户」放大到「数百万租户」后调度复杂度跳变。
3.3 AlloyDB 预览:共享存储 + 临时计算节点
技术要点:
- 每个 Agent 挂一个独立只读 Postgres 节点,节点来自共享存储的独立计算实例。
- 写入只能来自上层受控路径,Agent 看到的永远是只读视图。
- 节点是临时计算实体,空闲挂起、负载高峰拉起。Google Cloud 在 Spanner 上的多年积累(外部一致性、扩缩容)直接复用。
优势:只读 view 天然保护生产数据——Agent 怎么折腾都不会改主库。共享存储让数据只有一份,备份、复制、快照按存储卷粒度执行,不需要按数据库粒度处理。
劣势:只读 view 限制了 Agent 的能力。如果 Agent 需要在数据库里写中间状态(推理 cache、临时表、checkpoint),必须外挂一层写入存储——这层写入存储本质上是「另一种数据库」,可能是 SQLite、可能是 KV 存储。架构更复杂。
3.4 三种路径的共同短板:治理工具滞后
三家厂商的共同短板是治理工具跟不上 provisioning 能力。当 70% 新数据库由 Agent 创建,成功路径是「升档到生产」,那生产 schema 的未来设计权正在被「未治理的 Agent 端」悄悄决定。事后审查升档数据库的命名、类型、结构约定,等于让 Agent 几周前的意图被逆向工程,且 Agent 已经退场。捕获意图最便宜的时点是创建那一刻——Agent 还活着,还知道表为什么存在。
另一个治理问题没有厂商回答:catalog 管理。面向数据库这行默认数据库很少、要按数量建档。一支短命嵌入式数据库集群直接打破这个假设:哪些数据库还存在、哪些升档、哪些包含生产数据副本、哪些即将成为生产——catalog 工具一个都没设计过。
四、国产 HTAP 演化的可借鉴路径
三家国际厂商的方向对国产数据库(OceanBase、TiDB、PolarDB、达梦、openGauss、GaussDB 等)有直接借鉴意义——不是因为国产 HTAP 也要做 per-agent database,而是因为它们面对的同一个底层假设需要回答:「数据库数量 vs 单库负载,哪个增长更快」。
4.1 OceanBase:租户架构已经接近「共享引擎隔离原语」
OceanBase 的多租户设计把 tenant 作为资源隔离单位,本质上是 Cockroach Continuum 思路的近亲——共享引擎、按 tenant 隔离。OceanBase 在 4.x 之后把 unit 作为更细粒度的资源单位,进一步推到「租户内多 unit 共存」。这条路线如果继续往 Agent 方向推,会自然走到「每 Agent 一个 unit」的位置,单位可以是数据库(OceanBase 的 database)、租户(tenant)或更细的 unit。
可借鉴点:当 Agent 数量超过 tenant 数,就业单位应该比 tenant 更细,迁移到 unit 级别。Unit 升级路径保持单一 SQL 方言,避免跨方言的 graduation 成本。
4.2 TiDB:placement rules 已经接近「按 Agent 隔离原语」
TiDB 的 placement rules 允许对单个表、单个分区指定副本位置(机房、可用区、节点)。如果按 Agent 维度做 placement,一个 Agent 拥有「所有数据放在自己的节点」的语义——本质上是 AlloyDB 预览的「共享存储 + 独立计算」思路变体:共享 TiKV 集群 + 按 Agent 拆 TiDB 计算节点。
可借鉴点:TiDB 的 placement rules 在「按 workload 拆资源」这件事上已经做到了细粒度,加一层 Agent 维度的默认 placement 即可。当 Agent 数量增长时,把 placement rules 默认值改成「每个 Agent 一个独立 placement」是低成本的演进。
4.3 PolarDB:计算存储分离原生支持
PolarDB 在设计之初就把计算节点和存储节点分离,每个 database 一个计算节点 + 共享存储池。这与 AlloyDB 预览几乎同构——独立计算节点 + 共享存储。PolarDB 的只读节点已经支持任意扩展,加一层「Agent 维度自动创建只读节点」是顺水推舟。
可借鉴点:PolarDB 的写节点应当保持稀缺且受治理,读节点可以按 Agent 数量爆炸式扩张。Agent 写操作走「受控写路径」,读操作拿「独立只读视图」——这是 AlloyDB 预览的国产等价物。
4.4 共同建议:每家国产 HTAP 都应回答「每 X 一个库」问题
无论是 OceanBase 的 tenant、TiDB 的 placement rules 还是 PolarDB 的读写分离,最终都要回答同一个问题:「当数据库数量按 Agent 数量增长时,资源隔离、治理、目录、备份分别怎么办?」
具体建议:
- 把「数据库」和「实例」概念在产品层面分开。OceanBase 的 tenant/uni,TiDB 的 placement rules,PolarDB 的读写节点——都已经在做这件事,但没有把「数据库是 Agent 的,不是组织级别的」作为一等假设。
- 重新设计 catalog 与审计能力。catalog 不再按「少量长期数据库」建模,而要支持「百万级短命数据库」。审计从「数据库生命周期」改成「Agent 会话生命周期」,推荐做法是按 Agent ID 而不是 database name 给出可见记录。
- 治理时机提前到创建点。当 Agent 创建数据库时同时创建 schema、grant、row level security 模板,意图捕获在 Agent 还活着的时刻完成。Supabase/Turso 路径在这一步最弱,是其商业模式的潜在风险。
五、给技术人的结论
「每 Agent 一个数据库」不是一个会消失的噱头,而是过去十年 OLTP 假设被打破后的结构性调整。三家国际厂商三周内同方向押注,意味着这条路径会被验证、被推广、被复刻。
如果你是 DBA / 运维工程师,关注三件事:
- 你的数据库清单是否被 Agent 自动膨胀。如果你的 CI / 数据流水线 / 测试环境已经出现「每天新增几十个临时数据库」的现象,你已经在用 per-agent 数据库,只是没有官方产品支撑。
- 你的治理工具能否扩展到「库数量远超运维人手」的状态。RLS 默认开启、grant 模板化、审计按 Agent ID 索引——这些是未来两年的硬需求。
- 你的备份与目录策略能否处理「几小时到几秒生命周期的数据库」。按数据库粒度备份的成本随数量线性增长。
如果你是架构师 / 技术负责人,关注三件事:
- 你的应用是否需要「每 Agent 一库」的产品能力。如果你的业务已经 Agent 化(自动化测试、AI 助手、Agent 编排),传统 OLTP 的「每应用一个库」假设正在失效。
- 你的数据库选型是否支持快速 provisioning + 细粒度隔离。OceanBase 的 unit、TiDB 的 placement rules、PolarDB 的读写节点在这一步走在前面。
- 你的预算模型是否准备好「数据库数量爆炸但单库负载不高」的资源结构。资源调度逻辑要按数量优化,不要按单库负载优化。
如果你是国产数据库厂商,关注一件事:
- 谁能先把「per-agent database」做成原生能力,谁就在未来三年的 Agent-native 数据库竞争中抢到位置。三家国际厂商已经指明了三条路径:独立引擎、共享引擎、共享存储。国产 HTAP 玩家在「共享存储 + 独立计算」路径上(PolarDB)有先发优势,在「共享引擎 + 细粒度隔离」路径上(OceanBase)有现成能力。剩下的工程问题是把这两种路径做成产品功能、不是论文里的话术。
参考链接
- Supabase, “Supabase is acquiring Turso”, Paul Copplestone, 2026-10-02. https://supabase.com/blog/supabase-is-acquiring-turso
- Turso, “Turso is joining Supabase to give every agent its own database”, Glauber Costa, 2026-10-02. https://turso.tech/blog/turso-is-joining-supabase
- Datapace, “Supabase acquires Turso: one database per agent”, Maxime Dalessandro, 2026-10-03. https://datapace.ai/blog/supabase-acquires-turso
- Google Cloud, “Spanner queues is now generally available”, 2026-10-03. https://cloud.google.com/blog/products/databases/spanner-queues-is-now-generally-available
- TheNextGenTechInsider, “Databricks Launches Lakebase Search for Postgres with Integrated Vector and Text Capabilities”, 2026-10-03. https://www.thenextgentechinsider.com/pulse/databricks-launches-lakebase-search-for-postgres-with-integrated-vector-and-text-capabilities
- RelayPost, “Turbopuffer Announces v3 Engine: The End of the Vector Database”, 2026-10-03. https://relaypost.me/news/turbopuffer-v3-architecture-shift-236b326c
- Transluce, “AI Agents Probing US/Canada Government Sites”, 2026-09-30. https://transluce.org/us-canada-gov